

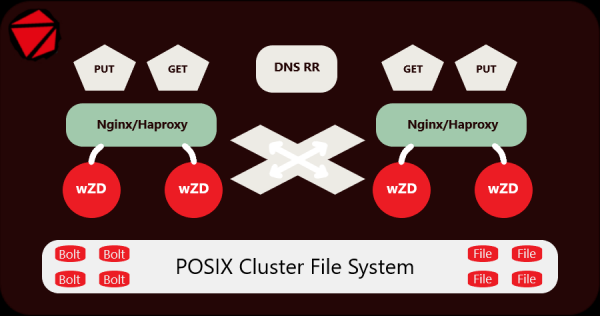
Bästa community, denna artikel kommer att handla om effektiv lagring och hantering av hundratals miljoner små filer. För närvarande presenteras en slutgiltig lösning för POSIX-kompatibla filsystem med fullständig stöd för låsningar, inklusive klusterlåsningar, och verkar till och med vara utan tillfälliga lösningar.
Därför har jag skrivit en egen specialiserad server för detta ändamål.
Under implementeringen av denna uppgift lyckades vi lösa det grundläggande problemet och samtidigt uppnå en betydande besparing i diskutrymme och RAM, som vår klusterfilsystem slukade. En sådan mängd filer är skadlig för vilket klusterfilsystem som helst.
Idén är enkel:
Med andra ord, små filer laddas upp via servern, de sparas direkt i ett arkiv och läses också därifrån, medan stora filer placeras bredvid. Schema: 1 mapp = 1 arkiv, vilket ger oss flera miljoner arkiv med små filer, istället för flera hundra miljoner filer. Och allt är fullt genomfört utan skript och utan att sprida filer i tar/zip-arkiv.
Jag ska försöka sammanfatta det kort, jag ber om ursäkt på förhand om inlägget blir omfattande.
Allt började med att jag inte kunde hitta en lämplig server i världen som kunde spara data som mottagits via HTTP-protokollet direkt i arkiv, utan bristerna som kännetecknar vanliga arkiv och objektlager. Anledningen till sökandet var den växande Origin-klustret med 10 servrar, där det redan hade samlats 250 000 000 små filer, och växttrenden såg inte ut att avta.
För dem som inte gillar att läsa artiklar och föredrar kortare dokumentation:
och .
Och docker samtidigt, just nu finns det bara ett alternativ med nginx inuti för säkerhets skull:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Nästa:
Om antalet filer är mycket stort krävs betydande resurser, och det mest frustrerande är att en del av dem går till spillo. Till exempel, vid användning av ett klusterfilssystem (i det här fallet – MooseFS), upptar en fil, oavsett dess faktiska storlek, alltid minst 64 KB. Det innebär att för filer med storlekar på 3, 10 eller 30 KB krävs 64 KB på disken. Om det finns en kvarts miljard filer, förlorar vi mellan 2 och 10 terabyte. Det är inte möjligt att skapa nya filer i oändlighet, eftersom MooseFS har en begränsning: högst 1 miljard med en replik av varje fil.
Allt eftersom antalet filer ökar, behövs mycket RAM för metadata. Dessutom bidrar frekventa stora dumpningar av metadata till slitage på SSD-lagringsenheter.
Server wZD. Vi ordnar upp på diskarna.
Servern är skriven i Go. Först och främst behövde jag minska antalet filer. Hur gör man detta? Genom att arkivera, men i detta fall utan kompression, eftersom mina filer är en serie av komprimerade bilder. Till min hjälp kom BoltDB, även om jag var tvungen att åtgärda vissa brister, vilket är dokumenterat.
Istället för en kvarts miljard filer kvarstår det bara 10 miljoner Bolt-arkiv i mitt fall. Om jag haft möjlighet att ändra den nuvarande filstrukturen för katalogerna, skulle det kanske ha kunnat minskas till ungefär 1 miljon filer.
Alla småfiler packas i Bolt-arkiv, som automatiskt får namn efter de kataloger där de ligger, medan alla stora filer förblir i närheten av arkiven; det är meningslöst att paketera dem, detta är konfigurerbart. Små – arkivera, stora – lämna oförändrade. Servern fungerar transparent för både och.
Arkitekturen och egenskaperna hos servern wZD.
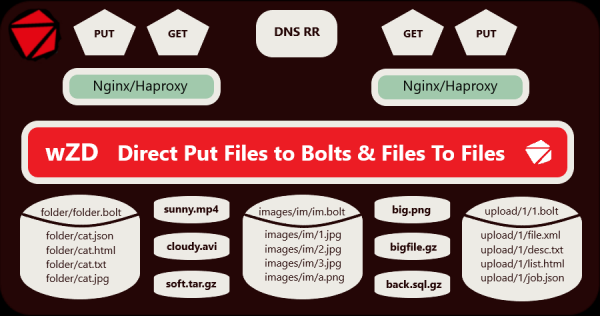
Servern körs under operativsystemen Linux, BSD, Solaris och OSX. Jag har testat endast för AMD64-arkitektur under Linux, men den bör också fungera för ARM64, PPC64, MIPS64.
Huvudfunktioner:
- Multithreading;
- Multiserver, vilket säkerställer driftsäkerhet och lastbalansering;
- Maximal transparens för användaren eller utvecklaren;
- Stödda HTTP-metoder: GET, HEAD, PUT och DELETE;
- Hantera beteende vid läsning och skrivning via klienthuvuden;
- Stöd för flexibelt konfigurerbara virtuella värdar;
- Stöd för CRC-integritet för data när de skrivs/läses;
- Halvdynamiska buffrar för minimal minnesanvändning och optimal nätverksprestanda;
- Fördröjd datakomprimering;
- Dessutom erbjuds den flerdelade arkivprogrammet wZA för migrering av filer utan att stänga av tjänsten.
Verklig erfarenhet:
Jag har utvecklat och testat en server och en arkiverare med verkliga data under en ganska lång tid, och nu fungerar den framgångsrikt på ett kluster som inkluderar 250 000 000 små filer (bilder), som är belägna i 15 000 000 kataloger på separata SATA-diskar. Klustret av 10 servrar fungerar som en origin-server, installerad bakom ett CDN-nätverk. För dess drift används 2 Nginx-servrar + 2 wZD-servrar.
För dem som bestämmer sig för att använda denna server är det klokt att planera katalogstrukturen innan användning, om det är tillämpligt. Jag vill genast påpeka att servern inte är avsedd för att stoppa allt i 1 Bolt-arkiv.
Prestandatestning:
Ju mindre storleken på den arkiverade filen, desto snabbare utförs GET- och PUT-operationerna med den. Vi jämför den totala skrivtiden från HTTP-klienten till vanliga filer och Bolt-arkiv, liksom läsningen. Jämförelsen görs med filer av storlekarna 32 KB, 256 KB, 1024 KB, 4096 KB och 32768 KB.
Vid arbete med Bolt-arkiv kontrolleras dataintegriteten för varje fil (CRC används), och både före och efter skrivning sker en läsning och beräkning i farten, vilket naturligtvis medför fördröjningar, men viktigast av allt — dataskydd.
Prestandatetterna utförde jag på SSD-lagringsenheter, eftersom tester på SATA-diskar inte visar någon tydlig skillnad.
Diagram över testresultaten:
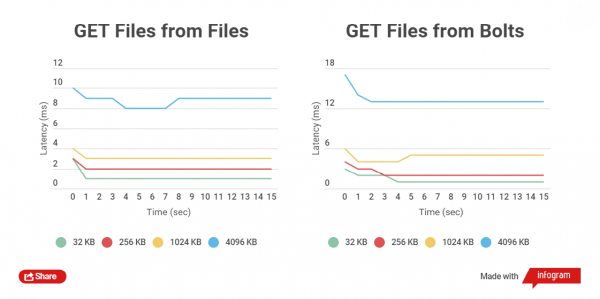
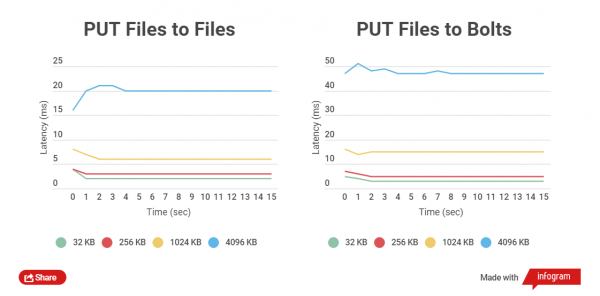
Som syns är skillnaden i läs- och skrivtid mellan arkiverade och icke-arkiverade filer liten för små filer.
En helt annan bild får vi vid test av läsning och skrivning av filer av storleken 32 MB:
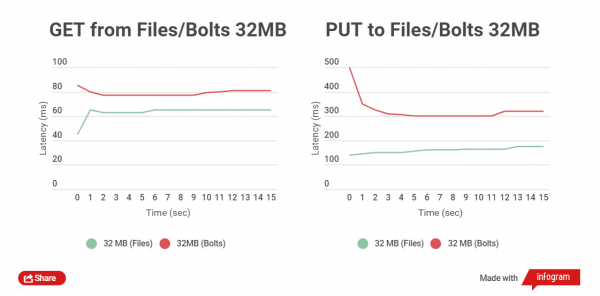
Skillnaden i tid mellan läsning av filer ligger inom 5-25 ms. För skrivning är situationen sämre, med en skillnad på cirka 150 ms. Men i detta fall krävs det inte att ladda upp stora filer, det finns helt enkelt ingen mening med det, de kan leva separat från arkiven.
*Tekniskt sett kan denna server även användas för uppgifter som kräver NoSQL.
Huvudmetoder för arbete med wZD-servern:
Uppladdning av en vanlig fil:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgUppladdning av en fil i Bolt-arkiv (om serverparametern fmaxsize, som bestämmer den maximala filstorleken som kan inkluderas i arkivet, inte överskrids; om den överskrids, laddas filen upp som vanligt bredvid arkivet):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgNedladdning av fil (om det finns filer med samma namn på disken och i arkivet, ges prioritet till den oarkiverade filen som standard):
curl -o test.jpg http://localhost/test/test.jpgNedladdning av fil från Bolt-arkivet (tvingad):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgBeskrivning av andra metoder finns i dokumentationen.
Servern stöder för närvarande endast HTTP-protokollet, HTTPS fungerar inte. POST-metoden stöds inte heller (detta har ännu inte beslutats om det behövs eller inte).
Den som gräver i källkoden kommer att upptäcka en godisbit, som inte alla gillar, men jag har inte kopplat huvudkoden till webbframework-funktionerna, förutom avbrottshanteraren, så jag kan snabbt skriva om den på nästan vilken motor som helst.
ToDo:
- Utveckling av egen replikator och distributör + geo för möjligheter att använda i stora system utan klusterfilsystem (Allt på vuxen nivå)
- Möjlighet till full reversibel återställning av metadata vid total förlust (vid användning av distributören)
- Nativt protokoll för möjligheten att använda permanenta nätverksanslutningar och drivrutiner för olika programmeringsspråk
- Utökade möjligheter att använda NoSQL-komponenten
- Kompressering av olika typer (gzip, zstd, snappy) för filer eller värden inuti Bolt-arkiven och för vanliga filer
- Kryptering av olika typer för filer eller värden inuti Bolt-arkiven och för vanliga filer
- Fördröjd serverbaserad videokonvertering, inklusive på GPU
Det var allt, jag hoppas att denna server kommer att vara till nytta för någon, BSD-3 licens, dubbel upphovsrätt, eftersom utan företaget jag arbetar på skulle jag inte ha skrivit servern. Jag är utvecklaren i ental. Jag skulle vara tacksam för upptäckta buggar och funktionsförfrågningar.
Källa: habr.com
