

Den här artikeln är en översättning av min artikel på medium — , som visade sig vara ganska populär, kanske på grund av sin enkelhet. Därför beslutade jag mig för att skriva den på ryska och lägga till lite mer information, så att en vanlig person som inte är specialist på databehandling kan förstå vad datalager (DW) är, vad ett datalake (Data Lake) är och hur de två samexisterar.
Varför ville jag skriva om datalake? Jag har arbetat med data och analys i över 10 år, och just nu arbetar jag med stordata inom Amazon Alexa AI i Cambridge, som ligger i Boston, även om jag själv bor i Victoria på Vancouver Island och ofta är i Boston, Seattle och Vancouver, och ibland till och med i Moskva för att tala på konferenser. Jag skriver också då och då, men främst på engelska, och jag har redan , jag har även ett behov av att dela trender inom analys från Nordamerika, och jag skriver ibland i .
Jag har alltid arbetat med datalager, och sedan 2015 har jag arbetat intensivt med Amazon Web Services och har överlag gått över till molnanalys (AWS, Azure, GCP). Jag har bevittnat utvecklingen av analyslösningar sedan 2007 och har till och med arbetat för datalagervärlden Teradata och implementerat det i Sberbank, då började Big Data med Hadoop. Alla började prata om att epoken för datalager var över och att nu var allt på Hadoop, och sen började man tala om Data Lake, igen att nu var det verkligen slutet för datalager. Men lyckligtvis (kanske olyckligt för dem som tjänade mycket pengar på att konfigurera Hadoop), har datalagret inte försvunnit.
I den här artikeln kommer vi att titta på vad ett datalake är. Artikeln är avsedd för personer med lite eller ingen erfarenhet av datalager.
På bilden är det Bledsjön, en av mina favoritjöar, även om jag bara har varit där en gång, men jag minns den för resten av mitt liv. Men vi kommer att prata om en annan typ av sjö — datalake. Många av er har säkert hört denna term flera gånger, men ytterligare en definition skadar aldrig.
Först och främst här är de mest populära definitionerna av Datalake:
"en fillager av alla typer av rådata, som är tillgängliga för analys av vem som helst i organisationen" — Martin Fowler.
«Om du tänker att ett datalager är som en flaska vatten — ren, förpackad och lättillgänglig, så är ett datalager som en stor behållare med vatten i sin naturliga form. Användare kan ta vatten för sig själva, dyka djupt och utforska» — James Dixon.
Nu vet vi säkert att ett datalager handlar om analys, det låter oss lagra stora mängder data i sin ursprungliga form och vi har den nödvändiga och bekväma åtkomsten till datan.
Jag gillar ofta att förenkla saker; om jag kan förklara ett komplicerat begrepp med enkla ord, betyder det att jag har förstått hur det fungerar och varför det är viktigt. På något sätt granskade jag min iPhone i fotogalleriet, och jag insåg att det verkligen är ett datalager, jag gjorde till och med en slide för konferenser:
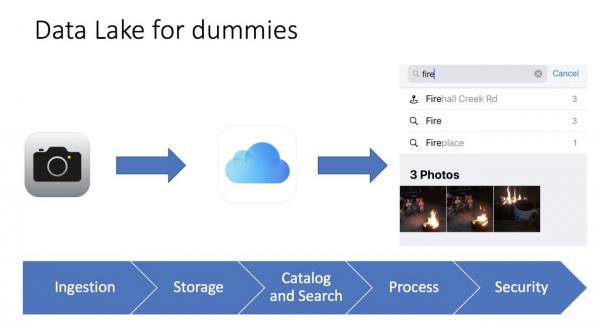
Det är mycket enkelt. Vi tar en bild med telefonen, bilden sparas på telefonen och kan också sparas i iCloud (molnlagring). Telefonnummer samlar även in metadata om bilden: vad som avbildas, geotaggning, tid. Som resultat kan vi använda det bekväma gränssnittet i iPhone för att hitta vår bild och vi kan till och med se statistik, till exempel när jag söker bilder med ordet eld, så hittar jag 3 bilder med en brasa. För mig är detta som ett Business Intelligence-verktyg som fungerar snabbt och exakt.
Och självklart får vi inte glömma säkerheten (autentisering och auktorisering), annars kan våra data lätt hamna i offentligheten. Det finns många nyheter om stora företag och startups vars data har blivit offentliga på grund av utvecklarens försumlighet och bristande efterlevnad av enkla regler.
Även en så enkel bild hjälper oss att förstå vad ett datalager är, dess skillnader från traditionell datalagring och dess grundläggande element:
- Dataimport (Ingestion) — en nyckelkomponent i ett datalager. Data kan komma in i datalagret på två sätt — batch (laddning med intervall) och streaming (datastreaming).
- Filarkiv (Storage) — huvudkomponenten i ett datalager. Vi behöver ett lagringssystem som är lätt skalbart, extremt pålitligt och har låg kostnad. Till exempel, i AWS är detta S3.
- Katalog och Sök (Katalog och Sökning) — för att undvika datamyren (detta är när vi slänger alla data i en hög, och sedan är de omöjliga att arbeta med) behöver vi skapa ett lager av metadata för att klassificera data, så att användarna enkelt kan hitta den data de behöver för analys. Dessutom kan vi använda ytterligare lösningar för sökning, till exempel ElasticSearch. Sökning hjälper användaren att hitta den nödvändiga datan genom ett enkelt gränssnitt.
- Bearbetning (Process) — detta steg ansvarar för bearbetning och transformation av data. Vi kan transformera data, ändra deras strukturer, rensa dem och mycket mer.
- Säkerhet (Säkerhet) — det är viktigt att avsätta tid för att utforma säkerhetslösningen. Till exempel data-kryptering vid lagring, bearbetning och överföring. Det är viktigt att använda autentiserings- och auktoriseringsmetoder. I slutändan behövs ett revisionsverktyg.
Från ett praktiskt perspektiv kan vi karakterisera dataläget med tre attribut:
- Samla och lagra vad som helst — dataläget innehåller all data, både råa oprocessade data under vilken tidsperiod som helst samt bearbetade/rensade data.
- Djup analys — dataläget gör det möjligt för användarna att utforska och analysera data.
- Flexibel åtkomst — dataläget erbjuder flexibel åtkomst till olika data och olika scenarier.
Nu kan vi prata om skillnaden mellan datalager och dataläge. Vanligtvis undrar folk:
- Men vad sägs om datalagret?
- Byter vi ut datalagret mot dataläget eller utökar vi det?
- Kan vi verkligen klara oss utan dataläget?
I korthet, det finns inget klart svar. Allt beror på den specifika situationen, kunskaperna i teamet och budgeten. Till exempel migrering av datalagret från Oracle till AWS och att skapa ett dataläge av dotterföretaget Amazon — Woot — .
Å andra sidan hävdar leverantören Snowflake att du inte längre behöver tänka på dataläget, eftersom deras dataplattform (fram till 2020 var detta datalagret) låter dig kombinera både dataläge och datalager. Jag har jobbat lite med Snowflake, och det är faktiskt en unik produkt som kan göra så. Kostnaden är en annan fråga.
Avslutningsvis anser jag personligen att vi fortfarande behöver ett datalager som vår primära datakälla för rapportering, och allt som inte får plats lagrar vi i ett datalager. Hela roll för analys är att tillhandahålla enkel åtkomst för företaget för beslutsfattande. Företagsanvändare arbetar helt enkelt mer effektivt med ett datalager än med ett datalager, till exempel i Amazon — där finns Redshift (ett analytiskt datalager) och Redshift Spectrum/Athena (SQL-gränssnitt för datalagret i S3 baserat på Hive/Presto). Detsamma gäller andra moderna analytiska datalagren.
Låt oss titta på en typisk arkitektur för ett datalager:
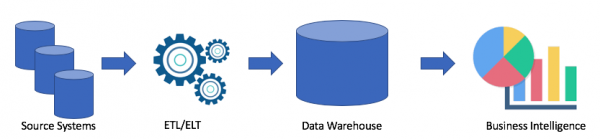
Detta är en klassisk lösning. Vi har källsystem, med hjälp av ETL/ELT kopierar vi data till det analytiska datalagret och kopplar det till en Business Intelligence-lösning (min favorit är Tableau, vad är din?).
Denna lösning har följande nackdelar:
- ETL/ELT-operationer kräver tid och resurser.
- Som regel är lagring för data i det analytiska datalagret inte billigt (till exempel Redshift, BigQuery, Teradata), eftersom vi behöver köpa en hel kluster.
- Företagsanvändare har tillgång till rengjorda och ofta aggregerade data och de har ingen möjlighet att få rådata.
Självklart beror allt på ditt fall. Om du inte har problem med ditt datalager, så behöver du överhuvudtaget inte ett datalager. Men när problem med brist på utrymme, kapacitet eller kostnaden är avgörande kan man överväga ett datalager. Just därför är datalagret mycket populärt. Här är ett exempel på arkitekturen för ett datalager:
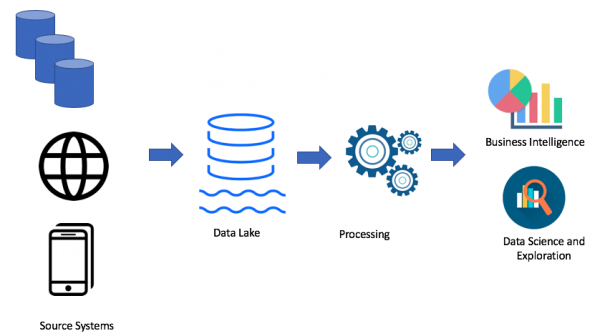
Genom att använda datalageransatsen laddar vi rådata till vårt datalager (batch eller streaming), och vi bearbetar data vid behov. Datalagret gör det möjligt för företagsanvändare att skapa sina egna datatransformationer (ETL/ELT) eller analysera data i Business Intelligence-lösningar (om rätt drivrutin finns).
Målet med varje analytisk lösning är att tjäna företagsanvändare. Därför måste vi alltid arbeta utifrån affärens krav. (I Amazon är detta en av principerna — arbeta baklänges).
Genom att arbeta med både datalager och datalager kan vi jämföra båda lösningarna:
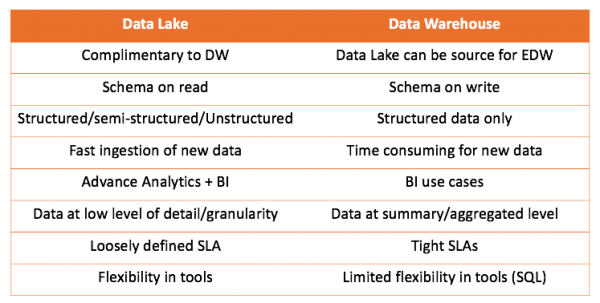
Den huvudsakliga slutsatsen man kan dra är att datalagret inte konkurrerar med dataläget, utan snarare kompletterar det. Men det är upp till er att avgöra vad som är bäst för ert fall. Det är alltid intressant att prova själv och dra rätt slutsatser.
Jag skulle också vilja berätta om ett av de fall där jag började använda datalägesmetoden. Allt är ganska banalt, jag försökte använda ett ELT-verktyg (vi hade Matillion ETL) och Amazon Redshift, min lösning fungerade, men den klarade inte kraven.
Jag behövde ta webbloggar, transformera dem och aggregera dem för att tillhandahålla data för två fall:
- Marknadsföringsteamet ville analysera botaktivitet för SEO
- IT ville se metrik för webbplatsers prestanda
Mycket enkelt, mycket enkla loggar. Här är ett exempel:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
En fil vägde 1-4 megabyte.
Men det fanns ett problem. Vi hade 7 domäner över hela världen, och på en dag skapades 7000 filer. Det är inte en särskilt stor mängd, totalt 50 gigabyte. Men storleken på vår Redshift-kluster var också liten (4 noder). Att ladda ett enda fil på traditionellt sätt tog cirka en minut. Så, uppgiften kunde inte lösas direkt. Och det här var det tillfället när jag beslutade att använda datalägesmetoden. Lösningen såg ut ungefär så här:
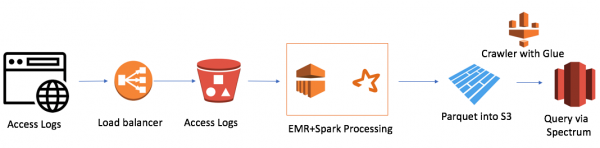
Den var ganska enkel (jag vill påpeka att fördelen med att arbeta i molnet är enkelheten). Jag använde:
- AWS Elastic Map Reduce (Hadoop) som datorkraft
- AWS S3 som filinfrastruktur med möjlighet till datakryptering och behörighetsindelning
- Spark som InMemory datorkraft och PySpark för logik och datatransformation
- Parquet som resultatet av Sparks arbete
- AWS Glue Crawler som metadata-insamlare om nya data och partitioner
- Redshift Spectrum som SQL-gränssnitt till dataläget för befintliga användare av Redshift
Den minsta EMR+Spark-klustret bearbetade hela batchen av filer på 30 minuter. Det finns också andra fall för AWS, särskilt många relaterade till Alexa, där det finns mycket data.
Nyligen upptäckte jag en av nackdelarna med ett datalager – det är GDPR. Problemet är att när en kund ber om att få sina uppgifter raderade och informationen finns i en av filerna, kan vi inte använda Data Manipulation Language och DELETE-operationen som i en databas.
Jag hoppas att artikeln klargjorde skillnaden mellan datalager och datalake. Om det var intressant kan jag översätta fler av mina artiklar eller artiklar från de yrkespersoner jag läser. Jag kan också berätta om de lösningar jag arbetar med och deras arkitektur.
Källa: habr.com
