

För att helt förstå Kubernetes måste man känna till olika sätt att skala klusterresurser: enligt , är detta en av de viktigaste uppgifterna för Kubernetes. Vi har förberett en översikt av mekanismerna för horisontell och vertikal autoskalering samt storleksändring av kluster, tillsammans med rekommendationer om hur man effektivt använder dem.
Artikeln översattes av teamet som implementerade autoskalering i .
Varför det är viktigt att tänka på skalning
— ett verktyg för att hantera resurser och orkestrering. Naturligtvis är det bra att arbeta med fantastiska funktioner för distribution, övervakning och hantering av pods (pod-modulen är en grupp containrar som körs som svar på en begäran).
Men man bör också tänka på följande frågor:
- Hur skalar man moduler och applikationer?
- Hur håller man containrarna i drift och effektiva?
- Hur reagerar man på ständiga förändringar i koden och användarbelastningen?
Att konfigurera Kubernetes-kluster för resurs- och prestandabalans kan vara en komplex uppgift, det kräver expertkunskap om hur Kubernetes fungerar. Arbetsbelastningen på din applikation eller tjänster kan variera under dagen eller till och med under en timme, så balans bör ses som en kontinuerlig process.
Nivåerna av Kubernetes-autoskisering
Effektiv autoskalering kräver samordning mellan två nivåer:
- Pod-nivån, som inkluderar horisontell (Horizontal Pod Autoscaler, HPA) och vertikal autoskalering (Vertical Pod Autoscaler, VPA). Detta är skalning av befintliga resurser för dina containrar.
- Klusternivån, som hanteras av cluster autoscalersystemet (Cluster Autoscaler, CA), vilket ökar eller minskar antalet noder inom klustret.
Modulen för horisontell autoskalering (HPA)
Som namnet antyder, skalar HPA antalet repliker av pods. Som triggere för att ändra antalet repliker använder de flesta DevOps-belastning på processor och minne. Men man kan även skala systemet baserat på , deras eller till och med .
Översikt över hur HPA fungerar:
- HPA övervakar kontinuerligt de metrikvärden som angavs vid installationen, med ett standardintervall på 30 sekunder.
- HPA försöker öka antalet moduler om det angivna tröskelvärdet har nåtts.
- HPA uppdaterar antalet replikor inom distributions-/replikatorns kontroller.
- Distributions-/replikatorns kontroller distribuerar sedan alla nödvändiga ytterligare moduler.
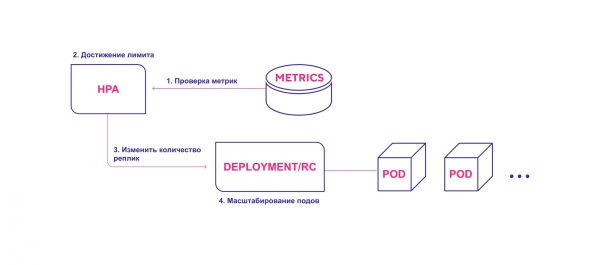
HPA initierar distributionsprocessen av moduler när tröskelvärdet för metrikvärdena nås.
Vid användning av HPA bör följande beaktas:
- Standardintervall för HPA:s kontroll är 30 sekunder. Det ställs in med flaggan horizontal-pod-autoscaler-sync-period i kontrolleraren.
- Den relativa felmarginalen är som standard 10%.
- Efter den senaste ökningen av antalet moduler väntar HPA på att metrikvärdena ska stabiliseras under tre minuter. Detta intervall ställs in med flaggan horizontal-pod-autoscaler-upscale-delay.
- Efter den senaste minskningen av antalet moduler väntar HPA på stabilisering under fem minuter. Detta intervall ställs in med flaggan horizontal-pod-autoscaler-downscale-delay.
- HPA fungerar bäst med distributionsobjekt, inte med replikatorer. Horisontell autoskalning är inkompatibel med rullande uppdatering (rolling update), som direkt manipulerar med replikatorer. Vid distribution beror antalet replikor direkt på distributionsobjekten.
Vertikal autoskalning av pods
Vertikal autoskalning (VPA) tilldelar mer (eller mindre) CPU-tid eller minneskapacitet till befintliga pods. Det passar för både stateful- och stateless-pods, men är främst avsett för stateful-tjänster. Som tur är kan du också tillämpa VPA på moduler utan bevarande av tillstånd om det behövs för att automatiskt justera mängden ursprungligt tilldelade resurser.
VPA reagerar också på OOM-händelser (out of memory, otillräckligt med minne). För att ändra CPU-tiden och minnesmängden krävs en omstart av pods. Vid omstart följer VPA fördelningsbudgeten () för att säkerställa det minimalt nödvändiga antalet moduler.
Du kan ställa in minimala och maximala resurser för varje modul. Så kan du begränsa den maximala tilldelningen av minne till 8 GB. Detta är användbart om de aktuella noderna inte kan tilldela mer än 8 GB minne till containern. Detaljerade specifikationer och hur det fungerar beskrivs i .
Dessutom har VPA en intressant rekommendationsfunktion (VPA Recommender). Den spårar resursanvändning och OOM-händelser för alla moduler för att föreslå nya värden för minne och CPU-tid baserat på en intelligent algoritm med historiska mätvärden i åtanke. Det finns också ett API-gränssnitt som tar emot en pod-descriptor och returnerar föreslagna resursvärden.
Det är värt att notera att VPA Recommender inte spårar "gränsen" för resurser. Detta kan leda till att modulen monopoliserar resurserna inom noderna. Det är bättre att ställa in ett gränsvärde på namnutrymmet för att undvika enorm minnes- eller CPU-tidsförbrukning.
Översiktlig arbetsstruktur för VPA:
- VPA övervakar kontinuerligt de metrikvärden som anges vid installationen med en standardintervall på 10 sekunder.
- Om den angivna tröskeln nås försöker VPA att ändra den tilldelade mängden resurser.
- VPA uppdaterar mängden resurser inom distributions-/replikationskontrollern.
- Vid omstart av moduler tillämpas alla nya resurser på de skapade instanserna.
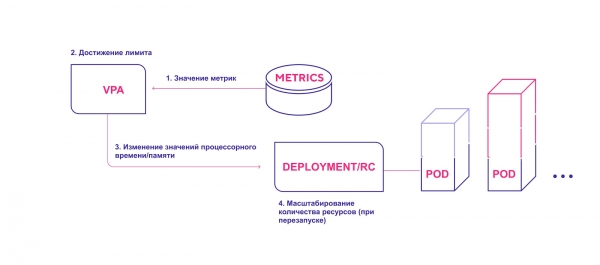
VPA lägger till det nödvändiga antalet resurser
Tänk på följande punkter vid användning av VPA:
- Skalning kräver att podden måste startas om. Detta behövs för att undvika instabilitet efter ändringar. För tillförlitlighet omstartar modulerna och fördelar dem över noder baserat på de nya tilldelade resurserna.
- VPA och HPA är för närvarande inkompatibla med varandra och kan inte fungera på samma poddar. Om du använder båda skalningsmekanismerna i samma kluster, se till att inställningarna inte tillåter dem att aktiveras på samma objekt.
- VPA justerar containerförfrågningar på resurser baserat endast på tidigare och nuvarande användning. Den sätter inga resursanvändningsgränser. Problem kan uppstå med appar som börjar ta mer och mer resurser, vilket kan leda till att Kubernetes stänger av denna pod.
- VPA är fortfarande i ett tidigt utvecklingsskede. Var beredd på att systemet kan genomgå vissa förändringar inom kort. Du kan läsa om och . Så, bland planerna är att implementera samarbete mellan VPA och HPA, samt att distribuera moduler med en vertikal autoskaleringpolicy för dem (t.ex. en speciell etikett 'requires VPA').
Automatisk skalning av Kubernetes-klustret
Cluster Autoscaler (CA) ändrar antalet noder baserat på antalet väntande pod-moduler. Systemet kontrollerar periodiskt om det finns väntande moduler — och ökar klusterstorleken om mer resurser behövs och om klustret inte överskrider satta gränser. CA interagerar med molnleverantören för att begära ytterligare noder eller frigöra inaktiva. Den första offentliga versionen av CA introducerades i Kubernetes 1.8.
Hög nivå översikt av CA:s funktion:
- CA kontrollerar väntande moduler med en standardintervall på 10 sekunder.
- Om en eller flera moduler väntar på grund av att klustret har otillräckliga tillgängliga resurser för att distribuera dem, försöker den förbereda en eller flera extra noder.
- När molnleverantören tilldelar den nödvändiga noden ansluts den till klustret och är redo att betjäna pod-moduler.
- Kubernetes-schemaläggaren distribuerar väntande moduler till den nya noden. Om vissa moduler fortfarande förblir i väntande status upprepas processen — och nya noder läggs till i klustret.
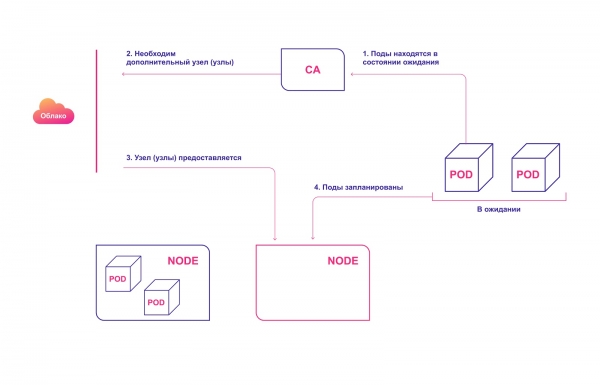
Automatisk tilldelning av klusternoder i molnet
Tänk på följande när du använder CA:
- CA garanterar att alla moduler i klustret har plats att köras, oavsett CPU-belastning. Dessutom försöker den säkerställa att det inte finns några onödiga noder i klustret.
- CA registrerar behovet av att skala upp efter ungefär 30 sekunder.
- När en nod inte längre behövs väntar CA som standard i 10 minuter innan den skalar ner systemet.
- I det automatiska skalningssystemet finns begreppet expanderare. Dessa är olika strategier för att välja en grupp noder där nya noder ska läggas till.
- Använd alternativet ansvarsfullt cluster-autoscaler.kubernetes.io/safe-to-evict (true). Om du har för många pods eller om många av dem är spridda över noderna, kommer du i stor utsträckning att förlora möjligheten att skala ner klustret.
- Använd , för att förhindra att pods tas bort, vilket kan leda till att delar av din applikation helt slutar fungera.
Hur Kubernetes automatiska skalningssystem samverkar
För perfekt harmoni bör både pod skalning (HPA/VPA) och kluster skalning tillämpas. De kan relativt enkelt samverka:
- HPA eller VPA uppdaterar antalet replicerade pods eller resurser tilldelade befintliga pods.
- Om det saknas noder för planerad skalning upptäcker CA pods som är i väntande tillstånd.
- CA tilldelar nya noder.
- Moduler distribueras över de nya noderna.
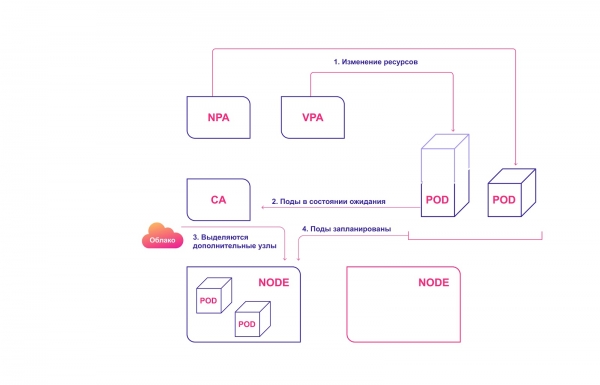
Gemensamt Kubernetes skalningssystem
Typiska fel vid Kubernetes automatisk skalning
Det finns flera typiska problem som devops-team står inför när de försöker implementera automatisk skalning.
HPA och VPA är beroende av mätvärden och viss historik. Om det inte tilldelas tillräckliga resurser kommer modulerna att minskas och inte kunna generera mätvärden. I så fall kommer automatisk skalning aldrig att äga rum.
Själva skalningsoperationen är tidskänslig. Vi vill att moduler och kluster ska skalas snabbt – innan användarna märker några problem eller avbrott. Därför ska genomsnittlig tid för skalning av pods och kluster beaktas.
Det perfekta scenariot – 4 minuter:
- 30 sekunder. Uppdatering av mål-mätvärden: 30-60 sekunder.
- 30 sekunder. HPA kontrollerar mätvärden: 30 sekunder.
- Mindre än 2 sekunder. Pods skapas och går in i väntande tillstånd: 1 sekund.
- Mindre än 2 sekunder. CA ser väntande moduler och skickar anrop för att förbereda noder: 1 sekund.
- 3 minuter. Molnleverantören tilldelar noder. K8s väntar tills de är redo: upp till 10 minuter (beroende på flera faktorer).
Den sämsta (mer realistiska) scenariot är 12 minuter:
- 30 sekunder. Uppdaterar mått.
- 30 sekunder. HPA kontrollerar mätvärden.
- Mindre än 2 sekunder. Podmoduler skapas och går i väntande tillstånd.
- Mindre än 2 sekunder. CA ser de väntande modulerna och skickar begärningar för att förbereda noder.
- 10 minuter. Molnleverantören tilldelar noder. K8s väntar tills de är redo. Väntetiden beror på flera faktorer, såsom leverantörens fördröjning, OS-fördröjning och drift av hjälpsystem.
Blanda inte molnleverantörernas skalningsmekanismer med vår CA. Den senare arbetar inom Kubernetes-klustret, medan molnleverantörens mekanism fungerar utifrån noddistribution. Den vet inte vad som händer med dina poddar eller applikationen. Dessa system arbetar parallellt.
Hur man hanterar skalning i Kubernetes
- Kubernetes är ett verktyg för resursstyrning och orkestrering. Hantering av poddar och klustrets resurser är en nyckelpunkt i att bemästra Kubernetes.
- Förstå logiken för poddars skalbarhet med hänsyn till HPA och VPA.
- CA bör användas endast om du har en god förståelse för dina poddar och containrers behov.
- För optimal konfiguration av klustret måste du förstå hur olika skalningssystem fungerar tillsammans.
- Vid bedömning av skalningstid, ha i åtanke det sämsta och bästa scenariot.
Källa: habr.com
