

Hej, Habr-användare. Traditionellt fortsätter vi att dela intressant material inför starten av nya kurser. Idag har vi särskilt översatt en artikel om Google Cloud Spanner, i samband med lanseringen av kursen. .
Ursprungligen publicerad i .
Som ett företag som erbjuder många molnbaserade POS-lösningar för detaljhandlare, restauranger och onlinehandlare över hela världen, använder Lightspeed flera olika typer av databaser för olika transaktions-, analytiska och sökfall. Varje databasplattform har sina egna styrkor och svagheter. När Google därför introducerade Cloud Spanner på marknaden — med lovande funktioner som aldrig tidigare skådade inom relationsdatabaser, såsom praktiskt taget obegränsad horisontell skalbarhet och 99,999% servicenivåavtal (SLA) — kunde vi inte missa chansen att få den i våra händer!
För att ge en uttömmande översikt över våra erfarenheter med Cloud Spanner samt de bedömningskriterier vi använde, kommer vi att behandla följande ämnen:
- Våra bedömningskriterier
- Cloud Spanner i korthet
- Vår bedömning
- Våra slutsatser
1. Våra bedömningskriterier
Innan vi går in på egenskaperna hos Cloud Spanner, dess likheter och skillnader med andra lösningar på marknaden, låt oss först diskutera de huvudsakliga användningsfallen som vi beaktade när vi övervägde var Cloud Spanner skulle implementeras i vår infrastruktur:
- Som en ersättning för det dominerande traditionella SQL-databassystemet
- Som en OLTP-lösning med stöd för OLAP
Anmärkning: För att förenkla och jämföra, jämför denna artikel Cloud Spanner med MySQL-alternativen i GCP Cloud SQL och Amazon AWS RDS-familjerna.
Användning av Cloud Spanner som ersättning för traditionella SQL-databassystem
I en miljö av traditionella databaser, när svarstiden för databasfrågor närmar sig eller till och med överstiger fördefinierade tröskelvärden för applikationen (oftast på grund av ökat antal användare och/eller frågor), finns det flera sätt att sänka svarstiden till acceptabla nivåer. Men de flesta av dessa lösningar involverar manuell inblandning.
Till exempel, det första steget att ta är att titta på de olika databasparametrarna relaterade till prestanda och justera dem för att bäst matcha användningsmönstren för applikationerna. Om detta visar sig vara otillräckligt kan man välja att skala databasen vertikalt eller horisontellt.
Vertikal skalning av applikationen innebär att man uppgraderar serverinstansen, vanligtvis genom att lägga till fler processorer/kärnor, mer RAM, snabbare lagring osv. Att lägga till fler hårdvaruresurser ledar till ökad databaspresentation, mätt i stort sett i transaktioner per sekund och transaktionsfördröjning för OLTP-system. Relationsdatabassystem (som använder en flertrådad metod) som MySQL kan skalas bra vertikalt.
Denna metod har flera nackdelar, men den mest uppenbara är den maximala serverstorleken på marknaden. När gränsen för den största serverinstansen har uppnåtts finns det bara en väg kvar: horisontell skalning.
Horisontell skalning är en metod där fler servrar läggs till klustret för att i idealfallet linjärt öka prestanda med en ökning av antalet servrar. De flesta av traditionella databassystem är förstörd för horisontell skalning eller kan överhuvudtaget inte skalas. Till exempel kan MySQL horisontellt skalas för läsoperationer genom att lägga till slave-läsare, men kan inte horisontellt skalas för skrivoperationer.
Å andra sidan kan Cloud Spanner tack vare sin natur enkelt skalas horisontellt med minimal inblandning.
Fullfjädrad DBMS som en tjänst bör utvärderas från olika perspektiv. Som grund har vi tagit den mest populära databasen i molnet – för Google, GCP Cloud SQL och för Amazon, AWS RDS. I vår utvärdering har vi fokuserat på följande kategorier:
- Funktionalitet: SQL-utvidgningar, DDL, DML; anslutningsbibliotek/anslutare, transaktionsstöd osv.
- Stöd för utveckling: enkelhet i utveckling och testning.
- Administration support: instance management — for example, scaling up/down and upgrading instances; SLA, backup and recovery; security/access control.
Using Cloud Spanner as an OLTP solution with OLAP support
Although Google does not explicitly claim that Cloud Spanner is intended for analytics processing, it shares some attributes with other mechanisms, such as Apache Impala & Kudu and YugaByte, that are designed for OLAP workloads.
Even if there was only a small chance that Cloud Spanner included a horizontally scalable HTAP (hybrid transactional/analytical processing) engine with a (more or less) usable set of OLAP features, we believe it would deserve our attention.
With this in mind, we considered the following categories:
- Data loading, indexing, and partitioning support
- Query performance and DML
2. Cloud Spanner in brief
Google Spanner is a clustered relational database management system (RDBMS) used by Google for several of its own services. Google made it publicly available to Google Cloud Platform users in early 2017.
Here are some of the attributes of Cloud Spanner:
- Strongly consistent scalable cluster RDBMS: uses hardware time synchronization to ensure data consistency.
- Support for cross-table transactions: transactions can span multiple tables — not necessarily limited to a single table (unlike Apache HBase or Apache Kudu).
- Primary key-based tables: all tables must have a declared primary key (PK), which can consist of multiple columns of the table. Tabular data is stored in PK order, making it very efficient and fast for lookups by PK. Like other PK-based systems, the implementation must be modeled with an eye toward well-thought-out use cases for achieving .
- Alternativa tabeller: tabeller kan ha fysiska beroenden av varandra. Rader i en underordnad tabell kan kopplas samman med rader i en överordnad tabell. Denna metod snabbar upp sökningen efter förhållanden som kan bestämmas under datamodelleringssteget, till exempel vid gemensam placering av kunder och deras fakturor.
- Index: Cloud Spanner stöder sekundära index. Ett index består av indexerade kolumner och alla kolumner i primärnyckeln. Om så önskas kan indexet också innehålla andra icke-indexerade kolumner. Indexet kan samverka med den överordnade tabellen för att påskynda förfrågningar. Det finns flera begränsningar för index, till exempel det maximala antalet extra kolumner som lagras i indexet. Förfrågningar via index kan även vara mer komplicerade än i andra relationsdatabaser.
„Cloud Spanner väljer automatiskt index endast i sällsynta fall. I synnerhet väljer Cloud Spanner inte automatiskt ett sekundärt index om förfrågan begär några kolumner som inte är lagrade i ».
- Service Level Agreement (SLA): distribution i en region med SLA på 99,99%; flerdelade distributioner med 99,999% SLA. Även om själva avtalet om servicenivå bara är ett avtal och ingen garanti, tror jag att Googles anställda har något exakt data som gör det möjligt att göra ett så allvarligt påstående. (För referens betyder 99,999% 26,3 sekunder av tjänstens otillgänglighet per månad.)
- Mer:
Anmärkning: Apache Tephra-projektet lägger till utökat stöd för transaktioner i Apache HBase (som nu också implementeras i Apache Phoenix i beta-version).
3. Vår bedömning
Så, vi har alla läst Googles påståenden om fördelarna med Cloud Spanner – praktiskt taget oändlig horisontell skalning med bibehållen hög konsistens och mycket hög SLA. Även om dessa krav är extremt svåra att uppnå, var vårt mål inte att motsäga dem. Låt oss istället fokusera på andra saker som bekymrar de flesta databas-användare: användbarhet och lätthet.
Vi bedömde Cloud Spanner som en ersättning för Sharded MySQL
Google Cloud SQL och Amazon AWS RDS, två av de mest populära OLTP-databaserna på marknaden för molntjänster, har en mycket omfattande uppsättning funktioner. För att dock skala dessa databaser bortom storleken på en enda nod, måste du implementera applikationspartitionering. Denna strategi skapar ytterligare komplexitet både för applikationerna och för administrationen. Vi har undersökt hur Spanner passar in i scenariot där flera segment samlas i en instans och vilka funktioner (om några) som kanske måste offras.
Stöd för SQL, DML och DDL, samt anslutare och bibliotek?
Först och främst, när du arbetar med vilken databas som helst måste du skapa en datamodell. Om du tror att du kan koppla JDBC Spanner till ditt favorit SQL-verktyg, kommer du att märka att du kan fråga dina data med det, men du kan inte använda det för att skapa tabeller eller göra ändringar (DDL) eller några insättnings-/uppdaterings-/raderingsoperationer (DML). Googles officiella JDBC stöder varken det ena eller det andra.
"För närvarande stöder drivrutinerna inte DML- eller DDL-satser."
Spanner-dokumentation
Med GCP-konsolen är situationen inte heller bättre — du kan endast skicka SELECT-frågor. Lyckligtvis finns det en JDBC-drivrutin med stöd för DML och DDL från gemenskapen, inklusive transaktioner. . Även om denna drivrutin är oerhört användbar, väcker avsaknaden av en egen JDBC-drivrutin från Google förvåning. Lyckligtvis erbjuder Google ganska bra stöd för klientbibliotek (baserat på gRPC): C#, Go, Java, node.js, PHP, Python och Ruby.
De nästan obligatoriska användningarna av anpassade API:er för Cloud Spanner (på grund av bristen på DDL och DML i JDBC) leder till vissa begränsningar för relaterade kodområden, såsom anslutningspooler eller databindningsramverk (till exempel Spring MVC). I allmänhet kan man vid användning av JDBC fritt välja sin favoritanslutningspool (till exempel HikariCP, DBCP, C3PO osv.) som har testats och fungerar bra. För anpassade API:er i Spanner måste vi förlita oss på de ramverk/pooler för bindning/Sessioner som vi har skapat själva.
Primärnyckelsinriktad konstruktion gör att Cloud Spanner är mycket snabb vid databasåtkomst via primärnyckeln, men leder också till vissa problem med frågor.
- Du kan inte uppdatera värdet av primärnyckeln; du måste först ta bort posten med den ursprungliga PK och infoga den igen med det nya värdet. (Detta liknar andra PK-orienterade databaser/lagringsmekanismer.)
- Alla UPDATE- och DELETE-operatorer måste ange PK i WHERE, därför kan det inte finnas tomma DELETE all-operatorer — det måste alltid finnas en underfråga, till exempel: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Avsaknad av autoinkrement eller något liknande som anger sekvensen för PK-fältet. För att detta ska fungera måste det motsvarande värdet skapas på applikationens sida.
Sekundära index?
Google Cloud Spanner har inbyggt stöd för sekundära index. Detta är en mycket trevlig funktion som inte alltid finns i andra teknologier. Apache Kudu stöder för närvarande överhuvudtaget inte sekundära index, och Apache HBase stöder inte index direkt men kan lägga till dem via Apache Phoenix.
Index i Kudu och HBase kan modelleras som en separat tabell med olika sammansättningar av primärnycklar, men atomäriteten för operationer som utförs med den primära tabellen och de relaterade index-tabellerna måste genomföras på applikationsnivå och är inte trivial i en korrekt implementering.
Som nämnts i översikten av Cloud Spanner kan dess index skilja sig från MySQL-index. Därför bör man vara särskilt försiktig vid byggandet av frågor och profilering för att säkerställa användningen av rätt index där det är nödvändigt.
Vyern?
En mycket populär och användbar objekt i databasen är vyer. De kan vara användbara för en mängd olika användningsfall; två av mina favoriter är logisk abstraheringsnivå och säkerhetsnivå. Tyvärr stödjer Cloud Spanner INTE vyer. Men detta begränsar oss endast delvis, eftersom det inte finns någon detaljering på kolumnivå för åtkomsträttigheter där vyer kan vara en acceptabel lösning.
I Cloud Spanners dokumentation finns det en sektion där kvoter och begränsningar beskrivs i detalj (), det finns, särskilt, en som kan vara problematisk för vissa applikationer: Cloud Spanner har som standard en gräns på högst 100 databaser per instans. Det är uppenbart att detta kan bli ett allvarligt hinder för en databas som är avsedd att skalas över mer än 100 databaser. Som tur är, efter att ha pratat med vår tekniska representant på Google, fick vi veta att denna gräns kan ökas till praktiskt taget vilket värde som helst via Googles support.
Stöd för utveckling?
Cloud Spanner erbjuder ganska bra stöd för programmeringsspråk för att arbeta med sitt API. Officiellt stödda bibliotek finns inom C#, Go, Java, node.js, PHP, Python och Ruby. Dokumentationen är ganska detaljerad, men som med andra avancerade teknologier är gemenskapen relativt liten jämfört med de mest populära databasteknologierna, vilket kan leda till ökad tid som spenderas på att lösa mindre vanliga användningsfall eller problem.
Så, hur är det med stödet för lokal utveckling?
Vi hittade inget sätt att skapa en Cloud Spanner-instans i en lokal miljö. Det närmaste vi fick var en Docker-avbildning , vilket i princip liknar, men i praktiken skiljer sig mycket. Till exempel kan CockroachDB använda PostgreSQL JDBC. Eftersom utvecklingsmiljön måste vara så nära produktionsmiljön som möjligt, är Cloud Spanner inte idealisk, eftersom man måste förlita sig på en fullständig Spanner-instans. För att spara kostnader kan du välja en instans för en region.
Stöd för administration?
Att skapa en Cloud Spanner-instans är mycket enkelt. Du behöver bara välja mellan att skapa en multiregional instans eller en instans för en region, ange region(er) och antal noder. På mindre än en minut kommer instansen att starta och vara redo att användas.
Några grundläggande mätvärden är direkt tillgängliga på Spanner-sidan i Google Console. Mer detaljerade vyer är tillgängliga via Stackdriver, där du också kan ställa in tröskelvärden för mätvärden och aviseringar.
Tillgång till resurser?
MySQL erbjuder omfattande och mycket detaljerade inställningar för användarrättigheter/roller. Det är enkelt att konfigurera åtkomst till en specifik tabell eller till och med bara ett delmängd av dess kolumner. Cloud Spanner använder Google Identity & Access Management (IAM), vilket gör att du kan ställa in policyer och åtkomsträttigheter på en mycket hög nivå. Den mest detaljerade versionen är databasnivåtillstånd, vilket inte passar in i de flesta produktionsfall. Denna begränsning tvingar dig att lägga till ytterligare säkerhetsåtgärder i din kod, infrastruktur eller båda för att förhindra obehörig användning av Spanner-resurser.
Säkerhetskopior?
För att säga det enkelt, det finns inga säkerhetskopior i Cloud Spanner. Även om Googles höga SLA-krav kan garantera att du inte förlorar några data på grund av hårdvarufel eller databasproblem, skyddar det inte mot mänskliga misstag, applikationsfel osv. Vi vet alla regeln: hög tillgänglighet ersätter inte en rimlig säkerhetskopieringsstrategi. För närvarande är det enda sättet att säkerhetskopiera data att programvaru-streama dem från databasen till en separat lagringsmiljö.
Frågeprestanda?
För datainläsning och testning av frågor använde vi Yahoo! Cloud Serving Benchmark. Tabellen nedan visar arbetsbelastningen B YCSB med läsningskvot 95 % och skrivkvot 5 %.
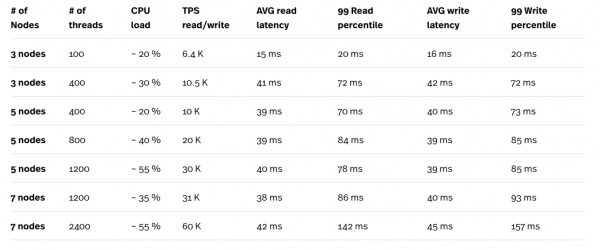
* Belastningstestet utfördes på beräkningsmotorn (CE) n1-standard-32 (32 vCPU, 120 GB RAM), och testinstansen var aldrig en flaskhals i testerna.
** Det maximala antalet trådar i en YCSB-instans är 400. Totalt behövde sex parallella YCSB-testinstanser köras för att få totalt 2400 trådar.
Tittande på testresultaten, särskilt när det gäller kombinationen av processorbelastning och TPS, ser vi tydligt att Cloud Spanner skalar ganska bra. Den stora belastningen som skapas av många trådar kompenseras av antalet noder i Cloud Spanner-klustret. Även om fördröjningen verkar ganska hög, särskilt vid arbete med 2400 trådar, kan det krävas omtestning med 6 mindre instanser av beräkningsmotorn för att få mer exakta siffror. Varje instans kommer att köra ett YCSB-test istället för en stor CE-instans med 6 parallella tester. På så sätt blir det lättare att särskilja fördröjningarna i Cloud Spanner och de fördröjningar som läggs till genom nätverksanslutningen mellan Cloud Spanner och CE-instansen där testet utförs.
Hur fungerar Cloud Spanner som OLAP?
Partionering?
Att dela upp data i fysiskt och/eller logiskt oberoende segment, kallade partitioner, är en mycket populär idé som är typisk för de flesta OLAP-mekanismer. Partitioner kan avsevärt förbättra frågeprestanda och databasunderhåll. Att gå djupare in på partitioner skulle vara en egen artikel, så låt oss bara nämna vikten av att ha en partitioneringsschema och sub-partionering. Möjligheten att dela upp data i partitioner och till och med vidare i underpartitioner är nyckeln till prestanda i analytiska frågor.
Cloud Spanner stödjer inte partitioner i egentlig mening. Den delar upp data inåt i så kallade split-er baserat på intervall av primära nycklar. Dela upp sker automatiskt för att balansera lasten i Cloud Spanner-klustret. En mycket användbar funktion hos Cloud Spanner är uppdelningen av den grundläggande belastningen av moderntabellen (tabellen som inte alterneras med en annan). Spanner identifierar automatiskt om split data läses oftare än data i andra split-er och kan besluta att ytterligare dela upp. På så sätt kan fler noder involveras i frågan, vilket effektivt ökar genomströmningen.
Datainläsning?
Cloud Spanner-metoden för stora datamängder är densamma som vid vanlig inladdning. För att uppnå maximal prestanda måste du följa vissa rekommendationer, inklusive:
- Sortera dina data efter primärnyckeln.
- Dela upp dem i 10*antal noder separata sektioner.
- Skapa en uppsättning arbetsuppgifter som laddar data parallellt.
Vid denna datainladdning används alla noder i Cloud Spanner.
Vi använde arbetsbelastning A YCSB för att generera en datamängd av 10M rader.
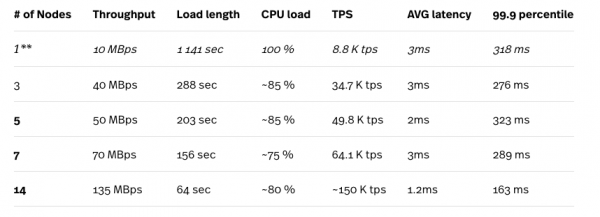
* Belastningstestet genomfördes på beräkningsmotorn n1-standard-32 (32 vCPU, 120 GB minne), och testinstansen var aldrig den begränsande faktorn i testerna.
** Konfiguration med 1 nod rekommenderas inte för något produktionsbelastning.
Som nämnts ovan hanterar Cloud Spanner automatiskt splittringar beroende på deras belastning, så resultaten förbättras efter flera på varandra följande testkörningar. Resultaten här är de bästa vi fick. Genom att titta på siffrorna ovan kan vi se hur Cloud Spanner (bra) skalas med ökande antal noder i klustret. Siffrorna som sticker ut representerar extremt låga genomsnittliga latenser som kontrasterar med resultaten från blandade arbetsbelastningar (95% för läsning och 5% för skrivning), som beskrivs ovan.
Skalning?
Att öka och minska antalet noder i Cloud Spanner är en uppgift som utförs med ett klick. Om du snabbt vill ladda data kan du överväga att öka instansen till max (i vårt fall var det 25 noder i regionen US-EAST), och sedan minska antalet noder till det som passar din normala belastning efter att alla data är i databasen, med tanke på begränsningen på 2 TB/nod.
Vi blev påminda om denna gräns även med en mycket mindre databas. Efter flera körningar av belastningstester hade vår databas en storlek av cirka 155 GB, och vid minskning till en instans med 1 nod fick vi följande felmeddelande:
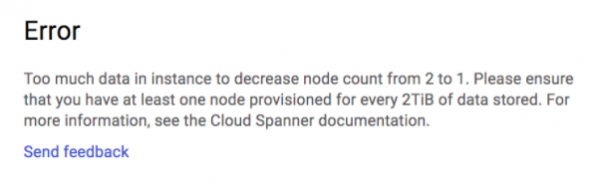
Vi lyckades minska skalan från 25 till 2 instanser, men vi fastnade vid två noder.
Ökningen och minskningen av antalet noder i Cloud Spanner-klustret kan automatiseras med hjälp av REST API. Detta kan vara särskilt användbart för att minska den ökade belastningen på systemet under högtrafikperioder.
Prestanda för OLAP-frågor?
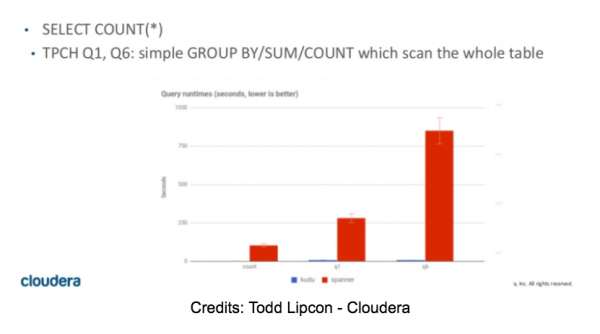
Vi planerade ursprungligen att ägna betydande tid åt vår bedömning av Spanner på denna del. Efter flera SELECT COUNT insåg vi genast att testningen skulle bli kort och att Spanner INTE skulle passa som OLAP-motor. Oavsett antalet noder i klustret tog en enkel fråga för att räkna antalet rader i en tabell med 10 miljoner rader mellan 55 och 60 sekunder. Dessutom ledde varje fråga som krävde mer minne för att lagra mellanresultat till ett OOM-fel.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M distinkta värden) -> SpoolingHashAggregateIterator fick slut på minne under den nya raden.
Vissa siffror för TPC-H-frågor finns i artikeln av Todd Lipkon , bilder 42 och 43. Dessa siffror överensstämmer med våra egna resultat (tyvärr).
4. Våra slutsatser
Med tanke på det nuvarande tillståndet av Cloud Spanner-funktioner är det svårt att föreställa sig en enkel ersättning för ett befintligt OLTP-lösning, särskilt när dina behov överstiger dess kapacitet. Det skulle ta betydande tid att bygga en lösning med tanke på bristerna hos Cloud Spanner.
När vi började utvärdera Cloud Spanner förväntade vi oss att dess hanteringsfunktioner skulle vara på nivå eller åtminstone inte så långt ifrån andra lösningar från Google SQL. Men vi blev överraskade över den totala avsaknaden av säkerhetskopior och mycket begränsad åtkomstkontroll till resurser. För att inte tala om avsaknaden av vyer, bristen på lokala utvecklingsmiljöer, icke-understödda sekvenser, JDBC utan stöd för DML och DDL och så vidare.
Så, vart ska man gå för att skala en transaktionsdatabas? Det verkar finnas många lösningar med både stängd och öppen källkod på marknaden (några av dem nämns i denna artikel), varje med sina styrkor och svagheter, men ingen av dem erbjuder en SaaS-lösning med SLA på 99,999 % och hög grad av överensstämmelse. Om en hög SLA-nivå är ditt främsta mål och du inte är benägen att skapa en egen lösning för flera molnmiljöer, kan Cloud Spanner vara den lösning du söker. Men du bör känna till dess begränsningar.
För rättvisans skull bör det nämnas att Cloud Spanner endast släpptes för allmänheten våren 2017, så det är rimligt att förvänta sig att vissa av dess nuvarande brister så småningom försvinner (förhoppningsvis), och när det händer kan det förändra spelet. Trots allt, Cloud Spanner är inte bara ett sidoprojekt för Google. Google använder det som grund för andra produkter. Och när Google nyligen ersatte Megastore i Google Cloud Storage med Cloud Spanner, gjorde det att Google Cloud Storage blev strikt överenskommet för objektlistor på världsstandard (vilket fortfarande inte gäller för) ).
Så hoppet lever fortfarande... vi hoppas.
Detta är allt. Precis som författaren av artikeln fortsätter vi att hoppas, vad tycker du om detta? Skriv i kommentarerna.
Vi inbjuder alla intresserade att besöka vår där vi kommer att berätta mer om kursen från OTUS.
Källa: habr.com
