

Översättningen av artikeln är särskilt utarbetad för studenter i kursen .
Under de senaste veckorna har vi med lagt till ett binärt strömmande format, som kompletterar det redan befintliga formatet för random access/IPD. Vi har implementationer på Java och C++ samt bindningar för Python. I den här artikeln kommer jag att förklara hur formatet fungerar och visa hur man kan uppnå mycket hög genomströmning för DataFrame pandas.
Strömning av kolumndata
En vanlig fråga som jag får från användare av Arrow är den höga kostnaden för att överföra stora uppsättningar tabulär data från format som är rad- eller postorienterade till kolumnformat. För flera gigabyte dataset kan transponering i minnet eller på disk vara en oöverkomlig uppgift.
För strömning av data, oavsett om de ursprungliga data är i rad- eller kolumnformat, kvarstår ett alternativ att skicka små paket av rader, där varje paket innehåller en kolumnlayout.
I Apache Arrow kallas en samling av kolumnarrayer i minnet, som representerar ett chank av en tabell, för en postbatch (record batch). För att representera en enda databasstruktur av en logisk tabell kan flera postbatcher samlas.
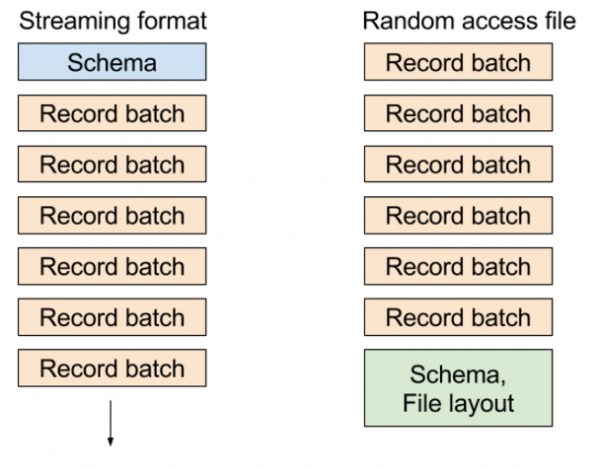
I det befintliga random access-formatet skriver vi metadata som innehåller tabellens schema och blockens placering i slutet av filen, vilket gör att du mycket enkelt kan välja vilken postbatch eller kolumn som helst från datasetet. I det strömmande formatet skickar vi en serie meddelanden: schemat, följt av en eller flera postbatcher.
Olika format ser ungefär ut som det som visas i denna bild:
Strömning av data i PyArrow: tillämpning
För att visa hur detta fungerar kommer jag att skapa ett exempel på en dataset som representerar ett strömmande chank:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Nu, låt oss anta att vi vill skriva 1 Gb av data som består av chankar på 1 Mb vardera, totalt 1024 chankar. För att börja, låt oss skapa den första dataram som är 1 Mb stor med 16 kolumner:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Sedan konverterar jag dem till pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Nu ska jag skapa en utdataström som kommer att skriva till RAM och skapa StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Därefter kommer vi att skriva 1024 block, vilket kommer att sammanfatta 1 GB av data:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Eftersom vi skrev till RAM, kommer vi att kunna få hela strömmen i en enda buffert:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Eftersom dessa data finns i minnet, så är läsningen av Arrow-paket en zero-copy operation. Jag öppnar StreamReader, läser data till pyarrow.Table, och konverterar dem sedan till DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Detta är förstås bra, men du kanske har frågor. Hur snabbt sker detta? Hur påverkar blockstorleken prestandan för att få DataFrame pandas?
Prestanda för datastreaming
När blockstorleken minskar så ökar kostnaden för att rekonstruera ett kontinuerligt kolumnformat DataFrame i pandas på grund av ineffektiva cacheminnesåtkomstscheman. Det finns också vissa overheadkostnader för att arbeta med C++ datatyper och deras minnesbufferar.
För 1 MB, som angivet ovan, får jag på min bärbara dator (Quad-core Xeon E3-1505M):
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Det visar sig att den effektiva bandbredden är 7,75 GB/s för att återställa en DataFrame på 1 GB från 1024 block om 1 MB. Vad händer om vi använder större eller mindre block? Här är resultaten:
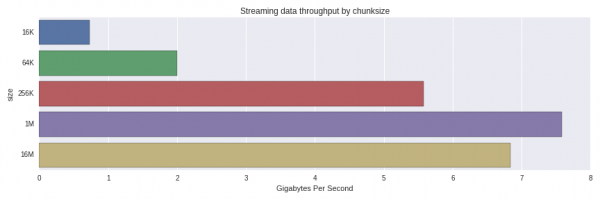
Prestandan minskar avsevärt från 256K till 64K block. Jag blev överraskad över att block om 1 MB hanterades snabbare än 16 MB. Det är värt att göra en grundligare undersökning för att förstå om detta är en normal fördelning eller om något annat spelar in.
I den nuvarande implementeringen av formatet komprimeras data överhuvudtaget inte, så storleken i minnet och "i överföringen" är ungefär densamma. I framtiden kan komprimering bli ett tillval.
Resultat
Strömmande överföring av kolumndata kan vara ett effektivt sätt att överföra stora datamängder till kolumnanalytiska verktyg, såsom pandas, med hjälp av små bitar. Datatjänster som använder lagring inriktad på rader kan överföra och transponera små databit som är mer lämpliga för L2 och L3-cachen i din processor.
Fullständig kod
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Källa: habr.com
