

Standardvillkor för implementering av CI/CD i Kubernetes: applikationen måste kunna sluta ta emot nya kundförfrågningar innan den stängs ner helt, och viktigast av allt - framgångsrikt slutföra redan pågående.
Att följa detta villkor gör det möjligt att uppnå noll driftstopp under distributionen. Men även vid användning av mycket populära kombinationer (som NGINX och PHP-FPM) kan man stöta på svårigheter som leder till en ökning av fel vid varje distribution…
Teori. Hur en pod lever
Vi har redan publicerat detaljer om livscykeln för en pod. . I kontexten av det aktuella ämnet är vi intresserade av följande: i det ögonblicket när en pod går in i tillståndet Terminating, slutar nya förfrågningar att skickas till den (pod från listan över endpoints för tjänsten). Därför räcker det för att undvika driftstopp under distributionen att lösa problemet med korrekt nedstängning av applikationen.
Det är också viktigt att komma ihåg att graceperioden som standard är : efter det kommer podden att termineras och applikationen måste hinna behandla alla förfrågningar före denna period. Anmärkning: även om varje förfrågan som tar mer än 5-10 sekunder redan är problematisk, och gracefull nedstängning kommer inte att hjälpa den…
För att bättre förstå vad som händer när en pod avslutar sin verksamhet är det tillräckligt att studera följande schema:
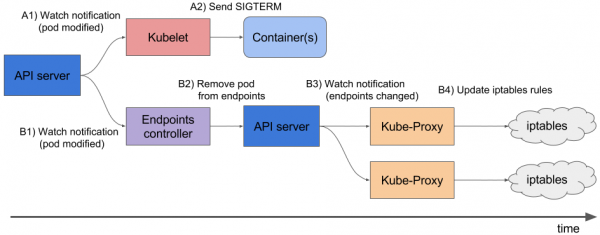
A1, B1 — Mottagande av förändringar i podens tillstånd
A2 — Skicka SIGTERM
B2 — Ta bort podden från endpoints
B3 — Mottagande av förändringar (listan över endpoints har ändrats)
B4 — Uppdatering av iptables-regler
Observera att borttagning av endpointen för podden och skickande av SIGTERM inte sker sekventiellt, utan parallellt. Eftersom Ingress inte får den uppdaterade listan över endpoints omedelbart, kommer nya förfrågningar från kunder att skickas till podden, vilket kommer att orsaka 500 fel under termineringen av podden. (mer detaljerat material om denna fråga har vi ). För att lösa detta problem finns det följande metoder:
- Skicka i svarshuvudena Connection: close (om det rör sig om en HTTP-applikation).
- Om det inte är möjligt att göra ändringar i koden, beskrivs i artikeln nedan en lösning som gör det möjligt att behandla förfrågningar tills slutet av graceperioden.
Teori. Hur NGINX och PHP-FPM avslutar sina processer
NGINX
Vi börjar med NGINX, eftersom allt är relativt uppenbart med det. Genom att dyka ner i teorin lär vi oss att NGINX har en masterprocess och flera "workers" — dessa är barnprocesser som hanterar klientförfrågningar. Det finns en praktisk möjlighet: med hjälp av kommandot nginx -s avsluta processer antingen i fast shutdown-läge eller i graceful shutdown-läge. Det är uppenbart att vi är intresserade av det senare alternativet.
Sedan är det enkelt: vi måste lägga till i ett kommando som kommer att skicka en signal om graceful shutdown. Det kan göras i Deployment, i containerblocket:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Nu, vid nedstängning av podden, kommer vi att se följande i loggarna från NGINX-kontainern:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
Och det kommer att betyda det vi vill: NGINX väntar på att slutföra begärningar, varefter det dödar processen. Nedan kommer vi dock att titta på ett vanligt problem som gör att även med kommandot nginx -s quit processen avslutas onormalt.
Och vid detta stadium har vi avslutat med NGINX: åtminstone kan vi förstå av loggarna att allt fungerar som det ska.
Hur ser det ut med PHP-FPM? Hur hanterar den graceful shutdown? Låt oss reda ut det.
PHP-FPM
När det gäller PHP-FPM finns det mindre information. Om vi orienterar oss på för PHP-FPM, kommer det att berättas att följande POSIX-signaler tas emot:
-
SIGINT,SIGTERM— fast shutdown; -
SIGQUIT— graceful shutdown (det vi behöver).
De övriga signalerna är inte nödvändiga för denna uppgift, så vi hoppar över dem. För att korrekt avsluta processen behöver vi skriva följande preStop-hake:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Vid första anblicken är detta allt som krävs för att utföra graceful shutdown i båda containrarna. Trots detta är uppgiften mer komplex än vad som verkar. Nedan diskuteras två fall där graceful shutdown inte fungerade och orsakade kortvarig otillgänglighet av projektet under deployment.
Praxis. Möjliga problem med graceful shutdown
NGINX
Först och främst är det bra att komma ihåg: utöver att utföra kommandot nginx -s quit finns det en annan steg som är värt att uppmärksamma. Vi har stött på ett problem där NGINX, istället för signalen SIGQUIT, fortfarande skickade SIGTERM, vilket gjorde att begärningarna inte avslutades korrekt. Liknande fall kan hittas, till exempel, . Tyvärr kunde vi inte fastställa den specifika orsaken till detta beteende: vi misstänkte NGINX-versionerna, men det bekräftades inte. Symtomen var att loggarna från NGINX-kontainern visade meddelanden «open socket #10 left in connection 5», efter vilket podden stannar.
Vi kan observera ett sådant problem, till exempel från svaren på vår önskade Ingress:
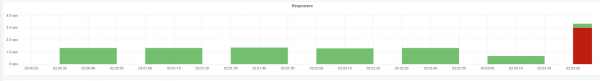
Statuskoders indikatorer vid distribueringsögonblicket
I det här fallet får vi faktiskt 503-felkod från själva Ingress: den kan inte komma åt NGINX-containern eftersom den redan är otillgänglig. Om vi tittar i loggarna för NGINX-containern ser vi följande:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Efter att stoppsignalen har ändrats börjar containern stängas av korrekt: detta bekräftas av att 503-felet inte längre observeras.
Om du har stött på ett liknande problem kan det vara värt att ta reda på vilken stoppsignal som används i containern och hur preStop-hooken ser ut. Det är möjligt att orsaken ligger just här.
PHP-FPM… och inte bara
Problemet med PHP-FPM beskrivs enkelt: det väntar inte på att barnprocesserna ska avslutas, utan terminerar dem, vilket leder till 502-fel under distribution och vid andra operationer. På bugs.php.net har det sedan 2005 funnits flera felrapporter (till exempel, och ), som beskriver detta problem. I loggarna kommer du förmodligen inte att se något: PHP-FPM kommer att meddela att dess process har avslutats utan några fel eller externa meddelanden.
Det är värt att klargöra att själva problemet kan i mindre eller större utsträckning bero på själva applikationen och kanske inte kommer att visas, till exempel i övervakningen. Om du ändå stöter på det, så är den första tanken en enkel workaround: att lägga till en preStop-hook med sleep(30). Det låter alla tidigare begärningar avslutas (och vi accepterar inga nya, eftersom podden redan är i tillståndet Terminating), och efter 30 sekunder kommer podden själv att avslutas med signalen SIGTERM.
Det visar sig att lifecycle för containern kommer att se ut som följer:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Men på grund av den angivna 30-sekunders sleep använder vi ökar vi distributionstiden, eftersom varje pod kommer att termineras minimum i 30 sekunder, vilket är dåligt. Vad kan vi göra åt detta?
Vi vänder oss till den del som ansvarar för den direkta körningen av applikationen. I vårt fall är det PHP-FPM, som i standardinställningen inte övervakar sina barnprocesser: huvudprocessen termineras omedelbart. Detta beteende kan ändras med hjälp av direktivet process_control_timeout, som anger tidsgränser för att vänta på signaler från masterprocessen från underprocesser. Om värdet sätts till 20 sekunder täcker det de flesta förfrågningar som utförs i containern, och efter deras slutförande kommer masterprocessen att stoppas.
Med denna kunskap återvänder vi till vårt senaste problem. Som nämnts är Kubernetes inte en monolitisk plattform: det tar viss tid för interaktion mellan dess olika komponenter. Detta är särskilt relevant när vi överväger arbetet med Ingress och andra relaterade komponenter, eftersom en sådan fördröjning vid distribution lätt kan leda till en topp av 500-fel. Till exempel kan ett fel uppstå vid steget att skicka en förfrågan till upstream, men den faktiska 'tidsfördröjningen' i interaktionen mellan komponenterna är ganska kort — mindre än en sekund.
Därför, totalt med den redan nämnda direktiven process_control_timeout kan följande konstruktion användas för lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
I så fall kompenserar vi för fördröjningen med kommandot sleep och ökar inte i stor grad distributionstiden: det är ju en märkbar skillnad mellan 30 sekunder och en?.. I huvudsak tar process_control_timeout, och lifecycle endast används som en 'säkerhetsåtgärd' i händelse av lag.
Generellt sett, det beskrivna beteendet och motsvarande workaround gäller inte bara PHP-FPM. En liknande situation kan uppstå vid användning av andra språk/ramverk. Om det inte går att åtgärda en korrekt avslutning på andra sätt — till exempel genom att skriva om koden så att applikationen korrekt hanterar avslutningssignaler — kan den beskrivna metoden användas. Den kanske inte är den snyggaste, men den fungerar.
Praktik. Belastningstestning för att kontrollera poddens funktion.
Belastningstestning är ett av sätten att kontrollera hur containern fungerar, då denna procedur närmar sig verkliga stridsvillkor när användare besöker webbplatsen. För att testa de ovan nämnda rekommendationerna kan man använda : den täcker perfekt alla våra behov. Här följer råd och rekommendationer för att genomföra tester med en tydlig — tack vare diagrammen från Grafana och Yandex.Tank — exempel från vår erfarenhet.
Det viktigaste här är — att kontrollera förändringar steg för steg.. Efter att ha lagt till en ny korrigering, kör testerna och se om resultaten har förändrats jämfört med tidigare körningar. Annars kan det bli svårt att identifiera ineffektiva lösningar, och på sikt kan det rentav skada (t.ex. öka tiden för deployment).
En annan aspekt är att kontrollera loggarna för containern under dess terminering. Registreras där information om graceful shutdown? Finns det några fel i loggarna när det gäller andra resurser (t.ex. en närstående PHP-FPM-container)? Fel från själva applikationen (som i det ovan beskrivna fallet med NGINX)? Jag hoppas att den inledande informationen i denna artikel hjälper till att förstå vad som händer med containern under dess terminering.
Så, den första testen kördes utan lifecycle och utan ytterligare direktiv för applikationsservern (process_control_timeout i PHP-FPM). Målet med detta test var att identifiera det ungefärliga antalet fel (och om det finns några överhuvudtaget). Dessutom bör det noteras att den genomsnittliga tiden för deployment av varje pod var cirka 5-10 sekunder tills det var helt redo. Resultaten är följande:
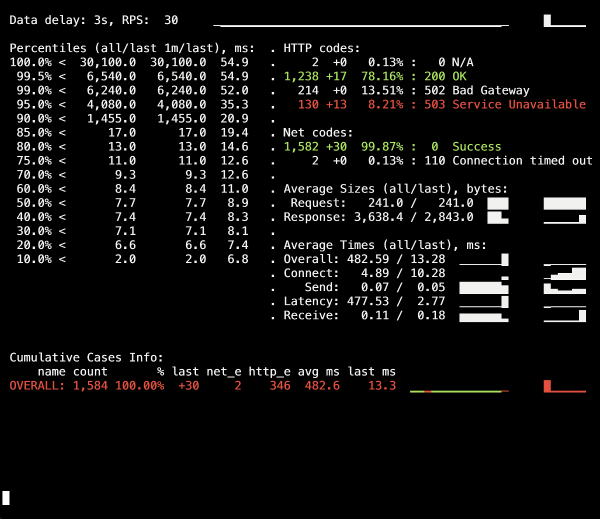
På informationspanelen i Yandex.Tank syns en ökning av 502-fel som inträffade vid tidpunkten för deployment och pågick i genomsnitt i upp till 5 sekunder. Antagligen avbröts befintliga förfrågningar till den gamla podden när den terminerades. Därefter uppstod 503-fel, vilket blev resultatet av den stoppade NGINX-containern som också bröt anslutningar på grund av backend (vilket gjorde att Ingress inte kunde ansluta).
Låt oss se hur process_control_timeout i PHP-FPM kan hjälpa oss att vänta på att barnprocesserna ska avslutas, det vill säga att åtgärda sådana fel. En omdeployment med användning av detta direktiv:
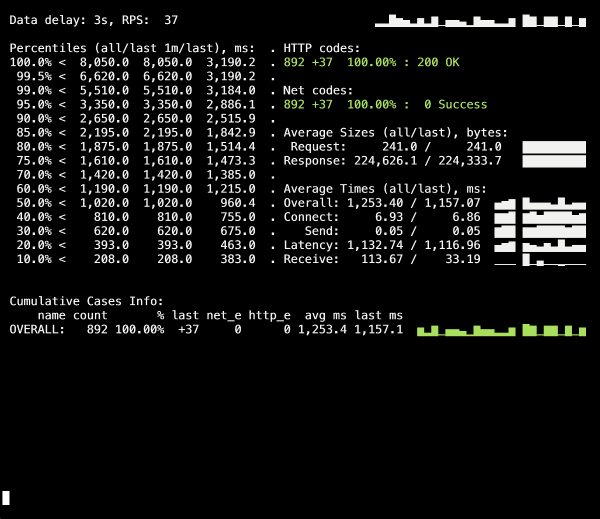
Under deployment finns det inga fler 500-fel! Deployment genomförs framgångsrikt, graceful shutdown fungerar.
Det är dock värt att nämna aspekten med Ingress-containrar, där en liten procentandel av felen kan uppstå på grund av tillfälliga fördröjningar. För att undvika dem gäller det att lägga till en konstruktion med sleep och upprepa deployment. I vårt specifika fall syntes dock inga förändringar (felen är återigen borta).
Slutsats
För att processen ska avslutas korrekt förväntar vi oss följande beteende från applikationen:
- Vänta några sekunder, efter vilket den slutar ta emot nya anslutningar.
- Vänta tills alla förfrågningar är klara och stäng alla keepalive-anslutningar som inte utför förfrågningarna.
- Avsluta din process.
Men inte alla applikationer kan fungera så här. En lösning på problemet i Kubernetes är:
- tillägg av en pre-stop hook som väntar några sekunder;
- granskning av konfigurationsfilen för vår backend med avseende på relevanta parametrar.
Ett exempel med NGINX visar att även en applikation som ursprungligen ska hantera avslutningssignaler korrekt, kanske inte gör det, varför det är kritiskt att kontrollera förekomsten av 500-fel under distributionen av applikationen. Detta gör det också möjligt att se på problemet bredare och inte enbart fokusera på enskild pod eller container, utan att betrakta hela infrastrukturen som helhet.
För testning kan Yandex.Tank användas tillsammans med vilket övervakningssystem som helst (i vårt fall togs data från Grafana med en backend som är Prometheus). Problem med graceful shutdown syns tydligt vid hög belastning, vilket benchmark kan generera, och övervakningen hjälper till att analysera situationen mer ingående under eller efter testet.
Som svar på feedback från artikeln: det bör nämnas att problem och lösningar som beskrivs här gäller NGINX Ingress. För andra fall finns det andra lösningar, som vi kanske kommer att gå igenom i framtida material i cykeln.
P.S.
Något från serien K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Källa: habr.com
