

Kanarie är en liten fågel som ständigt sjunger. Dessa fåglar är känsliga för metan och kolmonoxid. Även vid en låg koncentration av överflödiga gaser i luften förlorar de medvetandet eller dör. Guldgrävare och gruvarbetare tog med sig fåglar: så länge kanariefåglar sjunger kan man arbeta, om de tystnar – finns det gas i gruvan och det är dags att gå. Gruvarbetare offrade den lilla fågeln för att kunna ta sig ut ur gruvan vid liv.
En liknande praxis har också hittat in i IT. Till exempel i den standardiserade uppgiften att deployera en ny version av en tjänst eller applikation i produktion efter testning. Testmiljön kan vara för dyr, automatiserade tester täcker inte allt som man önskar, och att inte testa och offra kvalitet är riskabelt. Just i sådana fall hjälper metoden Canary Deployment, där en liten del av verklig produktionstrafik släpps på den nya versionen. Detta tillvägagångssätt hjälper att säkert kontrollera den nya versionen i produktion, genom att offra lite för en stor målsättning. Mer om hur metoden fungerar, vad den är bra för och hur den kan implementeras, kommer att berättas av Andrey Markelov (), med exemplet från implementeringen på företaget Infobip.
Andrey Markelov — ledande ingenjör-programmerare på Infobip, har arbetat med utveckling av applikationer i Java inom finans och telekommunikation i 11 år. Utvecklar Open Source-produkter, deltar aktivt i Atlassian Community och skriver plugins för Atlassians produkter. Evangelist för Prometheus, Docker och Redis.
Om företaget Infobip
Detta är en global telekommunikationsplattform som gör det möjligt för banker, detaljhandeln, e-handelsföretag och transportföretag att skicka meddelanden till sina kunder via SMS, push, e-post och röstmeddelanden. I en sådan verksamhet är stabilitet och tillförlitlighet viktiga för att kunderna ska få sina meddelanden i tid.
IT-infrastrukturen hos Infobip i siffror:
- 15 datacenter runt om i världen;
- 500 unika tjänster i drift;
- 2500 instanser av tjänster, vilket är mycket mer än antalet team;
- 4,5 TB månatlig trafik;
- 4,5 miljarder telefonnummer;
Verksamheten växer, och med den antalet release. Vi genomför cirka 60 releaser per dag, eftersom kunderna vill ha fler funktioner och kapacitet. Men det är svårt – det finns många tjänster och få team. Vi måste snabbt skriva kod som ska fungera i produktion utan fel.
Releaser
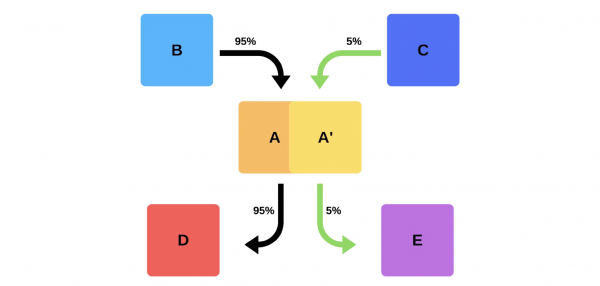
En typisk release går till så här. Till exempel finns tjänsterna A, B, C, D och E, där varje utvecklas av ett separat team.
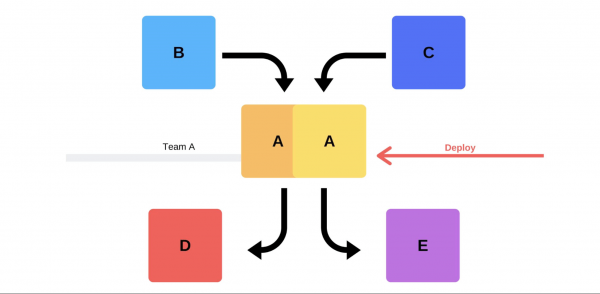
Vid något tillfälle bestämmer sig teamet för tjänst A för att deploya en ny version, men teamen för tjänsterna B, C, D och E är inte medvetna om det. Det finns två alternativ för hur teamet för tjänst A kan agera.
De kommer att genomföra en inkrementell release: först byta ut en version och sedan den andra.
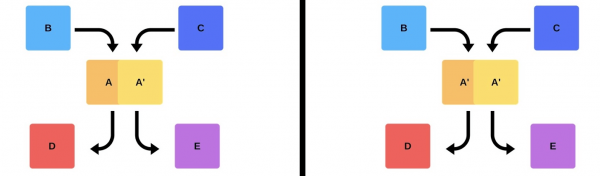
Men det finns ett andra alternativ: teamet hittar ytterligare resurser och maskiner, deployar den nya versionen och sedan switchar de routern så att versionen börjar fungera i produktion.
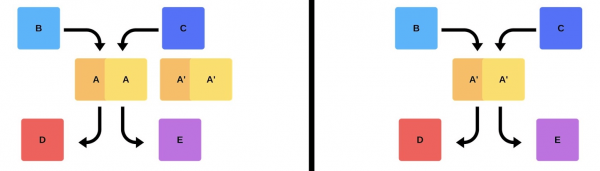
Oavsett alternativ kommer det nästan alltid att uppstå problem efter deployment, även om versionen har testats. Man kan testa manuellt, automatiserat eller hoppa över testningen — problem kommer att uppstå oavsett. Det enklaste och mest korrekta sättet att lösa dem är att rulla tillbaka till en fungerande version. Sedan kan vi ta hand om skadorna, orsakerna och åtgärda dem.
Så vad vill vi?
Vi vill inte ha problem. Om kunder upptäcker dem snabbare än vi, kommer det att skada vårt rykte. Därför måste vi finnas problem snabbare än våra kunder.Genom att arbeta proaktivt minimerar vi skadorna.
Samtidigt vill vi snabba upp deployment, så att det sker snabbt, enkelt, naturligt och utan stress från teamet. Ingenjörer, DevOps-ingenjörer och programmerare måste tas om hand — releasen av en ny version är stressande. Teamet är inte en förbrukningsvara, vi strävar efter att använda mänskliga resurser rationellt..
Deploymentsproblem
Kundtrafiken är oförutsägbar.Det är omöjligt att förutsäga när kundtrafiken kommer att vara minimal. Vi vet inte var och när kunderna påbörjar sina kampanjer — kanske ikväll i Indien och imorgon i Hongkong. Med hänsyn till den stora tidskillnaden garanterar en deployment även klockan 02:00 inte att kunderna inte kommer att påverkas.
Leverantörsproblem.Meddelandetjänster och leverantörer är våra partners. Ibland har de driftstörningar som orsakar fel under deployment av nya versioner.
Distribuerade team.Team som utvecklar frontend och backend är belägna i olika tidszoner. På grund av detta kan de ofta inte enas sinsemellan.
Datacenter kan inte replikeras i staging.I ett datacenter finns det 200 stativ — att replikera det i en sandlåda är nästan omöjligt.
Nertid timesär oacceptabla! Vi har en acceptabel tillgänglighetsnivå (Error Budget) när vi arbetar 99,99 % av tiden, och de resterande procenten är 'fehlerätt'. Att nå 100 % pålitlighet är omöjligt, men det är viktigt att ständigt övervaka nedtider och avbrott.
Klassiska lösningar
Att skriva kod utan buggar. När jag var ung utvecklare kom chefer till mig med önskan att göra en release utan buggar, men det är inte alltid möjligt.
Att skriva tester. Tester fungerar, men ibland inte riktigt som företaget vill. Att tjäna pengar är inte testernas uppgift.
Testa på stage. Under mina 3,5 år på Infobip har jag aldrig sett att stage status faktiskt delvis matchar produktionen.
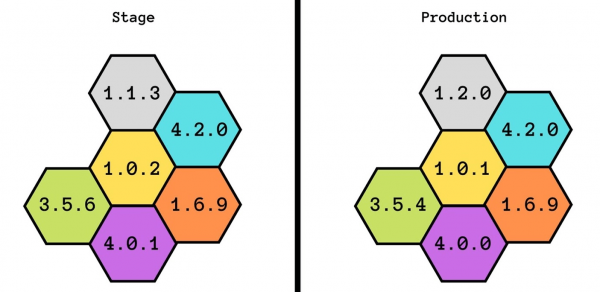
Vi försökte till och med utveckla denna idé: först hade vi en stage, sedan preproduktion, och sedan preproduktion av preproduktionsversionen. Men det hjälpte inte heller — de matchade inte ens i kapacitet. Med stage kan vi garantera grundläggande funktionalitet, men vi vet inte hur den kommer att fungera under belastningar.
Det är den som utvecklade som gör releasen. Detta är en bra praxis: även om någon ändrar namnet på en kommentar, läggs det omedelbart till i produktionen. Det hjälper till att utveckla ansvar och att inte glömma de ändringar som gjorts.
Det finns också ytterligare svårigheter. För utvecklaren är det stressande att spendera mycket tid på att kontrollera allt manuellt.
Överenskomna releaser. Denna lösning föreslås vanligtvis av ledningen: 'Låt oss komma överens om att ni varje dag ska testa och lägga till nya versioner'. Det funkar inte: det finns alltid ett team som väntar på att alla andra ska bli klara eller tvärtom.
Smoke-tester
Ett annat sätt att lösa våra problem med deployment. Låt oss titta på hur smoke-tester fungerar i exemplet när team A vill implementera en ny version.
Först implementerar teamet en instans i produktion. Meddelanden i instansen från mocks imiterar verklig trafik, så att det matchar den normala dagliga trafiken. Om allt fungerar bra, växlar teamet till den nya versionen för verklig trafik.
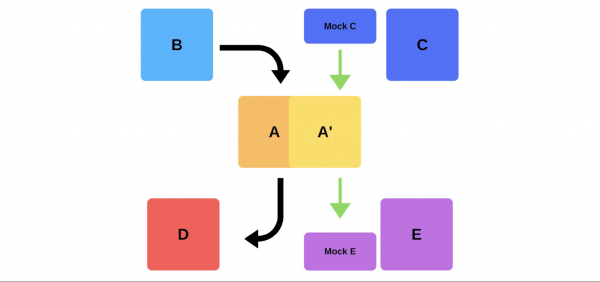
Ett annat alternativ är att implementera med extra hårdvara. Teamet testar den i produktion, byter sedan och allt fungerar.
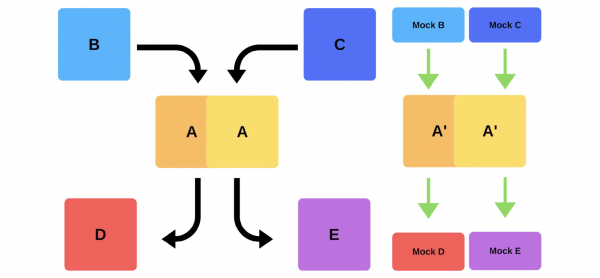
Nackdelar med smoke-tester:
- Man kan inte lita på tester. Var kan man få samma trafik som i produktion? Man kan använda gårdagens eller veckogammal trafik, men de stämmer inte alltid överens med den aktuella.
- Svårt att underhålla. Man måste underhålla testkonton, ständigt återställa dem inför varje deployment när aktiva poster skickas till lagret. Det är svårare än att skriva ett test i sin egen sandlåda.
Den enda bonusen här är att man kan kontrollera prestanda.
Canary-releaser
På grund av nackdelarna med smoke-tester började vi använda canary-releaser.
Praktiker, liknande hur gruvarbetare använde kanariefåglar för att indikera gasnivåer, har också hittat sin plats inom IT. Vi släpper in lite riktig produktionstrafik till den nya versionen, samtidigt som vi försöker hålla oss inom Service Level Agreement (SLA). SLA är vår "rätt till fel" som vi kan använda en gång om året (eller under någon annan tidsperiod). Om allt går bra, lägger vi till mer trafik. Om inte – vi återställer tidigare versioner.
Implementering och detaljer
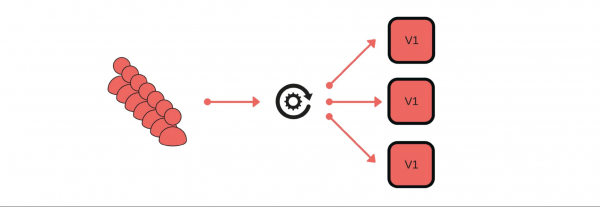
Hur implementerade vi canary-releaser? Till exempel, en grupp kunder skickar meddelanden via vår tjänst.
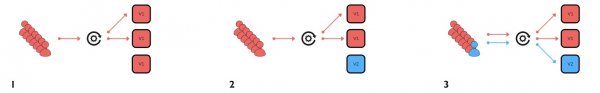
Deployment går till så här: vi tar bort en nod från lastbalanseraren (1), ändrar version (2) och släpper separerat in lite trafik (3).
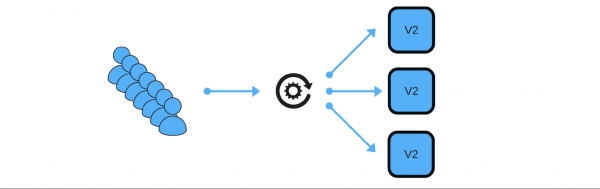
Överlag kommer alla i gruppen att bli nöjda, även om en användare är missnöjd. Om allt går bra – ändrar vi alla versioner.
Jag visar schematiskt hur det ser ut för mikrotjänster i de flesta fall.
Det finns Service Discovery och ytterligare två tjänster: S1N1 och S2. Den första tjänsten (S1N1) meddelar Service Discovery när den startar, och Service Discovery kommer ihåg den. Den andra tjänsten med två noder (S2N1 och S2N2) meddelar också Service Discovery vid start.
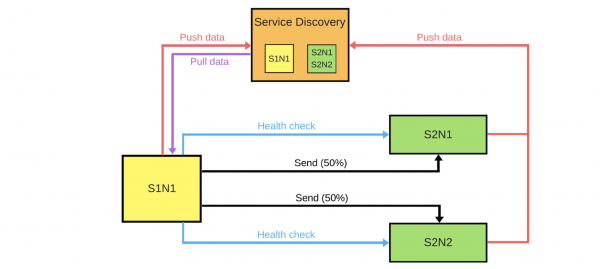
Den andra tjänsten fungerar för den första som en server. Den första begär information om sina servrar från Service Discovery, och när den får den, letar och kontrollerar den dem ("health check"). När den har kontrollerat skickar den meddelanden till dem.
När någon vill deploya en ny version av den andra tjänsten, meddelar den Service Discovery att den andra noden kommer att vara en canary-nod: den kommer att få mindre trafik eftersom en deployment kommer att äga rum. Vi tar bort canary-noden från lastbalanseraren och den första tjänsten skickar ingen trafik dit.
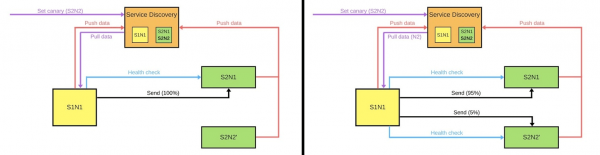
Vi ändrar version och Service Discovery vet att den andra noden nu är en canary — den kan ges en lägre belastning (5 %). Om allt går bra uppdaterar vi versionen, återställer belastningen och fortsätter arbeta.
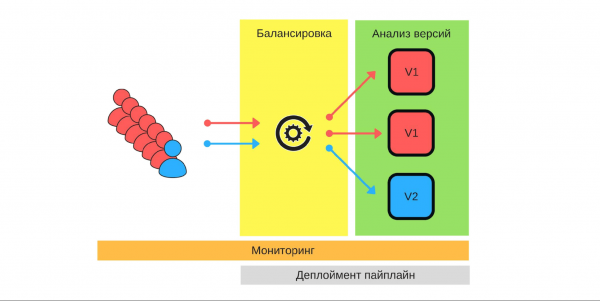
För att genomföra allt detta behöver vi:
- lastbalansering;
- övervakning, eftersom det är viktigt att veta vad varje användare förväntar sig och hur våra tjänster fungerar i detalj;
- versionsanalys, för att förstå hur bra den nya versionen kommer att fungera i produktion;
- som möjliggör snabbare testning, distribution och leverans av ny funktionalitet till användarna. Till exempel skapas det i alla våra projekt automatiskt en CI-pipeline vid varje commit. I den byggs en avbild, testas, distribueras till olika Kubernetes-miljöer för felsökning och vidare kontroller, och om allt går bra - når förändringarna slutligen användaren. Detta är inte längre raketvetenskap, utan en vanlig företeelse för många - förmodligen även för dig, eftersom du läser denna artikel. — vi skriver sekvensen för distribution (deployment pipeline).
Lastbalansering
Detta är det första vi måste tänka på. Det finns två strategier för lastbalansering.
Det enklaste alternativet, när en nod alltid är en canary. Denna nod får alltid mindre trafik och vi börjar distributionen med den. Vid problem kommer vi att jämföra dess prestanda före och under distributionen. Till exempel, om antalet fel har fördubblats, så har även skadan ökat med detsamma.
Canary-noden definieras under distributionsprocessen. När distributionen är klar och vi tar bort canary-statusen från den, kommer trafikbalansen att återställas. Med färre maskiner får vi en rättvis fördelning.
Övervakning
Fundamentet för canary-releaser. Vi måste förstå exakt varför vi gör detta och vilka mätvärden vi vill samla in.
Exempel på mätvärden som vi samlar in från våra tjänster.
- Antalet fel, som skrivs i loggar. Detta är en uppenbar indikator på att allt fungerar som det ska. Generellt är detta en bra mätning.
- Svarstider (latens). Denna mätning övervakas av alla eftersom alla vill arbeta snabbt.
- Köstorlek (genomströmning).
- Antalet framgångsrika svar per sekund.
- Den genomsnittliga svarstiden för 95 % av alla förfrågningar.
- Affärsmätningar: hur mycket pengar verksamheten tjänar under en viss period eller användartapp. Dessa mätvärden kan vara viktigare för vår nya version än de som ingenjörer lägger till.
Exempel på mätvärden i de flesta populära övervakningssystem.
Counter. Detta är en viss ökande kvantitet, till exempel antalet fel. Denna mätning är enkel att interpolera och studera grafen: igår var det 2 fel, men idag 500, vilket innebär att något har gått fel.
Antalet fel per minut eller per sekund är en avgörande indikator som kan beräknas med hjälp av Counter. Dessa uppgifter ger en klar bild av systemets prestanda över tid. Vi ska titta på grafen för antalet fel per sekund för två versioner av produktionssystemet.
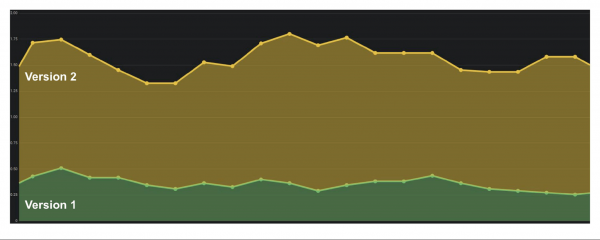
I den första versionen fanns det få fel, kanske audit-tjänsten inte fungerade. I den andra versionen är allt mycket sämre. Man kan säga med säkerhet att det finns problem, så vi måste återgå till denna version.
Gauge. Metriker är liknande Counter, men vi registrerar värden som kan både öka och minska. Till exempel tiden för frågaresponser eller storleken på kö.
På grafen är ett exempel på svarstid (latency). Grafen visar att versionerna är lika, och de går att arbeta med. Men om man tittar noggrant kan man se hur storleken förändras. Om tiden för frågaresponser ökar när användare läggs till, är det tydligt att det finns problem — så var det inte tidigare.
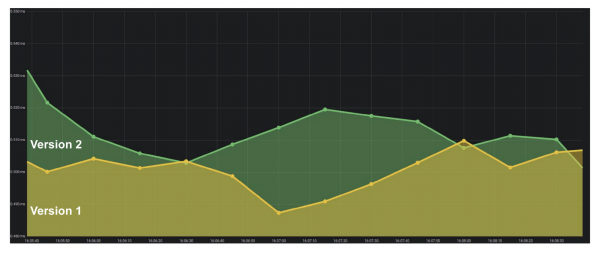
Summary. En av de viktigaste indikatorerna för företaget är percentiler. Metriken visar att i 95% av fallen fungerar vårt system så som vi vill. Vi kan acceptera om det finns problem någonstans, eftersom vi förstår den allmänna trenden, hur bra eller dåligt allt fungerar.
Verktyg
ELK Stack. Att implementera canary är möjligt med Elasticsearch — vi registrerar fel när händelser inträffar. Med en enkel API-anrop kan vi få antalet fel vid vilken tidspunkt som helst och jämföra med tidigare perioder: GET /applg/_cunt?q=level:errr.
Prometheus. Har presterat bra i Infobip. Det låter oss implementera mångdimensionella metrik eftersom etiketter används.
Vi kan använda nivå, instance, service, kombinera dem i ett system. Med hjälp av offset kan man se till exempel värdet för storleken för en vecka sedan med ett enda kommando. GET /api/v1/query?query={query}, där {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Versionsanalys
Det finns flera strategier för versionanalys.
Titta på metrik endast för canary-noden. Ett av de enklaste alternativen: vi deployerar en ny version och studerar endast dess funktionalitet. Men om en ingenjör vid denna tidpunkt börjar granska loggar, ständigt nervöst laddar om sidor, så är denna lösning inget annorlunda än de andra.
Canary-noden jämförs med vilken annan nod som helst. Detta är en jämförelse med andra instanser som arbetar med full trafik. Om det går sämre eller inte bättre med låg trafik än på riktiga instanser, så är något fel.
Canary-noden jämförs med sig själv från tidigare. Noder som har tilldelats canary kan jämföras med historiska data. Till exempel, om allt var bra för en vecka sedan, kan vi använda dessa data för att förstå den aktuella situationen.
Automatisering
Vi vill avlasta ingenjörerna från manuella jämförelser, därför är det viktigt att implementera automatisering. Deployment-processen ser vanligtvis ut så här:
- Vi startar;
- tar bort noden från belastningsbalanseraren;
- sätter canary-noden;
- aktiverar belastningsbalanseraren med en begränsad mängd trafik;
- jämför vi.
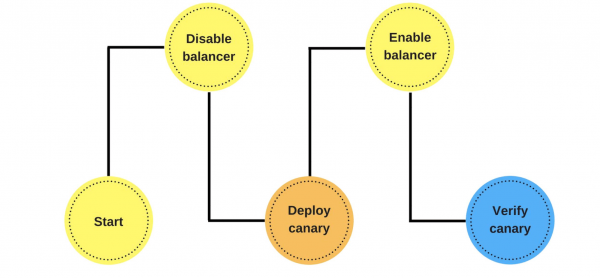
I det här steget implementerar vi automatiserad jämförelse. Hur det kan se ut och varför det är bättre än kontroll efter deployment, får vi se med ett exempel från Jenkins.
Detta är en pipeline till Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary misslyckades, behöver återgå"
        return false
    }
}
Här definierar vi i loopen att vi kommer att jämföra den nya noden under en timme. Om canary-processen inte har avslutats — anropar vi funktionen. Den rapporterar om allt är okej eller inte: def isOk = compare(srv, canary, time, base, offset, metrics).
Om allt är bra — sleep DEFAULT SLEEP, till exempel en sekund, och fortsätter. Om inte, avbryter vi — deployment misslyckades.
Beskrivning av metrik. Låt oss titta på hur funktionen compare kan se ut i DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Anta att vi jämför antalet fel och vill veta antalet fel per sekund under de senaste 5 minuterna.
Vi har två värden: det basala och canary-noden. Värdet för canary-noden är det aktuella. Det basala är baseValue — detta är värdet för vilken annan nod som inte är en canary. Vi jämför värdena med formeln som vi etablerar baserat på vår erfarenhet och observationer. Om värdet canaryValue är dåligt, misslyckades deployment och vi återgår.
Varför behövs allt detta?
En människa kan inte kontrollera hundratals och tusentals metrik, än mindre göra det snabbt. Automatiserad jämförelse hjälper till att kontrollera alla metrik och meddelar snabbt om problem. Tid för meddelande är kritisk: om något inträffade under de senaste 2 sekunderna, så är skadan inte så stor som om det hade hänt för 15 minuter sedan. Medan någon märker problemet, skriver till supporten, och supporten återgår åt oss, kan vi förlora kunder.
Om processen har avslutats framgångsrikt, distribuerar vi automatiskt alla andra noder. Under denna tid gör ingenjörerna ingenting. Endast när de kör canary, beslutar de vilken statistik de ska använda, hur länge jämförelsen ska pågå och vilken strategi som ska tillämpas.
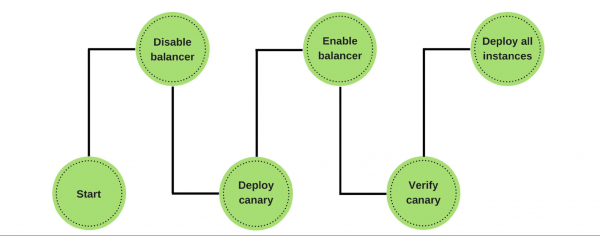
Om det uppstår problem rullar vi automatiskt tillbaka canary-noden, arbetar med tidigare versioner och korrigerar de fel som upptäckts. Med hjälp av statistiken är det lätt att hitta dem och se skadan från den nya versionen.
Hinder
Att genomföra detta är förstås inte enkelt. Först och främst behövs en gemensam övervakningssystem. Ingenjörerna har sina egna mätvärden, support och analytiker har andra, och affärsverksamheten har tredje. Ett gemensamt system är det gemensamma språket som både affär och utveckling kommunicerar på.
Det är nödvändigt att praktiskt testa stabiliteten hos mätvärdena. Testningen hjälper att förstå vilket minimiuppsättning mätvärden som krävs för att säkerställa kvaliteten..
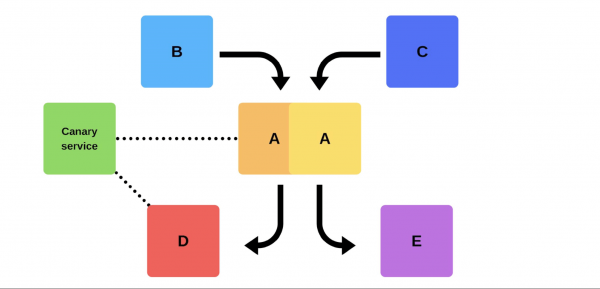
Hur kan vi uppnå detta? Använd canary-tjänsten inte vid distribution. Vi lägger till en viss tjänst på den gamla versionen, som när som helst kan ta en bestämd nod, minska trafiken utan distribution. Efteråt jämför vi: vi studerar felen och letar efter den gräns där vi uppnår kvalitet.
Vilken nytta har vi fått av canary-releaser
Vi minimerade skadenivån från buggar. De flesta distributionsfel beror på oöverensstämmelse av data eller prioritet. Sådana fel har minskat avsevärt, eftersom vi kan lösa problemet inom de första sekunderna.
Vi har optimerat teamens arbete. Nykomlingar har en "rätt att göra fel": de kan distribuera i produktion utan rädsla för att göra misstag, vilket ger dem ytterligare initiativ och motivation att arbeta. Om de bryter något, kommer konsekvenserna inte att vara kritiska, och den som gjort misstaget blir inte uppsagd.
Vi har automatiserat distributionen. Det är inte längre en manuell process som tidigare, utan en riktig automatiserad. Men det tar längre tid.
Vi har identifierat viktiga mätvärden. Hela företaget, från affärssidan till ingenjörerna, förstår vad som verkligen är viktigt i vår produkt, vilka mätvärden, till exempel kundavhopp och tillströmning. Vi kontrollerar processen: testar mätvärdena, inför nya, ser hur de gamla fungerar, för att bygga ett system som tjänar pengar mer effektivt.
Vi har många bra metoder och system som hjälper oss. Trots detta strävar vi efter att vara professionella och göra vårt jobb av hög kvalitet, oavsett om vi har ett system som kan hjälpa oss eller inte.
Ingenjörsmässiga tillvägagångssätt och metoder — . Om du har uppnått framgångar på vägen mot teknisk perfektion och är redo att berätta vad som hjälpt dig — .
Vi planerar att hålla den 8 juni. Vi förstår att det för närvarande är svårt att fatta beslut om deltagande i konferensen. Men samtidigt anser vi att karantän inte är en anledning att stoppa professionell kommunikation och utveckling. Därför kommer vi på något sätt att hitta ett sätt att diskutera tech lead-utmaningar och metoder för att lösa dem — om det behövs kommer vi att gå online och skapa ett nätverk där!
Källa: habr.com
