

Vid komplex bearbetning av stora datamängder (olika : importer, konverteringar och synkronisering med externa källor) uppstår ofta behovet att temporärt "komma ihåg", och snabbt bearbeta något omfattande.
En typisk uppgift av detta slag låter oftast så här: "Här har som snabbt måste laddas upp på webbplatsen och kopplas till kontona".
Men när volymen av detta "något" börjar mätas i hundratals megabyte, och tjänsten måste fortsätta att arbeta med databasen dygnet runt, uppstår många bieffekter som kommer att förstöra din tillvaro.
För att hantera dem i PostgreSQL (och även i andra system) kan man använda vissa möjligheter för optimeringar som gör att allt bearbetas snabbare och med mindre resursförbrukning.
1. Var ska vi ladda?
Först, låt oss klargöra vart vi kan ladda data som vi vill "bearbeta".
1.1. Temporära tabeller (TEMPORARY TABLE)
I princip är temporära tabeller i PostgreSQL precis som vanliga tabeller. Därför är vidskepligheten om att "de lagras bara i minnet, och det kan ta slut"felaktig. Men det finns några betydande skillnader.
Ett eget "namnrum" för varje anslutning till databasen
Om två anslutningar försöker samtidigt utföra CREATE TABLE x, så kommer någon garanterat få en unikhetsfel för databaskonton.
Men om båda försöker utföra Tänk på förkortningar. TILLFÄLIG TABELL x, så kommer båda att lyckas, och varje kommer att få sin egen instans av tabellen. Och ingenting kommer att vara gemensamt mellan dem.
"Självförstörelse" vid avbrott
Vid stängning av anslutningen tas alla temporära tabeller automatiskt bort, så det finns ingen mening med att "manuellt" utföra DROP TABLE x utom…
Om du arbetar genom pgbouncer i transaktionsläge, så anser databasen att anslutningen fortfarande är aktiv, och i denna anslutning existerar fortfarande denna temporära tabell.
Därför kommer ett försök att skapa den igen, redan från en annan anslutning till pgbouncer, att leda till ett fel. Men detta kan omgås genom att använda SKAPA TILLFÄLLIG TABELL OM DET INTE FINNS x.
Men det är bättre att inte göra så, eftersom man då kan "oväntat" upptäcka data där, som tillhörde "föregående ägare". Istället är det mycket bättre att läsa manualen och se att när man skapar en tabell finns det möjlighet att skriva till. PÅ ÅTAGANDE DROP — det vill säga vid avslutandet av transaktionen kommer tabellen att tas bort automatiskt.
Icke-replikering
Eftersom de endast tillhör en viss anslutning, replikeras inte temporära tabeller. Men detta eliminerar behovet av dubbel skrivning av data till heap + WAL, så INSERT/UPDATE/DELETE till dem är avsevärt snabbare.
Men eftersom en temporär tabell fortfarande är en "nästan vanlig" tabell, kan den inte skapas på replikan heller. Åtminstone inte ännu, även om en passande patch har funnits länge.
1.2. Icke-journaliserade tabeller (UNLOGGED TABLE)
Men vad gör man om man till exempel har en krånglig ETL-process som inte kan genomföras i en enda transaktion, och ni har faktiskt pgbouncer i transaktionsläge?..
Eller datastreamen är så stor att en enda anslutning inte har tillräcklig kapacitet till DB (läs, en process per CPU)?..
Eller en del operationer går asynkront i olika kopplingar?..
Här finns bara ett alternativ — att tillfälligt skapa en icke-temporär tabell. En kalambur, visst. Det vill säga:
- skapa "egna" tabeller med maximalt slumpmässiga namn, så att man inte krockar med någon annan
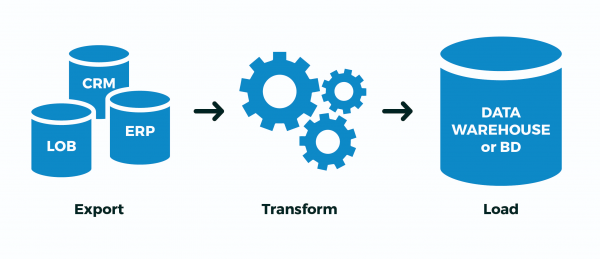
- Extrahera: ladda upp data från en extern källa
- Transformera: omvandla, fylla i nyckelkopplingsfält
- Ladda: hälla färdiga data i mål-tabeller
- ta bort "egna" tabeller
Och nu — en sked av bitterhet. I princip skriver hela tiden data i PostgreSQL två gånger — , och sedan till tabellernas/katalogernas kroppar. Allt detta görs för att stödja ACID och korrekt datavisning mellan COMMITtransaktioner och ROLLBACKinterna och
externa transaktioner. Men vi behöver inte detta! Hela processenantingen slutfördes framgångsrikt, eller så gjorde den inte.
Det spelar ingen roll hur många mellanliggande transaktioner som behövs — vi är inte intresserade av att "föra processen vidare från mitten", särskilt inte när det är oklart var den befann sig. :
icke-journaliserade (UNLOGGED) tabeller. Med denna angivelse skapas tabellen som en icke-journaliserad. Data som skrivs till icke-journaliserade tabeller går inte igenom förskottsjournalen (se Kapitel 29), vilket gör att sådana tabellerfungerar mycket snabbare än vanliga. Men de är inte skyddade mot fel; vid ett fel eller oväntad strömavbrott skärs den icke-journaliserade tabellenautomatiskt av. Dessutom replikeras innehållet i en icke-journaliserad tabell inte. på skrivna servrar. Alla index som skapas för en icke-journalförd tabell blir automatiskt icke-journalförda.
Kort sagt, blir det betydligt snabbare, men om databasservern "går ner" — blir det obehagligt. Men hur ofta händer det, och kan din ETL-process hantera det korrekt "från mitten" efter "återställningen" av databasen?..
Om inte, och om ovanstående scenario liknar ditt — använd UNLOGGED, men aktivera aldrig denna attribut på verkliga tabeller, vars data är viktiga för dig.
1.3. ON COMMIT { DELETE ROWS | DROP }
Denna konstruktion gör det möjligt att definiera automatiskt beteende vid transaktionsavslut när tabellen skapas.
Om PÅ ÅTAGANDE DROP Jag har redan nämnt det ovan, det genererar DROP TABLE, men här med PÅ ÅTAGANDE TA BORT RADER är situationen intressantare — här genereras TRUNCATE TABLE.
Eftersom hela infrastrukturen för lagring av metadata för temporära tabeller är exakt densamma som för vanliga, så den ständiga skapelsen och borttagningen av temporära tabeller leder till kraftig "utvidgning" av systemtabeller pg_class, pg_attribute, pg_attrdef, pg_depend,…
Nu kan du föreställa dig att du har en arbetare med direktanslutning till databasen som varje sekund öppnar en ny transaktion, skapar, fyller i, bearbetar och tar bort en temporär tabell… Skräpet i systemtabellerna kommer att samlas i överflöd, och detta ger extra fördröjningar vid varje körning.
Sammanfattningsvis, gör inte så! I det här fallet är det mycket effektivare CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS att flytta utanför transaktionscykeln — då kommer tabellerna i början av varje ny transaktion redan att existera (-spara anropet Tänk på förkortningar.), men kommer att vara tom, tack vare TRUNCATE (-detta anrop har vi också sparat) vid avslutningen av den föregående transaktionen.
1.4. LIKE… INCLUDING …
Jag nämnde i början att ett typiskt användningsfall för temporära tabeller är olika typer av importer — och utvecklaren kopierar trött det måltabellens fältlista till sitt tillkännagivande för den temporära …
Men lathet är framstegens motor! Så, att skapa en ny tabell "efter mall" kan göras mycket enklare:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Eftersom det kommer att genereras en hel del data till denna tabell så kommer sökningarna i den att inte vara snabba. Men det finns en traditionell lösning mot detta — index! Och ja, en temporär tabell kan också ha index.
Eftersom de nödvändiga indexerna ofta överensstämmer med indexerna för mål-tabellen kan man helt enkelt skriva LIKE måltavla INKLUDERAR INDEX.
Om du också behöver DEFAULT-värden (till exempel för att fylla i värdena för primärnyckeln) kan man använda LIKE måltavla INKLUDERAR STANDARDINSTÄLLNINGAR. Eller bara — LIKE måltavla INNEHÅLLER ALLT — kopierar standardvärdena, index, begränsningar,…
Men här måste man förstå att om du skapade import-tabellen direkt med index, så kommer datan att laddas längre, än om man först laddar allt, och sedan lägger på index — se som exempel hur detta görs av .
Kort sagt, !
2. Hur skriver man?
Jag säger helt enkelt — använd -ström istället för "batch" INSÄTT, . Man kan till och med direkt från den förbereda filen.
3. Hur bearbetar man?
Så, låt oss säga att vår indata ser ut ungefär så här:
- du har en tabell med kunddata i 1M poster
- varje dag skickar kunden dig en ny full "bild"
- utifrån erfarenhet vet du att det från gång till gång ändras inte mer än 10K poster
Ett klassiskt exempel på en sådan situation är — det finns många adresser, men i varje veckolastning av ändringar (omdöpnings av bosättningar, sammanslagningar av gator, nya hus som dyker upp) är det väldigt få även i hela landet.
3.1. Algoritm för fullständig synkronisering
För enkelhetens skull antar vi att du inte ens behöver omstrukturera datan — bara anpassa tabellen till rätt format, vilket innebär:
- radera allt som inte längre finns
- uppgradera allt som redan funnits och behöver uppdateras
- införa allt som ännu inte funnits
Varför exakt i den ordningen bör man utföra operationer? För att det är så storleken på tabellen växer minimalt ().
DELETE FROM dst
Nej, man kan självklart klara sig med bara två operationer:
- radera (
TA BORT) hela - införa allt från den nya bilden
Men samtidigt, tack vare MVCC, kommer storleken på tabellen att öka exakt dubbelt så mycket! Att få +1M poster i tabellen på grund av att uppdatera 10K — är en sådär överflödighet…
TRUNCATE dst
En mer erfaren utvecklare vet att man kan rensa hela tabellen ganska billigt:
- rensa (
TRUNCATE) hela tabellen - införa allt från den nya bilden
Metoden är effektiv, , men det finns ett problem… Att föra in 1M poster kommer att ta lång tid, så vi kan inte tillåta att lämna tabellen tom under hela denna tid (som skulle hända utan att kapsla in i en enda transaktion).
Det betyder att:
- vi inleder en långvarig transaktion
TRUNCATEdet lägger på AccessExclusive-låsningen- vi gör långsamma insättningar, och alla andra kan under tiden inte ens
VÄLJ
Det känns inte bra…
ALTER TABLE… RENAME… / DROP TABLE …
Ett alternativ är att ladda upp allt i en ny separat tabell och sedan helt enkelt döpa om den till den gamla. Några jobbiga småsaker:
- också det AccessExclusive, om än betydligt mindre i tid
- alla förfrågningsplaner/statistik för denna tabell återställs,
- alla externa nycklar (FK) till tabellen bryts
Det fanns en WIP-patch från Simon Riggs som föreslog att göra ALTER-operationen för att ersätta tabellens kropp på filnivå, utan att röra statistiken och FK, men han fick inte ihop tillräckligt med röster.
DELETE, UPDATE, INSERT
Så, vi stannar vid den icke-blockerande varianten av de tre operationerna. Nästan tre… Hur gör vi det mest effektivt?
-- vi gör allt inom ramen för en transaktion, så att ingen ser "mellan" tillstånd
BEGIN;

-- skapar en temporär tabell med importerade data
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- som en mall, även med index
) ON COMMIT DROP; -- vi behöver den inte utanför transaktionen

-- snabbt slår vi in den nya bilden via COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- tar bort de som saknas
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- fält för primärnyckel
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti-join"

-- uppdaterar de som är kvar
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- ingen anledning att uppdatera matchande

-- sätter in de som saknas
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Efterbehandling av importen
I samma KLDRe måste alla ändrade poster dessutom köras igenom efterbehandling — normaliseras, nyckelord identifieras, och struktureranpassas. Men hur vet man — vad som faktiskt ändrades, utan att komplicera synkroniseringskoden, helst utan att röra den överhuvudtaget?
Om skrivåtkomst under synkroniseringen endast finns för din process kan du använda en trigger som sammanställer alla ändringar för oss:
-- måltavlor
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabeller med ändringshistorik
CREATE TABLE kladr$log(
  ro kladr, -- här ligger hela versioner av gamla/nya poster
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- generell Funktion för loggning av ändringar
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- kontrollerar om loggning behövs vid uppdatering av post
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- skapar en loggpost
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Nu kan vi applicera triggers innan synkroniseringen (eller aktivera via ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Sedan kan vi enkelt hämta alla nödvändiga ändringar från loggtabellerna och köra dem genom ytterligare processorer.
3.3. Import av relaterade uppsättningar
Ovan har vi diskuterat fall där datakällor och mottagare har samma struktur. Men vad ska vi göra om export från ett externt system har ett format som skiljer sig från vår databasstruktur?
Vi tar som exempel lagring av kunder och deras fakturor, en klassisk "många-till-en"-variant:
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Och nu kommer exporten från en extern källa till oss som "allt-i-ett":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Det är uppenbart att kunddata kan dupliceras i detta fall, och huvudposten är "faktura":
0123456789;Vasya;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasya;B-03;2020-03-16;9999.00
För modellen kommer vi helt enkelt att infoga våra testdata, men kom ihåg — COPY effektivare!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasya', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasya', 'B-03', '2020-03-16', 9999.00);
Först utvalda de "skivor" som våra "fakta" hänvisar till. I vårt fall hänvisar fakturorna till kunder:
SKAPA EN TILLFÄLLIG TABELL client_import SOM
VÄLJ DISTINCT PÅ(client_inn)
-- man kan helt enkelt VÄLJA DISTINCT om data redan är kända som korrekta
  client_inn inn
, client_name "name"
FRÅN
  invoice_import;
För att korrekt koppla fakturor till kundernas ID måste vi först få reda på eller generera dessa identifierare. Vi lägger till fält för dem:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Vi använder den beskrivna metoden för att synkronisera tabeller med en liten justering — vi kommer inte att uppdatera eller ta bort något i måltabellen, eftersom importen av kunder är "endast tillägg":
-- vi sätter ID:n för redan befintliga poster i importtabellen
UPDATE
  client_import T
SET
  client_id = D.client_id
FRÅN
  client D
VARFÖR
  T.inn = D.inn; -- unik nyckel

-- vi lägger in saknade poster och sätter deras ID:n
MED ins SOM (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FRÅN
    client_import
  VARFÖR
    client_id ÄR NULL -- om ID:n inte har satts
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FRÅN
  ins D
VARFÖR
  T.inn = D.inn; -- unik nyckel

-- vi sätter kundernas ID:n på fakturarekorden
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FRÅN
  client_import D
VARFÖR
  T.client_inn = D.inn; -- tillämpad nyckel
Det är faktiskt allt — i invoice_import är nu fältet för kopplingen ifyllt client_id, som vi ska använda för att införa fakturan.
Källa: habr.com
