

Hej, Habr! Jag presenterar för er en egen översättning av artikeln .
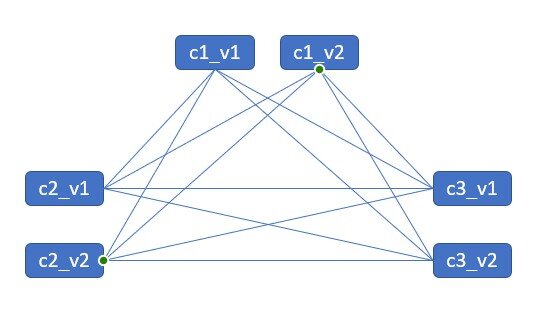
När IT-världen gradvis övergår till mikrotjänster och verktyg som Kubernetes blir ett problem allt mer framträdande. Det här problemet är av mikrotjänsternas versioner. IT-gemenskapen anser ändå att den nuvarande situationen är betydligt bättre än den tidigare generationens teknologier. Dock är versionshantering av mikrotjänster en ganska komplicerad fråga. Ett av bevisen på detta kan ses i artiklar som .
Om du fortfarande inte förstår problemet, låt mig förklara. Anta att din produkt består av 10 mikrotjänster. Anta nu att det för varje av dessa mikrotjänster släpps en ny version. Bara en version — jag hoppas att vi alla kan enas om att detta är en ganska trivial och obetydlig fakta. Men låt oss titta på vår produkt igen. Med bara en ny version av varje komponent har vi nu 2^10 — eller 1024 permutationer av hur vi kan sätta ihop vår produkt.
Om det fortfarande finns oklarheter, låt mig bryta ner matematiken. Så, vi har 10 mikrotjänster, varje får en uppdatering. Det innebär att vi får 2 möjliga versioner för varje mikrotjänst (antingen den gamla eller den nya). Nu, för varje komponent i produkten kan vi använda vilken av dessa två versioner vi vill. Matematiskt sett är detta detsamma som om vi hade ett binärt tal med 10 tecken. Till exempel, låt oss säga att 1 är den nya versionen och 0 är den gamla versionen — så kan en möjlig permutation anges som 1001000000 — där den 1:a och 4:e komponenten är uppdaterade, medan alla andra inte är det. Från matematiken vet vi att ett binärt tal med 10 tecken kan ha 2^10 eller 1024 värden. Det betyder att vi har bekräftat omfattningen av det antal vi har att göra med.
Låt oss fortsätta resonemanget — vad händer om vi har 100 mikrotjänster och var och en med 10 möjliga versioner? Hela situationen blir ganska obehaglig — nu har vi 10^100 permutationer — vilket är ett enormt antal. Men jag föredrar att beskriva denna situation på detta sätt, för nu döljer vi oss inte bakom ord som »kubernetes«, utan konfronterar problemet som det är.
Vad fascinerar mig så mycket med detta problem? Delvis för att jag tidigare arbetat inom NLP och AI, där vi diskuterade problemet med kombinatorisk explosion för 5-6 år sedan. Istället för versioner hade vi separata ord, och istället för produkter hade vi meningar och stycken. Även om NLP- och AI-problemen till stor del fortfarande är olösta, måste man erkänna att det har gjorts betydande framsteg de senaste åren. (enligt min åsikt skulle framstegen kunna vara störrebästa resultatet (subjektiv åsikt).om folk inom branschen ägnade lite mindre uppmärksamhet åt maskininlärning och lite mer åt andra tekniker - men det är en annan diskussion).
Jag återvänder till världen av DevOps och mikrotjänster. Vi står inför ett enormt problem, som en elefant i ett konstkabinett - för vad jag ofta hör är: "ta bara kubernetes och helm så blir allt bra!" Men nej, allt blir inte bra om vi lämnar allt som det är. Dessutom verkar en analytisk lösning på detta problem oacceptabel med tanke på komplexiteten. Precis som inom NLP bör vi först närma oss detta problem genom att avgränsa sökområdet - i det här fallet genom att utesluta föråldrade permutationer.
En av sakerna som kan hjälpa - jag skrev förra året Det är också viktigt att notera att en välarbetad CI/CD-process hjälper mycket med att minska variationer. Men, dagens tillstånd med CI/CD är inte tillräckligt bra för att lösa permutationsproblemet utan ett extra verktyg för att övervaka och spåra komponenter.
Vad vi behöver är ett experimentellt system under integrationsstadiet, där vi kan definiera riskfaktorer för varje komponent, samt ha en automatiserad process för att uppdatera olika komponenter och testa utan operatörens inblandning - för att se vad som fungerar och vad som inte gör.
Ett sådant experimentellt system skulle kunna se ut så här:
- Utvecklare skriver tester (detta är en kritisk fas - för annars har vi ingen bedömningskriterium - det är precis som datamärkning inom maskininlärning).
- Varje komponent (projekt) får sitt eget CI-system - den här processen är idag välarbetad, och frågan om att skapa ett CI-system för en enskild komponent är till stor del löst.
- Den "Intelligenta integrationssystemet" samlar resultat från olika CI-system och sätter samman projektkomponenter till en slutprodukt, utför tester och beräknar slutligen den kortaste vägen för att uppnå önskad produktfunktionalitet utifrån befintliga komponenter och riskfaktorer. Om en uppdatering inte är möjlig, varnar systemet utvecklarna om de befintliga komponenterna och vilken av dem som har ett fel. Jag vill återigen understryka att testsystemet här är av avgörande betydelse, eftersom integrationssystemet använder tester som utvärderingskriterier.
- CD-systemet som sedan tar emot data från den "Intelligenta integrationssystemet" och utför själva uppdateringen. Detta steg avslutar cykeln.
Sammanfattningsvis är en av de största utmaningarna för mig just nu avsaknaden av ett sådant "Intelligent integrationssystem" som kopplar samman olika komponenter i produkten och därmed möjliggör att följa hur produkten som helhet är sammansatt. Jag skulle vara intresserad av communityns tankar kring detta (spoiler — jag arbetar för närvarande med ett projekt , som kan bli ett sådant intelligent integrationssystem).
En sista sak jag vill nämna är att jag inte anser att en monolit är acceptabel för något projekt av ens medelstorlek. Jag är mycket skeptisk till försök att påskynda genomförandet och kvaliteten på utvecklingen genom att återvända till en monolit. För det första har monoliten ett liknande problem med komponenthantering — bland de olika bibliotek som den består av, men allt detta är inte så märkbart och visar sig först och främst i den tid som utvecklarna lägger ner. En konsekvens av monolitens problem är den faktiska omöjligheten att göra förändringar i koden — och extremt långsam utvecklingshastighet.
Mikrotjänster förbättrar situationen, men då står mikrotjänstarkitekturen inför problemet med kombinatorisk explosion i integrationsfasen. Ja, i allmänhet har vi flyttat samma problem — från utvecklingsfasen till integrationsfasen. Men enligt min åsikt leder mikrotjänstmetoden ändå till bättre resultat, och teamen uppnår resultat snabbare (troligen främst på grund av minskningen av storleken på utvecklingsenheten — eller batch-storlek). Men övergången från monolit till mikrotjänster har hittills inte resulterat i tillräcklig förbättring av processen — den kombinationsexplosion av versioner av mikrotjänster är ett stort problem, och vi har stor potential att förbättra situationen i takt med att vi löser detta.
Källa: habr.com
