

Kube-scheduler är en oumbärlig komponent i Kubernetes som ansvarar för schemaläggning av pods till noder enligt angivna policyer. Ofta behöver vi inte tänka på vilka policyer som används för schemaläggning av pods, eftersom standarduppsättningen av kube-scheduler passar de flesta vardagliga uppgifter. Men det förekommer situationer då det är viktigt för oss att fint justera processen för distribution av pods, och för att lösa denna uppgift finns det två alternativ:
- Skapa en kube-scheduler med en anpassad uppsättning regler
- Skriva en egen scheduler och lära den att arbeta med API-serverns förfrågningar
I denna artikel kommer jag att beskriva genomförandet av just det första alternativet för att lösa problemet med ojämn schemaläggning av pods i ett av våra projekt.
Kort introduktion till hur kube-scheduler fungerar
Det är värt att särskilt notera att kube-scheduler inte ansvarar för den direkta schemaläggningen av pods – den ansvarar endast för att bestämma vilken nod som ska placera en pod. Med andra ord, resultatet av kube-schedulers arbete är namnet på noden, vilket den returnerar till API-servern på en förfrågan om schemaläggning, och därefter avslutar den sitt arbete.
Först upprättar kube-scheduler en lista över noder som en pod kan schemaläggas på enligt predicates-policyer. Därefter får varje nod i denna lista ett visst antal poäng enligt prioriteringspolicyer. Resultatet är att en nod med det högsta antalet poäng väljs. Om det finns noder med samma maximala poäng väljs en av dem slumpmässigt. Du kan läsa mer om lista och beskrivning av predicates-policyer (filtering) och prioriteringar (scoring) i .
Beskrivning av problemets kärna
Trots det stora antalet olika Kubernetes-kluster som Nixys underhåller, stötte vi först på problemet med schemaläggning av pods nyligen, när behovet av att köra ett stort antal periodiska uppgifter (~100 CronJob-enheter) uppstod för ett av våra projekt. För att förenkla beskrivningen av problemet så mycket som möjligt, kommer vi att ta ett exempel på en mikrotjänst där en cron-uppgift körs varje minut och skapar en viss belastning på CPU:n. Tre helt identiska noder (24 vCPU på varje) har avsatts för utförandet av cron-uppgiften.
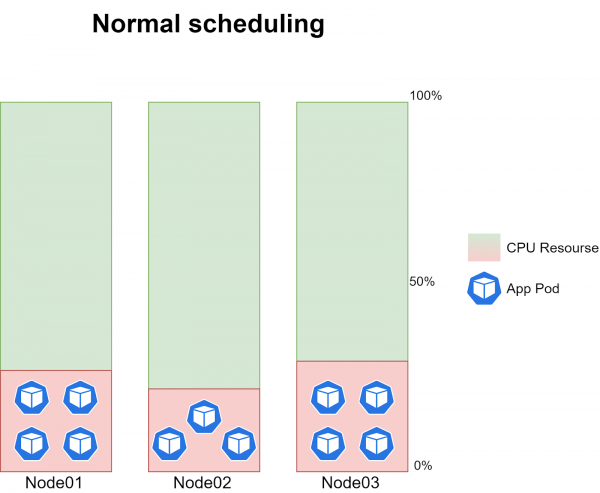
Det går inte att exakt säga hur länge en CronJob kommer att köras, eftersom mängden indata ständigt förändras. I genomsnitt, under normal drift av kube-scheduler, körs 3-4 instanser av uppgiften på varje nod, vilket skapar ~20-30% belastning på CPU:n på varje nod:
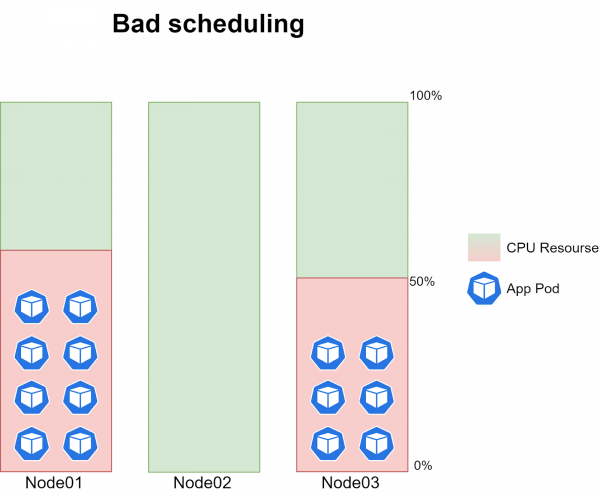
Själva problemet är att poddar för cron-uppgifter ibland slutade planeras på en av de tre noderna. Det vill säga, vid något tillfälle planerades ingen pod på en av noderna, medan två andra noder hade 6-8 instanser av uppgiften som skapade ~40-60% belastning på CPU:n:
Problemet upprepades med helt slumpmässig periodicitet och korrelerade ibland med tidpunkten för lanseringen av en ny version av koden.
Genom att höja loggnivån för kube-scheduler till 10 (-v=10) började vi notera hur mycket poäng varje nod fick under utvärderingsprocessen. Vid normal schemaläggning kunde följande information ses i loggarna:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1387 millicores 4161694720 minnebytes, poäng 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1347 millicores 4444810240 minnebytes, poäng 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1387 millicores 4161694720 minnebytes, poäng 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1687 millicores 4790840320 minnebytes, poäng 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1347 millicores 4444810240 minnebytes, poäng 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnebytes, total begäran 1687 millicores 4790840320 minnebytes, poäng 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Poäng: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Poäng: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Poäng: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:781] Host Node01 -> Poäng 100043
generic_scheduler.go:781] Host Node02 -> Poäng 100043
generic_scheduler.go:781] Host Node03 -> Poäng 100043
Det vill säga, baserat på informationen som erhölls från loggarna, fick varje nod lika många totala poäng och en slumpmässig valdes för planering. Vid tidpunkten för den problematiska planeringen såg loggarna ut på följande sätt:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 1587 millicores 4581125120 minnesbyte, poäng 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 1087 millicores 3532549120 minnesbyte, poäng 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 1587 millicores 4581125120 minnesbyte, poäng 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 987 millicores 3322833920 minnesbyte, poäng 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 987 millicores 3322833920 minnesbyte, poäng 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 minnesbyte, total begäran 1087 millicores 3532549120 minnesbyte, poäng 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Poäng: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Poäng: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Poäng: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Poäng: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Poäng: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Poäng: (10)
generic_scheduler.go:781] Värd Node03 => Poäng 100041
generic_scheduler.go:781] Värd Node02 => Poäng 100041
generic_scheduler.go:781] Värd Node01 => Poäng 100038
Det framgår att en av noderna fick färre poäng totalt jämfört med de andra, och därför utfördes planeringen endast på de två noder som fick högst poäng. På så sätt har vi säkerställt att problemet beror på planeringen av pods.
Den vidare algoritmen för att lösa problemet var uppenbar för oss - att analysera loggarna, förstå enligt vilken prioritetsordning noden inte fick tillräckligt med poäng och, om nödvändigt, justera standardpolicies för kube-scheduler. Men här stötte vi på två stora utmaningar:
- Vid maximal loggnivå (10) visas poäng endast för vissa prioriteter. I det ovanstående loggutdraget kan man se att noderna får samma mängd poäng för alla prioriteter som visas i loggarna, såväl vid normal som problematisk planering, men det slutliga resultatet vid problematisk planering skiljer sig. Därför kan vi dra slutsatsen att poängberäkningen sker "i bakgrunden" för vissa prioriteter, och vi har ingen möjlighet att förstå vilken specifik prioritet noden inte fick poäng för. Detta problem har vi beskrivit i detalj i Kubernetes repository på Github. Vid tidpunkten för artikelns skrivande hade vi fått svar från utvecklarna att loggning kommer att stödjas i uppdateringarna av Kubernetes v1.15, v1.16 och v1.17.
- Det finns inget enkelt sätt att förstå med vilken specifik uppsättning policies kube-scheduler arbetar för tillfället. Ja, denna lista nämns, men det finns ingen information om vilka specifika vikter som tilldelats varje prioritet. Vikterna kan bara ses eller redigeras för standardpolicies för kube-scheduler i Det är värt att notera att vi en gång lyckades bekräfta att noden inte fick poäng för policy för ImageLocalityPriority, som tilldelar poäng till en nod om den redan har en bild som behövs för att köra applikationen. Det innebär att när en ny version av applikationen rullades ut så hann cron-jobbet köra på två noder och ladda ner den nya bilden från docker registry, vilket gör att de två noderna fick ett högre totalt resultat än den tredje. .
Стоит отметить, один раз нам удалось зафиксировать, что нода не добирала очки по политике ImageLocalityPriority, которая начисляет очки ноде, если на ней уже есть образ, необходимый для запуска приложения. Т. е. в момент выкатки новой версии приложения cron-задача успевала запускаться на двух нодах, выкачивая на них новый образ из docker registry, и таким образом две ноды получали бОльший итоговый балл относительно третьей.
Som jag nämnde ovan ser vi ingen information om bedömningen av policyn ImageLocalityPriority i loggarna, så för att verifiera min hypotes laddade vi upp en bild med den nya versionen av applikationen på den tredje noden, vilket ledde till att schemaläggningen fungerade korrekt. Problemen med schemaläggningen observerades ganska sällan på grund av ImageLocalityPriority-policyn, oftare var de relaterade till något annat. Eftersom vi inte kunde debugga varje policy i listan över prioriteringar för standardkube-scheduler var vi tvungna att ha ett flexibelt sätt att hantera poddschemaläggningspolicyn.
Uppgiftsställande
Vi ville att lösningen på problemet skulle vara så specifik som möjligt, vilket innebär att de grundläggande enheterna i Kubernetes (här avses standardkube-scheduler) måste förbli oförändrade. Vi ville inte lösa problemet på ett ställe och skapa det på ett annat. Således kom vi fram till två lösningsalternativ på problemet, som nämndes i artikelns inledning — att skapa en ytterligare scheduler eller skriva vår egen. Huvudkravet för schemaläggning av cron-jobb är en jämn belastningsfördelning över tre noder. Detta krav kan uppfyllas av de redan existerande policys i kube-scheduler, så det finns ingen mening med att skriva vår egen scheduler för att lösa vårt problem.
Instruktionerna för att skapa och deploya en ytterligare kube-scheduler beskrivs i . Men vi ansåg att enbart Deployment-enheterna inte var tillräckliga för att säkerställa redundans i driften av en så kritisk tjänst som kube-scheduler, så vi beslutade att deploya en ny kube-scheduler som Static Pod, som Kubelet kommer att övervaka direkt. Därför ställdes följande krav på den nya kube-scheduler:
- Tjänsten ska deployas som en Static Pod på alla masternoder i klustret.
- Det ska finnas redundans i händelse av att den aktiva podden med kube-scheduler blir otillgänglig.
- Den huvudsakliga prioriteten vid schemaläggning ska vara mängden tillgängliga resurser på noden (LeastRequestedPriority).
Implementering av lösningen.
Det är värt att nämna att allt arbete kommer att genomföras i Kubernetes v1.14.7, eftersom just denna version användes i projektet. Vi börjar med att skriva manifestet för vår nya kube-scheduler. Vi tar utgångspunkt i manifestet för den standardiserade (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) och ger det följande utseende:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Kort om de viktigaste ändringarna:
- Pod- och containernamnet har ändrats till kube-scheduler-cron
- Vi har angett användning av portar 10151 och 10159 eftersom detta alternativ har definierats
hostNetwork: trueoch vi kan inte använda samma portar som standard kube-scheduler (10251 och 10259) - Med parametern —config angav vi konfigurationsfilen som tjänsten ska starta med
- Vi har konfigurerat monteringen av konfigurationsfilen (scheduler-custom.conf) och schemaläggningspolicyfilen (scheduler-custom-policy-config.json) från värden
Vi ska komma ihåg att vår kube-scheduler behöver behörigheter som liknar de standardinställda. Vi redigerar dess klusterroll:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Nu låt oss diskutera vad som bör ingå i konfigurationsfilen och filen med schemaläggningspolicyer:
- Konfigurationsfil (scheduler-custom.conf)
För att få konfigurationen för standard kube-scheduler behöver vi använda parametern--write-config-tofrån . Den erhållna konfigurationen placeras i filen /etc/kubernetes/scheduler-custom.conf och omformas till följande format:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Kort om de viktigaste ändringarna:
- Vi har angett namnet på vår tjänst kube-scheduler-cron i schedulerName.
- I parametern
lockObjectNamemåste vi också ange namnet på vår tjänst och se till att parameternleaderElectär inställd på true (om du har en enda master-nod kan du ställa in värdet på false). - Vi har angett sökvägen till filen som beskriver planeringspolicyerna i parametern
algorithmSource.
Det är värt att stanna upp mer vid den andra punkten, där vi redigerar parametrarna för nyckeln leaderElection. För att säkerställa hög tillgänglighet har vi aktiverat (leaderElect) valet av ledare (master) mellan poddarna av vår kube-scheduler med hjälp av en gemensam endpoint (resourceLock) med namnet kube-scheduler-cron (lockObjectName) i namnområdet kube-system (lockObjectNamespace). Om hur Kubernetes säkerställer hög tillgänglighet för viktiga komponenter (inklusive kube-scheduler) kan du läsa i .
- Fil för planeringspolicy (scheduler-custom-policy-config.json)
Som jag nämnde tidigare – för att ta reda på med vilka specifika policyer den standard kube-scheduler arbetar, kan vi endast analysera dess kod. Det innebär att vi inte kan få en fil med planeringspolicyer för den standard kube-scheduler, på samma sätt som vi får konfigurationsfilen. Vi kommer att beskriva de intressanta planeringspolicyerna i filen /etc/kubernetes/scheduler-custom-policy-config.json som följer:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Således upprättar kube-scheduler först en lista över noder där en pod kan schemaläggas i enlighet med policyn GeneralPredicates (som omfattar en uppsättning av policys som PodFitsResources, PodFitsHostPorts, HostName och MatchNodeSelector). Därefter utvärderas varje nod i enlighet med de policys som finns i arrayen priorities. För att uppfylla villkoren för vårt uppdrag har vi bedömt att en sådan uppsättning policys skulle vara den mest optimala lösningen. Jag påminner om att uppsättningen av policys med deras detaljerade beskrivning finns tillgänglig i . För att utföra din uppgift kan du helt enkelt ändra uppsättningen av de använda policys och tilldela dem motsvarande vikter.
Manifestet för den nya kube-scheduler som vi skapade i början av kapitlet kommer vi att kalla kube-scheduler-custom.yaml och placera på följande väg /etc/kubernetes/manifests på tre master-noder. Om allt görs korrekt kommer Kubelet på varje nod att starta podden, och i loggarna för vår nya kube-scheduler kommer vi att se information om att vår fil med policys har tillämpats framgångsrikt:
Creating scheduler from configuration: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registering predicate: GeneralPredicates
Predicate type GeneralPredicates already registered, reusing.
Registering priority: ServiceSpreadingPriority
Priority type ServiceSpreadingPriority already registered, reusing.
Registering priority: EqualPriority
Priority type EqualPriority already registered, reusing.
Registering priority: LeastRequestedPriority
Priority type LeastRequestedPriority already registered, reusing.
Registering priority: NodePreferAvoidPodsPriority
Priority type NodePreferAvoidPodsPriority already registered, reusing.
Registering priority: NodeAffinityPriority
Priority type NodeAffinityPriority already registered, reusing.
Creating scheduler with fit predicates 'map[GeneralPredicates:{}]' and priority functions 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Nu återstår det bara att ange i spec för vår CronJob att alla schemaläggningsförfrågningar för dess poddar ska hanteras av vår nya kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Slutsats
Slutligen har vi fått en ytterligare kube-scheduler med en unik uppsättning schemaläggningspolicys, vars arbete övervakas direkt av kubelet. Dessutom har vi ställt in valet av en ny ledare bland poddarna i vår kube-scheduler om den gamla ledaren av någon anledning blir otillgänglig.
Vanliga applikationer och tjänster fortsätter att schemaläggas genom den vanliga kube-scheduler, medan alla cron-uppgifter har överförts till den nya. Belastningen som skapas av cron-uppgifter fördelas nu jämnt över alla noder. Med tanke på att den största delen av cron-uppgifter körs på samma noder som de huvudsakliga applikationerna i projektet, har detta lett till en betydande minskning av risken för att pods flyttas på grund av resursbrist. Efter implementeringen av den extra kube-scheduler har problem med ojämn schemaläggning av cron-uppgifter inte längre förekommit.
Läs även andra artiklar i vår blogg:
Källa: habr.com
