

Hej alla, jag heter Alexander och jag är Data Quality-ingenjör som ansvarar för att kontrollera datakvaliteten. I den här artikeln kommer jag att berätta hur jag kom hit och varför denna typ av testning blev en trend 2020.
Global trend
Dagens värld genomgår en ny teknologisk revolution, där en aspekt är användningen av insamlad data av olika företag för att driva sina egna försäljningsmaskiner, vinster och PR. Det verkar som att närvaron av bra (kvalitativa) data, tillsammans med skickliga personer som kan tjäna pengar på dem (bearbeta dem korrekt, visualisera dem, bygga maskininlärningsmodeller osv.), har blivit nyckeln till framgång för många. För 15-20 år sedan ägnade sig främst stora företag åt intensivt arbete med att samla in och monetisera data, medan det idag är en uppgift för nästan alla rationella företag.
I och med detta började för några år sedan alla plattformar för jobbsökning runt om i världen att översvämmas av annonser för Data Scientists, eftersom alla var övertygade om att om de anställde en sådan specialist kunde de bygga en supermodell för maskininlärning, förutsäga framtiden och göra ett "kvantsteg" för företaget. Med tiden insåg folk att denna metod nästan aldrig fungerar, då långt ifrån all data som hamnar i händerna på sådana specialister är användbar för att träna modeller.
Och så började efterfrågan från Data Scientists: "Låt oss köpa mer data från dem och dem...", "Vi har inte tillräckligt med data...", "Vi behöver lite mer data, och helst kvalitativ data...". Baserat på dessa förfrågningar började det uppstå många samarbeten mellan företag som ägde olika datamängder. Det krävde naturligtvis en teknisk organisering av denna process - att koppla upp sig mot datakällan, hämta dem, kontrollera att de laddades ner i sin helhet osv. Antalet sådana processer har ökat, och idag har vi en enorm efterfrågan på en annan typ av specialister - Data Quality-ingenjörer - de som övervakar datastromen i systemet (data pipelines), datakvaliteten vid in- och utgång, och drar slutsatser om deras tillräcklighet, integritet och andra egenskaper.
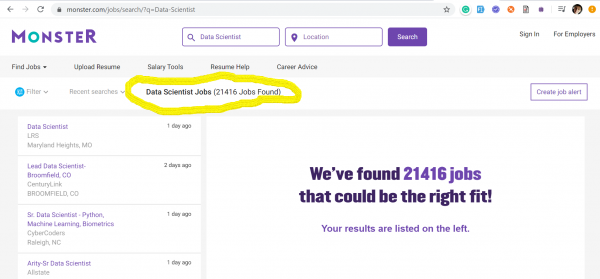
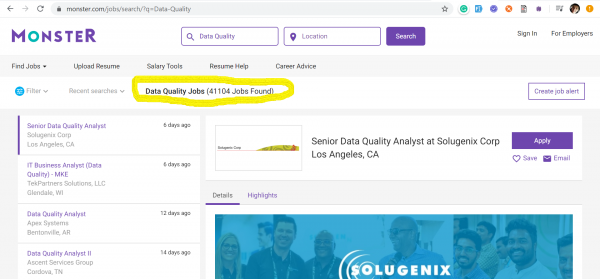
Trenden för Data Quality ingenjörer har nått oss från USA, där ingen är redo att förlora kampen om data mitt under den pågående kapitalismens era. Nedan har jag presenterat skärmdumpar från två av de mest populära jobbsökningssajterna i USA: och — där data från den 17 mars 2020 visas, angående antalet publicerade jobbannonser, baserat på nyckelorden: Data Quality och Data Scientist.
Data Scientists – 21416 jobbannonser
Data Quality – 41104 jobbannonser
Data Scientists – 404 jobbannonser
Data Quality – 2020 jobbannonser
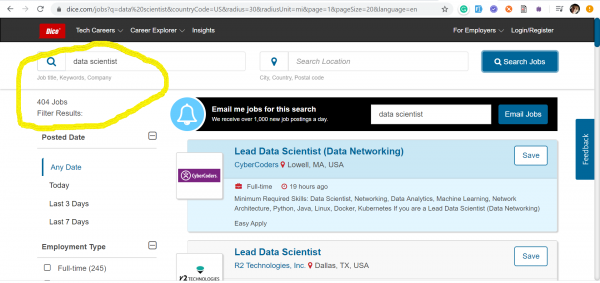
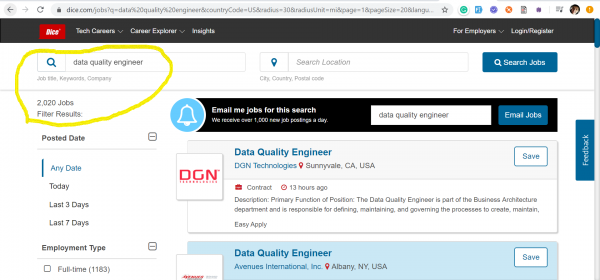
Det är uppenbart att dessa yrken på ingen sätt konkurrerar med varandra. Med skärmdumparna ville jag bara illustrera den nuvarande situationen på arbetsmarknaden när det gäller efterfrågan på Data Quality ingenjörer, som just nu behövs mycket mer än Data Scientists.
I juni 2019, som svar på behoven hos den moderna IT-marknaden, inrättade EPAM Data Quality som en separat praktik. Data Quality ingenjörer hanterar data i sitt dagliga arbete, testar deras beteende i nya miljöer och system, och övervakar relevansen, tillräckligheten och aktualiteten av data. Samtidigt ägnar Data Quality ingenjörer faktiskt lite tid åt klassisk funktionell testning, MEN detta beror mycket på projektet (ett exempel kommer jag att ge senare).
Data Quality ingenjörers ansvar begränsar sig inte bara till rutinmässiga manuella/automatiska kontroller av 'nulls, count och sums' i databastabeller, utan kräver en djup förståelse för kundens affärsbehov och därmed förmågan att omvandla befintliga data till nyttig affärsinformation.
Teorin om Data Quality
För att få en så fullständig bild av rollen för en sådan ingenjör som möjligt, låt oss undersöka vad Data Quality innebär i teorin.
Data Quality — en av etapperna i Data Management (en hel värld som vi lämnar till er för självstudier) och ansvarar för analys av data enligt följande kriterier:
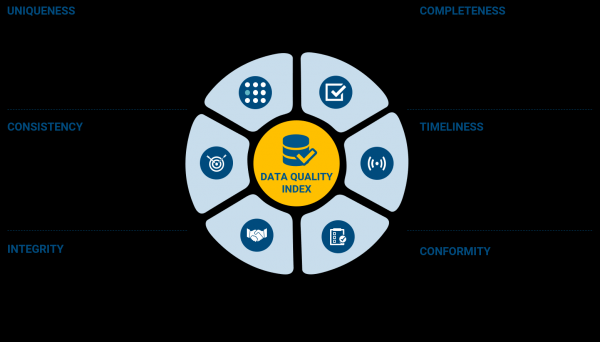
Jag tror inte att det är nödvändigt att avkoda varje punkt (som i teorin kallas 'data dimensions'); de är ganska väl beskrivna på bilden. Men själva testprocessen innebär inte en strikt kopiering av dessa egenskaper till testfallen och deras verifiering. Inom Data Quality, precis som i all annan typ av testning, måste man först och främst utgå från de kvalitetskrav som har överenskommits med projektets deltagare som fattar affärsbeslut.
Beroende på projektet kan Data Quality-ingenjören utföra olika funktioner: från en vanlig testautomatiserare med ytlig bedömning av datakvalitet, till en person som utför djupgående profilering av dem enligt de ovan nämnda egenskaperna.
En mycket detaljerad beskrivning av processerna för Data Management, Data Quality och relaterat material är väl beskrivna i boken med titeln ‘DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition’. Jag rekommenderar varmt denna bok som en introduktion till ämnet (länken till den hittar du i slutet av artikeln).
Min historia
Inom IT-branschen har jag gått från Junior-testare i produktföretag till Lead Data Quality Engineer på EPAM. Redan efter cirka två år som testare hade jag en fast övertygelse om att jag hade utfört alla typer av testning: regression, funktionell, stress, stabilitets-, säkerhets-, UI osv. - och jag har prövat många testverktyg, arbetat med tre programmeringsspråk: Java, Scala, Python.
När jag ser tillbaka inser jag varför min uppsättning professionella färdigheter blev så mångsidig - jag deltog i projekt kopplade till databehandling, stora och små. Just detta ledde mig in i en värld av många verktyg och möjligheter till tillväxt.
För att bedöma mångfalden av verktyg och möjligheter till nya kunskaper och färdigheter räcker det med att titta på bilden nedan, som visar de mest populära av dem inom 'Data & AI'.
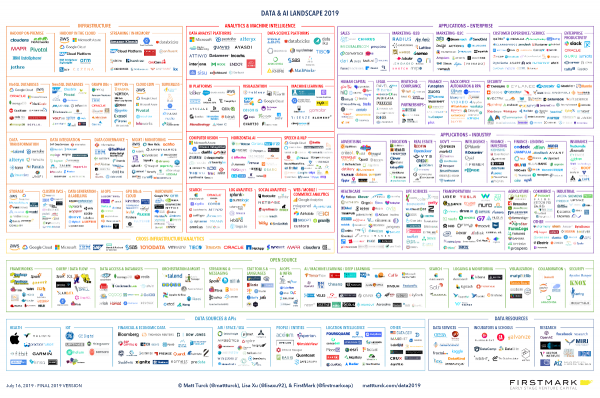
Sådana typer av illustrationer sammanställs årligen av en känd riskkapitalist, Matt Turck, som kommer från mjukvaruutveckling. Här är hans blogg och , där han arbetar som partner.
Jag växte särskilt snabbt i min profession när jag var den enda testaren i projektet, eller åtminstone i början av projektet. Just i sådana stunder måste man ta ansvar för hela testprocessen, och man har ingen möjlighet att backa, bara att gå framåt. I början var det skrämmande, men nu ser jag tydligt alla fördelar med en sådan prövning:
- Du börjar kommunicera med hela teamet som aldrig tidigare, eftersom det inte finns någon mellanhand för kommunikationen: varken testledare eller kollegor testare.
- Fördjupningen i projektet blir otroligt djup, och du har information om alla komponenter både i stort och i detalj.
- Utvecklarna ser inte på dig som "den där killen från testningen som gör något oklart", utan snarare som en jämlik, som skapar otroliga fördelar för teamet med sina automatiska tester och förutsägelse av buggar i specifika delar av produkten.
- Som ett resultat blir du mer effektiv, mer kvalificerad, mer eftertraktad.
I takt med att projektet växer blev jag i 100% av fallen mentor för de nya testarna som kom till projektet, jag lärde upp dem och delade med mig av de kunskaper som jag själv lärt mig. Beroende på projektet fick jag inte alltid experter på högsta nivå inom automatisering från ledningen och det fanns behov av att antingen utbilda dem i automatisering (för de som ville), eller skapa verktyg för deras dagliga aktiviteter (data-genereringsverktyg och deras uppladdning till systemet, verktyg för att genomföra belastningstestning/stabilitetstestning "snabbt" osv.).
Exempel på ett specifikt projekt
Tyvärr, på grund av sekretessavtal kan jag inte berätta om projekten jag har arbetat med i detalj, men jag kan ge exempel på typiska uppgifter för en Data Quality Engineer i ett av projekten.
Projektets kärna var att implementera en plattform för att förbereda data för att träna modeller för maskininlärning baserat på dem. Beställaren var ett stort läkemedelsföretag i USA. Tekniskt var detta en kluster , som kördes på instanser, med flera mikrotjänster och baserat på Open Source-projektet från företaget EPAM — , anpassat efter den specifika kundens behov (nu har projektet omformas till ). ETL-processerna organiserades med hjälp av och flyttade data från kundens system till Buckets. Därefter distribuerades en dockerbild av maskininlärningsmodellen på plattformen, som tränades på färska data och via REST API gränssnittet gav förutsägelser av intresse för verksamheten och som löste specifika problem.
Visuellt såg allt ungefär ut så här:
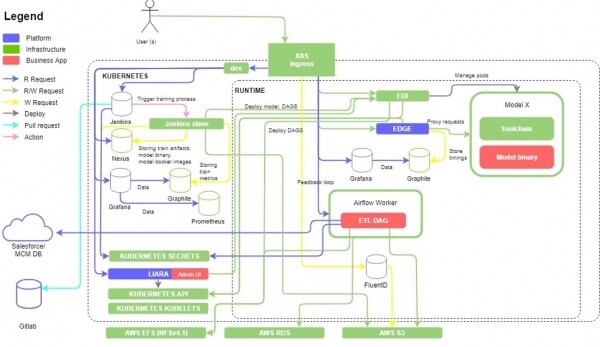
Det fanns tillräckligt med funktionell testning i detta projekt, och med tanke på hastigheten för funktionsutveckling och behovet av att upprätthålla takten i releasecykeln (tvåveckors sprintar), var det nödvändigt att genast tänka på automatisering av tester för de mest kritiska delarna av systemet. Större delen av plattformen baserad på Kubernetes täcktes av automatiserade tester som implementerades på + Python, men det var också nödvändigt att underhålla och utöka dem. Dessutom skapades en GUI för att hantera maskininlärningsmodellerna som distribuerades på klustret, samt möjligheten att specificera varifrån och vart data för modellträning skulle flyttas. Detta omfattande tillägg ledde till utvidgning av automatiserade funktionella kontroller, som till stor del genomfördes via REST API-anrop och ett fåtal end-2-end UI-tester. Ungefär på halva vägen i hela detta arbete anslöt sig en manuell testare till oss, som utmärkt hanterade godkännande av produktversioner och kommunikation med kunden angående godkännande av den senaste releasen. Dessutom, tack vare tillkomsten av den nya specialisten, kunde vi dokumentera vårt arbete och lägga till några mycket viktiga manuella kontroller som var svåra att automatisera direkt.
Och slutligen, efter att vi uppnått stabilitet med plattformen och GUI-överbyggnaden började vi bygga ETL-pipelines med hjälp av Apache Airflow DAGs. Automatisk kvalitetskontroll av data genomfördes genom att skriva speciella Airflow DAGs som kontrollerade data enligt resultaten från ETL-processen. Inom ramen för detta projekt hade vi tur, och kunden gav oss tillgång till anonymiserade datamängder som vi testade på. Vi kontrollerade data rad för rad mot typer, identifierade trasiga data, det totala antalet poster före och efter, samt jämförde de transformationer som utfördes av ETL-processen gällande aggregering, namnändringar på kolumner och mer. Dessutom skalades dessa kontroller på olika datakällor, exempelvis förutom SalesForce också på MySQL.
Kontroller av slutlig datakvalitet genomfördes redan på S3-nivå, där de lagrades och var i ready-to-use-tillstånd för att träna maskininlärningsmodeller. För att hämta data från den slutliga CSV-filen som ligger på S3 Bucket och validera dem, skrevs kod med hjälp av .
Det fanns också ett krav från kunden att lagra vissa data i en S3 Bucket och andra i en annan. För detta krävdes det också att skriva ytterligare kontroller som övervakade riktigheten av en sådan sortering.
Generell erfarenhet från andra projekt
Exempel på en allmän lista över aktiviteter för en Data Quality-ingenjör:
- Förbereda testdata (giltiga/ogiltiga, stora/ små) genom ett automatiserat verktyg.
- Ladda upp den förberedda databasen till den ursprungliga källan och kontrollera dess beredskap för användning.
- Köra ETL-processerna för att bearbeta databasen från den ursprungliga lagringsplatsen till den slutliga eller mellanliggande med hjälp av en viss uppsättning inställningar (om det är möjligt att ange konfigurerbara parametrar för ETL-uppgiften).
- Verifiera de bearbetade data som kom från ETL-processen med avseende på deras kvalitet och överensstämmelse med affärskrav.
Den huvudsakliga fokusen på kontroller bör inte bara ligga på att flödet av data i systemet har fungerat och nått slutet (vilket är en del av funktionell testning), utan i högre grad på att kontrollera och validera data för att säkerställa att de uppfyller förväntade krav, upptäckta avvikelser och annat.
Verktyg
En av teknikerna för sådan datakontroll kan vara att organisera kedjekontroller vid varje stadie av databehandling, den så kallade 'data chain' - kontroll av data från källan till den slutgiltiga användningen. Denna typ av kontroller genomförs oftast genom att skriva kontrollerande SQL-frågor. Det är uppenbart att sådana frågor bör vara så lätta som möjligt och kontrollera specifika delar av datakvalitet (tabellmetadata, tomma rader, NULL-värden, syntaxfel - andra nödvändiga attribut för kontroller).
Vid regressions testning, där redan färdiga (oförändrade eller något förändrade) datamängder används, kan koden för automatiserade tester innehålla redan färdiga mallar för datavalidering i termer av kvalitet (beskrivningar av förväntad tabellmetadata; strängar av urvalsområden som kan väljas slumpmässigt under testet, och annat).
Under testningen är det också nödvändigt att skriva test-ETL-processer, med hjälp av sådana ramverk som Apache Airflow, eller helt enkelt använda black-box molnverktyg av typen , och annat. Denna omständighet tvingar testingenjören att sätta sig in i principerna för ovan nämnda verktyg och att effektivare genomföra både funktionell testning (till exempel av befintliga ETL-processer i projektet) och använda dem för datavalidering. Specifikt, för Apache Airflow finns det redan färdiga operatörer för att arbeta med populära analytiska databaser, till exempel . Det mest grundläggande exemplet på dess användning har redan redovisats , så jag tänker inte upprepa mig.
Utöver färdiga lösningar är ingen förbjuden att utveckla sina egna tekniker och verktyg. Detta kommer inte bara att vara till nytta för projektet, utan också för Data Quality Engineer som därigenom förbättrar sin tekniska förståelse och programmeringsfärdigheter.
Hur detta fungerar i ett riktigt projekt
En bra illustration av de senaste styckena om "data chain", ETL och allestädes närvarande kontroller är följande process från ett av våra verkliga projekt:
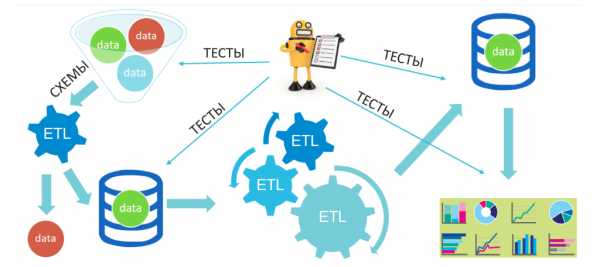
Här i ingångsvinkeln till vårt system strömmar olika data (naturligtvis förberedda av oss): giltiga, ogiltiga, blandade och så vidare, som filtreras och hamnar i ett mellanlagringsutrymme, sedan väntar en rad förändringar innan de placeras i slutlagringsutrymmet, från vilket analyser, datavitriner och affärsinsikter kommer att produceras. I ett sådant system fokuserar vi, utan att funktionellt kontrollera arbetet i ETL-processerna, på datans kvalitet före och efter transformationerna, samt på resultaten i analysen.
Sammanfattningsvis, oavsett var jag har arbetat har jag alltid varit involverad i Data-projekt som kännetecknas av följande drag:
- Endast genom automatisering kan vissa fall kontrolleras och en acceptabel releasescykel för företaget uppnås.
- Testaren i ett sådant projekt är en av de mest respekterade medlemmarna i teamet, eftersom de ger stort värde för varje deltagare (snabbare testning, bra data för Data Scientist, upptäckte defekter i ett tidigt skede).
- Det spelar ingen roll om du arbetar på din egen hårdvara eller i molnet — alla resurser är abstrakterade i en kluster av typen Hortonworks, Cloudera, Mesos, Kubernetes och så vidare.
- Projekt bygger på mikrotjänstestrukturen, med betoning på distribuerade och parallella beräkningar.
Jag noterar att när man arbetar med testning inom Data Quality flyttar testspecialisten sitt professionella fokus till produktens kod och de verktyg som används.
Utmärkande egenskaper för Data Quality-testning
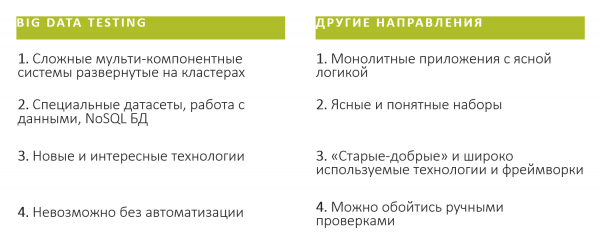
Dessutom har jag identifierat följande (vilket jag genast vill påpeka är MYCKET generaliserade och helt subjektiva) utmärkande drag för testning inom Data (Big Data) projekt (system) och andra områden:
Nyttiga länkar
- Teori: .
- EPAM
- Rekommenderat material för en nybörjare inom Data Quality engineering:
- Kostnadsfri kurs på Stepik: .
- Kurs på LinkedIn Learning: .
- Artiklar:
- ;
- ;
- ;
- Video:
- ;
- ;
Slutsats
Data Quality — det här är en mycket ung och lovande riktning, att vara en del av den innebär att vara en del av ett slags startup. Genom att gå in i Data Quality kommer du att dyka ner i en mängd moderna eftertraktade teknologier, men det viktigaste är att det framför dig öppnar sig enorma möjligheter för att generera och förverkliga dina idéer. Du kommer att kunna använda en kontinuerlig förbättringsmetod inte bara i projektet utan också för dig själv, och därigenom ständigt utvecklas som specialist.
Källa: habr.com
