

Effekten av tabell- och indexbloat är välkänd och förekommer inte bara i Postgres. Det finns sätt att hantera det ”out of the box”, som VACUUM FULL eller CLUSTER, men dessa låser tabellerna under användning och kan därför inte alltid användas.
I artikeln kommer vi att gå igenom lite teori om hur bloat uppstår, hur man kan hantera det, om deferred constraints och de problem som de medför vid användning av tillägget pg_repack.
Denna artikel är baserad på PgConf.Russia 2020.
Varför uppstår bloat
Postgres bygger på en flerVersionsmodell (). Kärnan i detta är att varje rad i tabellen kan ha flera versioner, där transaktioner ser högst en av dessa versioner, men nödvändigtvis inte samma version. Detta möjliggör att flera transaktioner kan utföras samtidigt utan att påverka varandra nämnvärt.
Det är uppenbart att alla dessa versioner måste lagras. Postgres arbetar med minnet per sida, och en sida är den minimi mängd data som kan läsas från disken eller skrivas till den. Låt oss titta på ett litet exempel för att förstå hur detta sker.
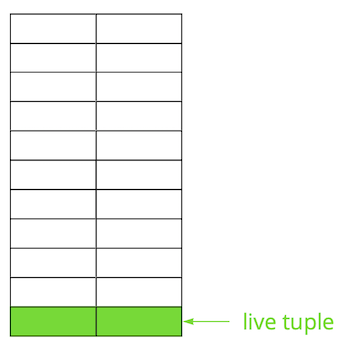
Anta att vi har en tabell där vi har lagt till flera poster. I den första sidan av filen där tabellen lagras har nya data lagts till. Detta är de aktiva versionerna av raderna, som är tillgängliga för andra transaktioner efter commit (för enkelhets skull antar vi att isoleringsnivån är Read Committed).
Därefter uppdaterade vi en av posterna och markerade därmed den gamla versionen som ogiltig.
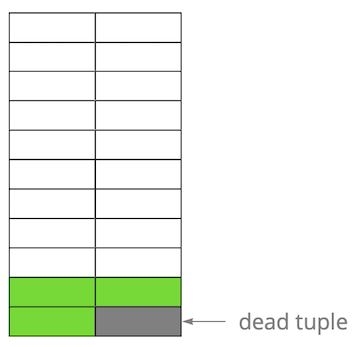
Steg för steg, genom att uppdatera och ta bort versioner av rader, har vi fått en sida där ungefär hälften av datan är ”skräp”. Dessa data är osynliga för någon transaktion.
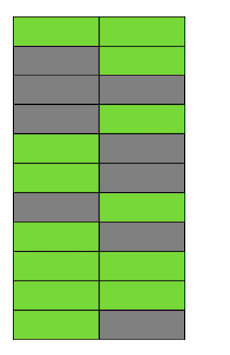
I Postgres finns det en mekanism , som rensar ogiltiga versioner och frigör plats för nya data. Men om den inte är inställd på att vara tillräckligt aggressiv eller sysselsatt med arbete i andra tabeller, så finns ”skräpdata” kvar, och vi tvingas använda ytterligare sidor för nya data.
Så i vårt exempel kommer tabellen vid någon tidpunkt att bestå av fyra sidor, men det kommer bara att finnas levande data i hälften av dem. Som ett resultat kommer vi att hämta mycket mer data från tabellen än nödvändigt.
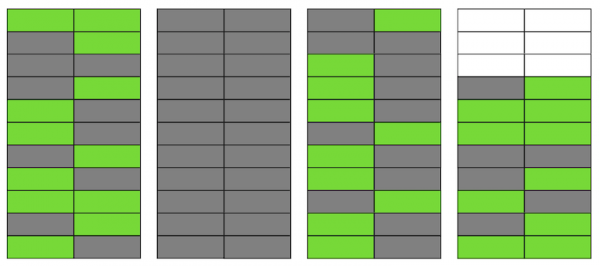
Även om VACUUM nu tar bort alla irrelevanta radversioner kommer situationen inte att förbättras radikalt. Vi får ledigt utrymme på sidorna eller till och med hela sidor för nya rader, men vi kommer fortfarande att läsa mer data än nödvändigt.
Förresten, om en helt tom sida (den andra i vårt exempel) hamnade i slutet av filen skulle VACUUM kunna trimma den. Men nu är den i mitten, så vi kan inte göra något med den.
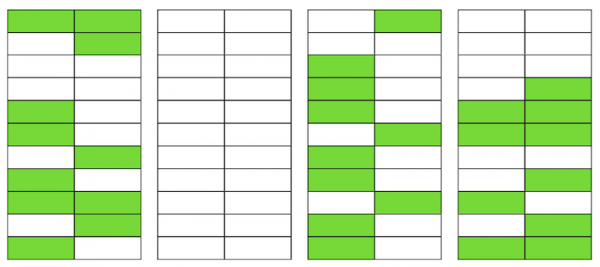
När antalet sådana tomma eller kraftigt nedpackade sidor blir stort, kallas det bloat, och det börjar påverka prestandan.
Ovanstående är mekaniken bakom uppkomsten av bloat i tabeller. I index sker detta ungefär på samma sätt.
Har jag bloat?
Det finns flera sätt att avgöra om du har bloat. Idén med den första är att använda inre statistik från Postgres, som innehåller ungefärlig information om antalet rader i tabellerna, antalet "levande" rader etc. På internet finns det många varianter av redan färdiga skript. Vi tog som utgångspunkt från PostgreSQL Experts, som kan bedöma bloat av tabeller tillsammans med toast och bloat av btree-index. Enligt vår erfarenhet ligger dess felmarginal på 10-20%.
Ett annat sätt är att använda tillägget , vilket gör att du kan titta inuti sidorna och få både en uppskattning och ett exakt värde för bloat. Men i det andra fallet måste hela tabellen genomsökas.
Ett litet bloat-värde, upp till 20%, anses vara acceptabelt. Det kan liknas vid fillfactor för och . Vid 50% och mer kan problem med prestanda börja uppstå.
Sätt att hantera bloat
I Postgres finns det flera sätt att hantera bloat "out-of-the-box", men de passar långt ifrån alltid och för alla.
Konfigurera AUTOVACUUM så att bloat inte uppstår. För att vara mer exakt, så att det hålls på en nivå som är acceptabel för dig. Det kan verka som ett ”kapten råd”, men i verkligheten är detta inte alltid lätt att uppnå. Till exempel, om du har aktiv utveckling med regelbundna ändringar i datamodellen eller om det pågår någon form av datamigrering. Som en följd kan din belastningsprofil förändras ofta, och vanligtvis är den olika för olika tabeller. Det betyder att du hela tiden måste ligga steget före och justera AUTOVACUUM efter den föränderliga profilen för varje tabell. Men det är uppenbart att det inte är enkelt att göra.
En annan vanlig orsak till att AUTOVACUUM inte hinner bearbeta tabellerna är när det finns långvariga transaktioner som hindrar det från att rensa data eftersom de är tillgängliga för dessa transaktioner. Rekommendationen här är också uppenbar – bli av med ”hängande” transaktioner och minimera tiden för aktiva transaktioner. Men om belastningen på din applikation är en hybrid av OLAP och OLTP kan du ha både många frekventa uppdateringar och korta frågor samtidigt, samt längre operationer – till exempel att skapa någon form av rapport. I en sådan situation bör du överväga att fördela belastningen på olika databaser, vilket skulle möjliggöra en finare justering av var och en av dem.
Ett annat exempel – även om profilen är homogent, men databasen är under mycket hög belastning, kan även det mest aggressiva AUTOVACUUM misslyckas, och bloat kan uppstå. Skala (vertikalt eller horisontellt) är den enda lösningen.
Vad ska man göra i en situation där du har ställt in AUTOVACUUM, men bloat fortsätter att öka.
Team VACUUM FULL återuppbygger innehållet i tabeller och index och lämnar bara aktuell data. För att åtgärda bloat fungerar den perfekt, men under dess körning låser den tabellen med ett exklusivt lås (AccessExclusiveLock), vilket gör att frågor mot denna tabell inte kan utföras, inte ens select-frågor. Om du kan tillåta att din tjänst eller en del av den stoppas under en viss tid (från tiotals minuter till flera timmar beroende på storleken på databasen och din hårdvara), är det här alternativet det bästa. Tyvärr hinner vi inte köra VACUUM FULL under den planerade underhållet, så den metoden passar oss inte.
Team CLUSTER den återuppbygger tabellinnehållet, precis som VACUUM FULL, men tillåter att ange en index som data kommer att ordnas fysiskt på disken (men för nya rader garanteras ordningen inte i framtiden). I vissa situationer är detta en bra optimering för en rad frågor – med läsning av flera poster via index. Nackdelen med kommandot är densamma som med VACUUM FULL – det låser tabellen under arbete.
Team REINDEX är lik de två föregående, men utför återuppbyggnad av ett specifikt index eller alla index i tabellen. Låsningarna är något svagare: ShareLock på tabellen (hindrar modifieringar men tillåter select) och AccessExclusiveLock på det återuppbyggda indexet (låser förfrågningar som använder detta index). Men i version 12 av Postgres introducerades parametrar , som tillåter att återuppbygga indexet utan att blockera parallell inmatning, ändring eller borttagning av poster.
I tidigare versioner av Postgres kan man nå resultat som liknar REINDEX CONCURRENTLY genom . Det tillåter att skapa ett index utan strikt låsning (ShareUpdateExclusiveLock, som inte hindrar parallella förfrågningar), sedan byta ut det gamla indexet mot det nya och ta bort det gamla indexet. Detta möjliggör eliminering av indexbloat utan att störa ditt applikationsarbete. Det är viktigt att notera att när index återuppbyggs kommer det att finnas en extra belastning på diskunderlaget.
Således, om det finns sätt för index att eliminera bloat "på språng", finns det inga sådana för tabeller. Här kommer olika externa tillägg in i bilden: (tidigare pg_reorg), , och andra. I denna artikel kommer jag inte att jämföra dem utan bara berätta om pg_repack, som vi använder efter viss anpassning.
Hur pg_repack fungerar
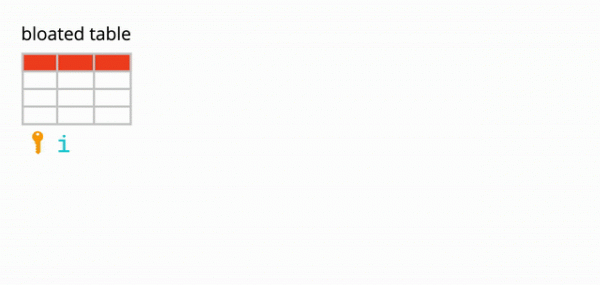
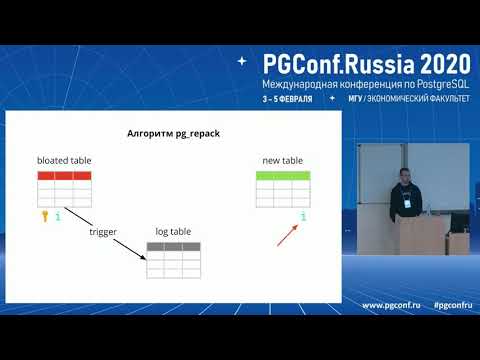
Antag att vi har en ganska vanlig tabell - med index, begränsningar och, tyvärr, med bloat. Det första steget pg_repack gör är att skapa en loggtabell för att lagra data om alla förändringar under arbetets gång. En trigger kommer att replikera dessa förändringar vid varje insert, update och delete. Därefter skapas en tabell som liknar den ursprungliga i struktur, men utan index och begränsningar, för att inte sakta ner datainmatningsprocessen.
Därefter flyttar pg_repack över data från den gamla tabellen till den nya, och filtrerar automatiskt bort alla irrelevanta rader, och skapar sedan index för den nya tabellen. Under tiden som alla dessa operationer utförs samlas ändringarna i loggtabellen.
Nästa steg är att överföra ändringarna till den nya tabellen. Överföringen utförs i flera iterationer, och när det finns mindre än 20 poster kvar i loggtabellen tar pg_repack en strikt låsning, överför de senaste data och ersätter den gamla tabellen med den nya i Postgres systemtabeller. Det är den enda och mycket korta tiden då du inte kan arbeta med tabellen. Efter detta tas den gamla tabellen och loggtabellen bort, och utrymme frigörs i filsystemet. Processen är avslutad.
I teorin ser allt bra ut, men hur är det i praktiken? Vi testade pg_repack utan belastning och under belastning, och granskade dess funktion vid en åtgärd för att stoppa den i förtid (med andra ord via Ctrl+C). Alla tester var positiva.
Vi gick live – och här gick allt inte som vi förväntade oss.
Första lyckosamma försöket i produktion
På den första klustret fick vi ett fel om ett brott mot unika begränsningar:
$ ./pg_repack -t tablename -o id
INFO: ompackar tabellen "tablename"
ERROR: frågan misslyckades:
    ERROR: duplicerat nyckelvärde bryter mot unik begränsning "index_16508"
DETAIL: Nyckel (id, index)=(100500, 42) existerar redan.
Denna begränsning hade ett autogenererat namn index_16508 – det skapades av pg_repack. Genom Attribute som ingår i det bestämde vi "vår" begränsning som motsvarade det. Problemet visade sig vara att detta inte är en helt vanlig begränsning, utan en uppskjuten (), dvs. att verifieringen av det utförs senare än SQL-kommandot, vilket leder till oväntade konsekvenser.
Uppskjutna begränsningar: varför de behövs och hur de fungerar
Lite teori om uppskjutna begränsningar.
Låt oss överväga ett enkelt exempel: vi har en referenstabell över bilar med två attribut – namn och ordningen på bilen i referenslistan.
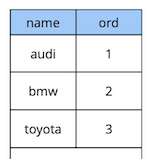
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Anta att vi behöver byta plats på den första och andra bilen. En "rak" lösning är att uppdatera det första värdet till det andra, och det andra till det första:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Men när vi utför denna kod förväntar vi oss naturligtvis ett brott mot begränsningen eftersom ordningen på värdena i tabellen är unik:
[23305] FEL: duplicerat nyckelvärde bryter mot unik begränsning “uk_cars”
Detalj: Nyckel (ord)=(2) finns redan.
Hur gör man på ett annat sätt? Första alternativet: lägg till en extra ersättning av värdet till en ordning som garanterat inte finns i tabellen, till exempel “-1”. Inom programmering kallas detta “byta värden på två variabler med hjälp av en tredje”. Den enda nackdelen med denna metod är ytterligare en uppdatering.
Andra alternativet: omdesigna tabellen för att använda flyttal för ordningen istället för heltal. Då, vid uppdatering av värden med 1 till exempel till 2.5, kommer den första posten automatiskt att placera sig mellan den andra och tredje. Denna lösning fungerar, men det finns två begränsningar. För det första passar den dig inte om värdet används någonstans i gränssnittet. För det andra, beroende på noggrannheten hos datatypen, kommer du att ha ett begränsat antal möjliga insättningar innan omberäkning av alla posters värden.
Tredje alternativet: gör begränsningen uppskjuten, så att den endast kontrolleras vid commit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Eftersom logiken i vår ursprungliga fråga garanterar att alla värden är unika vid tidpunkten för commit, kommer den att genomföras framgångsrikt.
Exemplet ovan är förstås mycket syntetiskt, men det förklarar idén. I vår applikation använder vi uppskjutna begränsningar för att implementera logik som hanterar konflikter när flera användare arbetar med gemensamma objekt-widgetar på tavlan. Användningen av sådana begränsningar gör att vi kan göra den applicerade koden något enklare.
Överlag, beroende på typen av begränsning i Postgres, finns det tre nivåer av granularitet för deras kontroll: radnivå, transaktionsnivå och uttrycksnivå.
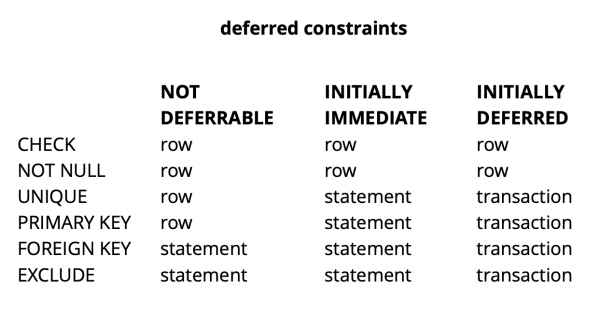
Källa:
CHECK och NOT NULL kontrolleras alltid på radnivå, medan för andra begränsningar, som framgår av tabellen, finns olika alternativ. Detaljer kan läsas om. .
Sammanfattningsvis ger uppskjutna begränsningar i flera situationer mer läsbar kod och färre kommandon. Men man får betala för detta med en mer komplicerad felsökningsprocess, eftersom tidpunkten för att ett fel uppstår och tidpunkten för när man får veta om det är åtskild. En annan potentiell problematik är att schemaläggaren inte alltid kan bygga en optimal plan om den inkluderar en uppskjuten begränsning i förfrågan.
Förbättring av pg_repack
Vi har förstått vad uppskjutna begränsningar är, men hur hänger de ihop med vårt problem? Låt oss återkalla felet vi fick tidigare:
$ ./pg_repack -t tablename -o id
INFO: ompackar tabellen "tablename"
ERROR: frågan misslyckades:
    ERROR: duplicerat nyckelvärde bryter mot unik begränsning "index_16508"
DETAIL: Nyckel (id, index)=(100500, 42) existerar redan.
Det uppstår i samband med kopieringen av data från loggtabellen till den nya tabellen. Det verkar märkligt, eftersom data i loggtabellen committas tillsammans med data från den ursprungliga tabellen. Om de uppfyller begränsningarna för den ursprungliga tabellen, hur kan de då bryta mot samma begränsningar i den nya?
Som det visar sig ligger roten till problemet i det föregående steget av pg_repack, där endast index skapas, men inga begränsningar: den gamla tabellen hade en unik begränsning, och i den nya skapades istället ett unikt index.
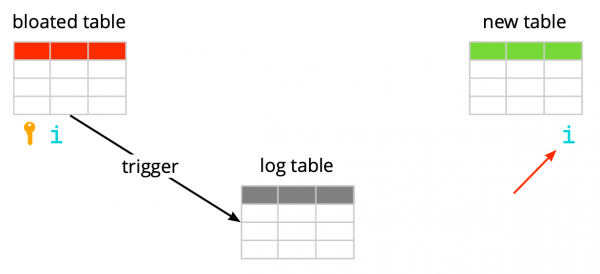
Det är viktigt att notera att om begränsningen är vanlig och inte uppskjuten, så är det skapade unika indexet likvärdigt med denna begränsning, eftersom unika begränsningar i Postgres implementeras genom att skapa ett unikt index. Men i fallet med en uppskjuten begränsning är beteendet inte detsamma, eftersom indexet inte kan vara uppskjutet och alltid kontrolleras vid körningen av SQL-kommandot.
Således ligger problemet i "uppskjutningen" av kontrollen: i den ursprungliga tabellen sker den vid tidpunkten för commit, medan den i den nya sker vid tidpunkten för körningen av SQL-kommandot. Det innebär att vi måste se till att kontrollerna görs på samma sätt i båda fallen: antingen alltid uppskjutet eller alltid omedelbart.
Så, vilka idéer hade vi.
Skapa ett index som är likvärdigt med deferred
Den första idén är att utföra båda kontrollerna i omedelbart läge. Detta kan leda till flera falska positiva svar vid begränsningar, men om de är få bör det inte påverka användarnas arbete, eftersom sådana konflikter är en normal situation för dem. De inträffar till exempel när två användare börjar redigera samma widget samtidigt, och klienten för den andra användaren hinner inte få information om att widgeten redan är låst för redigering av den första användaren. I en sådan situation svarar servern den andra användaren med ett avslag, och deras klient rullar tillbaka ändringarna och låser widgeten. Någon tids efteråt, när den första användaren avslutar redigeringen, får den andra information om att widgeten inte längre är låst, och kan upprepa sin åtgärd.
För att kontrollerna alltid ska vara i brådskande läge har vi skapat ett nytt index, liknande det ursprungliga fördröjda begränsningen:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- kör pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
I testmiljön fick vi bara några få förväntade fel. Framgång! Vi körde åter pg_repack på produkten och fick 5 fel på den första klustern under en timmes drift. Detta är ett Acceptabelt resultat. Men redan på den andra klustern ökade antalet fel flera gånger och vi var tvungna att stoppa pg_repack.
Varför hände detta? Sannolikheten för att ett fel inträffar beror på hur många användare som arbetar samtidigt med de samma widgetarna. Det verkar som om det vid den tiden fanns mycket färre konkurrerande förändringar i data som lagrades på den första klustern jämfört med de andra, det vill säga att vi helt enkelt hade "tur".
Idén fungerade inte. Vid den tiden såg vi två andra alternativ för att lösa problemet: omarbeta vår applikationskod för att avstå från de fördröjda begränsningarna, eller "lära" pg_repack att arbeta med dem. Vi valde den andra.
Ersätt indexerna i den nya tabellen med de fördröjda begränsningarna från den ursprungliga tabellen
Målet med förbättringen var uppenbart – om den ursprungliga tabellen har en fördröjd begränsning, så måste en sådan begränsning skapas för den nya istället för ett index.
För att kontrollera våra förändringar skrev vi ett enkelt test:
- tabell med en fördröjd begränsning och en post;
- vi sätter in data i en cykel som konflikterar med den befintliga posten;
- vi gör en uppdatering – data konflikter inte längre;
- vi committar ändringar.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Den ursprungliga versionen av pg_repack kraschar alltid vid den första insättningen, den reviderade versionen fungerade utan fel. Utmärkt.
Vi går live och får återigen ett fel i samma fas när datakopieringen från loggtabellen till den nya:
$ ./pg_repack -t tablename -o id
INFO: ompackar tabellen "tablename"
ERROR: frågan misslyckades:
    ERROR: duplicerat nyckelvärde bryter mot unik begränsning "index_16508"
DETAIL: Nyckel (id, index)=(100500, 42) existerar redan.
Klassisk situation: allt fungerar i testmiljöer, men inte i produktion?!
APPLY_COUNT och gränsen mellan två batchar
Vi började analysera koden rad för rad och upptäckte en viktig punkt: överföringen av data från loggtabellen till den nya sker i batchar, konstanten APPLY_COUNT angav storleken på batchen:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* det kan fortfarande finnas några tuples, upprepa. */
...
}
Problemet är att data från den ursprungliga transaktionen, där flera operationer potentiellt kan bryta mot begränsningen, vid överföringen kan hamna i gränsen mellan två batchar – hälften av kommandona kommer att committas i den första batchen, medan den andra hälften kommer att committas i den andra. Och här beror det på tur: om kommandona i den första batchen inte bryter mot några begränsningar, är allt bra, men om de bryter mot dem – uppstår ett fel.
APPLY_COUNT är 1000 poster, vilket förklarar varför våra tester passerade framgångsrikt – de täckte inte fallet med "gränsen mellan batcharna". Vi använde två kommandon – insert och update, så exakt 500 transaktioner med två kommandon fick alltid plats i batchen och vi upplevde inga problem. Efter att ha lagt till en andra update slutade vår modifiering att fungera:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- en till update
    COMMIT;
  END;
END LOOP;
Så nästa uppgift är att se till att data från den ursprungliga tabellen, som förändrades i en transaktion, också hamnar i den nya tabellen inom samma transaktion.
Avstående från batchning
Och vi hade återigen två lösningar. Första: låt oss helt avstå från att dela upp i batchar och istället göra dataöverföringen i en transaktion. För detta beslut talade dess enkelhet – de nödvändiga kodändringarna är minimala (för övrigt fungerade pg_reorg i äldre versioner på just detta sätt). Men det finns ett problem — vi skapar en långvarig transaktion, och detta, som nämnts tidigare, utgör en risk för att ny bloat uppstår.
Den andra lösningen är mer komplex, men antagligen mer korrekt: skapa en kolumn i loggtabellen med identifieraren för den transaktion som la till data i tabellen. Då kan vi, när vi kopierar data, gruppera dem efter denna attribut och garantera att relaterade ändringar överförs tillsammans. Batchen kommer att bestå av flera transaktioner (eller en stor) och dess storlek kommer att variera beroende på hur mycket data som har ändrats i dessa transaktioner. Det är viktigt att notera att eftersom data från olika transaktioner kommer in i loggtabellen i slumpmässig ordning, kommer det inte längre att vara möjligt att läsa den sekventiellt, som det var tidigare. seqscan med filtrering efter tx_id vid varje förfrågan är alltför kostsamt, vi behöver en index, men det kommer att sakta ner metoden på grund av kostnaderna för att uppdatera det. Som vanligt måste man offra något.
Så vi bestämde oss för att börja med det första alternativet, då det var enklare. Först behövde vi förstå om en långvarig transaktion verkligen skulle vara ett problem. Eftersom den huvudsakliga dataöverföringen från den gamla tabellen till den nya också sker i en långvarig transaktion, förändrades frågan till "hur mycket kommer vi att öka denna transaktion?" Varaktigheten av den första transaktionen beror främst på storleken på tabellen. Varaktigheten av den nya beror på hur mycket ändringar som samlas i tabellen under databeläggningen, dvs. från belastningens intensitet. pg_repack kördes under minimal belastning på tjänsten, och mängden ändringar var i jämförelse med det ursprungliga tabellinnehållet obetydlig. Vi beslutade att vi kunde bortse från tiden för den nya transaktionen (i genomsnitt är detta 1 timme och 2-3 minuter).
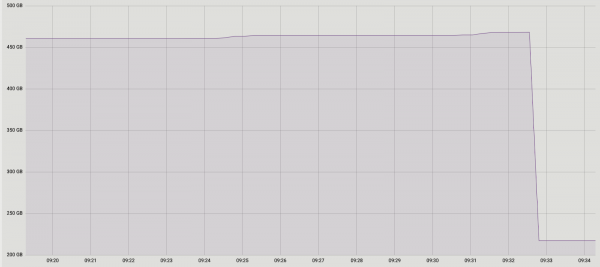
Experimenten var framgångsrika. Produktionsstarten också. För tydlighetens skull – en bild som visar storleken på en av databaserna efter körningen:
Eftersom denna lösning fullt ut passar oss, så har vi inte prövat att implementera en andra, men vi överväger möjligheten att diskutera det med utvecklarna av tillägget. Tyvärr är vår nuvarande förbättring ännu inte klar för publicering, eftersom vi bara har löst problemet med unika förseningar, och för en fullständig patch behöver vi även stöd för andra typer. Vi hoppas kunna göra detta i framtiden.
Kanske har du undrat varför vi överhuvudtaget gav oss in i denna historia med att förbättra pg_repack, istället för att använda dess motsvarigheter? Vid något tillfälle tänkte vi också så, men den positiva erfarenheten vi hade tidigare, med tabeller utan förseningar, motiverade oss att försöka förstå problemet och åtgärda det. Dessutom kräver användningen av andra lösningar också tid för tester, så vi beslutade att först försöka lösa problemet i det och om vi inser att vi inte kan göra det inom rimlig tid, då börjar vi överväga alternativ.
Slutsatser
Vad vi kan rekommendera baserat på egen erfarenhet:
- Övervaka din bloat. Baserat på övervakningsdata kan du förstå hur väl autovacuum är inställt.
- Konfigurera AUTOVACUUM för att hålla bloat på acceptabel nivå.
- Om bloat ändå ökar och du inte kan övervinna det med hjälp av "out-of-the-box"-lösningar, tveka inte att använda externa tillägg. Det viktigaste är att noggrant testa allt.
- Tveka inte att förbättra externa lösningar för dina behov – ibland kan detta vara mer effektivt och till och med enklare än att ändra din egen kod.
Källa: habr.com
