

Hej, Habr!
I ljuset av den aktuella situationen på grund av coronaviruset har ett antal internettjänster fått en ökad belastning. Till exempel, , eftersom kapaciteten inte räckte till. Och det är långt ifrån alltid möjligt att snabba upp en server genom att helt enkelt lägga till kraftfullare utrustning, ändå måste vi bearbeta kundernas förfrågningar (eller så går de till konkurrenterna).
I den här artikeln kommer jag kort att berätta om populära metoder som kan hjälpa till att skapa en snabb och motståndskraftig tjänst. Men bland de möjliga utvecklingsscheman har jag valt ut bara de som är lätta att använda.För varje punkt har du antingen redan färdiga bibliotek, eller så finns det möjlighet att lösa uppgiften med hjälp av en molnplattform.
Horisontell skalning
Det enklaste och mest kända punkten. I allmänhet finns det två vanliga sätt att fördela belastningen — horisontell och vertikal skalning. låter du tjänster arbeta parallellt, vilket fördelar belastningen mellan dem. beställer du kraftfullare servrar eller optimerar koden.
Som exempel tar jag ett abstrakt molnlagringssystem för filer, det vill säga en analog till OwnCloud, OneDrive och så vidare.
Den standardiserade bilden av en sådan struktur nedan visar bara systemets komplexitet. För vi måste på något sätt synkronisera tjänsterna. Vad händer om en användare sparar en fil från sin surfplatta och sedan vill titta på den från sin telefon?
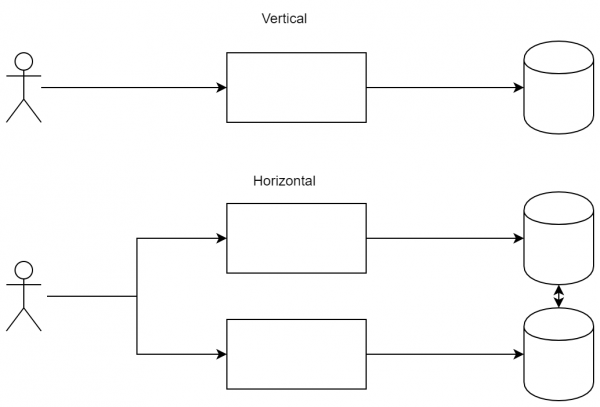
Skillnaden mellan metoderna: vid vertikal skalning är vi beredda att öka kapaciteten hos noderna, medan vi vid horisontell skalning lägger till nya noder för att fördela belastningen.
CQRS
är ett ganska viktigt mönster eftersom det gör det möjligt för olika kunder att inte bara ansluta till olika tjänster, utan också att få samma flöden av händelser. Dess fördelar är inte så uppenbara för en enkel applikation, men den är extremt viktig (och enkel) för en belastad tjänst. Kärnan i detta är att inkommande och utgående datastreamar inte bör korsas. Det vill säga att du inte kan skicka en förfrågan och förvänta dig ett svar, istället skickar du en förfrågan till tjänst A men får svaret i tjänst B.
Den första fördelen med detta tillvägagångssätt är möjligheten att avbryta anslutningen (i bred mening av ordet) under processen av ett långvarigt begäran. Som exempel kan vi ta en mer eller mindre standardiserad sekvens:
- Klienten skickade en begäran till servern.
- Servern påbörjade en långvarig bearbetning.
- Servern svarade klienten med resultatet.
Tänk dig att det i punkt 2 inträffade ett avbrott i kommunikationen (antingen återanslöt nätverket, eller så bytte användaren till en annan sida och avbröt anslutningen). I detta fall kommer det att vara svårt för servern att skicka svar till användaren med information om vad som faktiskt har behandlats. Genom att använda CQRS kommer sekvensen att vara något annorlunda:
- Klienten har prenumererat på uppdateringar.
- Klienten skickade en begäran till servern.
- Servern svarade 'begäran mottagen'.
- Servern svarade med resultatet genom kanalen från punkt '1'.
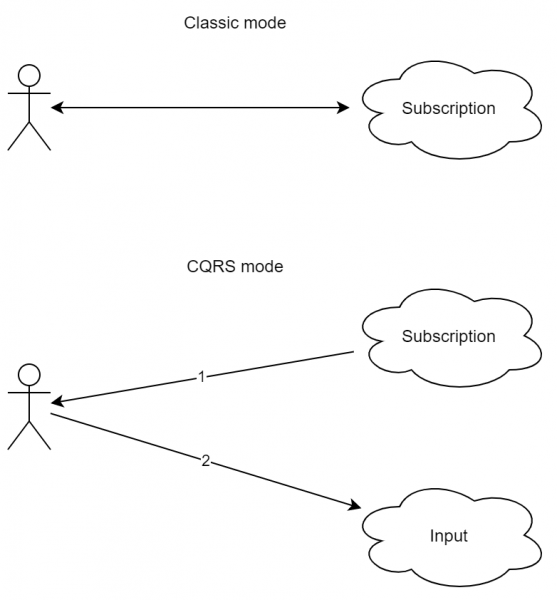
Som man kan se är schemat något mer komplext. Dessutom saknas det intuitiva tillvägagångssättet request-response här. Men som man kan se kommer ett avbrott i kommunikationen under behandling av begäran inte att leda till ett fel. Dessutom, om användaren verkligen är ansluten till tjänsten med flera enheter (till exempel med en mobiltelefon och en surfplatta), kan man se till att svaret kommer till båda enheterna.
Det intressanta är att koden för behandling av inkommande meddelanden blir densamma (inte till 100%) för både händelser som påverkats av själva klienten och för andra händelser, inklusive från andra kunder.
Men i praktiken får vi ytterligare fördelar eftersom den enkla strömmen kan behandlas på funktionellt sätt (med RX och liknande). Och det är redan en stor fördel, eftersom applikationen i stort sett kan göras helt reaktiv, dessutom med hjälp av ett funktionellt tillvägagångssätt. För mer omfattande program kan detta avsevärt spara resurser vid utveckling och underhåll.
Om man kombinerar detta tillvägagångssätt med horisontell skalning får vi bonusen av att kunna skicka begärningar till en server och få svar från en annan. På så sätt kan klienten själv välja en tjänst som passar dem, och systemet kan på insidan ändå korrekt bearbeta händelser.
Event Sourcing
Som ni vet är en av de främsta egenskaperna hos ett distribuerat system avsaknaden av gemensam tid och gemensam kritisk sektion. För en enskild process kan du göra en synkronisering (på samma mutexar), där du är säker på att ingen annan kör den koden. Men för ett distribuerat system är detta riskabelt eftersom det skulle innebära overhead och döda hela skönheten i skalbarhet – alla komponenter skulle ändå vänta på varandra.
Här får vi en viktig insikt – en snabb distribuerad system kan inte synkroniseras, för då minskar vi prestandan. Å andra sidan behöver vi ofta viss koherens mellan komponenterna. För detta kan vi använda en metod med , där det garanteras att, i avsaknad av dataändringar under en viss tidsperiod efter den senaste uppdateringen, kommer alla förfrågningar att returnera det senaste uppdaterade värdet.
Det är viktigt att förstå att strikt ofta tillämpas på klassiska databaser, där varje nod har identisk information (detta uppnås ofta när en transaktion anses vara genomförd först efter ett svar från den andra servern). Här finns vissa undantag på grund av isoleringsnivåer, men den övergripande essensen förblir densamma – du kan leva i en helt koherent värld.
Men låt oss återgå till den ursprungliga uppgiften. Om en del av systemet kan byggas med , så kan vi bygga följande schema.
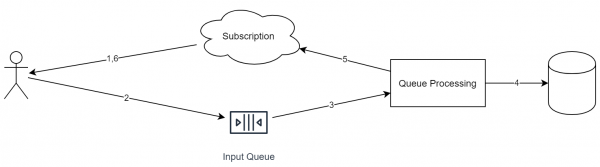
Viktiga egenskaper hos denna metod:
- Varje inkommande förfrågan placeras i en kö.
- Under behandlingen av förfrågan kan tjänsten också placera uppgifter i andra köer.
- Varje inkommande händelse har ett identifieringsnummer (som behövs för deduplication).
- Kön fungerar ideologiskt enligt "append only"-modellen. Det går inte att ta bort eller omorganisera element därifrån.
- Kön arbetar enligt FIFO (ursäkta tautologin). Om det behövs för parallell bearbetning bör föremålen flyttas till olika köer i en av stegen.
Jag påminner om att vi betraktar fallet av en online filserver. I detta fall kommer systemet att se ungefär ut så här:
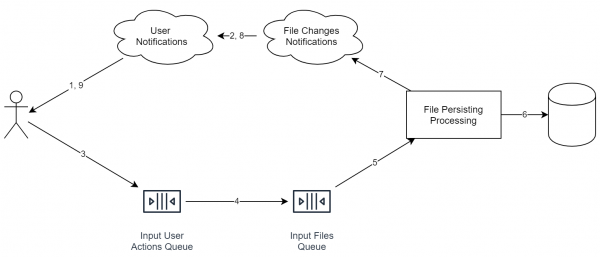
Det är viktigt att tjänsterna i diagrammet inte nödvändigtvis betyder enskilda servrar. Även processen kan vara densamma. Det viktiga är något annat: ideologiskt är dessa saker åtskilda på ett sådant sätt att det enkelt går att tillämpa horisontell skalning.
Och för två användare kommer schemat att se ut så här (tjänster avsedda för olika användare markeras med olika färger):
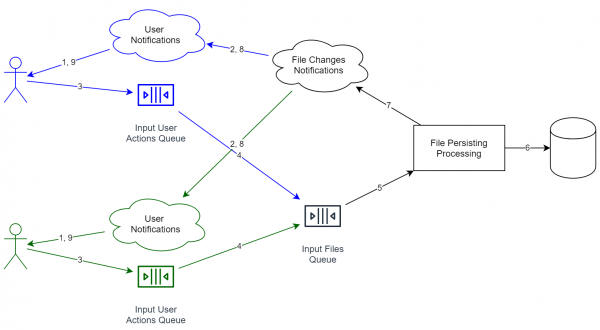
Fördelarna med en sådan kombination:
- Tjänsterna för informationsbehandling är åtskilda. Köerna är också åtskilda. Om vi behöver öka systemets genomströmning behöver vi bara starta fler tjänster på fler servrar.
- När vi får information från en användare behöver vi inte vänta på att all data ska sparas helt. Tvärtom, det räcker att vi svarar "ok", och sedan gradvis börja arbeta. Samtidigt jämnar kön ut toppar, eftersom tillägg av ett nytt objekt går snabbt, och användaren behöver inte vänta på en fullständig genomgång av hela cykeln.
- Som exempel har jag lagt till en dedupliceringstjänst som försöker sammanfoga identiska filer. Om den jobbar länge i 1 % av fallen kommer kunden praktiskt taget inte att märka det (se ovan), vilket är en stor fördel, eftersom vi inte längre kräver hundra procent hastighet och tillförlitlighet.
Men nackdelarna blir också tydliga:
- Vårt system har förlorat strikt konsistens. Det betyder att om man till exempel prenumererar på olika tjänster kan man teoretiskt få olika tillstånd (eftersom en av tjänsterna kan hinna ta emot meddelandet från den interna kön). Som en annan följd har systemet nu ingen gemensam tid. Det går alltså inte att sortera alla händelser endast efter ankomsttid, eftersom klockorna mellan servrarna kan vara osynkroniserade (dessutom är samma tid på två servrar en utopi).
- Inga händelser kan nu helt enkelt återskapas (som skulle kunna göras med en databas). Istället måste man lägga till en ny händelse — , som kommer att ändra det senaste tillståndet till det som krävs. Som ett exempel från ett liknande område: utan att skriva om historien (vilket är negativt i vissa fall) kan man i git inte ångra en commit, men man kan göra en speciell , som i grunden bara kommer att återställa det gamla tillståndet. Men i historiken kommer både den felaktiga commit och rollback att sparas.
- Dataschemat kan förändras från version till version, men gamla händelser kan nu inte uppdateras till den nya standarden (eftersom händelser i princip inte kan ändras).
Som vi ser passar Event Sourcing utmärkt med CQRS. Dessutom är det redan svårt att implementera ett system med effektiva och användarvänliga köer, utan att separera datastreams, eftersom vi då måste lägga till synkroniseringspunkter som kommer att neutralisera hela den positiva effekten av köerna. När man tillämpar båda tillvägagångssätten samtidigt måste koden för programmet justeras något. I vårt fall, när en fil skickas till servern, får vi bara "okej" som svar, vilket bara betyder att "filöverföringsoperationen har sparats". Formellt sett betyder det inte att datan redan är tillgänglig på andra enheter (till exempel kan dedupliceringstjänsten omstrukturera indexet). Men efter en tid kommer klienten att få en avisering i stil med "fil X har sparats".
Som ett resultat:
- Antalet statuser för filöverföring ökar: istället för den klassiska "fil skickad" får vi två: "fil tillagd i kön på servern" och "fil sparad i lagringen". Det senare betyder att andra enheter redan kan börja ta emot filen (med förbehåll för att köerna arbetar med olika hastigheter).
- Eftersom informationen om överföringen nu kommer via olika kanaler, måste vi hitta lösningar för att få status på filbehandlingen. Som en följd av detta: i motsats till det klassiska request-response, kan klienten startas om under filbehandlingen, men statusen för just denna bearbetning kommer att vara korrekt. Detta punkt fungerar i praktiken "out of the box". Som en följd av detta är vi nu mer toleranta mot fel.
Sharding
Som redan beskrivits ovan, inom system med event sourcing finns det ingen strikt konsistens. Det betyder att vi kan använda flera lagringsutrymmen utan någon synkronisering mellan dem. När vi närmar oss vår uppgift kan vi:
- Dela upp filer efter typer. Till exempel kan bilder/video avkodas och ett mer effektivt format väljas.
- Separera konton efter länder. På grund av många lagar kan detta krävas, men denna arkitekturschema möjliggör automatiskt detta.
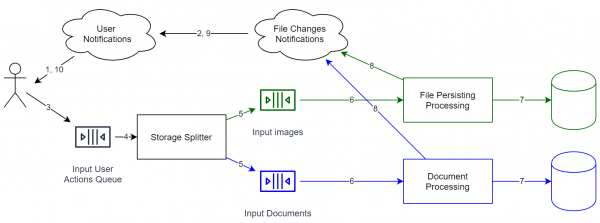
Om du vill överföra data från en lagring till en annan behövs redan standardmetoder. Tyvärr är det nödvändigt att stoppa kön, göra migrationen och sedan starta den igen. Generellt sett kan data inte överföras 'on-the-fly', men om händelsekön lagras helt och du har kopior av tidigare tillstånd av lagringen kan vi återspela händelser på följande sätt:
- I Event Source har varje händelse sitt eget identifierare (idealiskt — icke minskande). Det betyder att vi kan lägga till ett fält i lagringen — id för den senaste behandlade posten.
- Vi duplicerar kön så att alla händelser kan behandlas för flera oberoende lagringar (den första är den där data redan lagras, och den andra är ny, men för tillfället tom). Den andra kön behandlas förstås inte för närvarande.
- Vi startar den andra kön (det vill säga vi påbörjar återspelningen av händelser).
- När den nya kön relativt sett är tom (dvs. den genomsnittliga tidsdifferensen mellan tillägg av ett objekt och dess uttag är acceptabel) kan vi börja växla läsare till den nya lagringen.
Som vi kan se har vi i vårt system varken haft eller har strikt överensstämmelse. Det finns bara eventual consistency, det vill säga en garanti för att händelser behandlas i samma ordning (men eventuellt med olika fördröjningar). Och genom att utnyttja detta kan vi relativt enkelt flytta data utan att stoppa systemet till andra sidan av jorden.
Således, fortsätter vårt exempel om en online-lagring för filer, ger denna arkitektur oss redan ett antal fördelar:
- Vi kan flytta objekt närmare användarna, och detta görs dynamiskt. På så sätt kan vi förbättra kvaliteten på tjänsten.
- Vi kan lagra en del av data inom företagen. Till exempel kräver Enterprise-användare ofta att lagra sina data i kontrollerade datacenter (för att förhindra dataintrång). Genom sharding kan vi enkelt stödja detta. Och uppgiften förenklas ytterligare om kunden har en kompatibel molnlösning (till exempel, ).
- Och det viktigaste är att vi kanske inte behöver göra det. För i början skulle ett enda lagringsutrymme för alla konton vara tillräckligt (så att vi snabbt kan börja arbeta). Och den centrala egenskapen hos detta system är, även om det är skalbart, att det i början är ganska enkelt. Man behöver helt enkelt inte skriva kod som arbetar med en miljon separata oberoende köer och så vidare direkt. Om det behövs kan det göras i framtiden.
Statisk Innehålls-hosting
Denna punkt kan verka helt uppenbar, men den är ändå nödvändig för ett mer eller mindre standardbelastat program. Dess kärna är enkel: allt statiskt innehåll levereras inte från samma server som applikationen, utan från särskilda servrar som är avsedda för detta. Som en följd av detta utförs dessa operationer snabbare (exempelvis levererar nginx filer snabbare och mer kostnadseffektivt än en Java-server). Dessutom möjliggör arkitekturen för CDN () att placera våra filer närmare slutanvändarna, vilket positivt påverkar användarvänligheten.
Det enklaste och mest standardiserade exemplet på statiskt innehåll är en uppsättning skript och bilder för en webbplats. Det är enkelt — de är kända på förhand, och arkivet laddas upp på CDN-servrarna, från vilka det distribueras till slutanvändarna.
Men i verkligheten kan en något liknande metod som lambda-arkitekturen tillämpas för statiskt innehåll. Låt oss återvända till vårt uppdrag (ett online lagringsutrymme för filer), där vi behöver distribuera filer till användarna. Den enklaste lösningen är att skapa en tjänst som för varje användarförfrågan gör alla nödvändiga kontroller (auktorisering och så vidare) och sedan laddar ner filen direkt från vårt lagringsutrymme. Huvudnackdelen med denna metod är att det statiska innehållet (och en fil med en specifik_revision fungerar i grunden som statiskt innehåll) levereras av samma server som innehåller affärslogiken. Istället kan man göra följande schema:
- Servern ger en URL för nedladdning. Den kan se ut som file_id + key, där key är en miniatyrdigital signatur som ger tillgång till resursen under de närmaste 24 timmarna.
- Nedladdningen av filen hanteras av en enkel nginx med följande alternativ:
- Caching av innehåll. Eftersom den här tjänsten kan vara på en separat server har vi kvar en framtidslösning för att lagra alla de senaste nedladdade filerna på disken.
- Nyckelkontroll vid anslutningsskapande
- Valfritt: strömmande bearbetning av innehåll. Till exempel, om vi komprimerar alla filer i tjänsten, kan vi göra dekomprimeringen direkt i denna modul. Som en följd: IO-operationer genomförs där de hör hemma. En Java-arkivare kan lätt använda mycket extra minne, men att skriva om tjänsten med affärslogik på rust/c++ kan visa sig vara ineffektivt. I vårt fall används olika processer (eller till och med tjänster), så vi kan effektivt separera affärslogik och IO-operationer.
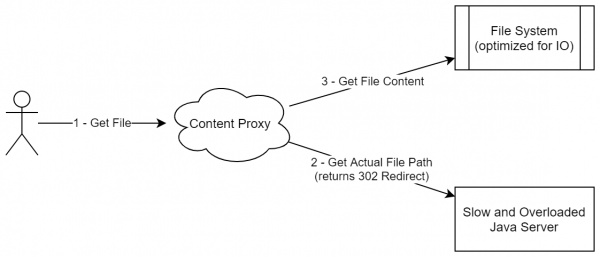
Denna typ av schema liknar inte mycket på distribution av statiskt innehåll (eftersom vi inte laddar upp hela paketet med statik någonstans), men i verkligheten hanterar denna metod just distribution av oföränderliga data. Dessutom kan detta schema generaliseras till andra fall där innehållet inte bara är statiskt utan kan presenteras i form av en uppsättning oföränderliga och oelimineringbara block (även om de kan läggas till).
Som ett annat exempel (för att befästa): om du har arbetat med Jenkins/TeamCity vet du att båda lösningarna är skrivna i Java. Båda är en Java-proces som hanterar både orkestrering av byggen och innehållshantering. Specifikt har de båda uppgifter som "överföra fil/-mapp från servern". Ett exempel: utfärdande av artefakter, överföring av källkod (när agenten inte laddar ner koden direkt från repot utan det gör servern), åtkomst till loggar. Alla dessa uppgifter skiljer sig i belastning på IO. Således blir det så att servern, som ansvarar för komplex affärslogik, också måste kunna effektivt hantera stora datamängder. Och det mest intressanta är att en sådan operation kan delegeras till nginx enligt exakt samma schema (med tillägget av nyckeldatan i begäran).
Men om vi återgår till vårt system, så ser vi ett sådant schema:
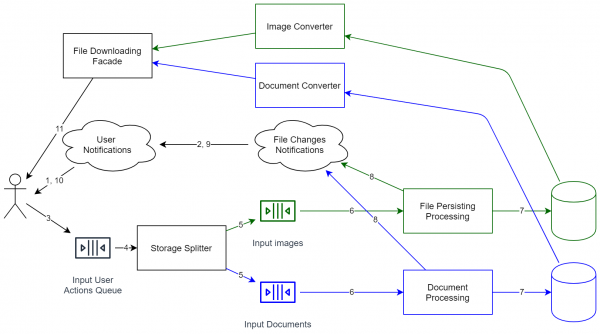
Som det framgår har systemet blivit radikalt mer komplicerat. Det är inte längre bara en mini-process som lagrar filer lokalt. Nu krävs inte bara enklare support, utan också versionskontroll av API:er osv. Därför, efter att alla diagram har ritats, är det bäst att noggrant överväga om kostnaderna för skalbarheten är värda det. Men om du vill ha möjlighet att skala systemet (inklusive för att arbeta med ännu fler användare), måste du acceptera sådana lösningar. Som ett resultat är systemets arkitektur redo för ökad belastning (nästan varje komponent kan klonas för horisontell skalning). Systemet kan uppdateras utan att stängas ner (enbart vissa operationer kan bromsas något).
Som jag nämnde i början, har flera internet-tjänster nu fått ökad belastning. Och vissa av dem har helt enkelt slutat fungera korrekt. I själva verket misslyckades systemen precis när företagen skulle börja tjäna pengar. Det vill säga, istället för att skjuta fram leveranser, istället för att erbjuda kunderna "planera leveranser över de kommande månaderna", sa systemet helt enkelt "gå till konkurrenterna". Och det är kostnaden för låg prestanda: förluster kommer att inträffa precis när vinsten skulle vara som högst.
Slutsats
Alla dessa tillvägagångssätt har varit kända tidigare. VK har länge använt idén om Static Content Hosting för att leverera bilder. Många online-spel använder en Sharding-plan för att dela upp spelare efter regioner eller för att dela upp spelmiljöer (om världen är en enhet). Event Sourcing-ansatsen används aktivt inom e-post. De flesta handelsapplikationer, där data kontinuerligt kommer in, är faktiskt byggda på CQRS-ansatsen för att kunna filtrera den mottagna datan. Och horisontell skalning har använts länge i många tjänster.
Men det viktigaste är att alla dessa mönster har blivit mycket lätta att tillämpa i moderna applikationer (om de är relevanta, förstås). Molntjänster erbjuder sharding och horisontell skalning som standard, vilket är mycket enklare än att beställa olika dedikerade servrar i olika datacenter själv. CQRS har blivit mycket enklare, delvis tack vare utvecklingen av bibliotek som RX. För tio år sedan skulle en sällsynt webbplats kunna stödja sådana saker. Event sourcing ställer in sig också otroligt lätt tack vare redan färdiga containrar med Apache Kafka. För tio år sedan hade detta varit en innovation, nu är det en självklarhet. På samma sätt med statisk innehållshosting: på grund av mer användarvänlig teknik (däribland för att det finns detaljerad dokumentation och en stor databas med svar), har denna metod blivit ännu enklare.
Som en följd har implementeringen av ett antal ganska komplexa arkitektoniska mönster nu blivit mycket enklare, vilket gör att man bör se närmare på dem i förväg. Om ett tioårigt program övergav en av de ovanstående lösningarna på grund av höga kostnader för implementering och drift, kan man nu, i ett nytt program, eller efter refaktorisering, skapa en tjänst som arkitektoniskt redan kommer att vara både skalbar (med avseende på prestanda) och redo för nya krav från kunderna (till exempel för lokalisering av personuppgifter).
Och det viktigaste: använd inte dessa metoder om ni har en enkel applikation. Ja, de är vackra och intressanta, men för en webbplats med en toppbesökare på 100 personer kan man ofta klara sig med en klassisk monolit (åtminstone utvändigt, internt kan allt brytas ner i moduler etc.).
Källa: habr.com
