

Jag vill gärna dela med mig av en sammanfattning av Alexandr Valjalkins föredrag från slutet av 2019 "Go-optimeringar i VictoriaMetrics"
– en snabb och skalbar databas för lagring och behandling av tidsseriedata (en post består av tid och en uppsättning värden som motsvarar den tiden, till exempel insamlade genom periodisk avläsning av sensorer eller insamling av mätvärden).
Här är länken till videon av detta föredrag –
Låt mig berätta lite om mig själv. Jag heter Alexandr Valjalkin. Här är . Jag är intresserad av Go och prestandaoptimering. Jag har skrivit många olika användbara och mindre användbara bibliotek. De börjar antingen med fast, eller med quick prefix.
För närvarande arbetar jag med VictoriaMetrics. Vad är det och vad gör jag där? Det kommer jag att berätta om i denna presentation.
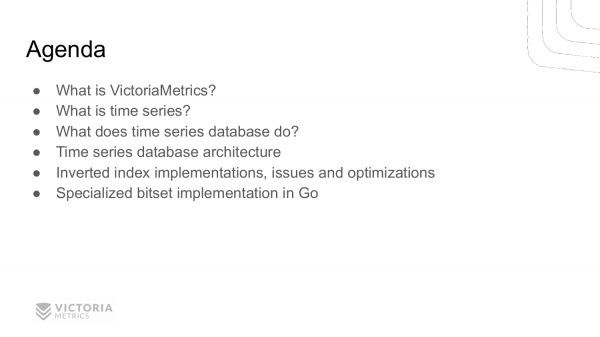
Föredragets plan ser ut så här:
- Först kommer jag att berätta vad VictoriaMetrics är.
- Sedan kommer jag att förklara vad tidsserier är.
- Därefter kommer jag att förklara hur en tidsseriedatabas fungerar.
- Vidare kommer jag att berätta om databasens arkitektur: hur den är uppbyggd.
- Och tillslut kommer vi att diskutera optimeringarna som finns i VictoriaMetrics. Det handlar om optimering av den inverterade indexen och optimering för bitset-implementationen på Go.
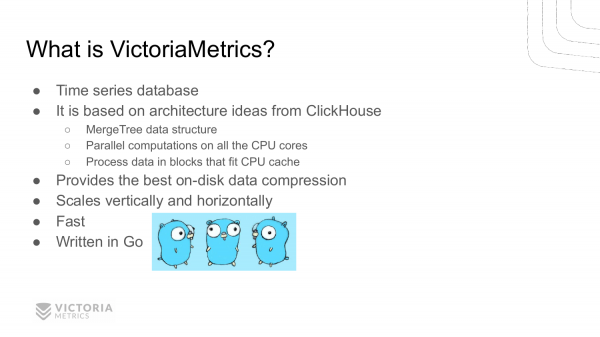
Vet någon i publiken vad VictoriaMetrics är? Oj, många känner redan till den. Det är goda nyheter. För dem som inte vet – det är en databas för tidsserier. Den är baserad på ClickHouse-arkitekturen, med vissa detaljer från ClickHouse-implementationen. Till exempel aspekter som: MergeTree, parallell beräkning på alla tillgängliga processor kärnor och prestandaoptimering genom att arbeta med datablokkar som placeras i processor-cache.
VictoriaMetrics erbjuder bättre datakompression jämfört med andra databaser för tidsserier.
Den kan skalas vertikalt – det vill säga att du kan lägga till fler processorer, mer RAM-minne på en maskin. VictoriaMetrics kommer att utnyttja dessa tillgängliga resurser effektivt och öka den linjära prestandan.
VictoriaMetrics kan även skalas horisontellt – det vill säga att du kan lägga till fler noder i VictoriaMetrics-klustret, och dess prestanda kommer att öka nästan linjärt.
Som ni kanske har gissat är VictoriaMetrics en snabb databas, eftersom jag inte kan skriva om andra. Den är skriven i Go, så därför pratar jag om den på detta meet-up.
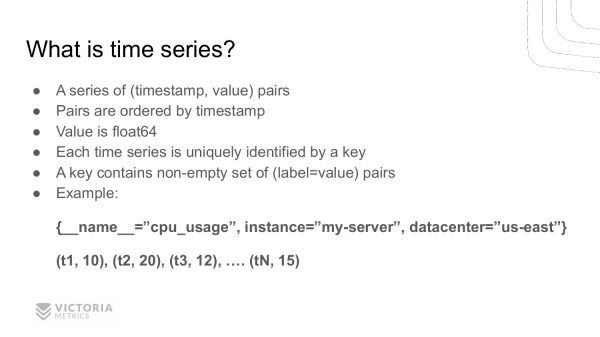
Vem vet vad en tidsserie är? Många människor känner också till det. En tidsserie är en sekvens av par (timestamp, värde), där dessa par är sorterade efter tid. Värdet utgörs av ett flyttal – float64.
Varje tidsserie identifieras unikt av en nyckel. Vad består denna nyckel av? Den består av en icke-tom uppsättning av par nyckel-värde.
Här är ett exempel på en tidsserie. Nyckeln till denna serie är en lista av par: __name__="cpu_usage" – det är namnet på metriket, instance="my-server" – det är datorn där denna metrik samlades in, datacenter="us-east" – det är datacentret där denna dator finns.
Vi har fått namnet på tidsserien, bestående av tre par nyckel-värde. Denna nyckel motsvarar en lista av par (timestamp, value). t1, t2, t3, ..., tN – dessa är timestamps, 10, 20, 12, ..., 15 – med motsvarande värden. Detta är cpu-användning just nu för den här serien.
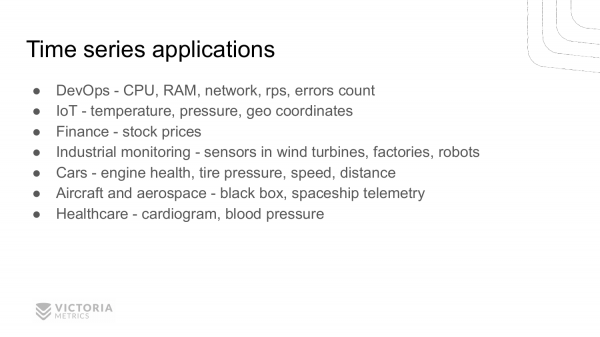
Var kan tidsserier användas? Har någon några idéer?
- Inom DevOps kan man mäta belastningen på CPU, RAM, nätverk, rps, antal fel, etc.
- IoT – vi kan mäta temperatur, tryck, geografiska koordinater och mer.
- Även inom finans – vi kan övervaka priser på olika aktier och valutor.
- Dessutom kan tidsserier användas för att övervaka produktionsprocesser på fabriker. Vi har användare som använder VictoriaMetrics för att övervaka vindkraftverk och robotar.
- Tidsserier är också användbara för att samla in information från sensorer på olika enheter. Till exempel för en motor; för att mäta trycket i däck; för att mäta hastighet, avstånd; för att mäta bränsleförbrukning, etc.
- Tidsserier kan också användas för att övervaka flygplan. Varje flygplan har en svart låda som samlar in tidsserier om olika hälsoparametrar för flygplanet. Tidsserier används också inom rymdindustrin.
- Hälsovård – det handlar om blodtryck, puls, etc.
Kanske finns det fler tillämpningar som jag har glömt, men jag hoppas att ni förstår att tidsserier används aktivt i den moderna världen. Och mängden av deras användning växer för varje år.
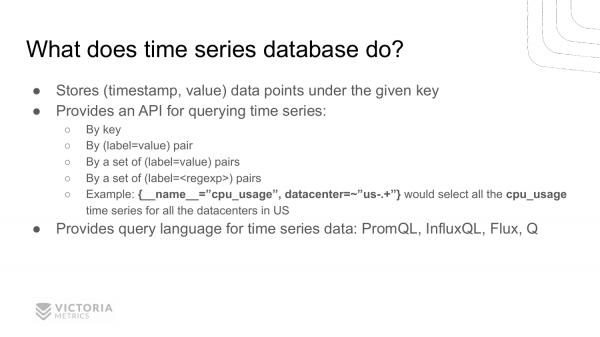
Vad behövs en databas för tidsserier? Varför kan man inte använda en vanlig relationsdatabas för att lagra tidsserier?
För att tidsserier vanligtvis innehåller en stor mängd information som är svår att lagra och bearbeta i vanliga databaser. Därför har det uppstått specialiserade databaser för tidsserier. Dessa databaser lagrar effektivt punkter (timestamp, value) med en given nyckel. De erbjuder ett API för att läsa de sparade uppgifterna efter nyckel, efter ett par nyckel-värde, flera sådana par eller efter regexp. Till exempel, om du vill hitta CPU-belastningen för alla dina tjänster i datacentret i Amerika, så behövs en sådan pseudofråga.
Vanligtvis har databaser för tidsserier specialiserade frågespråk, eftersom SQL inte passar särskilt bra för tidsserier. Även om det finns databaser som stödjer SQL så passar det inte särskilt bra. Mer lämpliga frågespråk är , , , . Jag hoppas att någon har hört talas om minst ett av dessa språk. Om PromQL har nog många hört talas om.
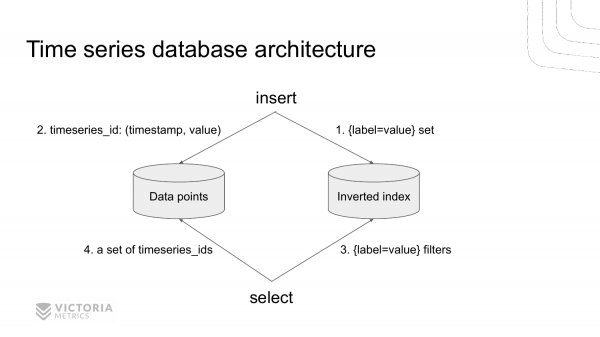
Så här ser arkitekturen för en modern databas för tidsserier ut, med VictoriaMetrics som exempel.
Den består av två delar. Det är ett lagringsutrymme för den inverterade indexen och ett lagringsutrymme för värdena i tidsserier. Dessa lagringsutrymmen är separerade.
När en ny post kommer in i databasen, börjar vi med att konsultera den inverterade indexen för att hitta identifieraren för tidsserien baserat på ett givet set label=value för denna metrik. Vi hittar denna identifierare och sparar värdet i data lagret.
När en fråga om att hämta data från TSDB kommer in, går vi först till den inverterade indexen. Vi hämtar alla timeseries_ids poster som motsvarar det angivna uppsättningen. label=valueOch sedan hämtar vi all nödvändig data från data lagret, indexerat efter timeseries_ids.
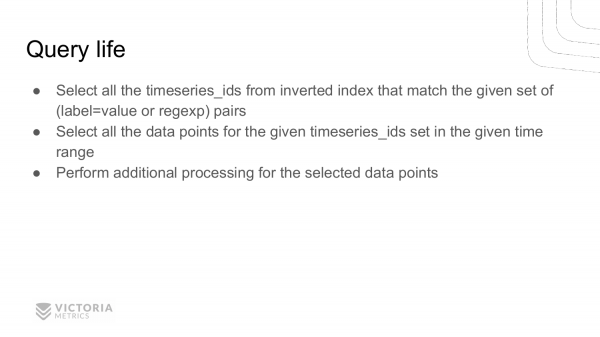
Låt oss titta på ett exempel på hur en databas för tidsserier behandlar en inkommande select-fråga.
- Först hämtar den alla
timeseries_idsfrån den inverterade indexen som innehåller de angivna parenlabel=value, eller som uppfyller det angivna reguljära uttrycket. - Sedan hämtar den alla data points från lagringsutrymmet för den angivna tidsperioden för de hittade
timeseries_ids. - Efter detta utför databasen vissa beräkningar på dessa datapunkter enligt användarens begäran. Och efter det returnerar den ett svar.
I denna presentation kommer jag att berätta om den första delen. Det handlar om sökning timeseries_ids i det inverterade indexet. Den andra och tredje delen kan ni se senare , eller vänta tills jag förbereder fler föredrag 🙂
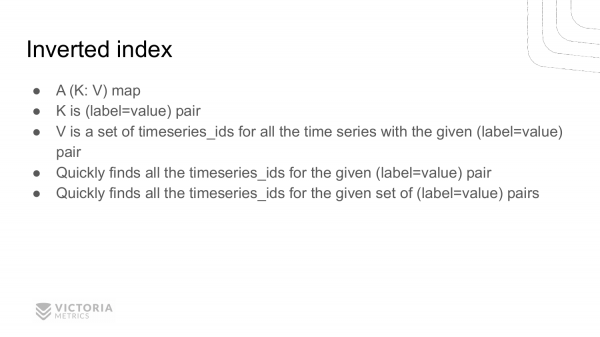
Låt oss gå vidare till det inverterade indexet. Många kan tycka att detta är enkelt. Vem vet vad ett inverterat index är och hur det fungerar? Åh, det är inte så många längre. Låt oss försöka förstå vad det handlar om.
I själva verket är allt enkelt. Det är bara en ordbok som mappar nyckeln till värdet. Vad är en nyckel? Det är paret label=value, där label och value — det är strängar. Och värdena är en uppsättning timeseries_ids, som inkluderar det angivna paret label=value.
Det inverterade indexet möjliggör snabb sökning av alla timeseries_ids, som har de angivna label=value.
Och det möjliggör också snabb sökning av timeseries_ids tidsserier för flera par label=value, eller för paren label=regexp. Hur fungerar det? Genom att hitta snittet av mängden timeseries_ids för varje par label=value.
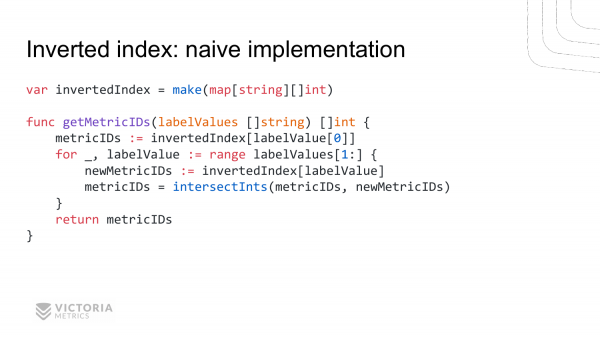
Låt oss titta på olika implementeringar av det inverterade indexet. Vi börjar med den enklaste naiva implementeringen. Den ser ut så här.
Funktionen getMetricIDs hämtar en lista med strängar. Varje sträng innehåller label=value. Denna funktion returnerar en lista metricIDs.
Hur fungerar det? Här har vi en global variabel som heter invertedIndex. Det är en vanlig ordbok (map), som mappar strängen till en slice av heltal. Strängen innehåller label=value.
Implementeringen av funktionen: vi får tag på metricIDs för den första label=value, sedan går vi igenom alla andra label=value, tar tag på metricIDs för dem. Och vi kallar funktionen intersectInts, som kommer att diskuteras senare. Och denna funktion returnerar snittet av dessa listor.
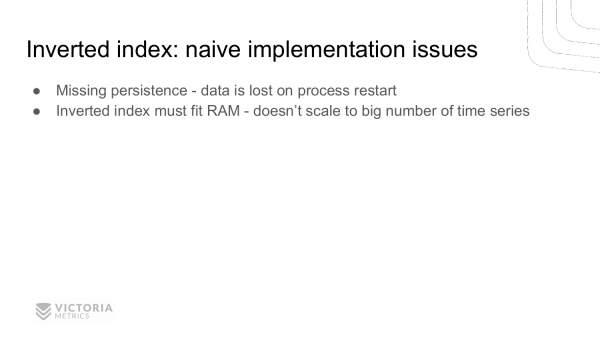
Som ni ser är implementeringen av det inverterade indexet inte särskilt komplicerad. Men det är en naiv implementation. Vilka nackdelar har den? Huvud nackdelen med den naiva implementeringen är att detta inverterade index lagras i arbetsminnet. Efter omstart av applikationen förlorar vi detta index. Det finns ingen lagring av detta index på disken. För en databas är det inverterade indexet svårt att använda.
Den andra nackdelen handlar också om minne. Den inverterade indexen måste placeras i RAM. Om den överstiger storleken på RAM, får vi uppenbarligen – out of memory error. Och programmet kommer inte att fungera.
Detta problem kan lösas med hjälp av färdiga lösningar som , eller .
Kort sagt behöver vi en databas som snabbt kan utföra tre operationer.
- Den första operationen är att skriva
nyckel-värdetill denna databas. Detta görs väldigt snabbt, därnyckel-värdeär godtyckliga strängar. - Den andra operationen är en snabb sökning av värdet för en given nyckel.
- Och den tredje operationen är en snabb sökning av alla värden efter ett givet prefix.
LevelDB och RocksDB – dessa databaser har utvecklats av Google och Facebook. Först kom LevelDB. Sedan tog Facebook-teamet LevelDB och började förbättra den och skapade RocksDB. Nu använder nästan alla interna databaser på Facebook RocksDB, dessutom har de även migrerat MySQL till RocksDB. De kallade det .
Den inverterade indexen kan implementeras med hjälp av LevelDB. Hur gör vi detta? Vi sparar som nyckel label=value. Och som värde – identifieraren för tidsserien där paret finns label=value.
Om vi har många tidsserier med detta par label=value, kommer det att finnas många rader i denna databas med samma nyckel men olika timeseries_ids. För att få en lista över alla timeseries_ids, som börjar med detta label=prefix, gör vi en range scan, för vilket denna databas är optimerad. Det vill säga, vi väljer alla rader som börjar med label=prefix och får de nödvändiga timeseries_ids.
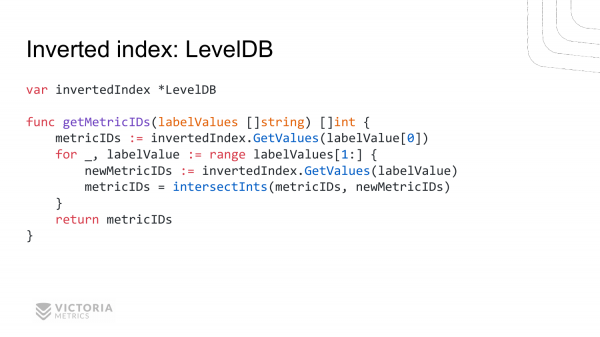
Här är en ungefärlig implementation hur den skulle se ut i Go. Vi har en inverterad index. Det är LevelDB.
Funktionen är densamma som för den naiva implementationen. Den upprepar nästan rad för rad den naiva implementationen. Den enda skillnaden är att istället för att referera till map refererar vi till den inverterade indexen. Vi hämtar alla värden för den första label=value. Sedan går vi igenom alla kvarstående par label=value och hämtar motsvarande uppsättningar av metricIDs för dem. Därefter hittar vi snittet.
Det verkar bra, men det finns nackdelar med denna lösning. VictoriaMetrics implementerade först den inverterade indexen baserad på LevelDB. Men till slut var de tvungna att överge den.
Varför? Eftersom LevelDB är långsammare än den naiva implementationen. I den naiva implementationen får vi direkt hela skivmått för en given nyckel. metricIDs. Denna mycket snabba operation - hela slice är redo att användas.
I LevelDB måste man vid varje anrop av funktionen GetValues gå igenom alla rader som börjar med label=value. Och för varje rad hämta värdet timeseries_ids. Av sådana timeseries_ids samla slice av dessa timeseries_ids. Det är uppenbart att detta är mycket långsammare än att helt enkelt komma åt en vanlig map genom nyckel.
Den andra nackdelen är att LevelDB är skrivet i C. Anrop till C-funktioner från Go är inte särskilt snabbt. Det tar hundratals nanosekunder. Det är inte så snabbt, eftersom jämfört med ett vanligt funktionsanrop, skrivet i Go, som tar 1-5 nanosekunder, blir prestandaskillnaden tiotals gånger. För VictoriaMetrics var detta en dödlig nackdel 🙂
Därför har jag skrivit en egen implementation av det inverterade indexet. Jag kallade den .
Mergeset är baserat på datakonstruktionen MergeTree. Denna datakonstruktion är lånad från ClickHouse. Uppenbarligen bör mergeset optimeras för snabb sökning timeseries_ids efter en given nyckel. Mergeset är helt skrivet i Go. Du kan titta på . Implementeringen av mergeset ligger i mappen . Du kan försöka ta reda på vad som händer där.
API:et för mergeset liknar mycket LevelDB och RocksDB. Det vill säga, det tillåter att snabbt spara nya postningar och snabbt hämta postningar efter en given prefix.
Vi kommer att prata om nackdelarna med mergeset senare. Just nu ska vi diskutera vilka problem som uppstod med VictoriaMetrics i produktion vid implementeringen av det inverterade indexet.
Varför uppstod de?
Den första anledningen är den höga churn rate. På svenska betyder detta - ofta byte av tidsserier. Detta inträffar när en tidsserie slutar och en ny börjar, eller många nya tidsserier börjar. Och detta händer ofta.
Den andra anledningen är det stora antalet tidsserier. I början, när övervakningen blev populär, var antalet tidsserier litet. Till exempel, för varje dator måste CPU, minne, nätverk och disk övervakas. 4 tidsserier per dator. Om du har, säg, 100 datorer och 400 tidsserier. Det är mycket lite.
Med tiden har människor kommit på att man kan mäta mer detaljerad information. Till exempel, att mäta belastningen inte för hela processorn, utan separat för varje processor kärna. Om du har 40 processor kärnor, får du därmed 40 gånger fler tidsserier för att mäta processorbelastningen.
Men det är inte allt. Varje processor kärna kan ha flera tillstånd som idle, när den är inaktiv. Dessutom finns det arbete i user space, arbete i kernel space och andra tillstånd. Och varje sådant tillstånd kan också mätas som en separat tidsserie. Detta ökar antalet serier ytterligare 7-8 gånger.
Från en enda metrik har vi fått 40 x 8 = 320 metrikker bara för en dator. Multiplicerat med 100 ger det oss 32 000 istället för 400.
Sedan kom Kubernetes. Och det förvärrade saken ytterligare, eftersom många olika tjänster kan hostas i Kubernetes. Varje tjänst i Kubernetes består av många pods. Allt detta måste övervakas. Dessutom har vi ständiga deployment av nya versioner av dina tjänster. För varje ny version måste nya tidsserier skapas. Slutresultatet är att antalet tidsserier växer exponentiellt och vi står inför problemet med ett stort antal tidsserier, som kallas high-cardinality. VictoriaMetrics hanterar detta framgångsrikt jämfört med andra tidsserie-databaser.
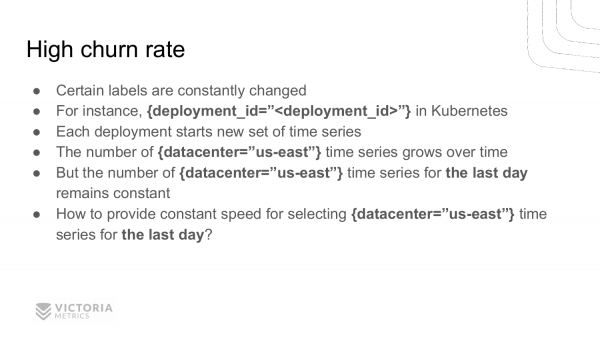
Låt oss titta närmare på high churn rate. Vad orsakar high churn rate i produktion? Eftersom vissa värden på etiketter och taggar ständigt förändras.
Till exempel, låt oss ta Kubernetes, där begreppet deployment, dvs. när en ny version av din applikation rullas ut. Utvecklarna av Kubernetes har av någon anledning valt att lägga till deployment-id i etiketten.
Vad ledde detta till? Att vid varje ny deployment bryts alla gamla tidsserier, och istället börjar nya tidsserier med det nya etikettvärdet deployment_id. Sådana serier kan vara hundratusentals eller till och med miljoner.
En viktig aspekt av allt detta är att det totala antalet tidsserier växer, men antalet tidsserier som för närvarande är aktiva, som får data, förblir konstant. Detta tillstånd kallas high churn rate.
Huvudproblemet med hög churn rate är att säkerställa en konstant sökhastighet för alla tidsserier över en given uppsättning etiketter under en viss tidsperiod. Vanligtvis handlar det om tidsperioden den senaste timmen eller den senaste dagen.
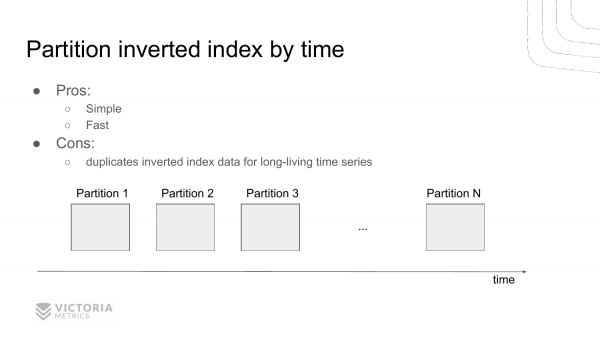
Hur kan vi lösa detta problem? Här är den första lösningen. Vi delar den inverterade indexen i oberoende delar baserat på tid. Det vill säga, när en tidsperiod har passerat, avslutar vi arbetet med den nuvarande inverterade indexen. Och vi skapar en ny inverterad index. När ytterligare en tidsperiod passerar, skapar vi en till och en till.
Och vid urvalet från dessa inverterade index hittar vi en uppsättning inverterade index som faller inom den angivna tidsperioden. Och, i enlighet därmed, väljer vi id:n för tidsserierna därifrån.
Detta sparar resurser eftersom vi inte behöver granska delar som inte faller inom den angivna tidsperioden. Det vill säga, om vi vanligtvis väljer data från den senaste timmen, så hoppar vi över förfrågningar från tidigare tidsperioder.
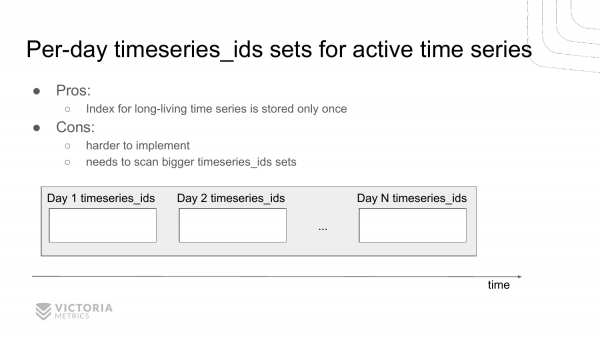
Det finns ytterligare en lösning på detta problem. Det är att för varje dag lagra en separat lista med id:n för tidsserier som förekommit den dagen.
Fördelen med denna lösning jämfört med den tidigare lösningen är att vi inte duplicerar information om tidsserier som inte försvinner över tid. De är konstant närvarande och förändras inte.
Nackdelen är att en sådan lösning är mer komplicerad att implementera och svårare att debugga. Och VictoriaMetrics har valt denna lösning. Det har historiskt sett blivit så. Denna lösning visar sig också fungera ganska bra, jämfört med den tidigare. Eftersom denna lösning inte implementerades på grund av att det kräver att vi duplicerar data i varje partition för tidsserier som inte förändras, det vill säga de som inte försvinner över tid. VictoriaMetrics har i första hand optimerats för diskutrymmesanvändning, och den tidigare implementationen försämrade diskutrymmesanvändningen. Men denna implementation passar bättre för att minimera diskutrymmesanvändningen, vilket är varför den valdes.
Vi fick kämpa emot den. Kampen bestod i att i denna implementation måste vi fortfarande välja ett betydligt större antal timeseries_ids för data än när den inverterade indexen är delad efter tid.
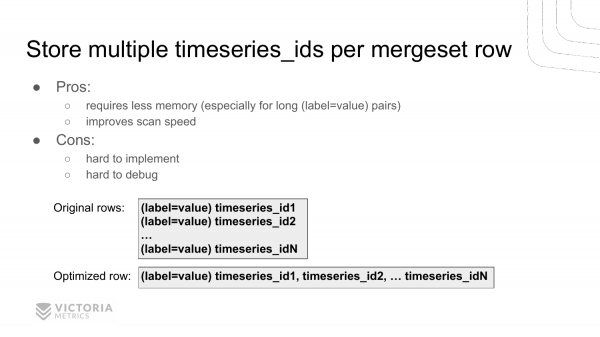
Hur löste vi detta problem? Vi löste det på ett unikt sätt – genom att spara flera identifierare för tidsserier i varje post i den inverterade indexen istället för en enda identifierare. Det vill säga, vi har en nyckel label=value, som förekommer i varje tidsserie. Och nu sparar vi flera timeseries_ids i en post.
Här är ett exempel. Tidigare hade vi N poster, nu har vi en post vars prefix är detsamma som alla andra. Den tidigare posten innehöll alla id:n för tidsserier.
Detta har ökat hastigheten för att skanna en sådan inverterad index med upp till 10 gånger. Och det har minskat minnesförbrukningen för cachen, eftersom vi nu sparar strängen label=value bara en gång i cachen istället för N gånger. Och denna sträng kan vara stor, om du har långa strängar i taggar och etiketter som Kubernetes gärna skjuter in där.
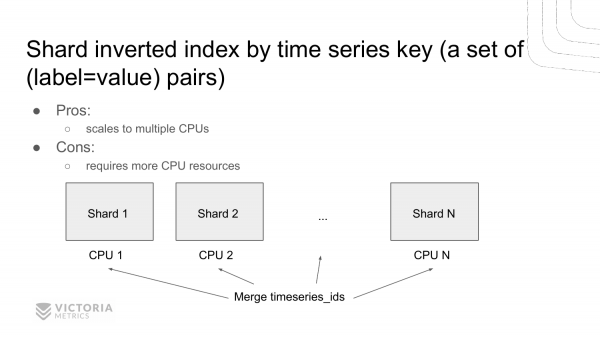
Ett annat alternativ för att snabba upp sökningarna i den inverterade indexen är sharding. Att skapa flera inverterade index istället för ett och shardera data mellan dem efter nyckel. Det är ett set av key=value par. Det vill säga, vi får flera oberoende inverterade index som vi kan fråga parallellt på flera processorer. Tidigare implementationer tillät endast att arbeta i en enskild processor, det vill säga att skanna data endast på ett kärna. Denna lösning möjliggör att skanna data på flera kärnor samtidigt, vilket ClickHouse gärna gör. Det är vad vi planerar att implementera.
Och nu tillbaka till våra får – till funktionen för intersection timeseries_ids. Låt oss överväga vilka implementationer som kan finnas. Denna funktion gör det möjligt att hitta timeseries_ids för ett givet set label=value.
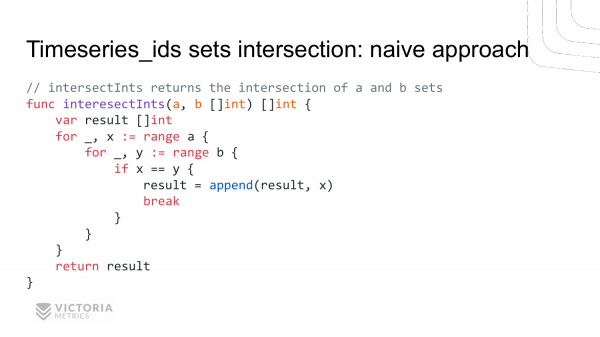
Det första alternativet – det är den naïva implementationen. Två nästlade loopar. Här får vi två slices som indata till funktionen intersectInts – a och b. Utgången ska ge oss intersection av dessa slices.
Den naïva implementationen ser ut så här. Vi går igenom alla värden från slice a, inom denna loop går vi igenom alla värden från slice b. Och vi jämför dem. Om de matchar, betyder det att vi har hittat intersection. Och vi sparar det i result.
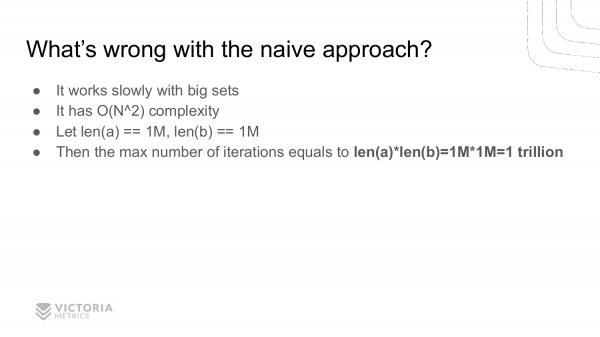
Vilka nackdelar finns det? Den kvadratiska komplexiteten – detta är dess främsta nackdel. Till exempel, om du har storlekar på slice a och b Om du har en miljon, kommer den här funktionen aldrig att ge dig ett svar. Eftersom den måste göra en biljon iterationer, vilket är mycket även för moderna datorer.
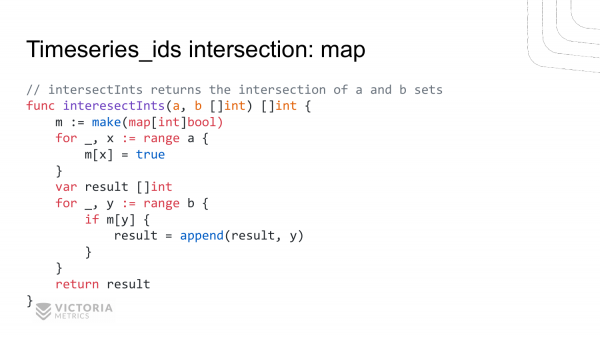
Den andra implementationen baseras på map. Vi skapar en map. Vi lägger alla värden från slice i denna map. aSedan går vi igenom slice med en separat loop. bOch vi kontrollerar – finns det detta värde från slice b i mappen. Om det finns, lägger vi till det i resultatet.
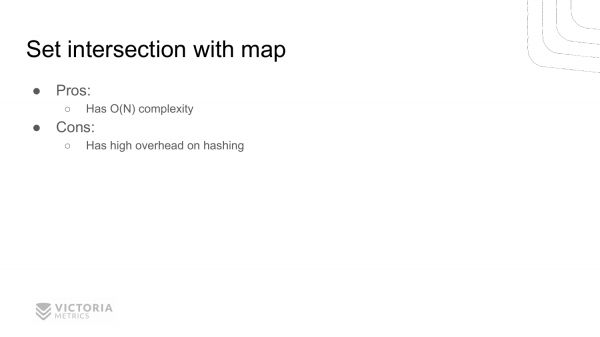
Vilka fördelar finns det? Fördelen är att här är det endast linjär komplexitet. Det vill säga, funktionen kommer att utföras mycket snabbare för stora storlekar av slices. För en slice av storlek en miljon kommer denna funktion att utföras på 2 miljoner iterationer, till skillnad från en biljon iterationer som i den tidigare funktionen.
Nackdelen är att denna funktion kräver mer minne för att skapa denna map.
Den andra nackdelen är den stora overheaden för hashing. Denna nackdel är inte särskilt uppenbar. Och för oss var den inte heller särskilt uppenbar, därför var den initiala implementationen av intersection i VictoriaMetrics genom map. Men sedan visade profileringsresultaten att den största processor tiden gick åt till att skriva till mappen och kontrollera om det finns ett värde i denna map.
Varför går processor tiden åt på dessa ställen? För att i dessa rader utför Go en hash operation. Det vill säga att den beräknar hash av nyckeln för att sedan kunna komma åt det angivna indexet i HashMap. Hashberäkningen utförs på tiotals nanosekunder. Det är långsamt för VictoriaMetrics.
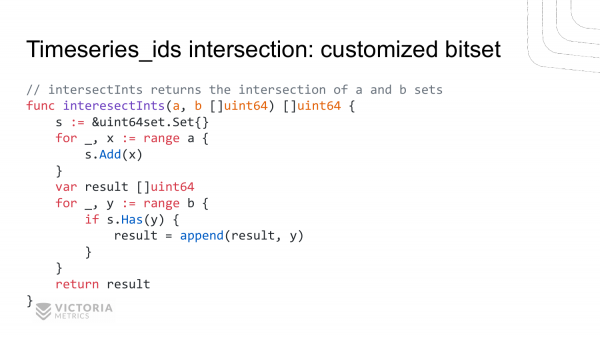
Jag beslutade att implementera en bitset, särskilt optimerad för detta fall. Så här ser nu intersection av två slices ut. Här skapar vi en bitset. Vi lägger till elementen från den första slice. Sedan kontrollerar vi närvaron av dessa element i den andra slice. Och vi lägger till dem i resultatet. Det vill säga, det skiljer sig knappt från det tidigare exemplet. Det enda som vi har bytt här är att vi har ersatt anropet till mappen med specialfunktioner. add och has.
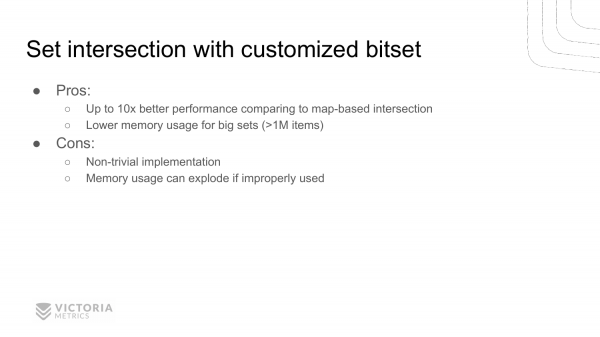
Vid första anblicken verkar det som om detta borde fungera långsammare, om standardmappen användes tidigare och här anropas det ytterligare funktioner, men profileringsresultaten visar att denna sak fungerar 10 gånger snabbare än standardmappen för fallet med VictoriaMetrics.
Dessutom använder den mycket mindre minne jämfört med implementationen med map. För vi lagrar bitar här istället för åttabyte värden.
En nackdel med denna implementation är att den inte är så uppenbar, inte trivial.
En annan nackdel som många kanske inte märker – är att denna implementation kan fungera dåligt i vissa fall. Det vill säga, den är optimerad för ett specifikt fall, för detta fall av överlappande ids av tidsserier i VictoriaMetrics. Det betyder inte att den passar alla situationer. Om den används felaktigt, kan vi få inte bara sämre prestanda utan också minnesfel och en minskning av prestanda.
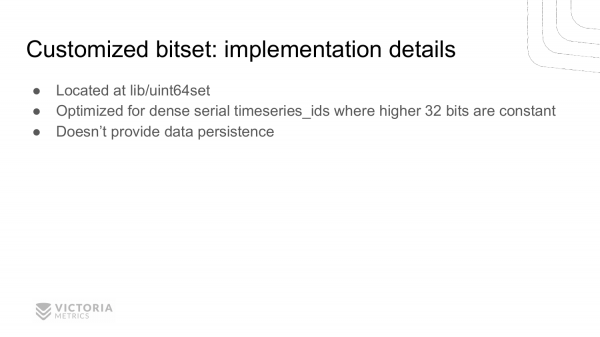
Låt oss titta på implementationen av denna struktur. Om du vill se den, så finns den i källkoden till VictoriaMetrics, i mappen . Den är optimerad just för fallet VictoriaMetrics, där timeseries_id är ett 64-bitarsvärde, där de första 32 bitarna är konstant och endast de sista 32 bitarna ändras.
Denna datastruktur lagras inte på disken, den fungerar endast i minnet.
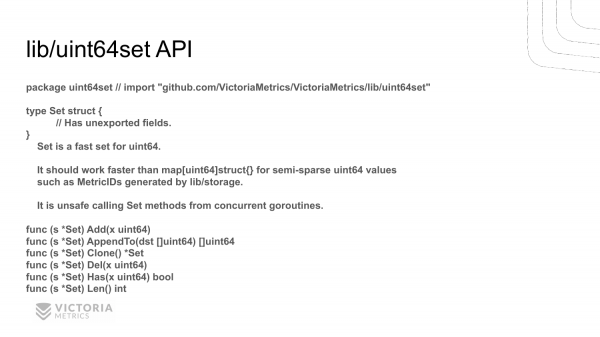
Här är dess API. Det är inte särskilt komplicerat. API:t är anpassat exakt för det specifika exempel som används av VictoriaMetrics. Det vill säga, det finns inga onödiga funktioner här. Här finns funktioner som VictoriaMetrics tydligt använder.
Det finns funktioner add, som lägger till nya värden. Det finns en funktion has, som kontrollerar nya värden. Och det finns en funktion del, som tar bort värden. Det finns också en hjälpfunktion len, som returnerar storleken på mängden. Funktionen clone klonar mängden. Och funktionen appendto omvandlar denna set till en slice timeseries_ids.
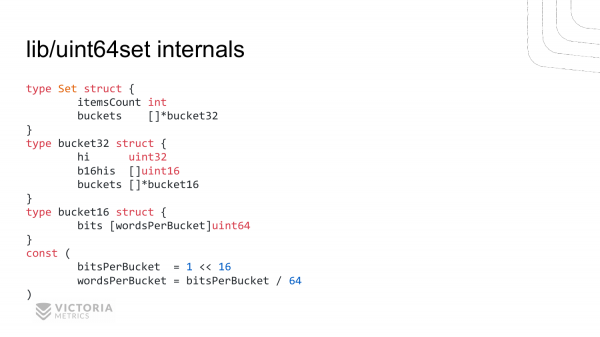
Så här ser implementationen av denna datastruktur ut. I set finns det två element:
ItemsCount– detta är ett hjälpfält, för att snabbt returnera antalet element i set. Man skulle kunna klara sig utan det här hjälpfältet, men det lades till här eftersom VictoriaMetrics ofta frågar om längden på bitset i sina algoritmer.Det andra fältet är
buckets. Detta är en slice av strukturenbucket32. I varje struktur lagrashifält. Detta är de översta 32 bitarna. Och två slices —b16hisochbucketsfrånbucket16strukturer.
Här lagras de översta 16 bitarna av den andra delen av den 64-bitars strukturen. Och här lagras bitsets för de lägre 16 bitarna av varje byte.
Bucket64 består av en array uint64. Längden beräknas med hjälp av dessa konstanter. I en bucket16 kan maximalt lagras 2^16=65536 bitar. Om vi delar detta med 8, får vi 8 kilobyte. Om vi delar en gång till med 8, så är det 1000 uint64 värden. Det vill säga, Bucket16 – är en 8-kilobyte struktur.
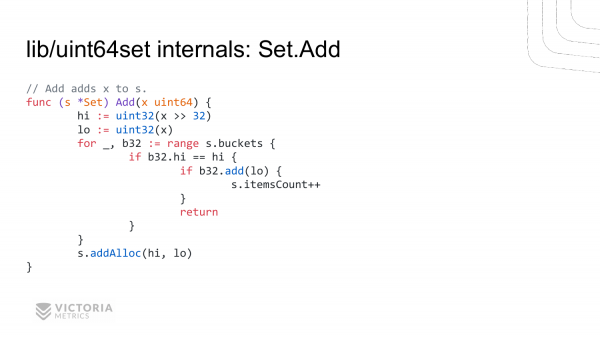
Låt oss titta på hur en av metoderna för denna struktur för att lägga till ett nytt värde är implementerad.
Allt börjar med uint64 värdet. Vi beräknar de övre 32 bitarna, beräknar de nedre 32 bitarna. Vi går igenom alla buckets. Vi jämför de övre 32 bitarna i varje bucket med det tillagda värdet. Och om de matchar, anropar vi funktionen add i strukturen b32 buckets. Och lägger till de nedre 32 bitarna där. Om detta returnerade true, betyder det att vi har lagt till ett sådant värde där och att vi inte hade ett sådant värde tidigare. Om det returnerar false, så fanns ett sådant värde redan. Sedan ökar vi antalet element i strukturen.
Om vi inte hittade den nödvändiga bucket med det nödvändiga hi-värdet, då anropar vi funktionen addAlloc, som tilldelar en ny bucket, genom att lägga till den i bucket-strukturen.
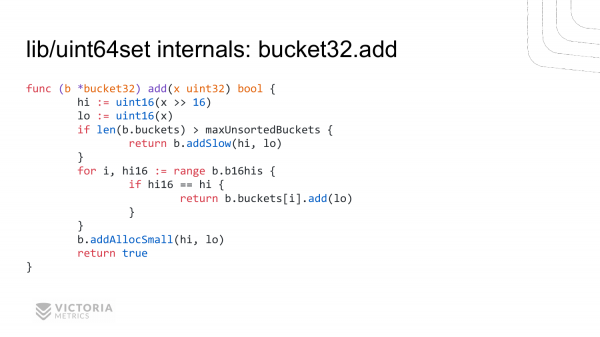
Detta är implementeringen av funktionen b32.add. Den liknar den tidigare implementationen. Vi beräknar de översta 16 bitarna, de nedersta 16 bitarna.
Sedan går vi igenom alla övre 16 bitar. Vi hittar matchningar. Och vid en match anropar vi metoden add, som vi kommer att gå igenom på nästa sida för bucket16.
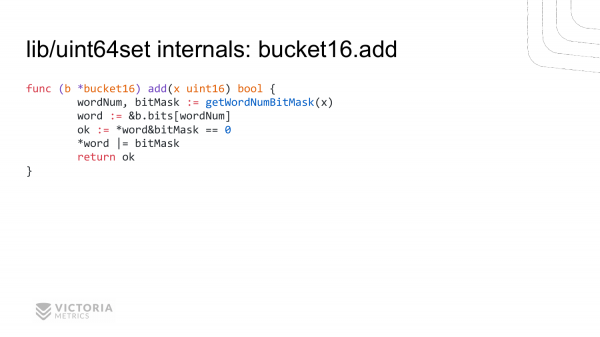
Och här är den nedersta nivån, som måste vara så optimal som möjligt. Vi beräknar för uint64 id-värdet i slice bit, samt bitmask. Detta är en mask för detta 64-bitars värde, genom vilken vi kan kontrollera om denna bit finns, eller sätta den. Vi kontrollerar om denna bit är inställd och sätter den, och returnerar dess tillstånd. Så här har vi en implementation som har gjort det möjligt att påskynda operationen för att korsa ids för tidsserier med 10 gånger jämfört med vanliga maps.
I VictoriaMetrics finns det många andra optimeringar förutom denna. De flesta av dessa optimeringar har lagts till av en anledning, efter profilering av koden i produktion.
Detta är den grundläggande regeln för optimering – lägg inte till en optimering, antar att det kommer att vara en flaskhals här, för det kan visa sig att det inte finns någon flaskhals där. Optimering försämrar vanligtvis kodens kvalitet. Därför bör man optimera endast efter profilering och helst i produktion, så att det handlar om verkliga data. Om du är intresserad kan du titta på källkoden för VictoriaMetrics och studera andra optimeringar som finns där.
Jag har en fråga om bitset. Mycket liknar implementeringen av C++ vector, optimerad bitset. Tog ni implementeringen därifrån?
Nej, det är inte därifrån. Vid implementeringen av detta bitset utgick jag från kunskapen om strukturen hos dessa ids tidsserier, som används i VictoriaMetrics. Deras struktur är sådan att de övre 32 bitarna vanligtvis är konstanta. De undre 32 bitarna kan förändras. Ju lägre bit, desto oftare kan den förändras. Därför är denna implementering specifikt optimerad för denna databasstruktur. C++-implementeringen, så vitt jag vet, är optimerad för allmänna fall. Att göra en optimering för allmänna fall innebär att den inte kommer att vara den mest optimala för det specifika fallet.
Jag rekommenderar att du också kollar på föredraget av Alexej Milovid. Han pratade för ungefär en månad sedan om optimeringar i ClickHouse för specifika specialiseringar. Han nämner just att i allmänhet är C++-implementeringen eller någon annan implementation anpassad för att fungera bra i genomsnitt. Den kan fungera sämre än en specialiserad implementering för specifik kunskap, såsom vår, när vi vet att de övre 32 bitarna huvudsakligen är konstanta.
Jag har en andra fråga. Vad är den grundläggande skillnaden från InfluxDB?
Det finns många grundläggande skillnader. När det gäller prestanda och minnesanvändning visar InfluxDB i tester 10 gånger högre minnesanvändning för hög kardinalitet tidsserier, när ni har många av dem, till exempel miljoner. Till exempel använder VictoriaMetrics 1 GB för en miljon aktiva serier, medan InfluxDB samtidigt använder 10 GB. Och det är en stor skillnad.
Den andra grundläggande skillnaden är att InfluxDB har konstiga frågespråk – Flux och InfluxQL. De är inte så bekväma för att arbeta med tidsserier i jämförelse med , som stöds i VictoriaMetrics. PromQL är frågespråket från Prometheus.
En annan skillnad är att InfluxDB har en lite märklig datamodell, där varje rad kan innehålla flera fält med olika uppsättningar av taggar. Dessa rader delas också in i olika tabeller. Dessa ytterligare komplikationer försvårar det fortsatta arbetet med databasen. Det är svårt att underhålla och förstå.
I VictoriaMetrics är allt mycket enklare. Där representerar varje tidsserie ett nyckel-värde-par. Värdet är en uppsättning punkter – (timestamp, value), och nyckeln är en uppsättning label=valueDet finns ingen uppdelning i fields och measurements. Detta gör att du kan välja vilken data som helst och sedan kombinera, addera, subtrahera, multiplicera och dividera, till skillnad från InfluxDB där beräkningar mellan olika rader fortfarande inte är implementerade, såvitt jag vet. Även om de skulle vara det, är det komplicerat och kräver massor av kod.
Jag har en uppföljande fråga. Förstod jag rätt att det fanns något problem som ni nämnde, att denna inverterade index inte får plats i minnet, och därför går partitioneringen till?
I början visade jag en naiv implementation av ett inverterat index på en standard Go-karta. En sådan implementation passar inte för databaser, eftersom detta inverterade index inte sparas på disken, och en databas måste spara på disken så att dessa data förblir tillgängliga vid omstart. I den här implementationen försvinner det inverterade indexet vid omstart av applikationen. Och du kommer att förlora tillgången till all data, eftersom du inte kommer att kunna hitta den.
Hej! Tack för presentationen! Jag heter Pavel. Jag kommer från företaget Wildberries. Jag har några frågor till dig. Första frågan. Vad tror du, om du hade valt en annan princip för att bygga arkitekturen av din applikation och partitionerat data efter tid, skulle du då kanske kunna göra datakorsningar vid sökning, baserat på att data i en partition ligger för en viss tidsperiod, dvs. för ett visst tidsintervall, och du skulle inte behöva bekymra dig om att du har bitar som är spridda på olika sätt? Fråga nummer 2 - eftersom ni implementerar en sådan algoritm med bitset och allt annat, har ni kanske provat att använda processorinstruktioner? Kanske har ni provat sådana optimeringar?
Jag svarar direkt på den andra. Vi har ännu inte kommit dit. Men om det behövs, gör vi det. Och den första, vad var frågan?
Ni diskuterade två scenarier. Och sa att ni valde den andra med en mer komplicerad implementation. Och ni föredrog inte den första där data är partitionerade efter tid.
Ja. I det första fallet skulle den totala mängden av indexet vara större, eftersom vi i varje partition skulle behöva lagra dubbletter av data för de tidsserier som sträcker sig över dessa alla partitioner. Och om er churn rate för tidsserierna är låg, dvs. om ständigt samma serier används, så skulle vi i det första fallet förlora mycket mer utrymme jämfört med det andra fallet.
Och ja, tidspartitionering är ett bra alternativ. Det används av Prometheus. Men Prometheus har en annan nackdel. Vid sammanslagning av dessa datadelar behöver den hålla metadata om alla labels och tidsserier i minnet. Därför, om de datadelar som den slår ihop är stora, ökar minnesanvändningen kraftigt under sammanslagningen, till skillnad från VictoriaMetrics. Vid sammanslagningen förbrukar VictoriaMetrics överhuvud taget inget minne, där används bara några kilobyte, oavsett storleken på de sammanfogade datadelarna.
Algoritmen som ni använder, den använder minne. I minnet markeras tidsseriemetrik där det finns värden. På så sätt kontrollerar ni om det finns parvis existens i en datamängd och i en annan. Och förstår – har en intersection skett eller inte. Vanligtvis implementeras det i databaser med hjälp av pekare, iteratorer som lagrar sitt nuvarande tillstånd och löper genom sorterad data vilket ger en enkel komplexitet för dessa operationer.
Varför använder vi inte pekare för att korsa data?
Ja.
I vår LevelDB eller i mergeset lagras just sorterade rader. Vi kan använda en pekare för att gå igenom och hitta korsningen. Men varför använder vi inte det? För att det är långsamt. För att pekare innebär att för varje rad måste en funktion anropas. Anrop av en funktion tar 5 nanosekunder. Och om ni har 100 000 000 rader, så tar det en halv sekund bara för funktionsanropet.
Sådana problem finns, ja. Och min sista fråga. Frågan kanske låter lite konstig. Varför kan vi inte beräkna alla nödvändiga aggregat vid datainmatning och spara dem i önskat format? Varför spara stora mängder i system som VictoriaMetrics, ClickHouse osv., för att sedan spendera så mycket tid på dem?
Låt mig ge ett exempel för att göra det tydligare. Anta att hur en liten leksakshastighetsmätare fungerar? Den registrerar avståndet du har kört, hela tiden adderande det till en figur, och i en annan – tiden. Och delar. Och får den genomsnittliga hastigheten. Man kan göra något liknande. Samla ihop alla nödvändiga fakta.
Okej, jag förstår frågan. Ditt exempel har sin plats. Om du vet vilka aggregationer du behöver, så är det den bästa implementeringen. Men problemet är att folk sparar dessa metrikor, vissa data i ClickHouse och de vet ännu inte hur de kommer att aggregera och filtrera dem i framtiden, så de måste spara alla rådata. Men om du vet att du behöver räkna något genomsnittligt, varför räknar du inte det istället för att spara en massa råa värden där? Men det är bara om du exakt vet vad du behöver.
Förresten, databaser för lagring av tidsserier stödjer beräkning av aggregationer. Till exempel, Prometheus stödjer . Det vill säga, detta kan göras om du vet vilka aggregationer du kommer att behöva. I VictoriaMetrics finns det inte än, men vanligtvis placeras Prometheus framför den, där detta kan göras i inspelningsreglerna.
Till exempel, på mitt tidigare jobb behövde vi räkna antal händelser i ett glidande fönster under den senaste timmen. Problemet är att jag var tvungen att göra en anpassad implementation i Go, det vill säga en tjänst för att räkna denna sak. Denna tjänst blev slutligen ganska komplex eftersom det är svårt att räkna. Implementeringen kan vara enkel om du behöver räkna några aggregationer vid fasta tidsintervall. Men om du vill räkna händelser i ett glidande fönster, är det inte så enkelt som det verkar. Jag tror att det fortfarande inte har implementerats i ClickHouse eller i tidsserie-databaser, eftersom det är svårt att implementera.
Och en sista fråga. Vi har just pratat om att räkna genomsnitt, och jag kom ihåg att det en gång fanns något som Graphite med backend Carbon. Den kunde tunna ut gamla data, det vill säga lämna en punkt per minut, en punkt per timme, osv. I princip är det ganska bekvämt om vi behöver rådata, så att säga, under en månad, och allt annat kan tunas ut. Men Prometheus, VictoriaMetrics stödjer inte denna funktionalitet. Planerar ni att stödja det? Om inte, varför?
Tack för din fråga. Våra användare ställer den ibland. De undrar när vi kommer att lägga till stöd för nedskärning (downsampling). Här finns det flera problem. För det första, vad varje användare menar med nedskärning är olika: någon vill få en godtycklig punkt inom ett angivet intervall, någon annan vill ha maximala, minimala, eller genomsnittliga värden. Om många system skriver data till din databas kan du inte bara behandla dem som om de vore samma. Det kan visa sig att varje system behöver använda olika nedskärningar. Och det är komplicerat att implementera.
För det andra, VictoriaMetrics, precis som ClickHouse, är optimerad för att arbeta med stora mängder rådata, så den kan bearbeta en miljard rader på mindre än en sekund om du har många kärnor i ditt system. Skanning av tidsserie-punkter i VictoriaMetrics – 50 000 000 punkter per sekund per kärna. Och denna prestanda skalas med tillgängliga kärnor. Om du har 20 kärnor, till exempel, så blir det en miljard punkter per sekund. Och denna egenskap hos VictoriaMetrics och ClickHouse minskar behovet av nedskärning.
En annan egenskap är att VictoriaMetrics effektivt komprimerar dessa data. Kompressionen ligger i genomsnitt på 0,4 till 0,8 byte per punkt i produktion. Varje punkt består av en tidsstämpel + ett värde. Och den komprimeras till mindre än en byte i genomsnitt.
Sergej. Jag har en fråga. Vad är den minimi tidskvant för registrering?
En millisekund. Nyligen hade vi ett samtal med andra utvecklare av tidsserie-databaser. Hos dem är den minimi tidskvanten en sekund. I Graphite, till exempel, är det också en sekund. I OpenTSDB är det också en sekund. I InfluxDB – nanosekundprecision. I VictoriaMetrics är det en millisekund, eftersom det i Prometheus är en millisekund. Och VictoriaMetrics utvecklades ursprungligen som fjärrlagring för Prometheus. Men nu kan den också spara data från andra system.
Människan jag pratade med säger att de har sekundprecision – det räcker för dem, eftersom det beror på vilken typ av data som lagras i tidsseriedatabasen. Om det är DevOps-data eller data från infrastruktur, där du samlar in dem med intervaller på 30 sekunder eller en minut, så räcker sekundprecision. Mindre behövs inte. Men om du samlar in dessa data från högfrekventa handelssystem, då behövs nanosekundprecision.
Millisekundnog noga i precision i VictoriaMetrics passar både för DevOps-fall och kan passa de flesta av de fall jag nämnde i början av presentationen. Det enda den kanske inte är lämplig för är högfrekventa handelssystem.
Tack! Och en fråga till. Vad är kompatibiliteten i PromQL?
Full bakåtkompatibilitet. VictoriaMetrics stödjer helt och hållet PromQL. Utöver detta lägger den till ytterligare utökad funktionalitet på PromQL, vilket kallas . Angående denna utökade funktionalitet finns det en presentation på YouTube. Jag pratade på Monitoring Meetup i våras i Petersburg.
Telegram-kanal .
Endast registrerade användare kan delta i omröstningen. , tack.
Vad hindrar dig från att byta till VictoriaMetrics som en långsiktig lagring för Prometheus? (Skriv i kommentarerna, jag lägger till det i enkäten))
71,4%Använder inte Prometheus5
28,6%Visste inte om VictoriaMetrics2
7 användare röstade. 12 användare avstod.
Källa: habr.com
