

Den här artikeln hjälper dig att förstå hur belastningsbalansering fungerar i Kubernetes, vad som händer vid skalning av långlivade anslutningar och varför man bör överväga klientbaserad balansering om du använder HTTP/2, gRPC, RSockets, AMQP eller andra långlivade protokoll.
Lite om hur trafiken omfördelas i Kubernetes
Kubernetes erbjuder två användbara abstraktioner för utrullning av applikationer: tjänster (Services) och distributioner (Deployments).
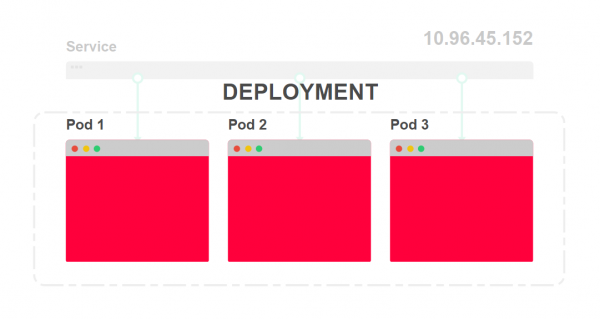
Distributioner beskriver hur många kopior av din applikation som ska vara igång vid varje given tidpunkt. Varje applikation distribueras som en pod (Pod) och tilldelas en IP-adress.
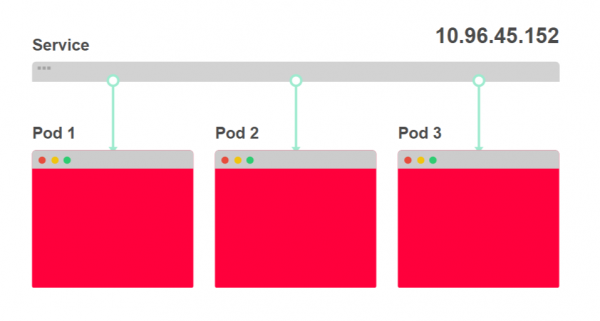
Tjänster fungerar som en belastningsbalanserare. De är utformade för att fördela trafiken över flera pods.
Låt oss se hur det ser ut.
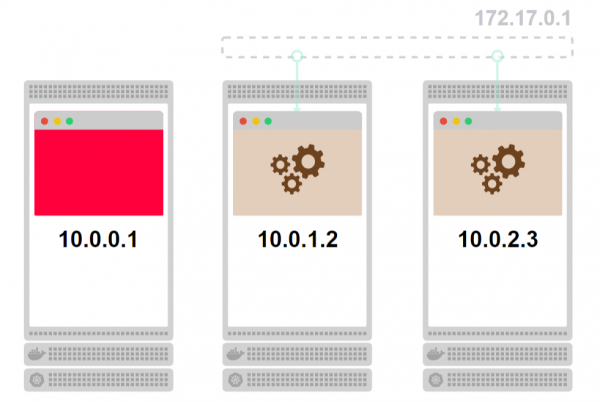
- I diagrammet nedan ser du tre instanser av en applikation och en belastningsbalanserare:

- Belastningsbalanseraren kallas tjänst (Service) och får en IP-adress. Varje inkommande begäran omdirigeras till en av pods:

- Distributionsscenariot definierar antalet instanser av applikationen. Du kommer nästan aldrig att behöva distribuera en pod direkt:

- Varje pod tilldelas sin egen IP-adress:

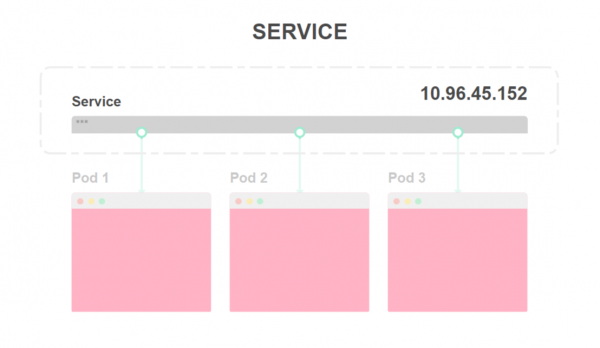
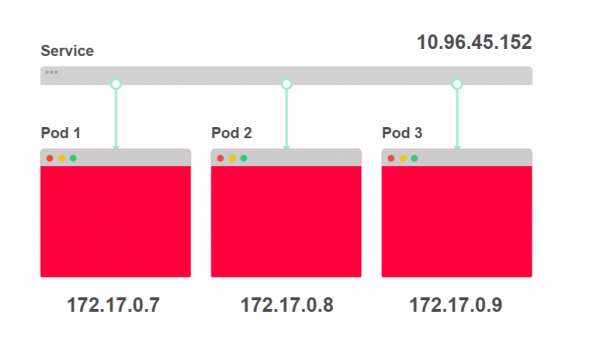
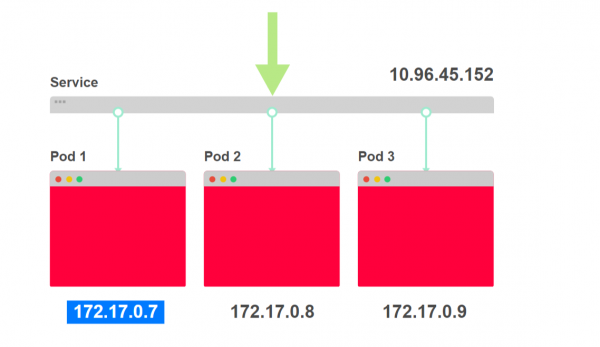
Det är användbart att betrakta tjänster som en uppsättning IP-adresser. Varje gång du anropar en tjänst väljs en av IP-adresserna från listan och används som destinationsadress.
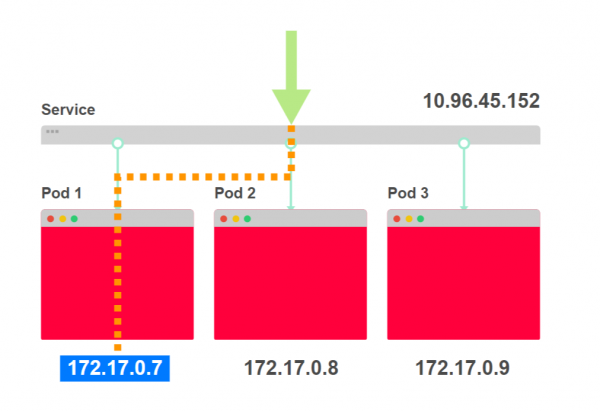
Det ser ut så här.
- En curl-begäran kommer till tjänsten 10.96.45.152:

- Tjänsten väljer en av de tre pod-adresserna som mål:

- Trafiken omdirigeras till en specifik pod:


Om din applikation består av en front-end och en back-end, så kommer du att ha både en tjänst och en distribution för varje.
När front-end gör en begäran till back-end behöver den inte veta hur många pods som betjänar back-end: det kan vara en, tio eller hundra.
Front-end vet inte heller något om adresserna till de pods som betjänar back-end.
När front-end gör en begäran till back-end använder den IP-adressen för back-end-tjänsten, som inte ändras.
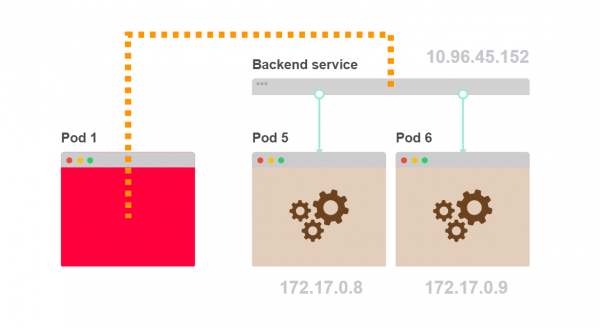
Så här ser det ut.
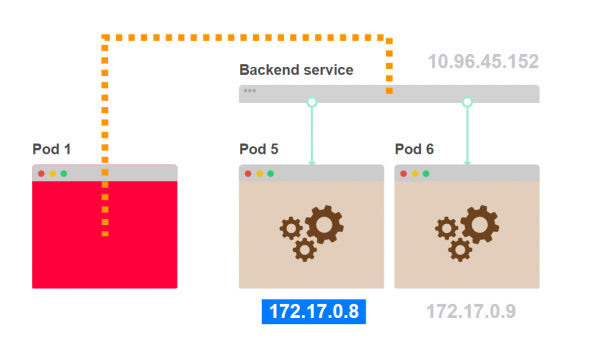
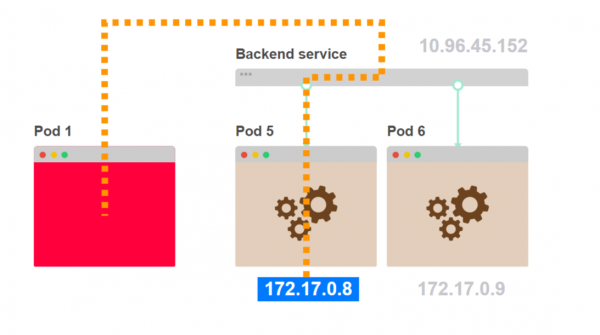
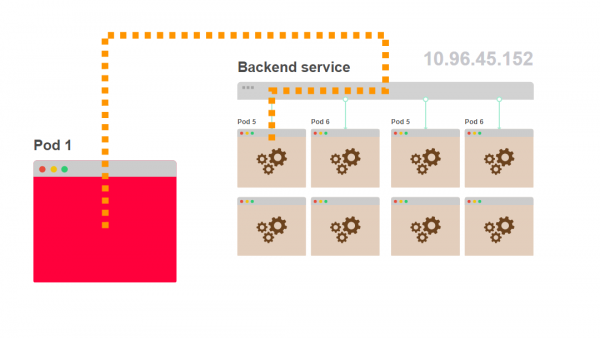
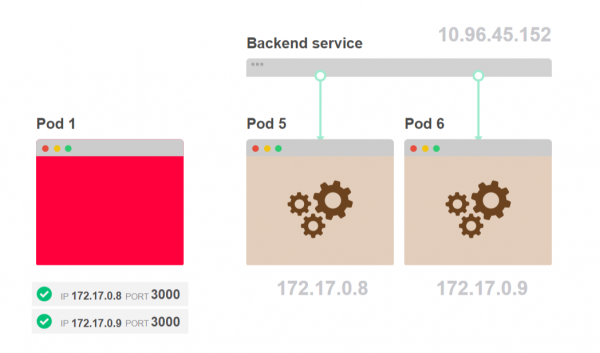
- Pod 1 begär en intern komponent från back-end. Istället för att välja en specifik back-end pod gör den en begäran till tjänsten:

- Tjänsten väljer en av backend-poddarna som destinationsadress:

- Trafiken går från pod 1 till pod 5, vald av tjänsten:

- Pod 1 vet inte hur många sådana poddar som pod 5 döljer bakom tjänsten:

Men hur fördelar tjänsten egentligen förfrågningarna? Används det en round-robin-balansering? Låt oss ta en titt.
Balansering i Kubernetes-tjänster
Kubernetes-tjänster existerar inte. Det finns ingen process för tjänsten som tilldelas en IP-adress och port.
Du kan bekräfta detta genom att logga in på vilken nod som helst i klustret och köra kommandot netstat -ntlp.
Du kommer inte ens att kunna hitta IP-adressen som tilldelats tjänsten.
IP-adressen för tjänsten placeras i kontrollplanet, i kontrollern, och registreras i databasen — etcd. Denna adress används också av en annan komponent — kube-proxy.
Kube-proxy får en lista över IP-adresser för alla tjänster och skapar en uppsättning iptables-regler på varje nod i klustret.
Dessa regler säger: "Om vi ser tjänstens IP-adress, bör vi modifiera destinationsadressen för förfrågan och skicka den till en av poddarna."
IP-adressen för tjänsten används endast som en ingångspunkt och hanteras inte av någon process som lyssnar på denna IP-adress och port.
Låt oss titta på detta.
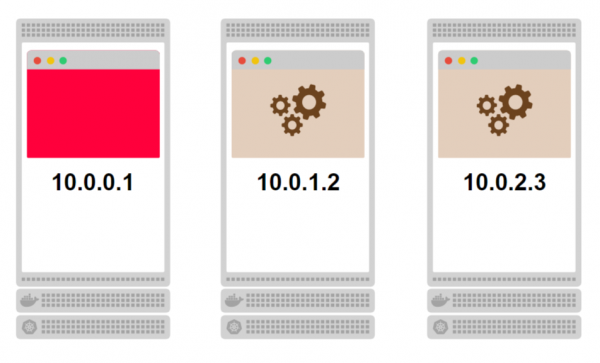
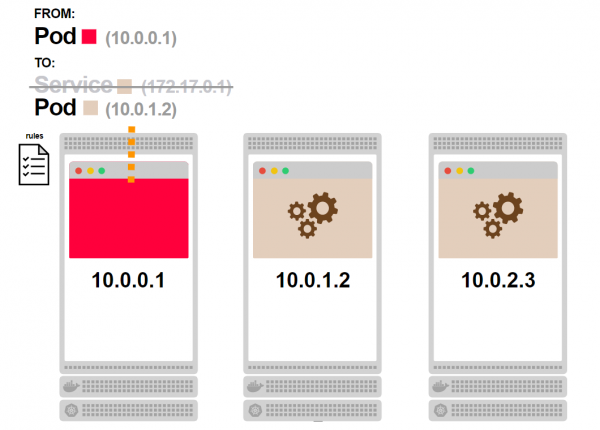
- Låt oss överväga ett kluster med tre noder. Varje nod har poddar:

- De relaterade poddarna, färgade i beige, är en del av tjänsten. Eftersom tjänsten inte existerar som en process visas den i grått:

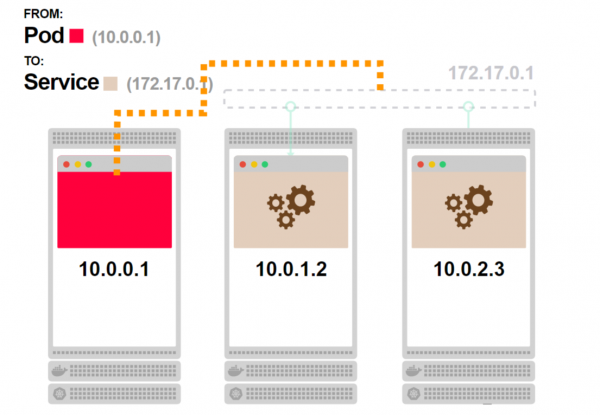
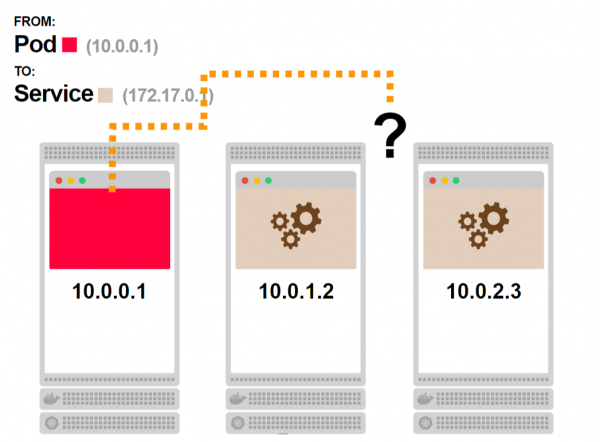
- Den första podden begär tjänsten och måste nå en av de relaterade poddarna:

- Men tjänsten existerar inte, det finns ingen process. Hur fungerar detta?

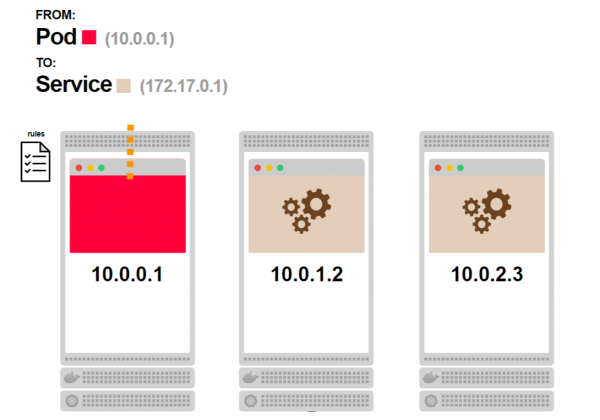
- Innan förfrågan lämnar noden passerar den genom iptables-reglerna:

- Iptables-reglerna vet att tjänsten inte existerar och ersätter dess IP-adress med en av IP-adresserna för poddarna kopplade till denna tjänst:

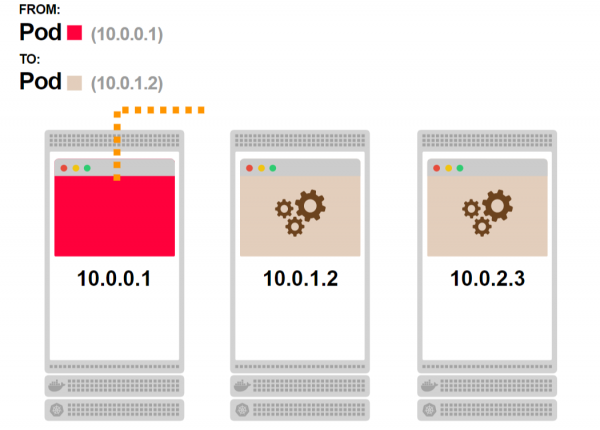
- Förfrågan får en giltig IP-adress som destinationsadress och behandlas normalt:
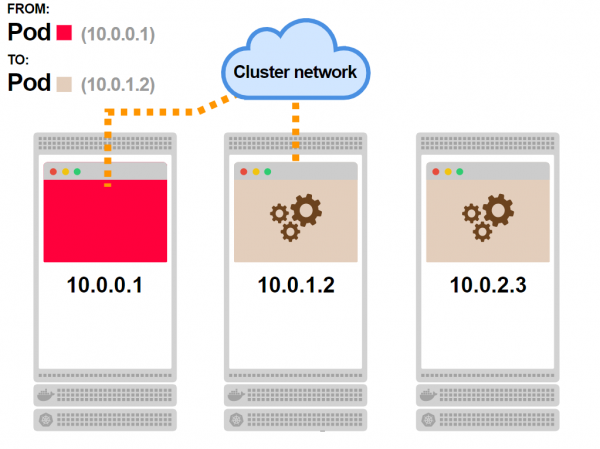
- Beroende på nätverkstopologin når förfrågan i slutändan podden:

Kan iptables balansera belastningen?
Nej, iptables används för filtrering och designades inte för balansering.
Det finns dock möjlighet att skriva en uppsättning regler som fungerar som .
Och det är precis vad som implementeras i Kubernetes.
Om du har tre poddar kommer kube-proxy att skriva följande regler:
- Välj den första podden med en sannolikhet på 33%, annars gå till nästa regel.
- Välj den andra podden med en sannolikhet på 50%, annars gå vidare till nästa regel.
- Välj den tredje podden.
Ett sådant system leder till att varje podd väljs med en sannolikhet på 33%.
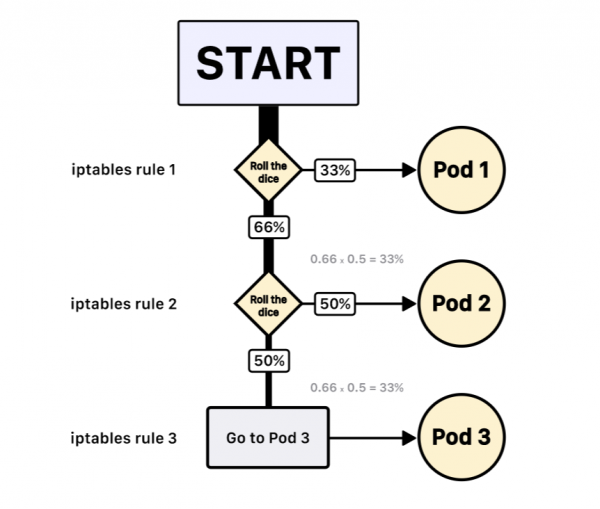
Och det finns ingen garanti för att podd 2 kommer att väljas nästa efter podd 1.
Anmärkning: iptables använder en statistisk modul med slumpmässig fördelning. Således baseras balansalgoritmen på slumpmässigt val.
Nu när du förstår hur tjänster fungerar, låt oss titta på mer intressanta scenarier.
Långlivade anslutningar i Kubernetes skalas inte automatiskt.
Varje HTTP-begäran från frontend till backend hanteras av en separat TCP-anslutning, som öppnas och stängs.
Om frontend skickar 100 begärningar per sekund till backend, öppnas och stängs 100 olika TCP-anslutningar.
Tiden för begäran kan minskas och belastningen kan sänkas genom att öppna en TCP-anslutning och använda den för alla efterföljande HTTP-begärningar.
I HTTP-protokollet finns en funktion som kallas HTTP keep-alive, eller återanvändning av anslutningen. I detta fall används en TCP-anslutning för att skicka och ta emot flera HTTP-begärningar och svar:
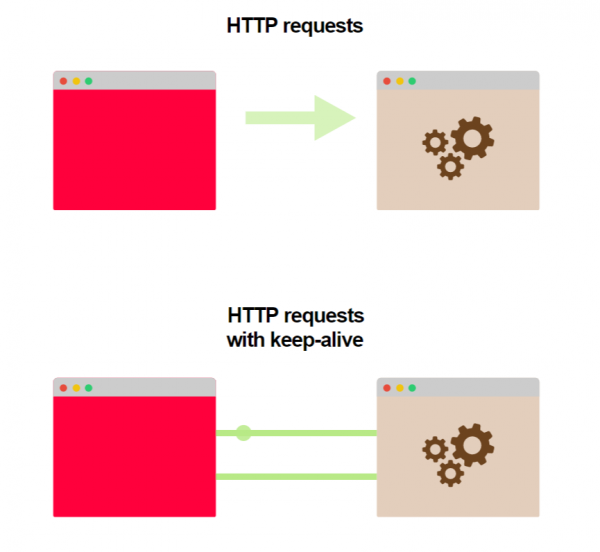
Denna funktion är inte aktiverad som standard: både servern och klienten måste konfigureras på rätt sätt.
Själva inställningen är enkel och tillgänglig för de flesta programmeringsspråk och miljöer.
Här är några länkar till exempel på olika språk:
Vad händer om vi använder keep-alive i en Kubernetes-tjänst?
Låt oss anta att både frontend och backend stöder keep-alive.
Vi har en kopia av frontend och tre instanser av backend. Frontend gör den första begäran och öppnar en TCP-anslutning till backend. Begäran når tjänsten, en av backendens poddar väljs som destinationsadress. Backendens pod skickar svaret, och frontend får det.
Till skillnad från en vanlig situation där TCP-anslutningen stängs efter att svaret mottagits, hålls den nu öppen för kommande HTTP-begärningar.
Vad händer om frontend skickar fler begärningar till backend?
För att vidarebefordra dessa begärningar kommer den öppna TCP-anslutningen att användas, alla begärningar kommer att nå samma backend-pod som den första begäran.
Ska inte iptables omdirigera trafiken?
Inte i det här fallet.
När en TCP-anslutning skapas passerar den genom iptables-reglerna, som väljer den specifika backend-poden dit trafiken kommer att gå.
Eftersom alla följande förfrågningar går genom en redan öppen TCP-anslutning, aktiveras iptables-reglerna inte längre.
Låt oss se hur det ser ut.
- Den första podden skickar en begäran till tjänsten:

- Du vet redan vad som kommer härnäst. Tjänsten existerar inte, men det finns iptables-regler som behandlar begäran:
- En av backend-podarna kommer att väljas som destinationsadress:

- Begäran når podden. Vid det här tillfället kommer en permanent TCP-anslutning mellan de två podarna att etableras:

- Varje följande begäran från den första podden kommer att gå genom den redan etablerade anslutningen:

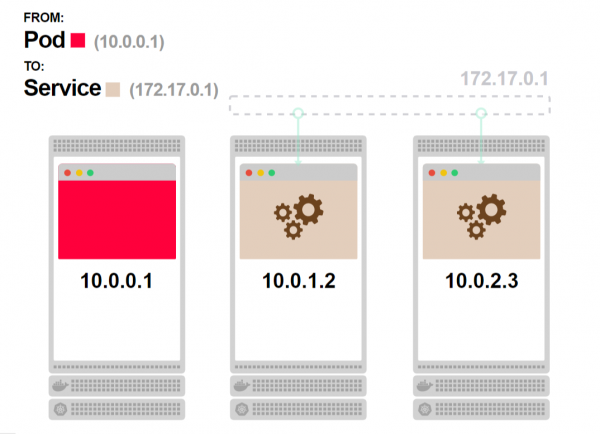
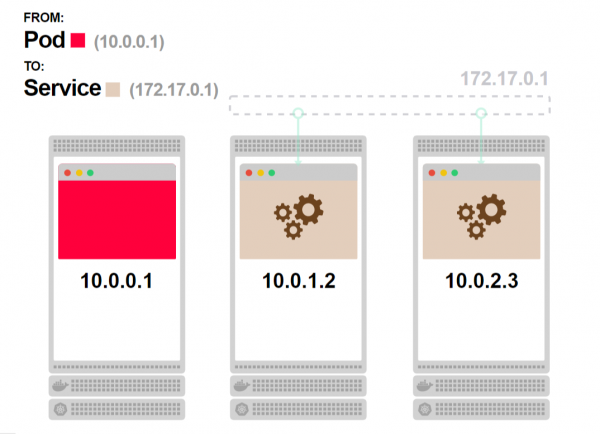
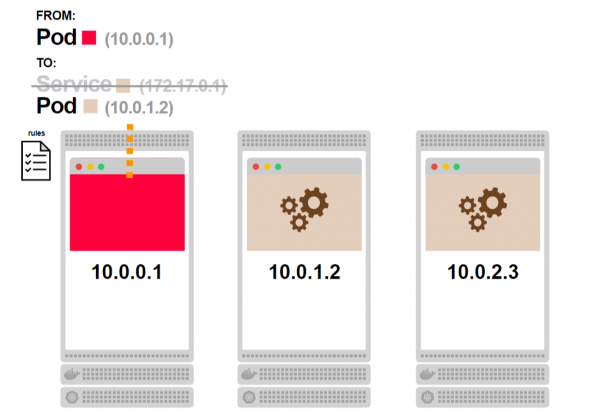
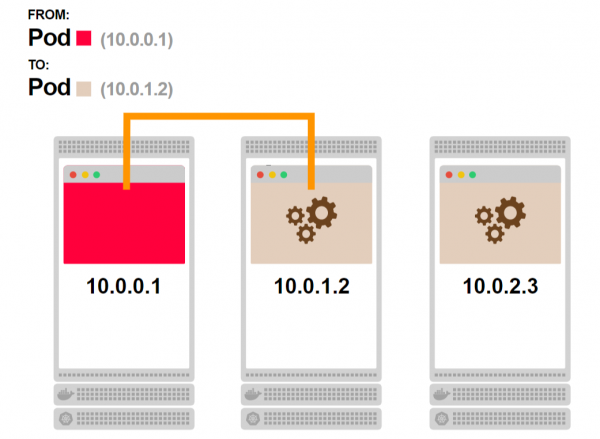
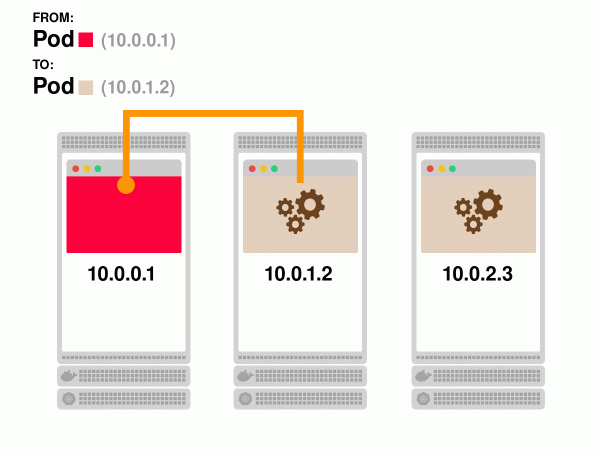
Som ett resultat har du fått en snabbare respons och högre genomströmning, men du har förlorat möjligheten att skala backend.
Även om du har två poddar i backend, kommer trafiken alltid att gå till en av dem under en permanent anslutning.
Kan detta åtgärdas?
Eftersom Kubernetes inte vet hur man balanserar permanenta anslutningar, läggs denna uppgift på dig.
Tjänster är en uppsättning IP-adresser och portar som kallas slutpunkter.
Din applikation kan få en lista över slutpunkter från tjänsten och besluta hur man fördelar begärningar mellan dem. Du kan öppna en permanent anslutning med varje pod och balansera begärningar mellan dessa anslutningar med round-robin.
Eller använda mer .
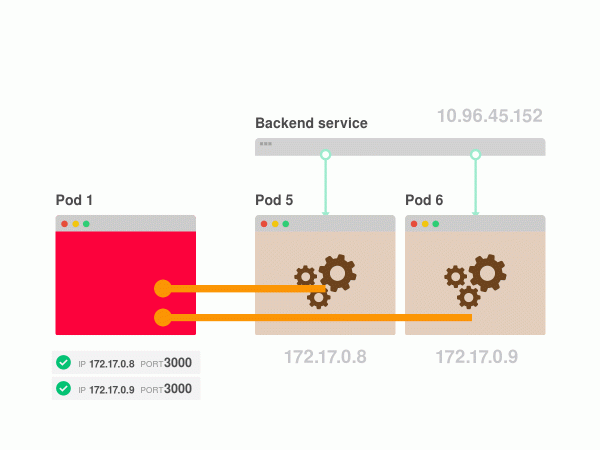
Koden på klientsidan, som ansvarar för balanseringen, bör följa följande logik:
- Få en lista över slutpunkter från tjänsten.
- För varje slutpunkt, öppna en permanent anslutning.
- När en begäran behöver göras, använd en av de öppna anslutningarna.
- Uppdatera regelbundet listan över slutpunkter, skapa nya eller stänga gamla permanenta anslutningar om listan ändras.
Så här ser det ut.
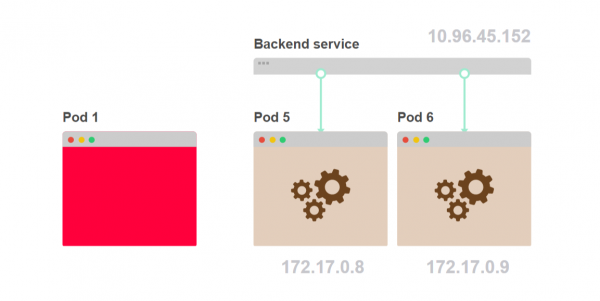
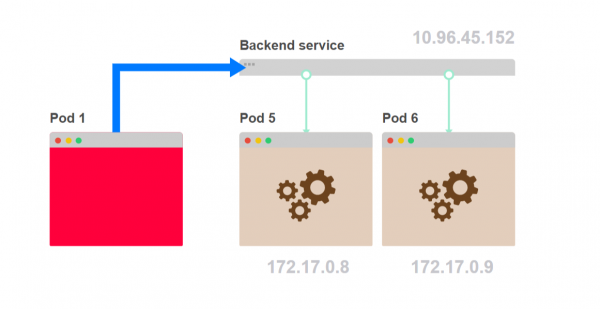
- Istället för att den första podden skickar en begäran till tjänsten, kan du balansera begärningar på klientsidan:

- Du behöver skriva kod som frågar vilka poddar som är en del av tjänsten:

- Så snart du får listan, spara den på klientsidan och använd den för att ansluta till poddarna:

- Du ansvarar själv för lastbalanseringsalgoritmen:
Nu uppstår frågan: gäller detta problem endast HTTP keep-alive?
Lastbalansering på klientsidan
HTTP är inte den enda protokollet som kan använda permanenta TCP-anslutningar.
Om din applikation använder en databas öppnas inte TCP-anslutningen varje gång du behöver utföra en begäran eller hämta ett dokument från databasen.
Istället öppnas och används en permanent TCP-anslutning till databasen.
Om din databas är distribuerad i Kubernetes och tillgången ges som en tjänst, kommer du att ställas inför samma problem som beskrivits i föregående avsnitt.
En databasreplik kommer att belastas mer än de andra. Kube-proxy och Kubernetes hjälper inte till att balansera anslutningarna. Du måste ta hand om lastbalanseringen av begärningar till din databas själv.
Beroende på vilken bibliotek du använder för att ansluta till DB, kan du ha olika alternativ för att lösa detta problem.
Nedan är ett exempel på åtkomst till en MySQL-databaskluster från Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* hämta endpoints från tjänsten */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Gör förfrågningar till den klustrade MySQL-databasen
Det finns många andra protokoll som använder permanenta TCP-anslutningar:
- WebSockets och säkrade WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
Du borde redan vara bekant med de flesta av dessa protokoll.
Men om dessa protokoll är så populära, varför finns det inget standardiserat lösning för lastbalansering? Varför krävs en ändring av klientens logik? Finns det en inbyggd lösning i Kubernetes?
Kube-proxy och iptables är skapade för att hantera de flesta standardanvändningar vid distribution i Kubernetes. Detta görs för bekvämlighet.
Om du använder en webbtjänst som tillhandahåller REST API har du tur — i det här fallet används inte permanenta TCP-anslutningar, du kan använda vilken Kubernetes-tjänst som helst.
Men så snart du börjar använda permanenta TCP-anslutningar måste du lista ut hur du jämnt fördelar belastningen på backend:erna. Kubernetes har inga färdiga lösningar för detta.
Men det finns självklart alternativ som kan hjälpa.
Lastbalansering av långlivade anslutningar i Kubernetes
I Kubernetes finns det fyra typer av tjänster:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
De första tre tjänsterna är baserade på en virtuell IP-adress som kube-proxy använder för att bygga iptables-regler. Men den grundläggande delen av alla tjänster är en headless-tjänst.
En headless-tjänst är inte kopplad till någon IP-adress och erbjuder endast en mekanism för att hämta en lista med IP-adresser och portar kopplade till dess pods (ändpunkter).
Alla tjänster baseras på en headless-tjänst.
ClusterIP-tjänsten är en headless-tjänst med några tillägg:
- Kontrollskiktet tilldelar den en IP-adress.
- Kube-proxy skapar nödvändiga iptables-regler.
Därför kan du ignorera kube-proxy och direkt använda listan med ändpunkter som erhållits från headless-tjänsten för lastbalansering i din applikation.
Men hur lägger man till en sådan logik till alla applikationer som distribuerats i klustret?
Om din applikation redan är distribuerad kan den uppgiften verka omöjlig. Men det finns ett alternativ.
Service Mesh kan hjälpa dig.
Du har kanske redan lagt märke till att lastbalanseringsstrategin på klientsidan är ganska standard.
När applikationen startar, så:
- Hämtar en lista med IP-adresser från tjänsten.
- Öppnar och underhåller en anslutningspool.
- Uppdaterar periodiskt poolen genom att lägga till eller ta bort ändpunkter.
Så snart applikationen vill göra en begäran, så:
- Väljer en tillgänglig anslutning, med någon typ av logik (till exempel round-robin).
- Genomför begäran.
Dessa steg fungerar både för WebSocket- och gRPC-anslutningar, samt för AMQP.
Du kan extrahera denna logik till ett separat bibliotek och använda det i dina applikationer.
Men istället kan du använda service mesh, till exempel Istio eller Linkerd.
Service Mesh kompletterar din applikation med en process som:
- Automatiskt letar efter IP-adresser för tjänster.
- Kontrollerar anslutningar som WebSockets och gRPC.
- Last balanserar begärningar med rätt protokoll.
Service Mesh hjälper till att hantera trafiken inom klustret, men den är ganska resurskrävande. Andra alternativ inkluderar att använda tredjepartsbibliotek som Netflix Ribbon eller programmerbara proxies som Envoy.
Vad händer om man ignorerar lastbalanseringsfrågor?
Du kan välja att inte använda lastbalansering och ändå inte märka några förändringar. Låt oss titta på några scenarier för drift.
Om du har fler kunder än servrar är det inte ett så stort problem.
Anta att det finns fem kunder som ansluter till två servrar. Även om det inte finns någon belastningsbalansering kommer båda servrarna att användas:
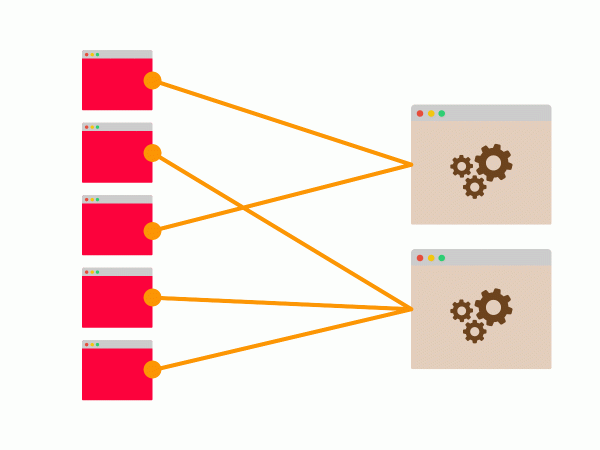
Anslutningarna kan fördelas ojämnt: det kan hända att fyra kunder anslöt till samma server, men det finns en god chans att båda servrarna kommer att användas.
Vad som är mer problematiskt är det motsatta scenariot.
Om du har färre kunder och fler servrar kan dina resurser utnyttjas otillräckligt, vilket kan leda till ett potentiellt flaskhals.
Anta att det finns två kunder och fem servrar. I bästa fall kommer det att finnas två permanenta anslutningar till två av de fem servrarna.
De övriga servrarna kommer att stå oanvända:
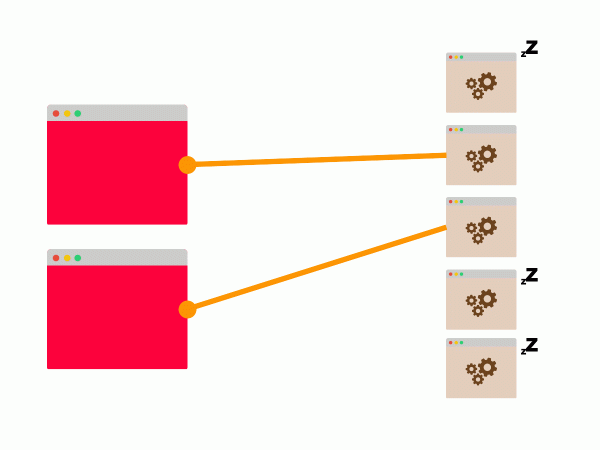
Om dessa två servrar inte kan hantera behandlingen av kundernas förfrågningar kommer horisontell skalning inte att hjälpa.
Slutsats
Kubernetes-tjänster är skapade för att fungera i de flesta standard scenarier för webbapplikationer.
Men så snart du börjar arbeta med applikationsprotokoll som använder långvariga TCP-anslutningar, såsom databaser, gRPC eller WebSockets, passar inte tjänster längre. Kubernetes tillhandahåller inga interna mekanismer för att balansera långvariga TCP-anslutningar.
Det betyder att du måste skriva applikationer med möjligheten till belastningsbalansering på klientsidan i åtanke.
Översättningen har förberetts av teamet .
Vad mer att läsa om ämnet:
- .
- .
- .
Källa: habr.com
