

 När man arbetar med stora datamängder kan problemet med brist på diskutrymme ibland bli akut. Ett av sätten att lösa detta problem är komprimering, vilket gör att man kan öka lagringskapaciteten på samma hårdvara. I denna artikel kommer vi att titta på hur datakomprimering fungerar i Apache Ignite. Endast de metoder som är implementerade i produkten för diskkomprimering kommer att behandlas. Andra metoder för datakomprimering (över nätverket, i minnet) både de som är implementerade och de som inte är, kommer att hållas utanför ramen.
Så, när persistensläget är aktiverat, börjar Ignite skriva till disken som ett resultat av ändringar i cacharna:
- Innehållet i cacharna
- Förhandsgranskningslogg (Write Ahead Log, här kallad WAL)
Det har funnits en mekanism för att komprimera WAL under en längre tid, känd som WAL-komprimering. I den nyligen släppta Apache Ignite 2.8 har två ytterligare mekanismer introducerats som gör det möjligt att komprimera data på disken: disk sida komprimering för att komprimera innehållet i cacharna och WAL sida snapshot komprimering för att komprimera vissa poster i WAL. Mer information om dessa tre mekanismer finns nedan.
Disk sida komprimering
Hur det fungerar
För att börja med ska vi kort gå igenom hur Ignite lagrar data. För lagring används sidminne. Sidstorleken sätts vid start av noden och kan inte ändras senare, dessutom måste sidstorleken vara en potenti av två och vara ett multipel av storleken på filsystemets block. Sidor laddas in i RAM från disken vid behov, storleken på data på disken kan överskrida den tilldelade RAM-kapaciteten. Om det saknas utrymme i RAM för att ladda en sida från disken kommer gamla, redan oanvända sidor att trängas ut från RAM.
På disken lagras data på följande sätt: för varje partition av varje cachegrupp skapas en separat fil, i denna fil kommer sidor att följas i ordning av stigande index. Det fullständiga identifieringsnumret för en sida innehåller identifieringsnumret för cachegruppen, partitionsnumret och sidans index i filen. På så sätt kan vi entydigt bestämma filen och offsetet i filen för varje sida utifrån det fullständiga identifieringsnumret. För mer information om strukturen av sidminnet kan du läsa artikeln på Apache Ignite Wiki: .
Disk page compression, som namnet antyder, fungerar på sidor-nivå. När denna mekanism är aktiverad, hanteras data i RAM som den är, utan någon komprimering, men i ögonblicket då sidor sparas från RAM till disk, sker en komprimering av dem.
Men att komprimera varje sida individuellt löser fortfarande inte problemet, vi måste på något sätt minska storleken på de slutgiltiga filerna med data. Om storleken på sidan slutar vara fast, kan vi inte längre skriva sidor till fil en efter en, eftersom detta kan ge upphov till en rad problem:
- Vi kommer inte att kunna beräkna offset för sidan i filen med hjälp av sidans index.
- Det är oklart vad vi ska göra med sidor som inte är i slutet av filen och som ändrar sin storlek. Om storleken på sidan minskar, försvinner utrymmet som den frigjorde. Om storleken på sidan ökar, måste man leta efter en ny plats för den i filen.
- Om sidan flyttas ett antal byte som inte är delbart med filsystemets blockstorlek, kommer en extra block av filsystemet att beröras för att läsa eller skriva den, vilket kan leda till prestandaförsämring.
För att undvika att hantera dessa problem på egen nivå, använder disk page compression i Apache Ignite en filsystemsmekanism kallad sparse filer. En sparse (sparse) fil är en fil där vissa regioner, som fyllts med nollor, kan markeras som "hål". Inga filsystemblock kommer att allokeras för att lagra dessa hål, vilket resulterar i diskutrymmesbesparing.
Det är logiskt att för att frigöra ett filsystemblock måste storleken på hålet vara större än eller lika med storleken på filsystemets block, vilket lägger till en ytterligare begränsning för sidstorleken i Apache Ignite: för att komprimeringen ska ha någon effekt måste storleken på sidan vara strikt större än storleken på filsystemets block. Om storleken på sidan är lika med storleken på blocket, kan vi aldrig frigöra något block, eftersom för att frigöra ett enda block måste den komprimerade sidan ta upp 0 byte. Om storleken på sidan däremot är lika med storleken på 2 eller 4 block, kan vi frigöra minst ett block om vår sida komprimeras med minst 50% eller 75% respektive.
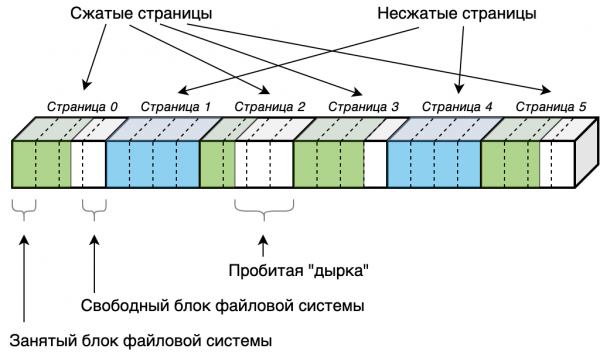
Således är den slutliga beskrivningen av mekanismens arbete: När en sida skrivs till disken görs ett försök att komprimera sidan. Om den komprimerade sidans storlek tillåter att en eller flera block av filsystemet frigörs, skrivs sidan i komprimerad form, och på platsen för de frigjorda blocken skapas en "hål" (ett systemanrop med flaggan "punch hole"). fallocate() Om den komprimerade sidans storlek inte tillåter block att frigöras, sparas sidan som den är, i okomprimerad form. Alla sidoffsetar beräknas på samma sätt som utan kompression, genom att multiplicera sidans index med sidans storlek. Ingen omlokalisering av sidor krävs på egen hand. Sidoffsetar, liksom utan kompression, hamnar vid gränserna för filsystemets block.
I den aktuella implementationen kan Ignite endast arbeta med sparsamma filer under Linux OS; därmed kan disk sidkompression endast aktiveras vid användning av Ignite på detta operativsystem.
Komprimeringsalgoritmer som kan användas för disk sidkompression: ZSTD, LZ4, Snappy. Dessutom finns det en driftläge (SKIP_GARBAGE), där endast oanvänd plats på sidan tas bort utan att kompression tillämpas på de återstående uppgifterna, vilket gör att CPU-belastningen minskar jämfört med de tidigare nämnda algoritmerna.
Påverkan på prestanda
Tyvärr har jag inte gjort några faktiska prestandamätningar på verkliga plattformar, eftersom vi inte planerar att använda denna mekanism i produktion, men vi kan teoretiskt diskutera var vi kommer att förlora och var vi kommer att vinna.
För detta behöver vi minnas hur läsning och skrivning av sidor utförs när vi gör förfrågningar till dem:
- Vid läsoperationen söks sidan först i RAM. Om sökningen misslyckas, laddas sidan in i RAM från disken av samma tråd som gör läsningen.
- Vid skrivoperationen markeras sidan i RAM som smutsig, men den fysiska sparingen av sidan till disken sker inte direkt inom tråden som utför skrivningen. Alla smutsiga sidor sparas till disken senare under checkpoint-processen av separata trådar.
Således påverkas läsoperationer:
- Positivt (disk IO), genom att antalet lästa block av filsystemet minskar.
- Negativt (CPU) på grund av den extra belastning som operativsystemet behöver för att hantera sparse-filer. Det kan också finnas ytterligare IO-operationer för att bevara en mer komplex struktur av sparse-filer (jag är tyvärr inte bekant med alla detaljer kring hur sparse-filer fungerar).
- Negativt (CPU) på grund av behovet av att dekomprimera sidor.
- Ingen påverkan på skrivoperationer.
- Påverkan på checkpoint-processen (liknande läsoperationer):
- Positivt (disk IO) på grund av minskningen av antalet skrivna block i filsystemet.
- Negativt (CPU, möjligtvis disk IO) på grund av hantering av sparse-filer.
- Negativt (CPU) på grund av behovet av att komprimera sidor.
Vilken skål väger tyngre? Detta beror väldigt mycket på miljön, men jag lutar åt att disk page compression snarare kommer att leda till prestandadegradering på de flesta system. Dessutom visar tester på andra databashanterare som använder liknande metoder med sparse-filer att prestandan minskar med aktiverad komprimering.
Hur man aktiverar och konfigurerar
Som nämnts tidigare är den minimi version av Apache Ignite som stöder disk page compression: 2.8 och stöds endast av operativsystemet Linux. Aktivering och konfiguration görs på följande sätt:
- I class-path måste modulen ignite-compression finnas. Som standard ligger den i distributionspaketet av Apache Ignite i katalogen libs/optional och ingår inte i class-path. Du kan helt enkelt flytta katalogen en nivå upp i libs så att den automatiskt inkluderas vid körning genom ignite.sh.
- Persistens måste vara aktiverat (aktiveras genom
DataRegionConfiguration.setPersistenceEnabled(true)). - Sidstorleken måste vara större än blockstorleken i filsystemet (detta kan ställas in med
DataStorageConfiguration.setPageSize()). - För varje cache vars data behöver komprimeras, måste komprimeringsmetod och (valfritt) komprimeringsnivå ställas in i konfigurationen (metoderna
CacheConfiguration.setDiskPageCompression(), CacheConfiguration.setDiskPageCompressionLevel()).
WAL-komprimering
Hur det fungerar
Vad är WAL och varför behövs det? Mycket kort: det är en logg där alla händelser som i slutändan förändrar sidlagringen registreras. Det behövs först och främst för att kunna återställa vid ett fel. Varje operation måste först registrera en händelse i WAL innan den ger kontrollen tillbaka till användaren, för att kunna återskapa alla operationer som användaren fick ett framgångsrikt svar på, även om dessa operationer inte hann återspeglas i sidlagringen på disken (det har tidigare beskrivits att den faktiska skrivningen till sidlagringen görs i en process som kallas "checkpoint" med viss fördröjning av separata trådar).
Posterna i WAL delas upp i logiska och fysiska. Logiska är själva nycklarna och värdena. Fysiska reflekterar förändringar i sidorna i sidlagringen. Om logiska poster kan vara användbara för vissa andra situationer, så behövs fysiska poster endast för att återställa vid ett fel och de poster som behövs är endast från den senaste framgångsrika checkpointen. Här kommer vi inte att gå in på detaljer och förklara varför det fungerar just så, men de som är intresserade kan vända sig till den redan nämnda artikeln på Apache Ignite Wiki: .
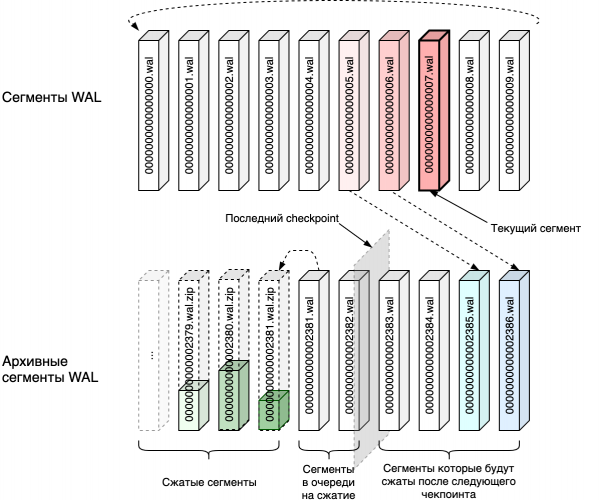
En logisk post motsvarar ofta flera fysiska poster. Det vill säga, till exempel så berör en put-operation i cachen flera sidor i den sidlagrade minnet (sidan med själva data, sidorna med index, sidorna med free-listor). I vissa syntetiska tester har jag funnit att de fysiska posterna upptog upp till 90% av storleken på WAL-filen. Samtidigt behövs de bara under en kort tid (som standard är intervallet mellan checkpoints 3 minuter). Det skulle vara logiskt att bli av med dessa data efter att de har förlorat sin aktualitet. Det är precis vad mekanismen för WAL-komprimering gör, den rensar bort fysiska poster och komprimerar de återstående logiska posterna med hjälp av zip, vilket resulterar i en betydande minskning av filens storlek (ibland upp till tio gånger).
WAL består fysiskt av flera segment (som standard 10) av fast storlek (som standard 64MB), som skrivs över på ett cykliskt sätt. När det aktuella segmentet är fullt tilldelas det nästa segmentet, och det fyllda segmentet kopieras till arkivet i en separat ström. WAL-komprimering fungerar redan med arkiverade segment. Det övervakar också checkpoints i en separat ström och påbörjar komprimering av arkiverade segment där fysiska poster inte längre behövs.
Påverkan på prestanda
Eftersom WAL-komprimering körs i en separat tråd ska det inte ha någon direkt inverkan på de pågående operationerna. Men det ger ändå en extra bakgrundsbelastning på CPU:n (komprimering) och disken (läsning av varje WAL-segment från arkivet och skrivning av komprimerade segment), så om systemet arbetar på gränsen av sina möjligheter kan det också leda till en nedgång i prestanda.
Hur man aktiverar och konfigurerar
WAL-komprimering kan aktiveras med hjälp av egenskapen WalCompactionEnabled på DataStorageConfiguration (DataStorageConfiguration.setWalCompactionEnabled(true)). Dessutom kan man med metoden DataStorageConfiguration.setWalCompactionLevel() ställa in komprimeringsgraden om standardvärdet (BEST_SPEED) inte är tillfredsställande.
WAL sidavsnitt komprimering
Hur det fungerar
Tidigare har vi redan klargjort att WAL-poster delas in i logiska och fysiska. För varje ändring av varje sida i sidminnet skapas en fysisk WAL-post. Fysiska poster delas också in i två underkategorier: page snapshot record och delta record. Varje gång vi ändrar något på en sida och överför den från ett rent tillstånd till ett smutsigt, sparas en fullständig kopia av denna sida i WAL (page snapshot record – sid snapshot). Även om vi endast har ändrat en enda byte kommer en post som är något större än storleken på sidan att sparas i WAL. Om vi däremot ändrar något på en redan smutsig sida skapas en delta record i WAL, vilken endast återspeglar ändringarna i jämförelse med det föregående tillståndet för sidan, men inte hela sidan. Eftersom återställningen av sidors status från smutsigt till rent utförs under checkpoint-processen, kommer nästan alla fysiska poster omedelbart efter att checkpointen har påbörjats att bestå av endast sid snapshots (eftersom alla sidor omedelbart efter att checkpointen har påbörjats är rena), och sedan, i takt med att vi närmar oss nästa checkpoint, börjar andelen delta records växa och återställs igen vid början av nästa checkpoint. Mätningar från vissa syntetiska tester visade att andelen sid snapshots i den totala mängden fysiska poster når upp till 90%.
Idén med WAL page snapshot kompression går ut på att komprimera sid snapshots med hjälp av ett redan existerande verktyg för komprimering av sidor (se disk page compression). Under tiden sparas WAL-poster sekventiellt i ett append-only-läge och det finns inget behov av att binda poster till gränserna för filsystemets block, så här, till skillnad från mekanismen för disk page compression, har vi inte längre något behov av sparsamma filer, vilket innebär att denna mekanism även fungerar på operativsystem som inte är Linux. Dessutom spelar det ingen roll hur mycket vi lyckas komprimera sidan. Även om vi frigör 1 byte är det redan ett positivt resultat och vi kan lagra de komprimerade uppgifterna i WAL, till skillnad från disk page compression, där vi endast sparar en komprimerad sida om vi har frigjort mer än 1 block av filsystemet.
Sidor är lätt komprimerbara data, deras andel av den totala storleken på WAL är mycket hög, så genom att inte ändra formatet på WAL-filen kan vi uppnå en betydande minskning av dess storlek. Komprimering av logiska poster skulle kräva en ändring av formatet och förlust av kompatibilitet, till exempel för externa konsumenter som kan vara intresserade av logiska poster, utan att det skulle medföra en betydande minskning av filstorleken.
Precis som för diskpage-komprimering kan algoritmer som ZSTD, LZ4, Snappy och även SKIP_GARBAGE-läget användas för WAL page snapshot-komprimering.
Påverkan på prestanda
Som det är lätt att se, påverkar direkt aktiveringen av WAL page snapshot-komprimering endast de trådar som skriver data i sidminnet, det vill säga de trådar som ändrar data i cacheminnen. Läsning från WAL fysiska poster sker endast en gång, vid uppstart av noden efter ett fel (och endast om ett fel inträffar under en checkpoint).
Det påverkar de trådar som ändrar data på följande sätt: vi får en negativ effekt (CPU) på grund av behovet av att komprimera sidan varje gång innan vi skriver till disk och en positiv effekt (disk IO) på grund av minskning av mängden skrivna data. Därför är det enkelt: om systemets prestanda begränsas av CPU får vi en liten nedgång, om det är disk I/O får vi en ökning.
Indirekt minskning av WAL-storleken påverkar också (positivt) de trådar som arkiverar WAL-segment och de trådar som ansvarar för WAL-komprimering.
Riktiga prestandatester i vår miljö med syntetiska data visade en liten ökning (genomströmningen ökade med 10%-15%, latensen minskade med 10%-15%).
Hur man aktiverar och konfigurerar
Minimikrav för Apache Ignite: 2.8. Aktivering och konfiguration görs på följande sätt:
- I class-path måste modulen ignite-compression finnas. Som standard ligger den i distributionspaketet av Apache Ignite i katalogen libs/optional och ingår inte i class-path. Du kan helt enkelt flytta katalogen en nivå upp i libs så att den automatiskt inkluderas vid körning genom ignite.sh.
- Persistens måste vara aktiverat (aktiveras genom
DataRegionConfiguration.setPersistenceEnabled(true)). - Komprimeringsläget måste specificeras med metoden
DataStorageConfiguration.setWalPageCompression(), komprimering är som standard avstängt (läge DISABLED). - Valfritt kan graden av komprimering specificeras med metoden
DataStorageConfiguration.setWalPageCompression(), se javadoc för metoden för tillåtna värden för varje läge.
Slutsats
De behandlade mekanismerna för datakompression i Apache Ignite kan användas oberoende av varandra, men alla deras kombinationer är också tillåtna. Att förstå principerna för deras funktion kommer att hjälpa dig att avgöra hur väl de passar dina uppgifter i din miljö och vad du eventuellt måste kompromissa med vid användning. Disk sidkompression är avsedd för att komprimera det primära lagret och kan ge en genomsnittlig kompressionsgrad. WAL sid snapshot-kompression kommer att ge en genomsnittlig kompressionsgrad för WAL-filer, och det är troligt att det till och med ökar prestandan. WAL-kompaktion kommer inte att påverka prestandan positivt, men kommer att maximera minskningen av storleken på WAL-filer genom att ta bort fysiska poster.
Källa: habr.com
