

Vi hade 2 säckar gräs, 75 tabletter meskalin, en unix-miljö, ett docker-repo och uppgiften var att genomföra kommandona docker pull och docker push utan docker-klienten.
UPD:
Fråga: Vad är poängen med allt detta?
Svar: Belastningstest av produkten (IKKE med bash, skripten är givna i utbildningssyfte). Det beslutades att inte använda docker-klienten för att minska extra mellanlager (inom rimliga gränser) och därmed simulera en högre belastning. Resultatet var att vi tog bort all systemlatens från docker-klienten. Vi fick en relativt ren belastning direkt på produkten.
I artikeln användes GNU-versioner av verktyg.
Låt oss börja med att förklara vad dessa kommandon gör.
Så vad används docker pull till? Enligt :
"Pull an image or a repository from a registry".
Där hittar vi också en länk till .
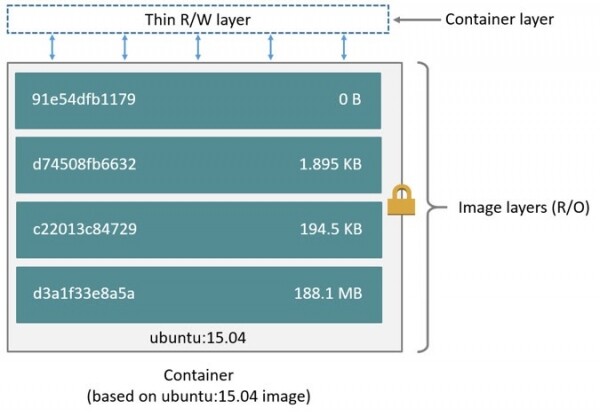
Här kan vi förstå att en docker image är en uppsättning lager, som innehåller information om de senaste förändringarna i bilden, som vi uppenbarligen behöver. Låt oss titta på .
Här sägs följande:
"An “image” is a combination of a JSON manifest and individual layer files. The process of pulling an > image centers around retrieving these two components."
Så det första steget enligt dokumentationen är "Pulling an Image Manifest”.
Vi kommer inte att dra det, men vi behöver data från det. Här är ett exempel på en förfrågan: GET /v2/{name}/manifests/{reference}
"The name and reference parameter identify the image and are required. The reference may include a tag or digest."
Vårt docker-repo är installerat lokalt, vi försöker att utföra förfrågan:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Som svar får vi json, där vi just nu är intresserade av endast lagren, mer specifikt deras hash. När vi har fått dem kan vi gå igenom var och en och göra nästa förfrågan: "GET /v2/{name}/blobs/{digest}"
“Access to a layer will be gated by the name of the repository but is identified uniquely in the registry by digest.”
digest är i detta fall den hash som vi fick.
Vi testar
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
låt oss se vilken fil vi slutligen fått som första lager.
file firstLayer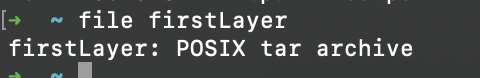
d.v.s. lagren är tar-arkiv, och genom att packa upp dem i rätt ordning får vi innehållet i bilden.
Låt oss skriva ett litet bash-skript för att automatisera allt detta.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Nu kan vi köra det med de önskade parametrarna och få innehållet från den nödvändiga bilden.
.\/script.sh dirName “http:\/\/localhost:8081\/link\/to\/docker\/registry” myAwesomeImage 1.0Del 2 — docker push
Det här kommer att bli lite mer komplicerat.
Vi börjar igen med . Så vi måste ladda upp varje lager, samla den motsvarande manifestet och ladda upp det också. Det verkar enkelt.
Genom att studera dokumentationen kan vi dela in uppladdningsprocessen i flera steg:
- Initiering av processen — "POST \/v2\/{repoName}\/blobs\/uploads\/
- Uppladdning av lager (vi kommer att använda monolitisk uppladdning, dvs. vi skickar varje lager i sin helhet) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest={digest}"
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Lager Binär Data". - Uppladdning av manifest — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Men dokumentationen missar ett steg, utan vilket ingenting kommer att fungera. För monolitisk uppladdning, precis som för partiell (chunked) uppladdning, innan du laddar upp ett lager måste du göra en PATCH begäran:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}"
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
Annars kan du inte gå vidare från första punkten, eftersom du istället för det förväntade svaret 202 kommer att få 4xx.
Nu ser algoritmen ut så här:
- Initiering
- Patch lager
- Uppladdning av lager
- Uppladdning av manifest
Punkterna 2 och 3 kommer respektive att upprepas så många gånger som det finns lager som måste laddas upp.
För att börja behöver vi vilken bild som helst. Jag kommer att använda archlinux:latest.
docker pull archlinux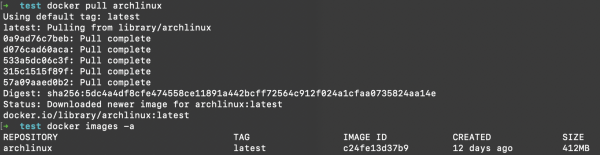
Nu sparar vi den lokalt för vidare analys.
docker save c24fe13d37b9 -o savedArch
Vi packar upp den erhållna arkivet i den aktuella katalogen.
tar xvf savedArch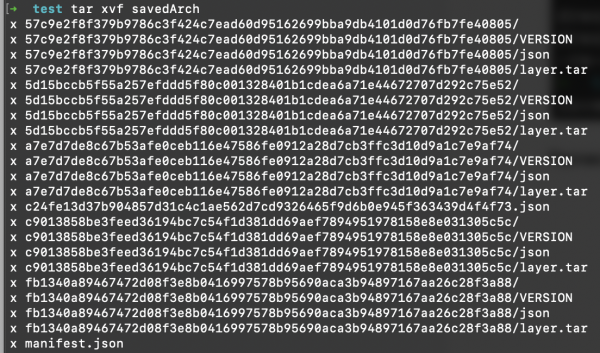
Som vi ser ligger varje lager i en separat mapp. Nu ska vi titta på strukturen av manifestet som vi fick.
cat manifest.json | json_pp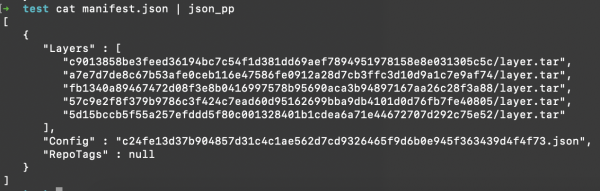
Inte så mycket. Låt oss se vilket manifest som behövs för uppladdningen, enligt .
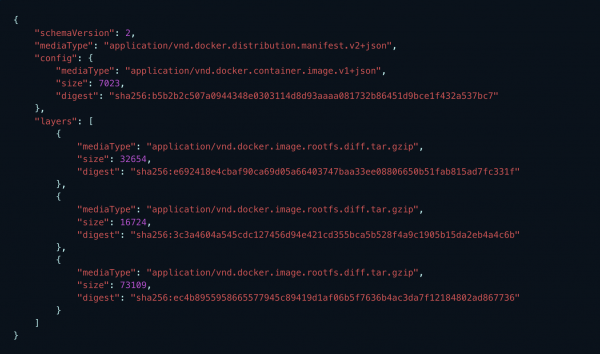
Det är uppenbart att det befintliga manifestet inte passar oss, så vi kommer att göra vårt med blackjack och kålsupare lager och konfigurationer.
Vi kommer alltid att ha minst en konfigurationsfil och en array av lager. Versionsschema 2 (giltigt vid tidpunkten för artikelns skrivande), mediaType lämnar vi oförändrat:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Efter att ha skapat det grundläggande manifestet måste vi fylla det med giltiga data. För detta använder vi en mall för json-objektet av lagret:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
det kommer vi att lägga till i manifestet för varje lager.
Därefter behöver vi ta reda på storleken på konfigurationsfilen och byta ut platshållarna i manifestet mot verkliga data.
sed -i "s/config_size/configSize/g; s/config_hash/configName/g" $manifestFileNu kan vi initiera uppladdningsprocessen och spara uuid, som sedan ska följa med alla efterföljande förfrågningar.
Det fullständiga skriptet ser ungefär ut så här:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
Vi kan använda ett färdigt skript:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Vad fick vi som resultat?
För det första, verkliga data för analys, eftersom tester körs i blazemeter och data från docker-klientens förfrågningar är ganska oinformationsrika i jämförelse med rena HTTP-förfrågningar.
För det andra gjorde övergången att vi kunde öka antalet virtuella användare för dockeruppladdning med ungefär 150% och därmed få ett genomsnittligt svarstider som är 20-25% snabbare. För docker-nedladdning ökades antalet användare med 500%, samtidigt som den genomsnittliga svarstiden minskade med cirka 60%.
Tack för uppmärksamheten.
Källa: habr.com
