

SQL, vad kan vara enklare? Vi kan alla skriva en enkel fråga — vi skriver select, listar de nödvändiga kolumnerna, sedan från, tabellnamnet, lite villkor i där och allt — då har vi användbara data i fickan, nästan oavsett vilken databas som ligger under huven (eller kanske inte ens är en databas) ). Som ett resultat kan arbetet med nästan vilken datakälla som helst (relationell eller inte) ses ur perspektivet av vanlig kod (med alla följder det innebär — versionskontroll, kodgranskning, statisk analys, automatiserade tester och allt det där). Och detta gäller inte bara själva datan, scheman och migrationer, utan hela livscykeln för lagret. I denna artikel kommer vi att diskutera vardagliga uppgifter och problem med att arbeta med olika databaser med fokus på "database as code".
Och vi börjar direkt med . De första striderna mellan "SQL vs ORM" sågs redan i .
Objekt-relationell mappning
Förespråkare av ORM värderar traditionellt hastighet och enkelhet i utvecklingen, oberoende av databasen och renheten i koden. För många av oss ser koden för databasarbetet (och ofta själva databasen)
vanligtvis ut ungefär så här...
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Modellen är prydd med smarta annotationer, och någonstans bakom kulisserna genererar och exekverar den återhållsamma ORM:en tonvis med SQL-kod. För att säga så, försöker utvecklarna med alla medel att skydda sig från sin databas med kilometer av abstraktioner, vilket tyder på en viss .
Å andra sidan noterar förespråkarna för ren "handmade"-SQL möjligheten att pressa ut alla safter ur sin databas utan några extra lager och abstraktioner. Som ett resultat så uppkommer "data-centric" projekt, där databasen hanteras av särskilt utbildade personer (de kallas också "basister", "basoviker", "basdädjes" osv.), medan utvecklarna bara behöver "dra" färdiga vyer och lagrade procedurer utan att bry sig om detaljerna.
Vad sägs om att ta det bästa från två världar? Hur det görs i det fantastiska verktyget med det livsbejakande namnet . Jag kommer att ge ett par rader från den övergripande konceptet i min fria översättning, och mer detaljerat kan man bekanta sig med det .
Clojure är ett fantastiskt språk för att skapa DSL:er, men SQL är redan i sig ett imponerande DSL, och vi behöver inte ett till. S-expressioner är vackra, men här tillför de inget nytt. I slutändan får vi parenteser för parentesernas skull. Håller ni inte med? Då får ni vänta tills abstraktionen över databasen börjar läcka, och ni börjar brottas med funktionen. (raw-sql)
Och vad ska vi göra? Låt oss behålla SQL som vanlig SQL — en fil för varje fråga:
-- namn: users-by-country
select *
  from users
 where country_code = :country_code
… och läs sedan denna fil, och omvandla den till en vanlig Clojure-funktion:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; En funktion med namnet `users-by-country` har skapats.
;;; Låt oss använda den:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Genom att följa principen "SQL separat, Clojure separat", får ni:
- Inga syntaxöverraskningar. Er databas (precis som vilken annan som helst) följer inte SQL-standarden till 100% — men för Yesql spelar det ingen roll. Ni kommer inte att slösa tid på att jaga efter funktioner med syntax som är likvärdig med SQL. Ni kommer aldrig att behöva återvända till funktionen. (raw-sql "some (‘funky’ :: SYNTAX)")).
- Bästa editorstöd. Er editor har redan utmärkt stöd för SQL. Genom att behålla SQL som SQL kan ni helt enkelt använda det.
- Kompatibilitet inom teamet. Era DBA:er kan läsa och skriva SQL som ni använder i ert Clojure-projekt.
- Enklare prestandaoptimering. Behöver ni skapa en plan för en problematisk fråga? Inga problem när er fråga är vanlig SQL.
- Återanvändning av frågor. Dra och släpp dessa samma SQL-filer till andra projekt, för det handlar bara om gammaldags SQL — dela dem bara.
Enligt mig är idén mycket cool och samtidigt mycket enkel, vilket har gett projektet många fördelar. på olika språk. Och vi kommer att försöka tillämpa en liknande filosofi att separera SQL-kod från allt annat långt bortom ORM.
IDE & DB-hanterare
Vi börjar med en enkel daglig uppgift. Ofta måste vi söka efter objekt i databasen, till exempel hitta en tabell i ett schema och studera dess struktur (vilka kolumner, nycklar, index, begränsningar och så vidare som används). Och från vilken grafisk IDE eller namnlig DB-manager som helst, förväntar vi oss först och främst dessa förmågor. Det ska gå snabbt och vi vill inte vänta i en halv timme medan ett fönster med den nödvändiga informationen dras upp (särskilt vid långsamma anslutningar till en fjärrdatabas), och dessutom ska den information vi får vara färsk och aktuell, och inte gammal cache. Ju mer komplex och större databasen är, och ju fler databaser vi har, desto svårare är det att göra detta.
Men vanligtvis lägger jag musen åt sidan och skriver bara kod. Låt oss säga att vi behöver ta reda på vilka tabeller (och med vilka egenskaper) som finns i schemat 'HR'. I de flesta DBMS kan vi få det nödvändiga resultatet med följande enkla fråga från information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Innehållet i sådana referenstabeller varierar från databas till databas beroende på kapaciteterna hos varje DBMS. Och till exempel för MySQL kan vi få specifika parametrar för denna DBMS från samma referens:
select table_name
     , storage_engine -- Använd "motor" ("MyISAM", "InnoDB" etc)
     , row_format     -- Radformat ("Fixed", "Dynamic" etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle kan inte information_schema, men det har , och det uppstår inga stora problem:
select table_name
     , pct_free       -- Minimal ledig plats i datakluster (%)
     , pct_used       -- Minimal använd plats i datakluster (%)
     , last_analyzed  -- Datum för senaste statistikinsamlingen
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse är inget undantag:
select name
     , engine -- Använd "motor" ("MergeTree", "Dictionary" etc)
     , ...
  from system.tables
 where database = 'HR'
Något liknande kan göras i Cassandra (där det finns columnfamilies istället för tabeller och keyspaces istället för scheman):
select columnfamily_name
     , compaction_strategy_class  -- Skräputtagningsstrategi
     , gc_grace_seconds           -- Skräpets livslängd
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
För de flesta andra databaser kan liknande frågor också konstrueras (även i Mongo finns det , som innehåller information om alla kollektioner i systemet).
Självklart kan man på detta sätt få information inte bara om tabeller, utan om vilket objekt som helst. Då och då delar snälla människor med sig av sådan kod för olika databaser, som till exempel i serien av Habra-artiklar "Funktioner för dokumentering av PostgreSQL-databaser" (, , ). Självklart är det "sådär" roligt att hålla hela denna mängd frågor i huvudet och ständigt skriva in dem, så i min favorit-IDE/redigerare har jag ett förberett set av snippar för ofta använda frågor, och det är bara att fylla i objektnamnen i mallen.
Som ett resultat är ett sådant sätt att navigera och söka efter objekt mycket mer flexibelt, sparar mycket tid, och gör det möjligt att få just den informationen i det format som är nödvändigt just nu (som beskrivs i inlägget ).
Operationer med objekt
Efter att vi har hittat och studerat de nödvändiga objekten är det dags att göra något nyttigt med dem. Självklart utan att ta fingrarna från tangentbordet.
Det är ingen hemlighet att enkel borttagning av en tabell kommer att se likadan ut nästan i alla databaser:
drop table hr.personsMen att skapa en tabell är redan mer intressant. Nästan varje DBMS (inklusive många NoSQL) kan på ett eller annat sätt "create table", och huvuddelen kommer knappt att skilja sig (namn, kolumnlista, datatyper), men andra detaljer kan skilja sig kraftigt och beror på den interna strukturen och möjligheterna hos den specifika DBMS. Mitt favoritexempel är att i Oracle-dokumentationen tar bara "råa" BNF:er för syftet "create table" . Andra DBMS har mer blygsamma möjligheter, men var och en av dem har också många intressanta och unika funktioner för att skapa tabeller (, , , ). Det är osannolikt att någon grafisk "wizard" från nästa IDE (särskilt en allmän) helt kan täcka alla dessa funktioner, och om den skulle kunna, så skulle det vara en scen som inte är för de med svaga nerver. Samtidigt kommer en korrekt och i rätt tid skriven operator create table att möjliggöra att utan svårighet utnyttja alla dessa, göra lagring och tillgång till dina data pålitlig, optimal och så bekväm som möjligt.
Många databashanterare har sina specifika objekttyper som saknas i andra databashanterare. Vi kan dessutom utföra operationer inte bara på databasobjekten, utan även på själva databashanteraren, som att "döda" en process, frigöra ett minnesområde, aktivera spårning, gå in i "read only"-läge och mycket mer.
Och nu ska vi göra lite teckningar
En av de vanligaste uppgifterna är att skapa ett diagram med databasobjekten, för att på en vacker bild se objekt och relationer mellan dem. Nästan varje grafisk IDE, vissa kommandoradsverktyg, specialiserade grafiska verktyg och modellerare kan göra detta. De kommer att skapa en bild "som de kan", och endast genom att justera ett par parametrar i konfigurationsfilen eller kryssrutor i gränssnittet kan man påverka denna process.
Men detta problem kan lösas på ett mycket enklare, mer flexibelt och elegant sätt, naturligtvis med hjälp av kod. För att skapa diagram av vilken komplexitet som helst har vi flera specialiserade märkspråk (DOT, GraphML, etc.), och med dem en hel del program (GraphViz, PlantUML, Mermaid) som kan läsa sådana instruktioner och visualisera i olika format. Vi vet redan hur man får information om objekten och relationerna mellan dem.
Låt oss ge ett litet exempel på hur det skulle kunna se ut, med hjälp av PlantUML och (till vänster SQL-frågan som genererar den nödvändiga instruktionen för PlantUML, och till höger resultatet):
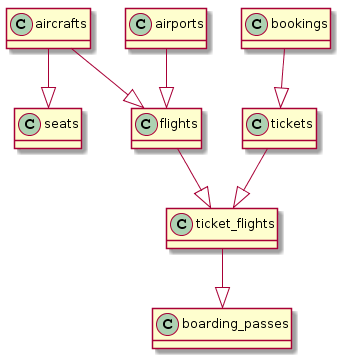
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Om man anstränger sig lite kan man på basis av få något som liknar en riktig ER-diagram:
SQL-frågan är lite mer komplicerad
-- Huvud
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabeller
select format('Table(%s, "%s n information about %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relationer mellan tabeller
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s may haven many %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Sidfot
select '@enduml' 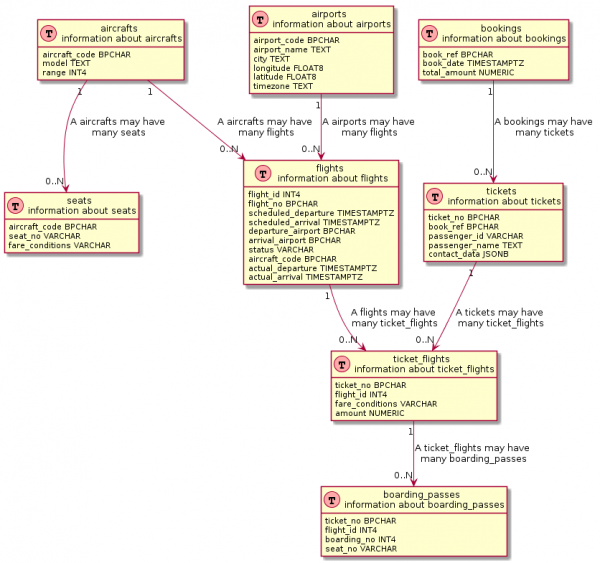
Om man tittar noga så använder de flesta visualiseringsverktyg på samma sätt liknande frågor. Men dessa frågor är vanligtvis djupt , för att inte tala om att modifiera dem.
Mätningar och övervakning
Låt oss gå vidare till ett traditionellt komplext ämne — övervakning av databashälsa. Jag kommer ihåg en liten sann historia som "en av mina vänner" berättade för mig. I ett pågående projekt fanns det en mäktig DBA, och få av utvecklarna kände honom personligen, eller hade överhuvudtaget sett honom (trots att han, enligt rykten, arbetade någonstans i det angränsande huset). Vid tidpunkten "X", när produktionssystemet för en stor detaljhandlare återigen började "må dåligt", skickade han tyst skärmdumpar av diagram från Oracle Enterprise Manager, där han noggrant markerade kritiska punkter med röd penna för "tydlighet" (vilket, milt sagt, sällan hjälpte). Och det var på denna "bild" man fick basera sina åtgärder. Men ingen hade tillgång till det värdefulla (i båda bemärkelser) Enterprise Manager, eftersom systemet är komplext och dyrt, och vem vet om "utvecklarna stöter på något och förstör allt". Därför hittade utvecklarna "empiriskt" platsen och orsaken till fördröjningar och släppte en patch. Om det skrämmande brevet från DBA inte kom igen inom den närmaste tiden, kände alla en lättnad och återvände till sina pågående uppgifter (tills ett nytt brev kom in).
Men övervakningsprocessen kan se betydligt mer underhållande och vänlig ut, och framför allt — tillgänglig och transparent för alla. Åtminstone dess grundläggande del, som ett komplement till de viktiga övervakningssystemen (som utan tvekan är användbara och i många fall oersättliga). Varje DBMS är fritt och helt utan kostnad redo att dela med sig av information om sitt nuvarande tillstånd och prestanda. I den "blodiga" Oracle DB kan man nästan få all information om prestanda från systemvisningar, allt från processer och sessioner till tillståndet för buffertcachen (till exempel, , avsnittet "Övervakning"). I PostgreSQL finns det också en rad systemvisningar för , särskilt sådana som är oumbärliga i det dagliga livet för varje DBA, som , , . I MySQL är det till och med en separat skema som är avsedd för detta, . Och i Mongo finns det en inbyggd som samlar in prestandadata i en systemkollektion .
Således, med hjälp av en metrics-aggregator (Telegraf, Metricbeat, Collectd) som kan utföra skräddarsydda SQL-frågor, en databas för dessa metrics (InfluxDB, Elasticsearch, Timescaledb) och en visualiserare (Grafana, Kibana), kan man få ett relativt enkelt och flexibelt övervakningssystem som kommer att vara nära integrerat med andra systemmetrics (hämtade, till exempel, från applikationsservrar, operativsystem osv.). Som detta, till exempel, görs i pgwatch2, där en kombination av InfluxDB + Grafana och en uppsättning frågor mot systemvyer används, till vilka man också kan .
Sammanfattningsvis
Och detta är bara en preliminär lista över vad man kan göra med vår databas genom vanlig SQL-kod. Jag är säker på att det finns många fler tillämpningar, skriv gärna i kommentarerna. Nästa gång ska vi prata om hur (och viktigast av allt varför) man automatiserar detta och integrerar det i sin CI/CD-pipeline.
Källa: habr.com
