

Kubernetes är ett utmärkt verktyg för att köra Docker-containrar i en klustrad produktionsmiljö. Men det finns uppgifter som Kubernetes inte kan lösa. Vid frekvent distribution i produktionsmiljö behöver vi en helt automatiserad Blue/Green-distribution för att undvika driftstopp i denna process, där det också är nödvändigt att hantera externa HTTP-förfrågningar och genomföra SSL-avlastning. Detta kräver integration med en lastbalanserare, såsom ha-proxy. En annan uppgift är semi-automatiserad skalning av själva Kubernetes-klustret när man arbetar i molnmiljö, till exempel delvis nedskalning av klustret under nattetid.
Även om Kubernetes inte har dessa funktioner direkt "ur lådan", erbjuder det ett API som kan användas för att lösa sådana uppgifter. Verktyg för automatiserad Blue/Green-distribution och skalning av Kubernetes-klustret har utvecklats inom projektet Cloud RTI, som skapats baserat på öppen programvara.
I denna artikel, en avkodning av videon, diskuteras hur man konfigurerar Kubernetes tillsammans med andra komponenter med öppen källkod för att skapa en produktionsklar miljö som oavbrutet tar emot kod från git commit.
Så snart du har fått tillgång till dina applikationer från den externa världen, kan du påbörja den fullständiga automatiseringsinställningen, det vill säga att ta den till en punkt där du kan göra en git commit och vara säker på att denna git commit når produktionen. Naturligtvis vill vi inte uppleva driftstopp vid genomförandet av dessa steg under distributionen. Så varje automatisering i Kubernetes börjar med API:et.
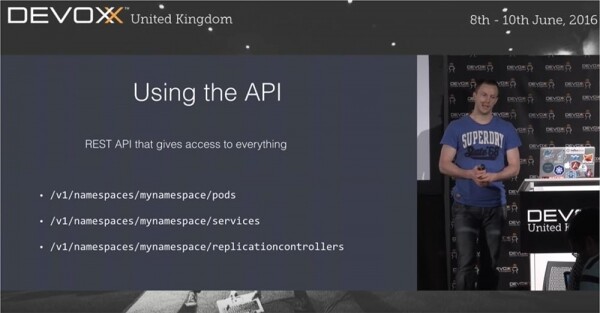
Kubernetes är inte ett verktyg som kan användas produktivt "direkt ur lådan". Självklart kan du göra så, använda kubectl och så vidare, men API:et är ändå det mest intressanta och användbara med denna plattform. Genom att använda API:et som en uppsättning funktioner kan du få tillgång till nästan allt du vill göra i Kubernetes. Kubectl själv använder också REST API.
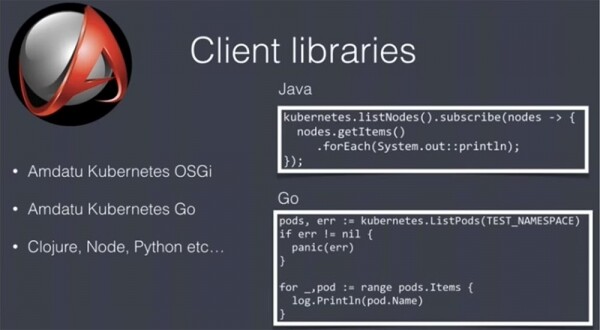
Det här är REST, så du kan använda vilket språk och verktyg som helst för att arbeta med det här API:et, men användarbiblioteken kommer att göra ditt liv betydligt enklare. Mitt team har skrivit två sådana bibliotek: ett för Java / OSGi och ett för Go. Det andra används inte så ofta, men ni har dessa användbara verktyg tillgängliga. De utgör ett delvis licensierat open-source-projekt. Det finns många sådana bibliotek för olika språk, så du kan välja de som passar bäst.
Så innan du börjar automatisera distributionen, är det viktigt att säkerställa att denna process inte drabbas av några driftstopp. Till exempel genomför vårt team produktiondistribution mitt på dagen, när folk använder applikationerna som mest, så det är mycket viktigt att undvika förseningar i denna process. För att undvika driftstopp används två metoder: blue/green distribution eller glidande uppdatering (rolling update). I det senare fallet, om du har fem replikas av applikationen, uppdateras de sekventiellt en efter en. Denna metod fungerar utmärkt, men den är inte lämplig om du har olika versioner av applikationen som körs samtidigt under distributionsprocessen. I så fall kan du uppdatera användargränssnittet medan backend fortfarande arbetar med den gamla versionen, vilket skulle innebära att applikationen skulle upphöra att fungera. Därför är det ganska komplicerat ur en programmeringssynvinkel att arbeta i sådana förhållanden.
Detta är en av anledningarna till att vi föredrar att använda blue/green deployment för att automatisera distributionen av våra applikationer. Med denna metod måste du säkerställa att endast en version av applikationen är aktiv vid en given tidpunkt.
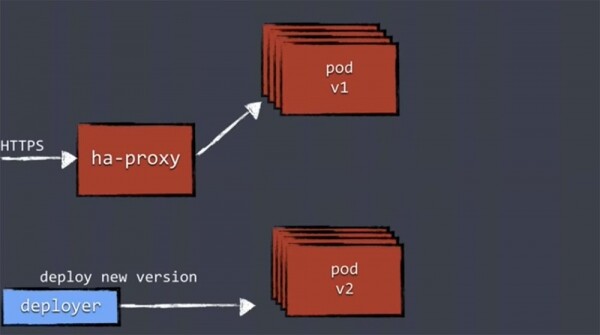
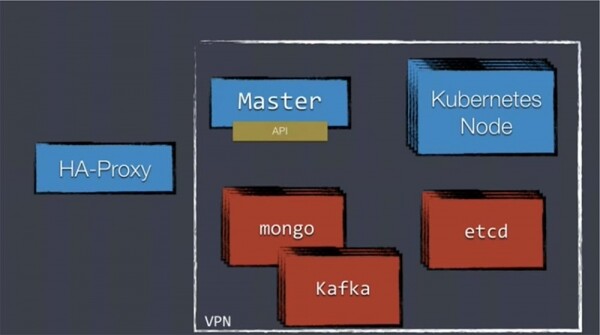
Blue/green deployment-mekanismen fungerar enligt följande. Vi får trafik till våra applikationer via ha-proxy, som dirigerar det till de körande replikas av applikationen med samma version.
När en ny distribution görs använder vi Deployer, som tillhandahålls nya komponenter, och den genomför distributionen av den nya versionen. Distributionen av den nya versionen av applikationen innebär att en ny uppsättning repliker "startas", och dessa repliker av den nya versionen körs i en separat, ny pod. Men ha-proxy har ingen kännedom om dem och dirigerar fortfarande ingen arbetsbelastning till dem.
Därför är det i första hand nödvändigt att utföra en hälsokontroll av de nya versionerna för att säkerställa att replikerna är redo att hantera belastningen.
Alla distributionskomponenter måste stödja någon form av hälsokontroll. Detta kan vara en mycket enkel kontroll med en HTTP-anrop, där du får en statuskod 200, eller en mer djupgående kontroll där du kontrollerar replikerna med databasen och andra tjänster, stabiliteten i förbindelserna i den dynamiska miljön, och att allt startar och fungerar korrekt. Denna process kan vara ganska komplex.
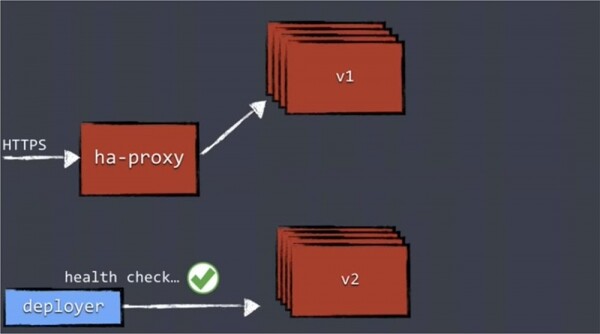
När systemet har verifierat att alla uppdaterade repliker fungerar, kommer Deployer att uppdatera konfigurationen och överföra rätt confd, som omkonfigurerar ha-proxy.
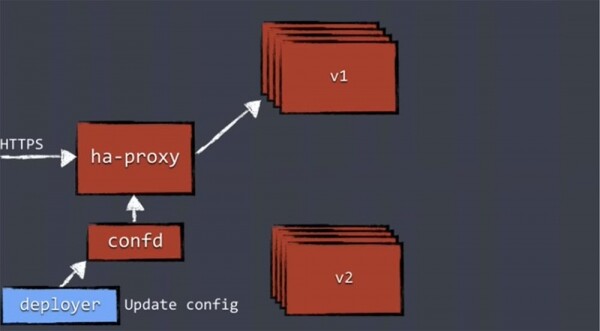
Först efter detta kommer trafiken att dirigeras till podden med repliker av den nya versionen, medan den gamla podden försvinner.
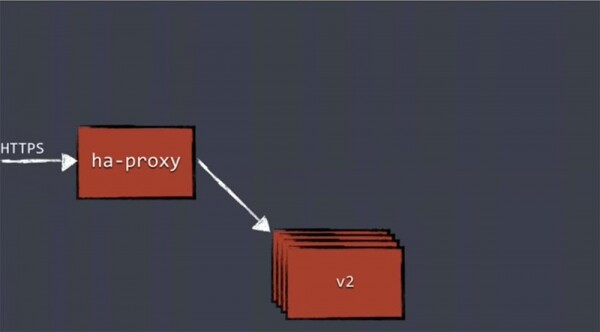
Denna mekanism är inte unik för Kubernetes. Konceptet med Blue/green deployment har funnits länge, och det har alltid använt en lastbalanserare. Först dirigerar du all trafik till den gamla versionen av applikationen, och efter uppdateringen växlar du helt över till den nya versionen. Detta princip gäller inte bara i Kubernetes.
Nu ska jag introducera er till den nya distributionskomponenten – Deployer, som utför hälsokontroller, omkonfigurerar proxy och så vidare. Detta är ett koncept som inte rör det externa världen och existerar inom Kubernetes. Jag kommer att visa hur man kan skapa sitt egna Deployer-koncept med hjälp av open source-verktyg.
Så, det första Deployer gör är att skapa en replikationskontroller RC med hjälp av Kubernetes API. Detta API skapar pods och tjänster för vidare distribution, det vill säga det skapar ett helt nytt kluster för våra applikationer. Så snart RC har bekräftat att replikerna har startat, gör den en statuskontroll av deras funktion, Health check. För detta används kommandot GET /health i Deployer. Det aktiverar motsvarande kontrollkomponenter och kontrollerar alla element som gör att klustret fungerar.
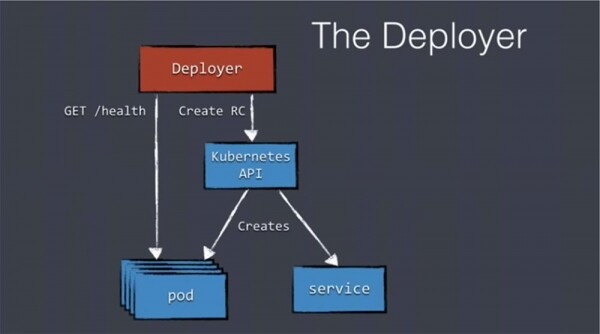
När alla pods har rapporterat sitt "hälsotillstånd", skapar Deployer en ny konfigurationspost – ett distribuerat lagringssystem etcd, som används internt inom Kubernetes, inklusive för att lagra konfigurationen för lastbalanseraren. Vi skriver data till etcd, och ett litet verktyg, confd, övervakar etcd för nya data.
Om det upptäcker några ändringar i den ursprungliga konfigurationen, genererar det en ny konfigurationsfil och överför den till ha-proxy. I detta fall startar ha-proxy om utan att förlora några anslutningar och dirigerar belastningen till de nya tjänster som stöder den nya versionen av våra applikationer.
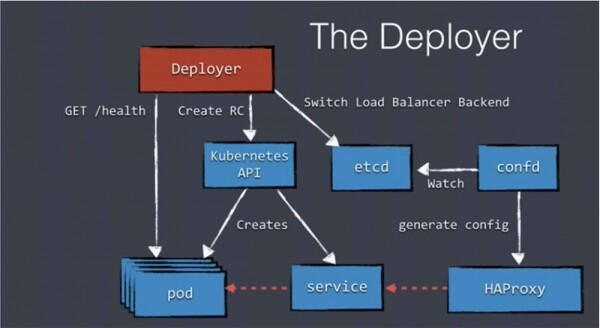
Som ni ser, trots mängden komponenter, finns det inget svårt här. Du behöver bara ägna mer uppmärksamhet åt API och etcd. Jag vill berätta om en open-source-deployer som vi själva använder – Amdatu Kubernetes Deployer.
Detta är ett verktyg för orkestrering av Kubernetes-distributioner, med följande funktioner:
- Blue/Green distribution;
- konfiguration av extern lastbalanserare;
- hantering av distributionsbeskrivningar;
- hantering av den faktiska distributionen;
- hälsokontroller under distributionen;
- införande av miljövariabler i pods.
Denna Deployer är byggd ovanpå Kubernetes API och erbjuder ett REST API för hantering av beskrivningar och distributioner, samt Websocket API för strömmande loggar under distributionen.
Den placerar konfigurationsdata för lastbalanseraren i etcd, så att du kan använda din egen lastbalanseringskonfigurationsfil istället för ha-proxy med "out-of-the-box"-stöd. Amdatu Deployer är skriven i Go, precis som Kubernetes, och är licensierad under Apache.
Innan jag började använda denna version av deployern använde jag följande distributionsbeskrivare, där jag angav de parametrar jag behövde.
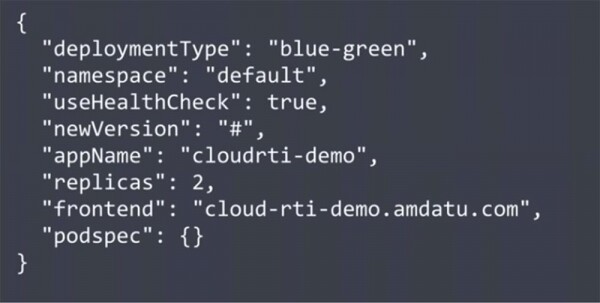
En av de viktiga parametrarna i denna kod är aktiveringen av flaggan "useHealthCheck". Vi behöver specificera att hälsokontroller måste utföras under distributionen. Denna parameter kan stängas av när tredjepartscontainrar används i distributionen som inte behöver kontrolleras. I denna beskrivare anges även antalet repliker och URL:en för frontenden som behövs av ha-proxy. I slutet anges flaggan för podspecifikationen "podspec" som hänvisar till Kubernetes för att hämta information om portkonfigurationer, bilder etc. Detta är en ganska enkel beskrivare i JSON-format.
Ett annat verktyg som är en del av open-source-projektet Amdatu, är Deploymentctl. Det har ett användargränssnitt (UI) för konfiguration av distributionen, lagrar distributionshistorik och innehåller webhooks för callbacks från tredjepartsanvändare och utvecklare. Du behöver inte använda UI, eftersom Amdatu Deployer själv är ett REST API, men detta gränssnitt kan avsevärt underlätta din distribution utan att involvera något API. Deploymentctl är skrivet i OSGi/Vertx med hjälp av Angular 2.
Nu kommer jag att visa det som sagts ovan på skärmen, genom att använda en förinspelad video, så att du inte behöver vänta. Vi kommer att distribuera en enkel applikation på Go. Oroa dig inte om du inte har stött på Go tidigare, detta är en mycket enkel applikation, så allt bör vara klart för dig.
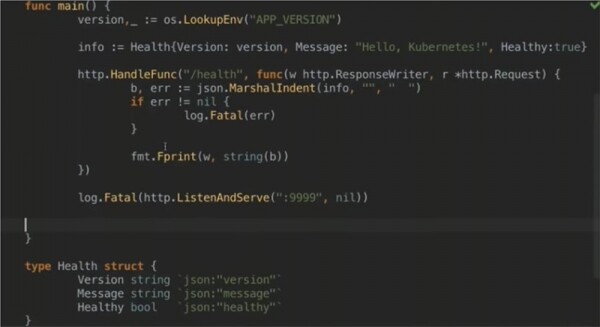
Här skapar vi en HTTP-server som bara svarar på /health, så denna applikation är endast avsedd för att kontrollera hälsokontrollen och inget mer. Om kontrollen lyckas aktiveras den JSON-struktur som visas nedan. Den innehåller versionen av applikationen som kommer att distribueras av deployern, meddelandet som du ser i toppen av filen, samt en boolean datatyp — om vår applikation är fungerande eller inte.
I den sista raden fuskar jag lite, eftersom jag placerade ett fast boolean-värde högst upp i filen, vilket senare kommer att hjälpa mig att distribuera även en "ohälsosam" applikation. Vi kommer att gå igenom detta senare.
Låt oss börja. Först kontrollerar vi om det finns några aktiva pods genom att köra kommandot ~ kubectl get pods och, genom att inte få något svar på front-end-URL:en, bekräftar vi att inga distributioner för närvarande pågår.
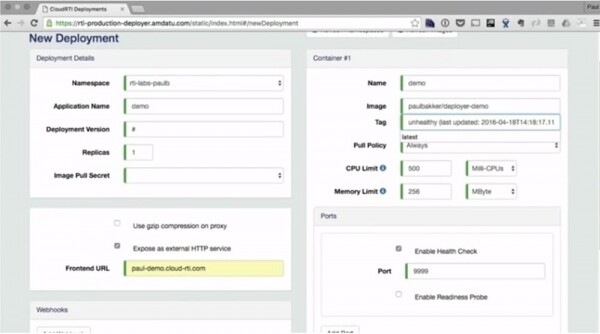
Nästa på skärmen ser ni det gränssnitt för Deploymentctl som jag nämnde, där distributionsparametrarna ställs in: namnrymden, applikationsnamnet, distributionsversionen, antalet repliker, front-end-URL:en, containerinänget, bilden, resursgränserna, portnumret för hälsokontrollen, och så vidare. Resursgränserna är mycket viktiga eftersom de möjliggör maximal användning av hårdvaran. Här kan vi också se distributionsloggen Deployment log.
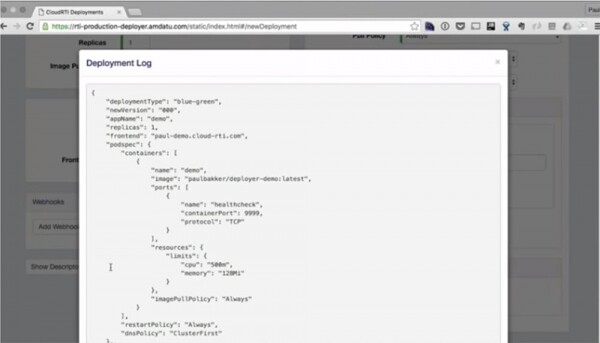
Om vi nu upprepar kommandot ~ kubectl get pods, kan vi se att systemet "fryser" i 20 sekunder, under vilka ha-proxy rekonfigureras. Efter det startas podden, och vi kan se vår replika i distributionsloggen.
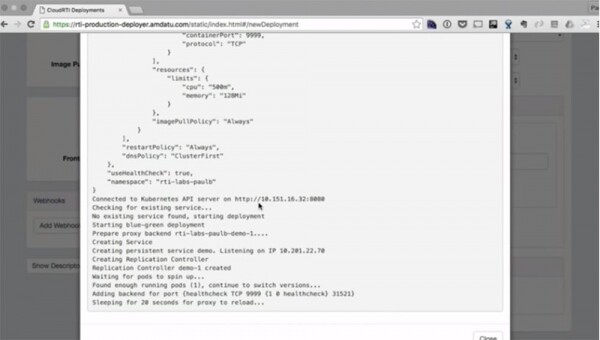
Jag har klippt ut de 20 sekunder av väntan från videon, och nu ser ni på skärmen att den första versionen av applikationen har distribuerats. Detta gjordes enbart med hjälp av UI.
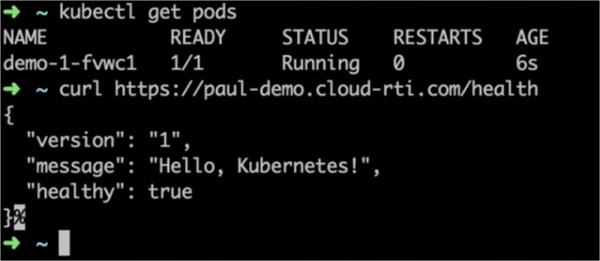
Låt oss nu försöka med den andra versionen. För detta ändrar jag applikationens meddelande från "Hello, Kubernetes!" till "Hello, Deployer!", systemet skapar denna bild och placerar den i Docker-registret, varefter vi bara trycker på knappen "Deploy" igen i fönstret Deploymentctl. Detta startar automatiskt distributionsloggen precis som det gjorde under distributionen av den första versionen av applikationen.
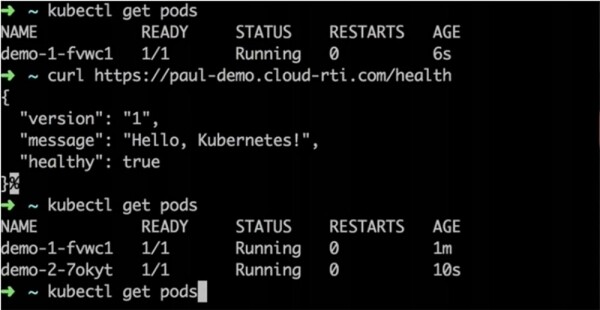
Kommandot ~ kubectl get pods visar att det för närvarande finns 2 versioner av applikationen aktiva, men front-end visar att vi fortfarande kör version 1.
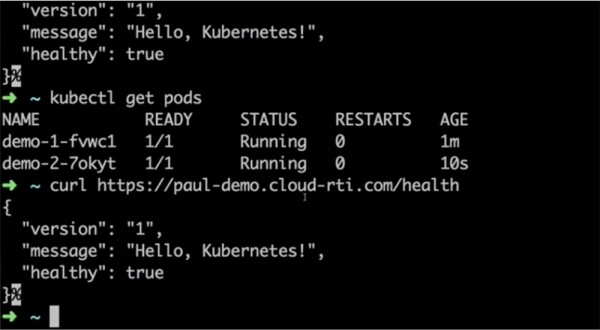
Lastbalanseraren väntar på att hälsokontrollen ska genomföras, varefter trafiken kommer att omdirigeras till den nya versionen. Efter 20 sekunder växlar vi till curl och ser att vi nu har distribuerat version 2 av applikationen, medan den första har tagits bort.
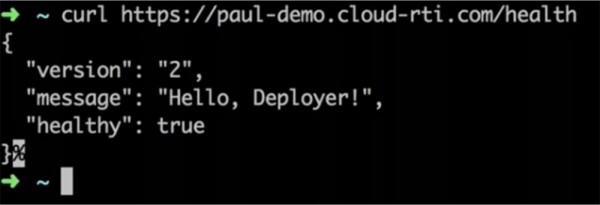
Detta var distributionen av en "hälsosam" applikation. Låt oss se vad som händer om jag ändrar värdet på parametern Healthy för den nya versionen av applikationen från true till false, det vill säga om jag försöker distribuera en ohälsosam applikation som inte klarade hälsokontrollen. Detta kan hända om det under utvecklingen har förekommit konfigurationsfel i applikationen, och den skickas till produktion i detta skick.
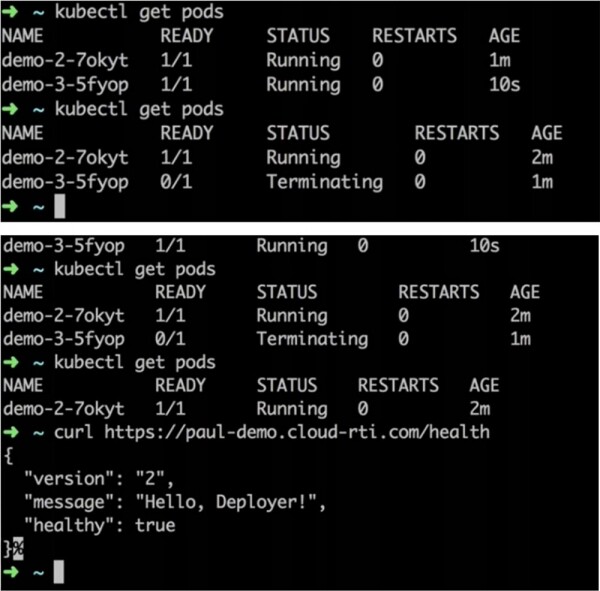
Som du kan se, går distributionen igenom alla de ovan nämnda stegen, och ~ kubectl get pods visar att båda poddar är igång. Men till skillnad från den tidigare distributionen visar loggen ett timeout-tillstånd. Det innebär att eftersom health check inte lyckades kan den nya versionen av applikationen inte distribueras. Som ett resultat ser du att systemet återgår till att använda den gamla versionen av applikationen, medan den nya versionen bara har tagits bort.
Det bästa med detta är att även om du har ett stort antal samtidiga förfrågningar som kommer till applikationen, kommer de knappt märka av några driftstopp under distributionsproceduren. Om man testar denna applikation med hjälp av Gatling-ramverket, som skickar så många förfrågningar som möjligt, så kommer ingen av dessa förfrågningar att avvisas. Det betyder att våra användare knappt kommer att märka uppdateringar av versionerna i realtid. Om det skulle misslyckas, fortsätter arbetet på den gamla versionen; om det lyckas, flyttas användarna till den nya versionen.
Det finns bara en sak som kan leda till misslyckande – om health check gick igenom framgångsrikt, men applikationen kraschade så snart den fick arbetsbelastning, det vill säga kollapsen inträffar först efter att distributionen är klar. I så fall måste du manuellt återgå till den gamla versionen. Så, vi har sett hur man använder Kubernetes med avsedda open-source-verktyg. Distributionsproceduren kommer att gå mycket smidigare om du integrerar dessa verktyg i Build/Deploy pipelines. För att starta distributionen kan du använda både användargränssnittet och helt automatisera denna process, till exempel genom att göra en commit till master.
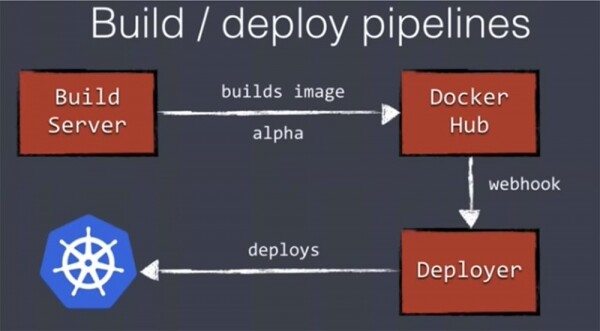
Vår Build Server skapar en Docker-avbildning, lägger den i Docker Hub eller vilket register du använder. Docker Hub stöder webhook, så vi kan starta en fjärrdistribution genom Deployer på det sätt som visades ovan. På så sätt kan hela distributionen av applikationen till potentiell produktion automatiseras.
Låt oss gå vidare till nästa ämne – skalning av Kubernetes-klustret. Jag vill påpeka att kommandot kubectl är ett skalningskommando. Med det kan vi enkelt öka antalet repliker i vårt befintliga kluster. Men i praktiken vill vi oftast öka antalet noder, inte pods.
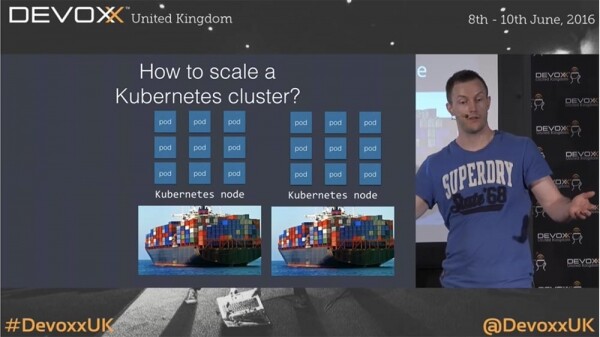
Under arbetstid kan det hända att du behöver öka antalet instanser, medan det på natten, för att minska kostnaderna för Amazon, kan vara nödvändigt att minska antalet körande instanser av din applikation. Det betyder inte att det räcker med att bara skala antalet pods, eftersom även om en av noderna är oanvänd, måste du ändå betala för den till Amazon. Således, förutom att skala pods, behöver du även skala antalet använda maskiner.
Detta kan skapa problem, eftersom oavsett om vi använder Amazon eller någon annan molntjänst, vet Kubernetes ingenting om antalet använda maskiner. Det saknas ett verktyg som kan skala systemet på nodnivå.
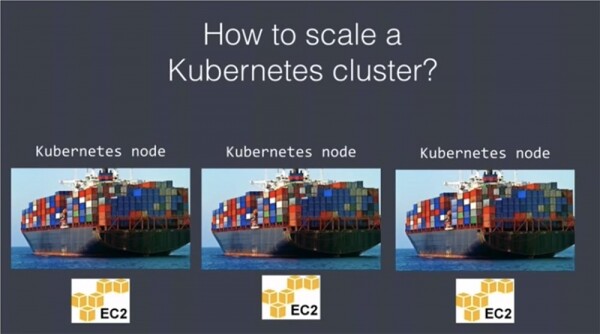
Så vi måste ta hand om både noder och pods. Vi kan enkelt skala upp nya noder med hjälp av AWS API och autoskalningsgrupper för att konfigurera antalet arbetsnoder i Kubernetes. Det går också att använda cloud-init eller ett liknande skript för att registrera noder i Kubernetes-klustret.
Den nya maskinen startar i Scaling group, registrerar sig själv som en nod, skrivs in i masterregistren och börjar arbeta. Efter detta kan antalet repliker ökas för att utnyttja de bildade noderna. Nedskärning kräver större ansträngningar, eftersom det är nödvändigt att säkerställa att ett sådant steg inte leder till att redan fungerande applikationer förstörs efter att "onödiga" maskiner har stängts av. För att förhindra detta scenario måste noderna sättas till statusen "unschedulable". Det innebär att schemaläggaren, vid schemaläggning av DaemonSet-pods, kommer att ignorera dessa noder. Schemaläggaren kommer inte att ta bort någon information från dessa servrar, men inte heller starta nya containrar där. Det följande steget är att dränera noden, det vill säga att flytta de fungerande pods från den till en annan maskin eller andra noder med tillräcklig kapacitet. När det har säkerställts att det inte finns några containrar kvar på dessa noder kan de tas bort från Kubernetes. Efter detta kommer de helt enkelt att upphöra att existera för Kubernetes. Därefter behöver AWS API användas för att stänga av onödiga noder eller maskiner.
Du kan använda Amdatu Scalerd — ett annat open-source verktyg för skalning, liknande AWS API. Det erbjuder CLI för att lägga till eller ta bort noder i klustret. Dess intressanta funktion är möjligheten att konfigurera schemaläggaren med hjälp av följande json-fil.
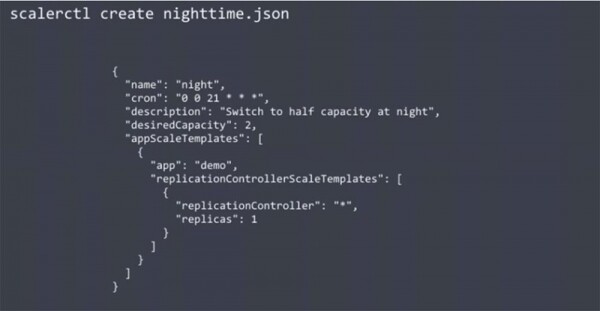
Koden som visas minskar kapaciteten i klustret med hälften under nattperioden. Den ställer in både antalet befintliga repliker och den önskade kapaciteten för Amazon-klustret. Användningen av denna schemaläggare kommer automatiskt att minska antalet noder på natten och öka dem på morgonen, vilket sparar kostnaden för användning av sådana noder från en molntjänst som Amazon. Denna funktion är inte inbyggd i Kubernetes, men användningen av Scalerd kommer att låta dig skala denna plattform hur som helst.
Jag vill uppmärksamma er på att många människor säger till mig: "Det här är allt bra, men vad händer med min databas som vanligtvis är statisk?" Hur kan man få något liknande att fungera i en så dynamisk miljö som Kubernetes? Enligt min åsikt bör ni inte göra det, ni bör inte försöka organisera databashantering i Kubernetes. Tekniskt sett är det möjligt, och det finns guider om detta på internet, men det kommer att komplicera ert liv avsevärt.
Ja, det finns begreppet beständiga lagringslösningar i Kubernetes, och ni kan försöka köra databaser som Mongo eller MySQL, men det är en ganska arbetsintensiv uppgift. Detta beror på att databaser inte helt stöder interaktion med en dynamisk miljö. De flesta databaser kräver betydande konfiguration, inklusive manuell klusterinställning, gillar inte automatiserad skalning och liknande.
Så det är inte värt att komplicera ert liv genom att försöka köra en databas i Kubernetes. Organisera deras arbete på det traditionella sättet med hjälp av bekanta tjänster och låt Kubernetes använda dem.
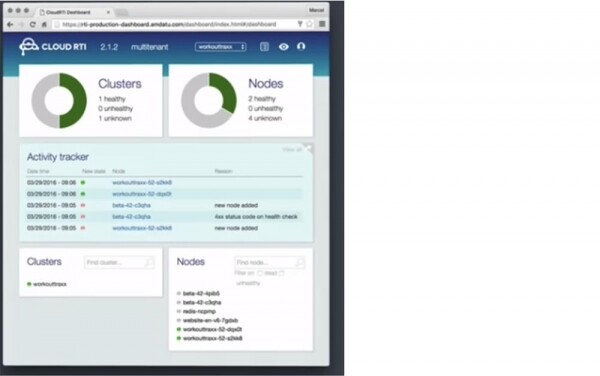
Avslutningsvis vill jag introducera er för Cloud RTI-plattformen baserad på Kubernetes, som mitt team arbetar med. Den erbjuder centraliserad loggning, övervakning av applikationer och kluster och har många andra användbara funktioner som ni kommer att ha nytta av. Den använder olika open-source verktyg, såsom Grafana för att visa övervakning.
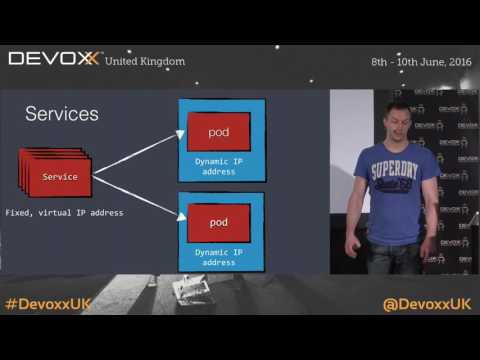
Det ställdes en fråga om varför man ska använda lastbalanseraren ha-proxy med Kubernetes. Bra fråga, eftersom det för närvarande finns två nivåer av lastbalansering. Kubernetes-tjänster är fortfarande på virtuella IP-adresser. Ni kan inte använda dem för portar på externa värd-maskiner, eftersom om Amazon överbelastar sin molnserver kommer adressen att ändras. Det är därför vi placerar ha-proxy framför tjänsterna – för att skapa en mer statisk struktur för sömlös trafikinteraktion med Kubernetes.
Ännu en bra fråga – hur kan man hantera förändringar i databasstrukturen vid blue/green deployment? Faktum är att oavsett om man använder Kubernetes, så är det en komplex uppgift att ändra databasstrukturen. Du måste säkerställa kompatibilitet mellan den gamla och den nya strukturen, och först därefter kan du uppdatera databasen och sedan själva applikationerna. Du kan genomföra en 'hot swapping' av databasen och sedan uppdatera applikationerna. Jag känner folk som har laddat upp ett helt nytt databascluster med en ny struktur, vilket är ett alternativ om du har en schemaless databas som Mongo, men i vilket fall som helst är det inte en enkel uppgift. Om det inte finns fler frågor, tack för uppmärksamheten!
Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
