

Vad skulle du känna om datacentret med din utrustning såg ut så här en underbar sommardag?
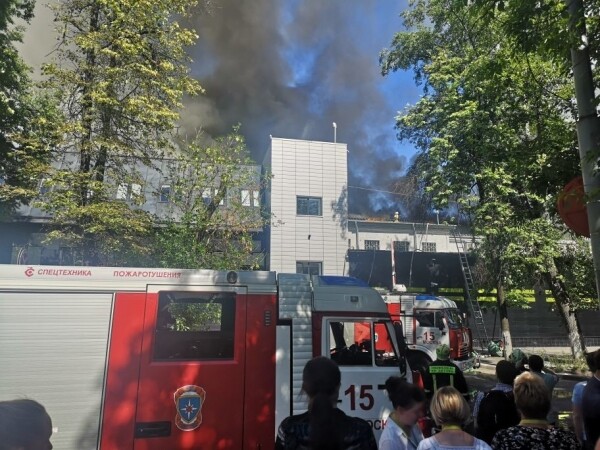
Hej alla! Jag heter Dmitrij Samsonov och arbetar som ledande systemadministratör påEn av de fyra datacentren där vår utrustning som stöder vårt projekt är installerad. Bakom dessa väggar finns cirka 4000 enheter av utrustning: servrar, lagringssystem, nätverksutrustning osv. — nästan en tredjedel av all vår utrustning.
De flesta servrar är Linux. Det finns också ett par dussin servrar med Windows (MS SQL) — vårt arv som vi gradvis har övergett under många år.
Så, den 5 juni 2019 klockan 14:35 meddelade ingenjörer från ett av våra datacenter om en brandlarm.
Förnekelse
14:45. Små incidenter med rökutveckling i datacentren sker oftare än vad man kan tro. Indikatorerna inom hallar var normala, så vår första reaktion var relativt lugn: vi införde förbud mot arbete med produktionen, det vill säga alla ändringar i konfigurationer, lansering av nya versioner och liknande, utom arbete som rör reparation av något.
Vrede
Har du någonsin försökt fråga brandmännen var på taket branden ägde rum, eller själv gå upp på det brinnande taket för att bedöma situationen? Hur mycket förtroende kan man ha för information som gått genom fem personer?
14:50. Det kom information om att elden närmar sig kylsystemet. Men kommer den att nå dit? Den jourhavande systemadministratören omdirigerar extern trafik från fronten av detta datacenter.
För närvarande är alla våra servicers framkanaler duplicerade i tre datacenter, och vi använder lastbalansering på DNS-nivå, vilket gör att vi kan ta bort adresserna för ett datacenter från DNS, vilket skyddar användarna från potentiella problem med åtkomst till tjänster. Om det redan har inträffat problem i datacentret, tas det automatiskt bort från rotationen. Mer kan läsas här:
Branden har för närvarande inte påverkat oss på något sätt — varken användare eller utrustning har skadats. Är det en incident? Den första delen av dokumentet 'Handlingsplan vid incident' ger en definition av begreppet 'incident', och slutar avsnittet så här:
«Om det råder tvekan om huruvida det är en incident eller inte, så är det en incident!»
14:53. Utnämning av katastrofkoordinator.
Koordinatorn är den person som övervakar kommunikationen mellan alla aktörer, bedömer omfånget av katastrofen, använder "Handlingsplan vid katastrof", engagerar nödvändig personal, övervakar avhjälpningen, och viktigast av allt – delegerar uppgifter. Med andra ord, det är den personen som hanterar hela avhjälpningsprocessen.
Handel
15:01. Vi börjar stänga av servrar som inte är kopplade till produktionen.
15:03. Vi stänger av alla reserverade tjänster på rätt sätt.
Detta inkluderar inte bara front-end (som användare vid denna tidpunkt redan inte går in på) och deras stödjande tjänster (affärslogik, cache och så vidare), utan även olika databaser med replikeringsfaktor 2 och mer (, , , och annat).
15:06. Information har kommit in om att en brand hotar ett av datacenterhallarna. I denna hall har vi ingen utrustning, men att elden kan sprida sig från taket till hallarna förändrar dramatiskt situationen.
(Senare visade det sig att det inte fanns något fysiskt hot mot hallen, då den var hermetiskt isolerad från taket. Hotet var endast för kylsystemet i den hallen.)
15:07. Vi tillåter att kommandon utförs på servrarna i snabbare tempo utan ytterligare kontroller ().
15:08. Temperaturen i hallarna är inom normala gränser.
15:12. Det har registrerats en temperaturökning i hallarna.
15:13. Mer än hälften av servrarna i datacentret är avstängda. Vi fortsätter.
15:16. Beslut har fattats om att stänga av all utrustning.
15:21. Vi börjar stänga av strömmen på stateless-servrar utan korrekt nedstängning av applikation och operativsystem.
15:23. En grupp ansvariga för MS SQL utses (de är få, beroendet av deras tjänster är inte stort, men återställningsproceduren tar längre tid och är mer komplicerad än, till exempel, för Cassandra).
Depression
15:25. Information har kommit om att strömmen har stängts av i fyra hallar av 16 (nr 6, 7, 8, 9). I hallar 7 och 8 finns vår utrustning. Det finns fortfarande ingen information om våra två andra hallar (nr 1 och 3).
Vanligtvis stängs elen av omedelbart vid bränder, men i detta fall, tack vare det koordinerade arbetet mellan brandmän och teknisk personal i datacentret, stängdes den inte överallt och inte omedelbart, utan vid behov.
(Det blev senare klart att strömmen i hallar 8 och 9 inte stängdes av.)
15:28. Vi börjar återställa MS SQL-databaser från backuper i andra datacenter.
Hur lång tid kommer detta att ta? Räcker nätverkskapaciteten längs hela rutten?
15:37. Det har registrerats avbrott i vissa delar av nätverket.
Management-nätverket och produktionsnätverket är fysiskt isolerade från varandra. Om produktionsnätverket är tillgängligt kan du logga in på servern, stoppa applikationen och stänga av OS. Om det inte är tillgängligt kan du logga in via IPMI, stoppa applikationen och stänga av OS. Om ingen av nätverken är tillgängliga kan du inte göra något. 'Tack, kapten!', tänker du.
'Och för övrigt, det är lite väl mycket röran', kanske du också funderar.
Allt handlar om att servrar genererar en enorm mängd värme även utan brand. Mer exakt, när det finns kylning genererar de värme, och när det inte finns någon skapar de ett helvetes bakhåll som i bästa fall smälter en del av utrustningen och stänger av en annan del, och i värsta fall… orsakar brand inuti hallen som praktiskt taget garanterat kommer att förstöra allt.
15:39. Vi registrerar problem med conf-databasen.
Conf-databasen är backend för den med namnet tjänsten, som används av alla produktionsapplikationer för att snabbt ändra inställningar. Utan denna databas kan vi inte styra portalens verksamhet, men själva portalen kan fortfarande fungera.
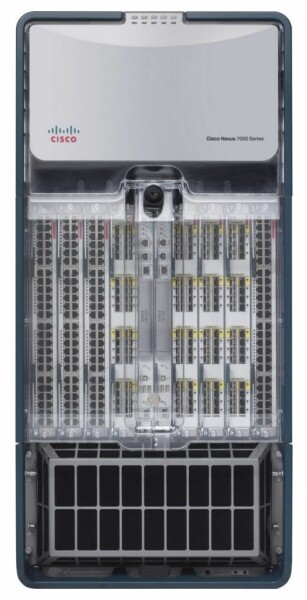
15:41. Temperaturgivarna på Core-nätverksutrustningen registrerar värden nära de högsta tillåtna. Det är en låda som tar upp en hel rack och möjliggör drift av alla nätverk inom datacentret.
15:42. Issue tracker och wiki är otillgängliga, vi växlar till standby.
Detta är inte produktion, men vid en nödsituation kan tillgången till vilken kunskapsbas som helst vara kritisk.
15:50. Ett av övervakningssystemen slutade fungera.
Det finns flera av dem, och de ansvarar för olika aspekter av tjänsternas funktion. Vissa av dem är inställda för autonom drift inom varje datacenter (det vill säga de övervakar endast sitt datacenter), andra består av distribuerade komponenter som transparent hanterar förlusten av vilket datacenter som helst.
I detta fall slutade , som arbetar i master-standby-läge. Vi växlade till standby.
Antagande
15:51. Vi stängde av alla servrar via IPMI utan korrekt avslut av arbetet, förutom MS SQL.
Är du redo för masshantering av servrar via IPMI om så behövs?
Det ögonblick när räddningen av utrustningen i datacentret har avslutats. Allt som kunde göras har gjorts. Vissa kollegor kan ta en paus.
16:13. Vi har fått information om att kylrör på taket har spruckit — detta försenar öppnandet av datacentret efter att branden har åtgärdats.
16:19. Enligt uppgifter från datacentrets tekniska personal har temperaturen i lokalerna slutat stiga.
17:10. Vi har återställt driften av konfigurationsdatabasen. Nu kan vi ändra inställningarna för applikationerna.
Varför är detta så viktigt, om allt är redundanta och fungerar även utan ett datacenter?
För det första är inte allt redundanta. Det finns olika sekundära tjänster som för närvarande inte klarar av att klara av ett datacenters nedgång tillräckligt bra, och det finns databaser i master-standby-läge. Möjligheten att hantera inställningarna gör det möjligt att vidta alla nödvändiga åtgärder för att minimera effekterna av en olycka på användarna även under svåra förhållanden.
För det andra har det blivit tydligt att verksamheten i datacentret inte kommer att återställas helt inom de närmaste timmarna, så det var nödvändigt att vidta åtgärder för att den långvariga otillgängligheten för repliker inte skulle leda till ytterligare problem som överfulla diskar i de kvarvarande datacentren.
17:29. Det är pizzatid! Vi har människor som arbetar, inte robotar.
Rehabilitering
18:02. Temperaturen i salar nr 8 (vår), 9, 10 och 11 har stabiliserats. I ett av de som förblir avstängda (nr 7) finns vår utrustning, och temperaturen fortsätter att stiga där.
18:31. Vi har gett klartecken för att starta utrustningen i salar nr 1 och 3 – dessa salar påverkades inte av branden.
För närvarande pågår uppstart av servrar i salar nr 1, 3 och 8, med de mest kritiska först. Vi kontrollerar att alla aktiverade tjänster fungerar korrekt. Det finns fortfarande problem med sal nr 7.
18:44. Datacentrets tekniska personal har upptäckt att många servrar i sal nr 7 (där endast vår utrustning är installerad) inte är avstängda. Enligt våra uppgifter är 26 servrar fortfarande påslagna. Efter en andra kontroll upptäcker vi 58 servrar.
20:18. Datacentrets tekniska personal blåser luft i rummet utan luftkonditionering genom mobila ventilationskanaler som är dragna genom korridorerna.
23:08. Den första administratören har fått åka hem. Någon måste sova under natten för att fortsätta arbetet imorgon. Vi släpper nu ytterligare en del av administratörerna och utvecklarna.
02:56. Vi har startat allt som går att starta. Vi utför en stor kontroll av alla tjänster med automatiska tester.
03:02. Luftkonditioneringen i det sista, 7:e rummet har återställts.
03:36. Vi har aktiverat frontarna i datacenter för rotation i DNS. Från och med nu börjar användartrafik att komma in.
Vi skickar en stor del av administratörsteamet hem. Men vi behåller några personer.
En liten FAQ:
Q: Vad hände mellan 18:31 och 02:56?
A: Enligt "Krisåtgärdsplanen" startar vi alla tjänster, med de viktigaste först. Samtidigt tilldelas tjänsten i chatten till en tillgänglig administratör som kontrollerar om OS och applikationen har startat, om det finns några fel och om indikatorerna är normala. Efter att starten är klar meddelar han i chatten att han är tillgänglig och får en ny tjänst från koordinatorn.
Processen fördröjs ytterligare av felaktig utrustning. Även om stopp av OS och avstängning av servrar har genomförts korrekt, återvänder vissa servrar inte på grund av plötsligt felaktiga diskar, minne, chassin. Vid strömavbrott ökar avbrottsfrekvensen.
Q: Varför kan vi inte bara starta allt på en gång och sedan fixa det som dyker upp i övervakningen?
A: Allt måste göras stegvis, eftersom det finns beroenden mellan tjänsterna. Och allt bör kontrolleras direkt, utan att vänta på övervakningen — eftersom det är bättre att hantera problem omedelbart, utan att vänta på att de ska förvärras.
7:40. Den sista administratören (koordinatorn) har gått och lagt sig. Arbetet för den första dagen är avslutat.
8:09. De första utvecklarna, ingenjörerna i datacentren och administratörerna (inklusive den nya koordinatorn) har påbörjat återställningsarbetena.
09:37. Vi har börjat återuppbygga rum nr 7 (det sista).
Samtidigt fortsätter vi att återställa det som inte har avslutats i de andra rummen: byte av diskar/minne/servrar, reparation av allt som "brinner" i övervakningen, byte av roller i master-standby-schema och andra små saker, som ändå är ganska många.
17:08. Vi tillåter alla normala arbeten med produktionen.
21:45. Arbetet för den andra dagen är avslutat.
09:45. Idag är det fredag. Det finns fortfarande en hel del småproblem i övervakningen. Helgen närmar sig, och alla vill koppla av. Vi fortsätter att massivt reparera allt som går. De schemalagda administrativa uppgifterna som kunde skjutas upp har blivit uppskjutna. En ny koordinator är på plats.
15:40. Plötsligt startade hälften av Core-nätverksutrustningen om i EN ANNAN datacenter. Vi har tagit ur rotation fronten för att minimera riskerna. Det har inte påverkat användarna. Senare visade det sig att det var en felaktig chassi. Koordinatorn arbetar med att fixa två incidenter samtidigt.
17:17. Nätverksarbetet i det andra datacentret är återställt, allt är kontrollerat. Datacentret har nu återgått till rotation.
18:29. Arbetet under den tredje dagen och den allmänna återställningen efter incidenten är slutfört.
Epilog
04.04.2013, , "Odnoklassniki" — under tre dagar var portalen helt eller delvis otillgänglig. Under hela denna tid reparerade över 100 personer från olika städer och företag (stort tack igen!), både på distans och direkt i datacentren, manuellt och automatiskt tusentals servrar.
Vi har dragit lärdomar. För att något liknande inte ska hända igen har vi genomfört och fortsätter att genomföra omfattande arbeten.
Vad är de viktigaste skillnaderna mellan den nuvarande incidenten och 404?
- Vi har fått en "Incident Response Plan". En gång per kvartal genomför vi övningar – simulerar en incident som en grupp administratörer (alla i tur och ordning) måste åtgärda med hjälp av "Incident Response Plan". Ledande systemadministratörer övar i tur och ordning rollen som koordinator.
- Kvartalsvis isolerar vi datacentren i testläge (alla i tur och ordning) via LAN och WAN, vilket möjliggör tidig upptäckter av flaskhalsar.
- Färre trasiga diskar, eftersom vi har skärpt normerna: mindre körtid, strängare tröskelvärden för S.M.A.R.T.
- Vi har helt övergivit BerkeleyDB – den gamla och instabila databasen som krävde mycket tid för att återställa efter omstart av servern.
- Vi har minskat antalet servrar med MS SQL och minskat beroendet av de som är kvar.
- Vi har vårt eget , där vi aktivt har migrerat alla tjänster under de senaste två åren. Molnet förenklar hela arbetsprocessen med applikationen och ger, vid incidenter, unika verktyg som:
- korrigering av alla applikationer med ett klick;
- enkel migrering av applikationer från misslyckade servrar;
- automatisk prioriterad start av hela datacentret.
Incidenten som beskrivs i denna artikel var den största sedan den 404:e. Självklart gick inte allt smidigt. Till exempel, under den tid datacentret var otillgängligt, kraschat i ett annat datacenter, föll en disk ut på en av servrarna, vilket innebar att endast en av tre repliker i Cassandra-klustret var tillgänglig, vilket gjorde att 4,2% av mobilapp-användarna inte kunde logga in. Samtidigt fortsatte redan anslutna användare att arbeta. Totalt har mer än 30 problem identifierats till följd av incidenten — från banala buggar till brister i tjänsternas arkitektur.
Men den största skillnaden mellan den nuvarande incidenten och 404:e är att medan vi hanterade konsekvenserna av branden, fortsatte användarna att chatta och göra videosamtal i , spela spel, lyssna på musik, ge varandra presenter, titta på videor, serier och TV-kanaler i , samt streama i .
Hur hanterar ni era incidenter?
Källa: habr.com
