

År 2018 introducerades termen MLOps i professionella kretsar och vid temakonferenser om AI, och har snabbt etablerat sig inom branschen som ett självständigt område. I framtiden kan MLOps bli en av de mest eftertraktade sektorerna inom IT. Vad innebär det och hur används det? Vi går igenom det nedan.
Vad är MLOps
MLOps (en integration av teknologier och processer för maskininlärning och metoder för att implementera utvecklade modeller i affärsprocesser) är ett nytt sätt för samarbete mellan affärsrepresentanter, forskare, matematikexperter, specialister inom maskininlärning och IT-ingenjörer för att skapa system för artificiell intelligens.
Med andra ord är det ett sätt att omvandla metoder och teknologier inom maskininlärning till ett användbart verktyg för att lösa affärsproblem.
Det är viktigt att förstå att kedjan av produktivitet börjar långt innan modellen utvecklas. Det första steget är att definiera affärsproblemet, hypoteserna om det värde som kan extraheras från data och affärsidéerna för tillämpning.
Själva begreppet MLOps uppstod som en analogi till begreppet DevOps, men tillämpat på modeller och teknologier för maskininlärning. DevOps är en metod för mjukvaruutveckling som möjliggör snabbare implementering av ändringar samtidigt som man behåller flexibilitet och tillförlitlighet genom olika metoder, inklusive kontinuerlig utveckling, uppdelning av funktioner i oberoende mikrotjänster, automatiserad testning och distribution av specifika ändringar, global övervakning av prestanda, samt ett system för snabb respons på identifierade problem och mycket mer.
DevOps definierade livscykeln för mjukvara och i specialistgemenskapen föddes idén att använda samma metodik för stora data. DataOps är ett försök att anpassa och utöka metoden med hänsyn till särskildheterna i lagring, överföring och bearbetning av stora datamängder på olika och interaktiva plattformar.
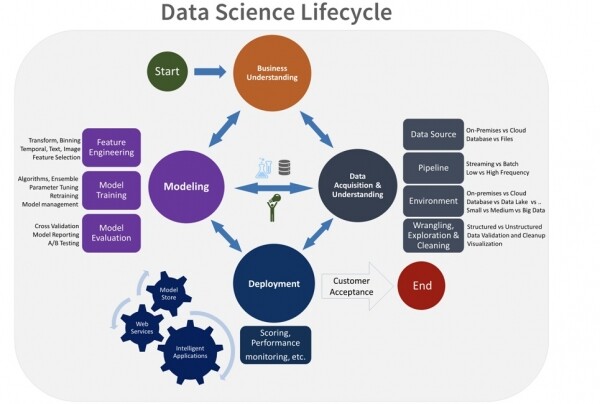
Med framväxten av en viss kritisk massa av maskininlärningsmodeller som implementerats i företags affärsprocesser har en stark likhet mellan livscykeln för matematiska maskininlärningsmodeller och livscykeln för mjukvara blivit uppmärksammad. Skillnaden ligger endast i att algoritmerna för modellerna skapas med hjälp av verktyg och metoder för maskininlärning. Därför har idén att tillämpa och anpassa kända metoder för mjukvaruutveckling på maskininlärningsmodeller naturligtvis uppkommit. På så sätt kan följande nyckelstadier identifieras i livscykeln för maskininlärningsmodeller:
- definiera affärsidén;
- träna modellen;
- testa och implementera modellen i affärsprocessen;
- drift av modellen.
När behovet av att ändra eller vidareutbilda modellen med nya data uppstår under driftsfasen, startar cykeln om — modellen förbättras, testas, och en ny version deployas.
Avvikelse. Varför vidareutbilda istället för att omutbilda? Termen "omutbildning av modellen" har en dubbel betydelse: bland specialister betyder det en defekt modell, där modellen gör bra förutsägelser, faktiskt upprepar det förutsagda värdet på träningsdata, men fungerar mycket sämre på externa datamängder. Uppenbarligen är en sådan modell en defekt, eftersom denna brist förhindrar dess tillämpning.
I denna livscykel verkar det logiskt att använda DevOps-verktyg: automatiserad testning, distribution och övervakning, utformning av modellberäkningar som separata mikrotjänster. Men det finns också en rad särdrag som hindrar en direkt tillämpning av dessa verktyg utan ytterligare ML-bindningar.
Hur får man modeller att fungera och generera vinst
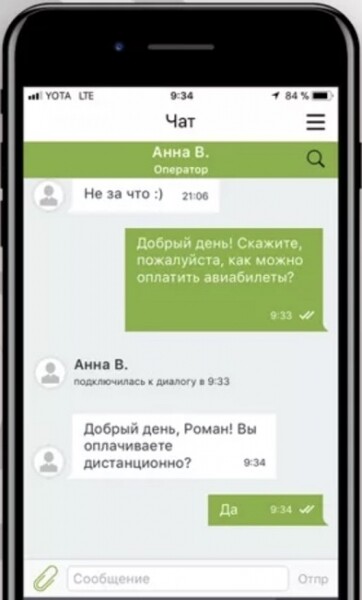
Som ett exempel där vi kommer att demonstrera tillämpningen av MLOps, tar vi den klassiska uppgiften att automatisera kundsupport genom chatt för bankprodukter (eller andra produkter). Vanligtvis ser affärsprocessen för support via chatt ut som följer: en kund skriver ett meddelande med en fråga i chatten och får ett svar från en specialist enligt en förutbestämd dialogstruktur. Automatiseringen av en sådan chatt usually löses med expertbestämda regeluppsättningar, som är mycket tidskrävande att utveckla och underhålla. Effektiviteten av sådan automatisering, beroende på uppgiftens komplexitet, kan uppgå till 20–30%. Naturligtvis väcks idén att det är mer fördelaktigt att implementera en artificiell intelligensmodul – en modell utvecklad med hjälp av maskininlärning, som:
- kan hantera fler förfrågningar utan hjälp av en operatör (beroende på ämnet, kan effektiviteten i vissa fall nå 70–80%);
- bättre anpassar sig till icke-standardformuleringar i dialogen – kan upptäcka avsikten, det verkliga önskemålet från användaren baserat på otydligt formulerade förfrågningar;
- vet att avgöra när modellens svar är adekvat, och när det finns tvivel kring «medvetenheten» av detta svar och det behövs en ytterligare avklarande fråga eller en överföring till en operatör;
- kan automatiskt vidareutbildas (istället för en grupp utvecklare som ständigt anpassar och justerar svarsscenarier, utbildar en Data Science-specialist modellen med hjälp av lämpliga maskininlärningsbibliotek).
Hur får man en så avancerad modell att fungera?
Precis som när man löser andra uppgifter, innan man utvecklar en sådan modul, måste man fastställa affärsprocessen och formellt beskriva den specifika uppgift som vi ska lösa med metoden för maskininlärning. Vid denna punkt inleds processens operabilisering, som anges med akronymen Ops.
Nästa steg är att data science-specialisten i samarbete med dataingenjören kontrollerar tillgången och tillräckligheten av data samt affärshypotesen om affärsidéns genomförbarhet genom att utveckla en prototyp av modellen och pröva dess faktiska effektivitet. Endast efter bekräftelse från affärshåll kan övergången från modellutveckling till integrering i system som utför specifika affärsprocesser börja. En helhetsplanering av implementeringen, en djup förståelse för hur modellen kommer att användas på varje steg och vilken ekonomisk effekt den kommer att medföra, är en grundläggande aspekt i processen för att implementera MLOps i företagets teknologiska landskap.
Med utvecklingen av AI-teknologier ökar antalet och mångfalden av uppgifter som kan lösas med hjälp av maskininlärning lavinartat. Varje sådan affärsprocess innebär besparingar för företaget genom automatisering av arbetet för anställda inom masspositioner (callcenter, granskning och sortering av dokument etc.), det är en utvidgning av kundbasen genom att lägga till nya attraktiva och bekväma funktioner, besparingar genom optimal användning av resurser och omfördelning av resurser och mycket mer. Slutligen är varje process inriktad på att skapa värde och därmed måste den ge viss ekonomisk effekt. Det är här viktigt att klart formulera affärsidén och beräkna den förväntade vinsten från implementeringen av modellen inom den övergripande strukturen för värdeskapandet i företaget. Det finns situationer där implementeringen av modellen inte lönar sig, och den tid som maskininlärningsexperterna lägger ner blir mycket dyrare än arbetsplatsen för en operatör som utför denna uppgift. Därför måste sådana fall identifieras tidigt i processen för att skapa AI-system.
Därför börjar modellen först generera vinster när affärsuppgiften i MLOps har formulerats korrekt, prioriteringarna har ställts och implementeringsprocessen för modellen i systemet har formulerats tidigt i utvecklingen.
Nytt process – nya utmaningar
Ett utförligt svar på den fundamentala frågan om hur tillämpbara ML-modeller är för att lösa problem, samt den allmänna frågan om förtroende för AI – det är en av de centrala utmaningarna i utvecklingen och implementeringen av MLOps-ansatser. Inledningsvis är företag skeptiska till att implementera maskininlärning i processerna – det är svårt att förlita sig på modeller i situationer där människor tidigare har arbetat. För företag framstår programmen som en "svart låda", vars relevans fortfarande måste bevisas. Dessutom finns det strikta krav från statliga myndigheter inom bankverksamhet, telekommunikation och andra branscher. Alla system och algoritmer som implementerats i bankprocesser genomgår en revision. För att lösa detta problem och övertyga företag och myndigheter om AI:s svar relevans och korrekthet, implementeras övervakningsverktyg tillsammans med modellen. Det finns också en oberoende valideringsprocedur, som är obligatorisk för regulatoriska modeller och som uppfyller centralbankens krav. En oberoende expertgrupp gör en revision av resultaten som modellen har producerat i beaktande av ingångsdata.
Den andra utmaningen är att bedöma och ta hänsyn till modellrisker vid implementering av maskininlärningsmodeller. Om även en människa inte kan svara med hundraprocentig säkerhet på frågan om klänningen var vit eller blå, så har också artificiell intelligens rätt att göra misstag. Det är också värt att notera att data kan förändras över tid, och modellerna behöver fortsätta att tränas för att ge tillräckligt exakta resultat. För att affärsprocessen inte ska påverkas negativt, är det nödvändigt att hantera modellrisker och övervaka modellens arbete, genom att regelbundet återträna den med nya data.
Men efter den första fasen av misstro börjar en motsatt effekt att framträda. Ju fler modeller som framgångsrikt implementeras i processerna, desto mer ökar företagens aptit för att använda artificiell intelligens – nya uppgifter dyker upp som kan lösas med hjälp av maskininlärning. Varje uppgift initierar en hel process som kräver olika kompetenser:
- dataingenjörer förbereder och bearbetar data;
- datascientister tillämpar verktyg för maskininlärning och utvecklar modeller;
- IT implementerar modellen i systemet;
- ML-ingenjören bestämmer hur modellen på rätt sätt ska integreras i processen, vilket IT-verktyg som ska användas beroende på krav för användning av modellen med hänsyn till flödet av förfrågningar, svarstid osv.
- ML-arkitekten designar hur programvaruprodukten kan genomföras fysiskt i ett industriellt system.
Hela cykeln kräver ett stort antal högt kvalificerade specialister. Vid en viss punkt i utvecklingen och graden av integration av ML-modeller i affärsprocesser visar det sig att det blir dyrt och ineffektivt att linjärt skala antal specialister i proportion till ökningen av antalet uppgifter. Därför uppstår frågan om automatisering av MLOps-processen — att definiera flera standardklasser av maskininlärningsuppgifter, utveckla typiska pipeline för databehandling och vidareutbildning av modeller. I den ideala bilden för att lösa sådana problem krävs proffs som behärskar kompetenser i korsningen mellan Big Data, Data Science, DevOps och IT. Därför är den största utmaningen inom Data Science-industrin och den största utmaningen vid organisering av MLOps-processer avsaknaden av sådan kompetens på den befintliga arbetsmarknaden. Specialister som uppfyller dessa krav är för närvarande enstaka på arbetsmarknaden och värderas som guld.
När det gäller kompetenser
Teoretiskt kan alla uppgifter inom MLOps lösas med klassiska DevOps-verktyg utan att behöva ta till en specialiserad utvidgning av rollmodellen. Som vi redan har nämnt ovan måste data scientist vara inte bara matematiker och specialist inom dataanalys, utan också mästare i hela pipelinen — det faller på honom att utveckla arkitekturen, programmera modeller på flera språk beroende på arkitekturen, förbereda datavitrinen och distribuera själva applikationen. Men att skapa den tekniska infrastrukturen som implementeras i den integrerade MLOps-processen tar upp till 80% av arbetsinsatsen, vilket betyder att en kvalificerad matematiker, som en kvalitets Data Scientist, endast kommer att ägna 20% av sin tid åt sitt specialområde. Därför blir uppdelningen av roller bland specialister som genomför processen för implementering av maskininlärningsmodeller livsnödvändig.
Hur detaljerat roller bör särskiljas beror på företagets storlek. Det är en sak när en specialist i en startup är en mångsysslare som fungerar som ingenjör, arkitekt och DevOps. En helt annan sak är när alla utvecklingsprocesser för modeller på ett stort företag är koncentrerade till ett fåtal högt kvalificerade Data Science-specialister, medan programmerare eller databasspecialister — en mer vanlig och billigare kompetens på arbetsmarknaden — kan ta hand om större delen av de rutinmässiga uppgifterna.
Således beror var gränsen går i valet av specialister för att säkerställa MLOps-processen och hur operationaliseringen av de utvecklade modellerna är organiserad direkt på hastigheten och kvaliteten på de utvecklade modellerna, teamets produktivitet och arbetsklimatet.
Vad vårt team har åstadkommit hittills
Vi började nyligen bygga upp kompetensstrukturer och MLOps-processer. Men nu är våra projekt för hantering av modellernas livscykel och att använda modeller som en tjänst redan i MVP-testning.
Vi har också definierat den optimala kompetensstrukturen och den organisatoriska strukturen för samarbetet mellan alla deltagare i processen, vilket ledde till att Agile-team skapades som löser uppgifter för hela spektrumet av affärskunder. Samtidigt har vi etablerat samarbeten med projektteam som skapar plattformar och infrastruktur som är grunden för den byggnad MLOps.
Frågor för framtiden
MLOps är ett utvecklande område som lider av brist på kompetenser och kommer att öka i betydelse i framtiden. Men för nu är det bäst att utgå ifrån etablerade metoder och praxis inom DevOps. Huvudsyftet med MLOps är att mer effektivt använda ML-modeller för att lösa affärsproblem. Men det väcker många frågor:
- Hur kan vi minska tiden för att sätta modeller i produktion?
- Hur kan vi minska byråkratiska friktioner mellan team med olika kompetenser och öka fokus på samarbete?
- Hur kan vi spåra modeller, hantera versioner och organisera effektiv övervakning?
- Hur kan vi skapa en verkligt cyklisk livscykel för en modern ML-modell?
- Hur kan vi standardisera processen för maskininlärning?
Svar på dessa frågor kommer i hög grad att avgöra hur snabbt MLOps kommer att avslöja sin fulla potential.
Källa: habr.com
