

VictoriaMetrics, TimescaleDB och InfluxDB jämfördes i en datamängd med en miljard datapunkter, som tillhör 40K unika tidsserier.
För flera år sedan var Zabbix eran. Varje bare metal-server hade högst några mätvärden – CPU-användning, minnesanvändning, disk-användning och nätverksanvändning. Därmed kunde mätvärden från tusentals servrar rymmas i 40 000 unika tidsserier, och Zabbix kunde använda MySQL som backend för dessa tidsserier 🙂
I dagsläget ger en standardkonfiguration mer än 500 mätvärden på en genomsnittlig värd. Det finns många för olika databaser, webbservrar, hårdvarusystem etc. Alla erbjuder många användbara mätvärden. Fler börjar exponera olika metrikar. Det finns Kubernetes med kluster och poddar som avtäcker många metrikar. Detta leder till att servrar exponerar tusentals unika mätvärden per värd. Därmed är en unik tidsserie på 40K inte längre en hög kapacitet. Det har blivit mainstream och bör enkelt hanteras av varje modern TSDB på en server.
Vad är egentligen en stor mängd unika tidsserier nu? Antagligen 400K eller 4M? Eller 40M? Låt oss jämföra moderna TSDB:er med dessa siffror.
Att installera en benchmark
är ett utmärkt verktyg för benchmarkning av TSDB:er. Det möjliggör generering av ett godtyckligt antal mätvärden genom att ange önskat antal tidsserier, delat med 10 – flagga (tidigare -scale-var). 10 – är antalet dimensioner (mätvärden) som genereras på varje värd, server. Följande datamängder skapades med hjälp av TSBS för benchmarken:
- 400K unika tidsserier, 60 sekunders intervall mellan datapunkter, data täcker hela 3 dagar, ~1.7B totalt antal datapunkter.
- 4M unika tidsserier, 600 sekunders intervall, data täcker hela 3 dagar, ~1.7B totalt antal datapunkter.
- 40M unika tidsserier, 1 timmes intervall, data täcker hela 3 dagar, ~2.8B totalt antal datapunkter.
Klient och server kördes på dedikerade instanser i Google Cloud. Dessa instanser hade följande konfigurationer:
- vCPUs: 16
- RAM: 60 GB
- Lagringsutrymme: standard hårddisk på 1 TB. Den ger en läshastighet/skrivhastighet på 120 Mbit/s, 750 läsningar per sekund och 1,5K skrivningar per sekund.
TSDB:er har extraherats från officiella docker-bilder och körts i docker med följande konfigurationer:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsInfluxDB-värden (-e är nödvändiga för hög kapacitet. Se detaljer i ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (konfigurationen togs från filen):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Databloader har körts med 16 parallella trådar.
Denna artikel innehåller endast resultat för kontrollpunkterna för insättning. Resultaten för den utvalda benchmarken kommer att publiceras i en separat artikel.
400K unika tidsserier
Låt oss börja med de enkla elementen – 400K. Benchmarkresultat:
- VictoriaMetrics: 2,6M datapunkter per sekund; minnesanvändning: 3 GB; slutlig datastorlek på disken: 965 MB
- InfluxDB: 1,2M datapunkter per sekund; minnesanvändning: 8,5 GB; slutlig datastorlek på disken: 1,6 GB
- Timescale: 849K datapunkter per sekund; minnesanvändning: 2,5 GB; slutlig datastorlek på disken: 50 GB
Som du kan se från resultaten ovan, vinner VictoriaMetrics i insättningsprestanda och komprimeringsgrad. Tidslinjen vinner i minnesanvändning, men den använder mycket diskutrymme – 29 byte per datapunkt.
Nedan finns grafer för CPU-användning för varje av TSDB:erna under benchmarktestet:
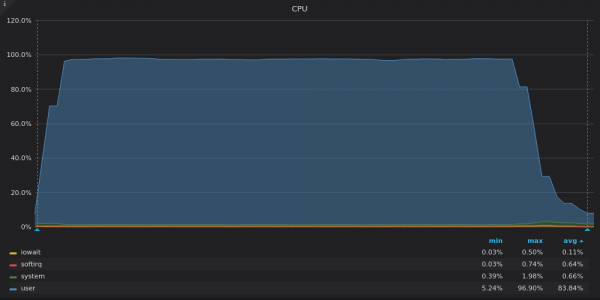
Ovanstående skärmdump: VictoriaMetrics – CPU-belastning under insättningstestet för den unika metriken 400K.
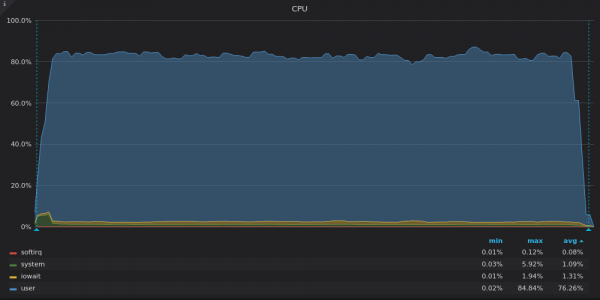
Ovanstående skärmdump: InfluxDB – CPU-belastning under insättningstestet för den unika metriken 400K.
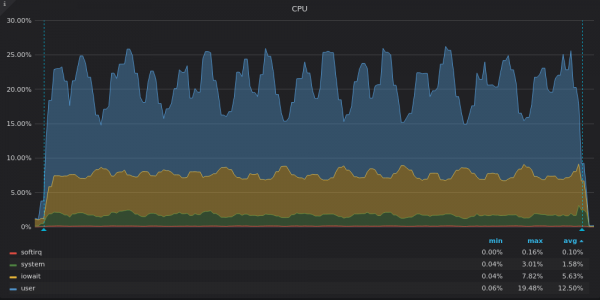
Ovanstående skärmdump: TimescaleDB – CPU-belastning under insättningstestet för den unika metriken 400K.
VictoriaMetrics använder alla tillgängliga vCPUs, medan InfluxDB inte utnyttjar tillräckligt med ~2 av 16 vCPUs.
Timescale använder bara 3-4 av 16 vCPUs. Höga iowait- och systemandelar på TimescaleDB:s tidsseriegrafik indikerar en flaskhals i I/O-subsystemet. Låt oss titta på graferna för diskens bandbreddsanvändning:
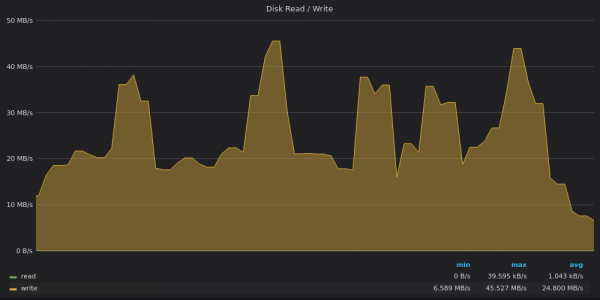
Ovanstående skärmdump: VictoriaMetrics – Diskens bandbreddsanvändning vid insättningsprov för 400K unika mätvärden.
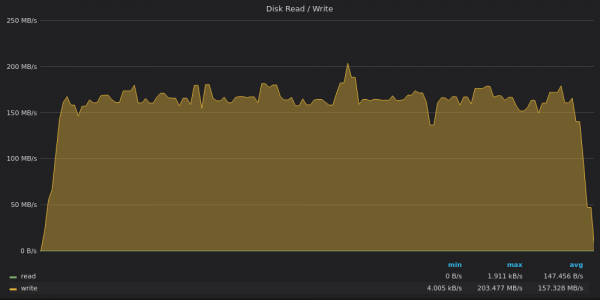
Ovanstående skärmdump: InfluxDB – Diskens bandbreddsanvändning vid insättningsprov för 400K unika mätvärden.
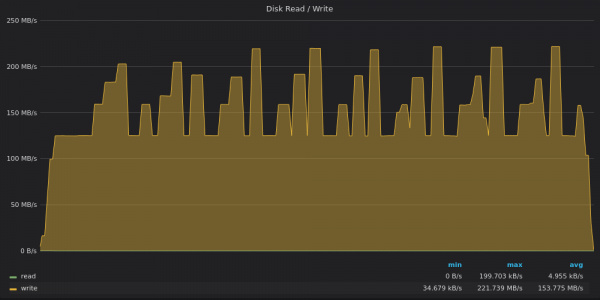
Ovanstående skärmdump: TimescaleDB – Diskens bandbreddsanvändning vid insättningsprov för 400K unika mätvärden.
VictoriaMetrics skriver data med en hastighet av 20 Mbit/s med toppar upp till 45 Mbit/s. Topparna motsvarar stora partiella sammanslagningar i trädet. .
InfluxDB skriver data med en hastighet av 160 MB/s, medan 1 TB-disken till en skrivbandbredd av 120 MB/s.
TimescaleDB är begränsad till en skrivbandbredd av 120 Mbit/s, men ibland bryter den denna gräns och når upp till 220 Mbit/s i toppar. Dessa toppar motsvarar fall av otillräcklig CPU-belastning på den föregående grafen.
Låt oss titta på graferna för I/O-användning:
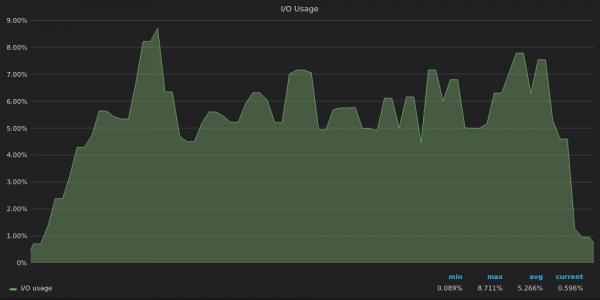
Ovanstående skärmdump: VictoriaMetrics – I/O-användning vid insättningsprov för 400K unika metrik.
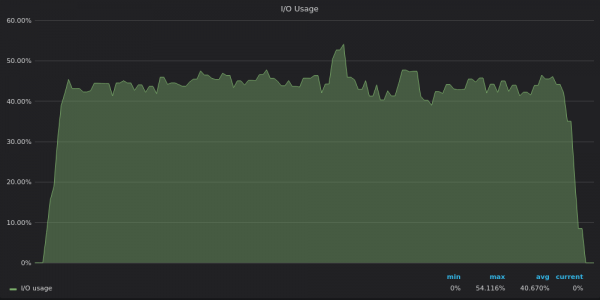
Ovanstående skärmdump: InfluxDB – I/O-användning vid insättningsprov för 400K unika metrik.
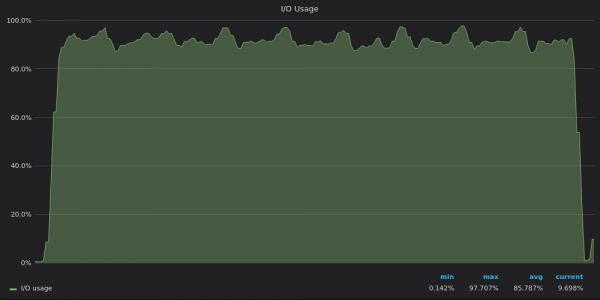
Ovanstående skärmdump: TimescaleDB – I/O-användning vid insättningsprov för 400K unika metrik.
Nu är det klart att TimescaleDB når I/O-gränsen, så den kan inte utnyttja de återstående 12 vCPUs.
4M unika tidsserier
4M tidsserier verkar lite utmanande. Men våra konkurrenter klarar denna prov. Prestandautvärderingarna visar:
- VictoriaMetrics: 2,2M datapunkter per sekund; minnesanvändning: 6 GB; slutlig storlek på data på disken: 3 GB.
- InfluxDB: 330K datapunkter per sekund; minnesanvändning: 20,5 GB; slutlig storlek på data på disken: 18,4 GB.
- TimescaleDB: 480K datapunkter per sekund; minnesanvändning: 2,5 GB; slutlig storlek på data på disken: 52 GB.
Prestandan för InfluxDB minskade från 1,2 miljoner datapunkter per sekund för 400K tidsserier till 330 000 datapunkter per sekund för 4M tidsserier. Detta är en betydande prestationsförlust jämfört med andra konkurrenter. Låt oss titta på CPU-användningsgraferna för att förstå grundorsaken till denna förlust:
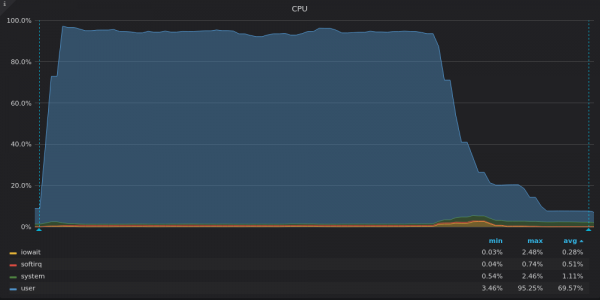
Ovanstående skärmbild: VictoriaMetrics — CPU-användning vid insättningstest för unika tidsserier 4M.
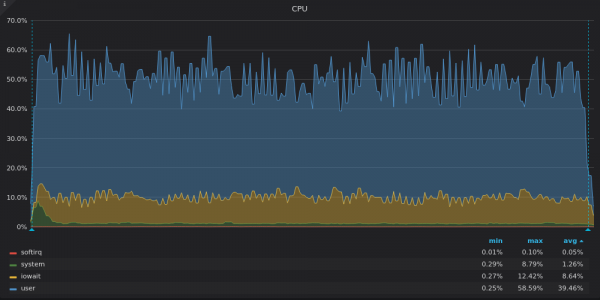
Ovanstående skärmbild: InfluxDB — CPU-användning vid insättningstest för unika tidsserier 4M.
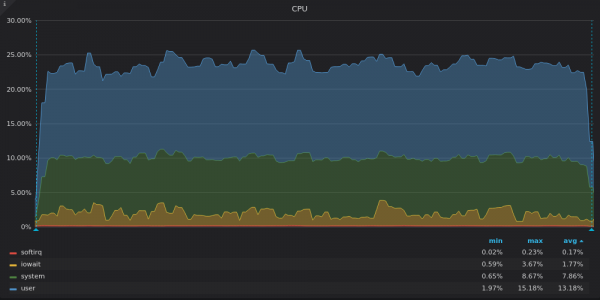
Ovanstående skärmbild: TimescaleDB — CPU-användning vid insättningstest för unika tidsserier 4M.
VictoriaMetrics använder nästan all CPU-kraft. Nedgången i slutet motsvarar de återstående LSM-sammanslagningarna efter att alla data har satts in.
InfluxDB använder endast 8 av 16 vCPU:er, medan TimescaleDB använder 4 av 16 vCPU:er. Vad har deras grafer gemensamt? En hög andel iowait, vilket återigen indikerar en flaskhals i in- och utdata.
TimescaleDB har en hög andel system. Vi misstänker att den höga belastningen ledde till många systemanrop eller många .
Låt oss titta på graferna för diskens genomströmning:
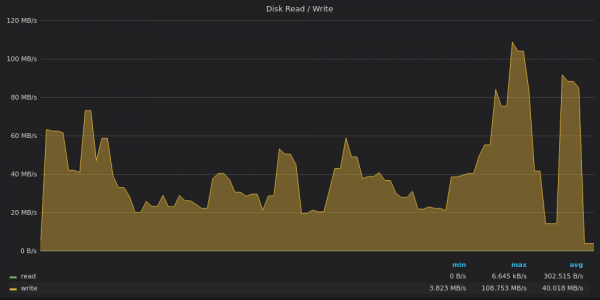
Ovanstående skärmbild: VictoriaMetrics — Användning av disktillämpning för insättning av 4M unika mätvärden.
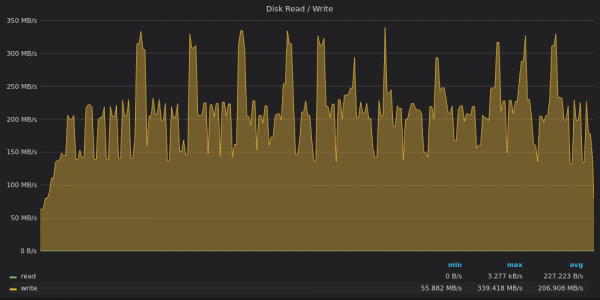
Ovanstående skärmbild: InfluxDB — Användning av disktillämpning för insättning av 4M unika mätvärden.
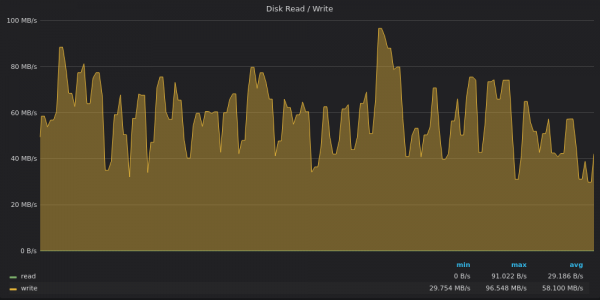
Ovanstående skärmbild: TimescaleDB — Användning av disktillämpning för insättning av 4M unika mätvärden.
VictoriaMetrics nådde gränsen på 120 MB/s i toppen, medan den genomsnittliga skrivhastigheten var 40 MB/s. Det är troligt att det under toppen genomfördes flera tunga LSM-sammanslagningar.
InfluxDB uppnår återigen en genomsnittlig skrivgenomströmning på 200 MB/s med toppar på 340 MB/s på en disk med en skrivgräns på 120 MB/s 🙂
TimescaleDB är inte längre begränsad av disken. Det verkar som att det är begränsat av något annat som rör en hög andel systembelastning CPU-förbrukning.
Låt oss titta på graferna för IO-användning:
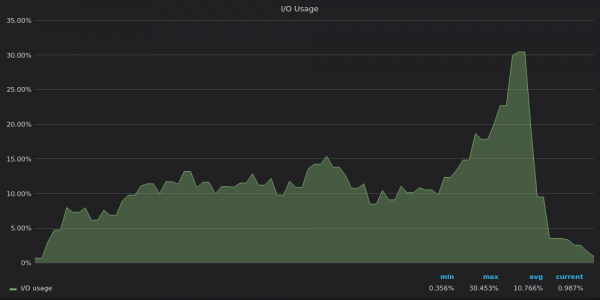
Ovanstående skärmbild: VictoriaMetrics — Användning av in- och utdata under insättningstestet för en unik tidsserie 4M.
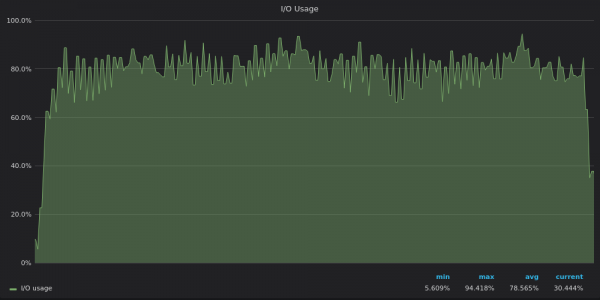
Ovanstående skärmbild: InfluxDB — Användning av in- och utdata under insättningstestet för en unik tidsserie 4M.
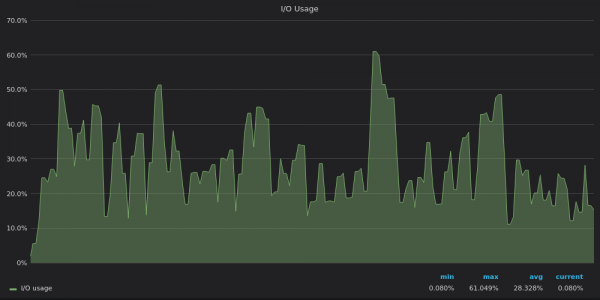
Ovanstående skärmbild: TimescaleDB — Användning av in- och utdata under insättningstestet för en unik tidsserie 4M.
IO-användningsdiagrammen speglar diagrammen för diskbandbreddsanvändning – InfluxDB är begränsad av IO, medan VictoriaMetrics och TimescaleDB har extra IO-resurser.
40M unika tidsserier
40M unika tidsserier var för stora för InfluxDB 🙁
Benchmarkresultat:
- VictoriaMetrics: 1,7M datapunkter per sekund; minnesanvändning: 29 GB; lagringsutrymme: 17 GB.
- InfluxDB: avslutade inte, eftersom det krävdes mer än 60 GB RAM.
- TimescaleDB: 330K datapunkter per sekund, minnesanvändning: 2,5 GB; lagringsutrymme: 84GB.
TimescaleDB uppvisar exceptionellt låg och stabil minnesanvändning – 2,5 GB – samma mängd som för unika metrikvärden 4M och 400K.
VictoriaMetrics ökade långsamt med en hastighet av 100 000 datapunkter per sekund, tills alla 40M metriska namn med etiketter hade behandlats. Sedan nådde den en stabil infogningshastighet på 1,5-2,0M datapunkter per sekund, så det slutliga resultatet blev 1,7M datapunkter per sekund.
Diagrammen för 40M unika tidsserier liknar diagrammen för 4M unika tidsserier, så vi hoppar över dem.
Slutsatser
- Moderna TSDB:er kan hantera insättningar för miljoner unika tidsserier på en enda server. I nästa artikel ska vi undersöka hur väl TSDB:er presterar vid val av miljoner unika tidsserier.
- Otillräcklig CPU-belastning indikerar vanligtvis en flaskhals i IO. Dessutom kan det indikera grov låsning där endast några få trådar kan köras samtidigt.
- Flaskhalsar i IO finns verkligen, särskilt i lagringslösningar utan SSD, som virtualiserade blockenheter från molnleverantörer.
- VictoriaMetrics erbjuder den bästa optimeringen för långsamma lagringslösningar med låg IO. Den ger den bästa hastigheten och komprimeringsgraden.
Ladda ner och prova det på dina data. En relevant statisk binärfil finns tillgänglig på .
Läs mer om VictoriaMetrics i denna .
Uppdatering: en med reproducerbara resultat.
Uppdatering #2: Läs även .
Uppdatering #3: !
Telegram chatt:
Källa: habr.com
