

I dagens läge är det omöjligt att föreställa sig ett projekt baserat på Kubernetes utan ELK-stacken, som används för att spara loggar från både applikationer och systemkomponenter i klustret. I vår praktik använder vi EFK-stacken med Fluentd istället för Logstash.
Fluentd är en modern och mångsidig loggkollektor som vinner allt mer popularitet och har anslutit sig till Cloud Native Computing Foundation, vilket innebär att dess utvecklingsinriktning är fokuserad på användning tillsammans med Kubernetes.
Faktum är att användningen av Fluentd istället för Logstash inte förändrar den övergripande funktionen av programvarusystemet, men Fluentd har sina specifika nyanser, vilket beror på dess mångfunktionalitet.
Till exempel, när vi började använda EFK i ett intensivt projekt med hög loggskrivning, stötte vi på att vissa meddelanden i Kibana visas flera gånger. I denna artikel kommer vi att berätta orsaken till detta fenomen och hur man löser problemet.
Problemet med dubblering av dokument
I våra projekt är Fluentd implementerat som en DaemonSet (startar automatiskt i en instans på varje nod i Kubernetes-klustret) och övervakar stdout-loggar från containrarna i /var/log/containers. Efter insamling och behandling skickas loggarna i form av JSON-dokument till ElasticSearch, antingen i kluster- eller fristående version, beroende på projektets storlek och krav på prestanda och tillförlitlighet. För det grafiska gränssnittet används Kibana.
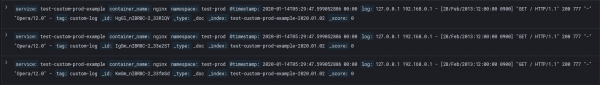
Vid användning av Fluentd med en buffrande plugin vid utgången stötte vi på en situation där vissa dokument i ElasticSearch har helt identiskt innehåll och bara skiljer sig åt i identifieraren. Att säkerställa att detta verkligen är ett meddelande som upprepas kan illustreras med ett exempel från Nginx-loggen. I loggfilen finns detta meddelande en gång:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Men i ElasticSearch finns flera dokument som innehåller detta meddelande:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Dessutom kan det finnas fler än två upprepningar.
Under registreringen av detta problem kan man observera ett stort antal varningar i Fluentd-loggarna med följande innehåll:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] misslyckades med att tömma bufferten. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="kunde inte skicka loggar till Elasticsearch-klustret ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): tid för läsning överskreds"Dessa varningar uppstår när ElasticSearch inte kan returnera ett svar inom den tid som anges i request_timeout, vilket gör att den skickade bufferdelen inte kan rensas. Efter det försöker Fluentd att skicka bufferdelen till ElasticSearch igen och efter ett antal försök lyckas operationen:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] försök lyckades. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] försök lyckades. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] försök lyckades. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] försök lyckades. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] försök lyckades. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Dock uppfattar ElasticSearch varje skickad bufferdel som unik och tilldelar dem unika värden i fälten _id vid indexering. På så sätt uppstår kopior av meddelanden.
I Kibana ser det ut så här:
Lös problemet
Det finns flera alternativ för att lösa detta problem. Ett av dem är den inneboende mekanismen för generering av unika hash-värden för varje dokument som finns i pluginet fluent-plugin-elasticsearch. Om denna mekanism används kommer ElasticSearch att känna igen dubbletter under överföringsstadiet och förhindra duplicering av dokument. Men man måste också ta hänsyn till att denna metod för att lösa problemet bekämpar konsekvenserna och inte eliminerar felet med bristen på timeout, varför vi valde att inte använda den.
Vi använder en buffrande plugin i Fluentd utgången för att förhindra förlust av loggar vid kortvariga nätverksproblem eller ökad loggskrivning. Om ElasticSearch av någon anledning inte omedelbart kan skriva ett dokument till indexet, hamnar dokumentet i en kö som lagras på disken. Därför, för att eliminera källan till problemet som orsakar det ovan beskrivna felet, måste korrekta värden för buffertparametrarna ställas in, så att Fluentds utgångsbuffert har tillräcklig kapacitet och kan rensas inom angiven tid.
Det är värt att notera att värdena för de parametrar som kommer att diskuteras nedan är individuella för varje specifikt fall av buffring i utgångsplugins, eftersom de beror på många faktorer: intensiteten av loggmeddelanden som skrivs av tjänster, prestanda för lagringssystemet, belastning på nätverkskanalen och dess kapacitet. För att få lämpliga men inte överdrivna inställningar för varje specifikt fall, och undvika långvarig blind avkänning, kan man använda den felsökningsinformation som Fluentd skriver till sin logg under drift och relativt snabbt få korrekta värden.
Vid tidpunkten för problemet såg konfigurationen ut på följande sätt:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Under lösningen av problemet justerades följande parameter värden manuellt:
chunk_limit_size — storleken på chunkar som meddelanden bryts ned i i bufferten.
- flush_interval — tidsintervallet för när bufferten rensas.
- queue_limit_length — det maximala antalet chunkar i kön.
- request_timeout — den tid som anslutningen mellan Fluentd och ElasticSearch ställs in på.
Den totala storleken på bufferten kan beräknas genom att multiplicera parametrarna queue_limit_length och chunk_limit_size, vilket kan tolkas som "det maximala antalet chunkar i kön, där varje har en angiven storlek". Om bufferten är för liten, kommer följande varning att visas i loggarna:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] misslyckades med att skriva data i bufferten på grund av buffertöversvämning action=:blockDet betyder att bufferten inte hinner rensa sig inom angiven tid och data som kommer in i den fulla bufferten blockeras, vilket leder till förlust av en del loggar.
Bufferten kan ökas på två sätt: genom att antingen öka storleken på varje chunk i kön eller antalet chunkar som kan vara i kön.
Om storleken på chunk_limit_size sätts till mer än 32 megabyte, kommer ElasticSearch inte att acceptera den, eftersom det inkommande paketet blir för stort. Därför, om bufferten behöver ökas ytterligare, är det bäst att öka den maximala kö-längden queue_limit_length.
När bufferten slutar översvämmas och endast meddelandet om timeout-överskridning kvarstår, kan du börja öka parametern request_timeout. Men om värdet sätts högre än 20 sekunder, kommer följande varningar att visas i Fluentds loggar:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] buffertflush tog längre tid än slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Detta meddelande påverkar inte systemets funktion och innebär att tiden för att rensa bufferten tog längre tid än angivet i slow_flush_log_threshold. Detta är felsökningsinformation och vi använder den när vi ställer in värdet på parametern request_timeout.
Den allmänna algoritmen för justering ser ut på följande sätt:
- Sätt värdet på request_timeout betydligt högre än nödvändigt (hundratals sekunder). Under inställningsperioden kommer det huvudsakliga kriteriet för att korrekt ställa in denna parameter vara att varningarna om timeout-överskridning försvinner.
- Vänta på meddelanden om överskridande av slow_flush_log_threshold. I texten av varningen kommer det verkliga tiden för att rensa bufferten att anges i fältet elapsed_time.
- Ställ in värdet för request_timeout högre än det maximala värdet för elapsed_time som fåtts under observationsperioden. Vi beräknar värdet på request_timeout som elapsed_time + 50%.
- För att ta bort varningar om långsam buffertrensning från loggen kan man höja värdet på slow_flush_log_threshold. Vi beräknar detta värde som elapsed_time + 25%.
De slutgiltiga värdena för dessa parametrar, som tidigare nämnts, är individuella för varje fall. Genom att följa den ovan angivna algoritmen garanterar vi att vi eliminerar felet som leder till dubbletter av meddelanden.
I tabellen nedan visas hur antalet fel per dag som leder till dublika meddelanden förändras under processen att justera värdena för de ovan beskrivna parametrarna:
node-1
node-2
node-3
node-4
Före/Efter
Före/Efter
Före/Efter
Före/Efter
misslyckades med att rensa bufferten
1749/2
694/2
47/0
1121/2
återförsök lyckades
410/2
205/1
24/0
241/2
Det är värt att notera att de inställningar som erhållits kan förlora sin relevans i takt med att projektet växer och, därmed, antalet loggar ökar. Det primära tecknet på otillräcklig inställd tidsgräns är att loggarna i Fluentd visar meddelanden om långsam buffertrensning, det vill säga överskridande av tröskeln slow_flush_log_threshold. Från och med detta ögonblick finns det en liten marginal kvar innan parameter request_timeout överskrids, så det är viktigt att reagera snabbt på dessa meddelanden och upprepa processen för att justera de optimala inställningarna, som beskrivits ovan.
Slutsats
Finjusteringen av utdata bufferten i Fluentd är ett av de viktigaste stegen i konfigurationen av EFK-stacken, som bestämmer stabiliteten i dess arbete och korrekt placering av dokumenten i indexen. Med hjälp av den beskrivna konfigurationsalgoritmen kan man vara säker på att alla loggar kommer att skrivas till ElasticSearch-indexet i rätt ordning, utan dubbletter och förluster.
Läs även andra artiklar i vår blogg:
Källa: habr.com
