

Inledning
Hej!
I denna artikel kommer jag att dela med mig av erfarenheter av att bygga en mikrotjänstarkitektur för ett projekt som använder neurala nätverk.
Vi kommer att diskutera kraven på arkitekturen, titta på olika strukturella diagram, gå igenom var och en av komponenterna i den färdiga arkitekturen samt bedöma de tekniska metrikserna för lösningen.
Trevlig läsning!
Några ord om uppgiften och dess lösning
Huvudidén är att ge en bedömning av en persons attraktivitet baserat på ett foto på en tiogradig skala.
I denna artikel kommer vi att avvika från att beskriva både de använda neurala nätverken och processen för dataförberedelse och inlärning. Men i en av kommande publikationer kommer vi definitivt att återkomma till att analysera pipelinen för bedömning på en djupare nivå.
Just nu kommer vi på en övergripande nivå att gå igenom pipelinen för bedömning och vi kommer att fokusera på interaktionen mellan mikrotjänster i kontexten av projektets övergripande arkitektur.
När vi arbetade med pipelinen för att bedöma attraktivitet, så delades uppgiften upp i följande beståndsdelar:
- Utvinning av ansikten från foton
- Bedömning av varje ansikte
- Rendering av resultatet
Den första löses med hjälp av en förutbildad . För den andra tränades ett konvolutionsnätverk på PyTorch, där en användes som backbone för att balansera ‘kvalitet / hastighet på inferens på CPU’
Funktionsdiagram för bedömningspipen
Analys av kraven på projektets arkitektur
I livscykeln för projektet är faserna för att arbeta med arkitektur och automatisering av distribution av modellen ofta de mest tidskrävande och resurskrävande.
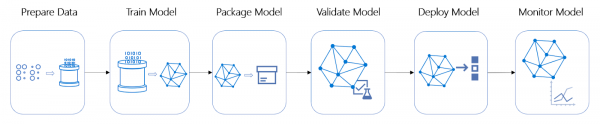
Livscykel för ML-projekt
Detta projekt är inget undantag - beslutet togs att kapsla in bedömningspipen i en online-tjänst, för detta krävdes det att vi dykte ner i arkitekturen. följande grundläggande krav anges:
- Enhetlig loggförvaring - alla tjänster bör skriva loggar på en och samma plats, de bör vara lätta att analysera
- Möjlighet till horisontell skalning av bedömningstjänsten - som den mest troliga flaskhalsen
- Samma mängd processorresurser ska tilldelas för varje bildbedömning - för att undvika avvikelser i tidsfördelningen för inferens
- Snabb (om) distribution av både specifika tjänster och stacken som helhet
- Möjlighet, om så behövs, att använda gemensamma objekt i olika tjänster
Arkitektur
Efter att ha analyserat kraven står det klart att en mikrotjänstarkitektur passar nästan perfekt.
För att undvika överflödig huvudvärk valdes Telegram API som frontend.
Vi börjar med att titta på den strukturella diagrammet för den färdiga arkitekturen, därefter går vi vidare till beskrivningen av varje komponent och formaliserar processen för framgångsrik bildbehandling.
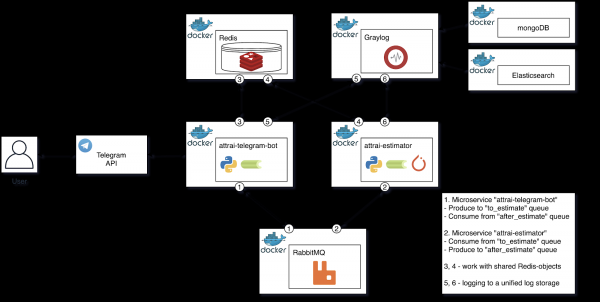
Det strukturella diagrammet för den färdiga arkitekturen
Låt oss gå in mer detaljerat på varje komponent i diagrammet och definiera deras Single Responsibility i processen för bildbedömning.
Mikrotjänsten «attrai-telegram-bot»
Denna mikrotjänst kapslar in all interaktion med Telegram API. Två huvudscenarier kan urskiljas – hantering av användarens bild och hantering av resultatet från bedömningspipeline. Vi går igenom båda scenarierna i allmänhet.
Vid mottagning av ett användarmeddelande med en bild:
- Filtrering genomförs, som består av följande kontroller:
- Närvaron av optimal bildstorlek
- Antalet bilder från användaren som redan finns i kön
- Vid godkänd första filtrering sparas bilden i en dockervolym
- En uppgift produceras i kön "to_estimate", som bland annat innehåller sökvägen till bilden som ligger i vår volym
- Om de ovanstående stegen har genomförts framgångsrikt – får användaren ett meddelande med den uppskattade bearbetningstiden för bilden, baserat på antalet uppgifter i kön. I händelse av fel kommer användaren att informeras tydligt – genom att skicka ett meddelande med information om vad som kan ha gått fel.
Dessutom lyssnar denna mikrotjänst, som celery-arbetare, på kön "after_estimate", som är avsedd för uppgifter som har passerat genom bedömningspipeline.
Vid mottagning av en ny uppgift från "after_estimate":
- Om bilden har bearbetats framgångsrikt – skickar vi resultatet till användaren, om inte – meddelar vi om ett fel.
- Vi tar bort bilden som är resultatet av bedömningspipen.
Mikrotjänsten för bedömning «attrai-estimator»
Denna mikrotjänst är en celery-arbetare och kapslar in allt som rör bedömningspipen för bilden. Arbetsalgoritmen här är en – vi går igenom den.
Vid mottagning av en ny uppgift från "to_estimate":
- Vi kör bilden genom bedömningspipen:
- Vi laddar bilden i minnet
- Justera bilden till önskad storlek
- Identifiera alla ansikten (MTCNN)
- Utvärdera alla ansikten (bunta de identifierade ansiktena från föregående steg och utför inferens med ResNet34)
- Rendera den slutliga bilden
- Rita bounding boxes
- Rita utvärderingarna
- Ta bort användarens (ursprungliga) bild
- Spara utgången från utvärderingspipen
- Lägg till uppgiften i kön “after_estimate”, som lyssnas på av mikrotjänsten “attrai-telegram-bot”
Graylog (+ mongoDB + Elasticsearch)
— är en lösning för centraliserad logghantering. I detta projekt användes det för sitt avsedda syfte.
Valet föll faktiskt på det, istället för den bekanta stacken, på grund av användarvänligheten i Python. Det enda som behövs för att logga i Graylog är att lägga till GELFTCPHandler från paketet till de övriga root logger handlers av vår python-mikrotjänst.
Jag, som en person som tidigare endast arbetat med ELK-stacken, fick totalt sett en positiv upplevelse av att arbeta med Graylog. Det enda som är nedslående är den överlägsenhet i funktioner som Kibana har jämfört med Graylogs webbgränssnitt.
RabbitMQ
— är en meddelandebroker baserad på AMQP-protokollet.
I detta projekt användes den som brokern för Celery och arbetade i hållbar läge.
Redis
— är en NoSQL-databas som arbetar med datatyper av typen "nyckel-värde"
Ibland behöver man använda gemensamma objekt i olika python-mikrotjänster som implementerar vissa datatyper.
Till exempel, i Redis lagras en hashmap av typen "telegram_user_id => antal aktiva uppgifter i kön", vilket gör att antalet förfrågningar från en användare kan begränsas till ett visst värde och därmed förhindra DoS-attacker.
Formaliserar processen för framgångsrik bildbehandling
- Användaren skickar en bild till Telegram-boten
- “attrai-telegram-bot” tar emot meddelandet från Telegram API och analyserar det
- Uppgiften med bilden läggs till i den asynkrona kön “to_estimate”
- Användaren får meddelande med planerad utvärderingstid
- “attrai-estimator” tar uppgiften från kön “to_estimate”, kör den genom utvärderingspipen och producerar uppgiften i kön “after_estimate”
- “attrai-telegram-bot”, som lyssnar på kön “after_estimate”, skickar resultatet till användaren
DevOps
Till sist, efter att ha granskat arkitekturen, kan vi gå vidare till den inte mindre intressanta delen — DevOps
Docker Swarm
— ett kluster system vars funktionalitet är inbyggd i Docker Engine och finns tillgänglig direkt.
Genom hjälp av "svärmen" kan alla noder i vårt kluster delas upp i två typer – worker och manager. På maskiner av den första typen deployas grupper av containrar (stacks), maskiner av den andra typen ansvarar för skalning, balansering och Managern är som standard även en worker.
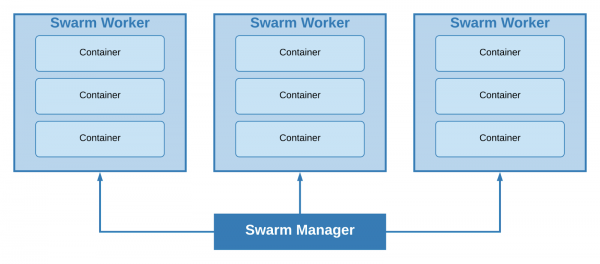
Kluster med en leader manager och tre workers.
Den minsta möjliga storleken på klustret är 1 nod, den enda maskinen kommer att fungera som både leader manager och worker. Baserat på projektets storlek och minimala krav på felöverlevnad beslutades det att använda just denna strategi.
För att gå vidare kan jag säga att sedan den första production-leveransen, som skedde i mitten av juni, har det inte funnits några problem relaterade till denna klusterorganisation (men det betyder inte att en sådan organisation är på något sätt tillåten i medelstora till stora projekt, som har krav på felöverlevnad).
Docker Stack
I "svärmläget" ansvarar för deployeringen av stacks (uppsättningar av docker-tjänster)
Den stöder docker-compose konfigurationer, vilket dessutom möjliggör användning av deploy-parametrar.
Till exempel, med hjälp av dessa parametrar begränsades resurserna på varje instans av mikrotjänsten för bedömning (vi tilldelar N instanser N kärnor, och i själva mikrotjänsten begränsar vi antalet kärnor som används av PyTorch till en).
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Det är viktigt att notera att Redis, RabbitMQ och Graylog är stateful tjänster och det är inte lika enkelt att skala dem som "attrai-estimator".
För att förutspå frågan – varför inte Kubernetes?
Det verkar som att användning av Kubernetes i små och medelstora projekt är en överbelastning, all nödvändig funktionalitet kan erhållas från Docker Swarm, som är ganska användarvänlig för behållarorkestrering och har en låg tröskel för att komma igång.
Infrastruktur
Detta rullades ut på VDS med följande specifikationer:
- CPU: 4 kärnor Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Efter lokal belastningstestning verkade det som att denna maskin skulle vara precis tillräcklig vid ett stort inflöde av användare.
Men direkt efter lanseringen postade jag en länk till en av de mest populära bildtavlorna i CIS (ja, precis den), vilket väckte intresse och under några timmar behandlade tjänsten framgångsrikt tiotusentals bilder. Under peak-ögonblicken användes varken CPU- eller RAM-resurserna ens till hälften.
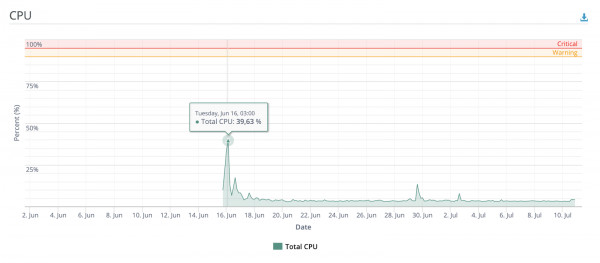
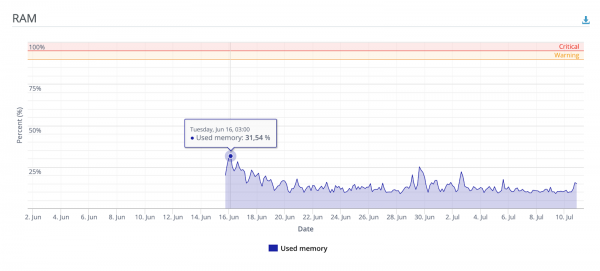
Lite mer grafik
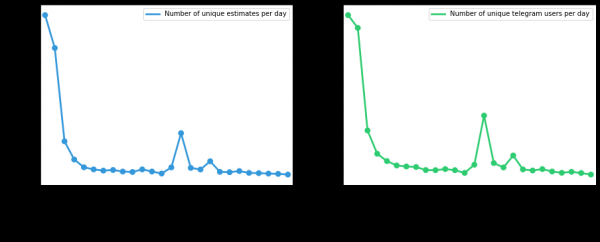
Antalet unika användare och begärningar om bedömning, sedan lanseringen, beroende på dagen
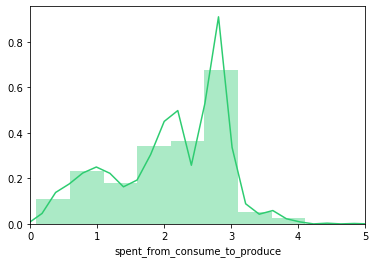
Fördelning av inferenstid för bedömningspipelin
Slutsatser
Sammanfattningsvis kan jag säga att arkitekturen och tillvägagångssättet för orkestrering av containrar fullständigt har bevisat sin värdighet - även under peak-ögonblicken inträffade det inga nedgångar eller förseningar i bearbetningstiden.
Jag tror att små och medelstora projekt som använder realtidsinfernsering av neurala nätverk på CPU framgångsrikt kan adoptera de metoder som beskrivs i denna artikel.
Jag tillägger att artikeln ursprungligen var längre, men för att inte posta en lång läsning beslutade jag att utelämna vissa punkter i denna artikel - vi kommer att återkomma till dem i kommande publikationer.
Du kan testa boten på Telegram - @AttraiBot, den kommer att fungera åtminstone fram till slutet av hösten 2020. Jag påminner om - inga användardata lagras - varken ursprungsbilder eller resultat från bedömningspipelinen - allt raderas efter bearbetning.
Källa: habr.com
