

Jag heter Viktor Yagofarov och jag arbetar med utvecklingen av Kubernetes-plattformen på företaget DomClick som teknisk utvecklingsledare inom Ops-teamet (drift). Jag skulle vilja berätta om hur våra Dev Ops-processer fungerar, om de unika egenskaperna hos en av de största k8s-klustrarna i Ryssland, samt om DevOps/SRE-praktiker som vårt team tillämpar.
Ops-teamet
I Ops-teamet arbetar för närvarande 15 personer. Tre av dem ansvarar för kontoret, två arbetar i en annan tidszon och är tillgängliga, även på natten. På så sätt finns det alltid någon från Ops vid skärmen och är redo att reagera på incidenter av alla svårighetsgrader. Vi har inga nattpass, vilket skyddar vår mentala hälsa och ger alla möjlighet att få tillräckligt med sömn och tillbringa fritiden inte bara framför datorn.
Kompetenserna är varierande: nätverksspecialister, DBA, experter på ELK-stack, Kubernetes-administratörer/utvecklare, övervakningsexperter, virtualisering, hårdvara osv. Det som förenar oss är att var och en av oss kan ersätta den andra till viss del: till exempel, lägga till nya noder i k8s-klustret, uppdatera PostgreSQL, skriva CI/CD-pipelines + Ansible, automatisera något i Python/Bash/Go, koppla ihop hårdvara i datacentret. Starka kompetenser inom ett område hindrar inte att man byter inriktning och börjar utvecklas inom ett annat område. Till exempel började jag på företaget som PostgreSQL-specialist, och nu är mitt huvudansvarsområde Kubernetes-kluster. I teamet uppskattas all tillväxt och känslan av stöd är väldigt stark.
För övrigt rekryterar vi. Kraven på kandidater är ganska standardiserade. Personligen tycker jag att det är viktigt att personen passar in i teamet, är konfliktskör men också kan stå upp för sin åsikt, vill utvecklas och inte är rädd för att göra något nytt, samt att de ger sina egna idéer. Det är också obligatoriskt med programmeringskunskaper i skriptspråk, förståelse för grunderna i Linux och engelska. Engelska behövs helt enkelt så att personen, vid en eventuell nödsituation, kan googla lösningen på problemet på 10 sekunder istället för 10 minuter. Det är nu mycket svårt att hitta specialister med djup kunskap om Linux: det är löjligt, men två av tre kandidater kan inte svara på frågan "Vad är Load Average? Vad består det av?", och frågan "Hur samlar man en core dump från ett C-program" betraktas som något från en supermänniska... eller dinosaurier. Man får acceptera detta, eftersom människor vanligtvis har starka kompetenser på andra områden, och vi kan lära dem "Linux". Svaret på frågan "varför detta är viktigt för en DevOps-ingenjör i dagens molnvärld" får jag lämna utanför artikeln, men om jag ska sammanfatta det med tre ord: allt detta är nödvändigt.
Verktygsteamet
Verktygsteamet spelar en stor roll i automatiseringen. Deras huvuduppgift är att skapa användarvänliga grafiska och CLI-verktyg för utvecklare. Till exempel tillåter vår interna utveckling Confer att man bokstavligen kan rulla ut en applikation i Kubernetes med bara några musklick, ställa in resurser, nycklar från vault etc. Tidigare använde vi Jenkins + Helm 2, men vi var tvungna att utveckla vårt eget verktyg för att utesluta copy-paste och införa enhetlighet i programvarans livscykel.
Ops-teamet skriver inte pipelines för utvecklarna, men kan ge råd i alla frågor angående deras skrivande (några har fortfarande Helm 3).
DevOps
När det kommer till DevOps ser vi det som följer:
Utvecklarteam skriver kod och rullar ut den genom Confer från dev -> qa/stage -> prod. Ansvarigheten för att koden inte saktas ner eller ger fel ligger på utvecklar- och ops-team. Under dagtid ska den jourhavande från Ops-teamet reagera på incidenter med sin applikation, medan under kvälls- och nattetid bör den jourhavande administratören (Ops) väcka den jourhavande utvecklaren om han är säker på att problemet inte ligger i infrastrukturen. Alla metrik och larm i övervakningen uppträder automatiskt eller halvautomatiskt.
Ops ansvarområde börjar från det ögonblick applikationen går live, men även Dev:s ansvar tar inte slut där – vi arbetar med samma saker och är i samma båt.
Utvecklarna konsulterar administratörer om hjälp med att skriva administrativa mikrotjänster (t.ex. Go backend + HTML5), och administratörer konsulterar utvecklarna om infrastrukturella frågor eller frågor relaterade till k8s.
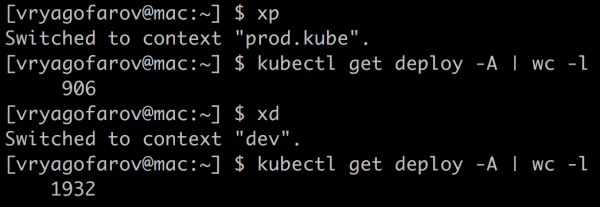
För övrigt har vi överhuvudtaget ingen monolit, bara mikrotjänster. Antalet ligger för närvarande mellan 900 och 1000 i prod k8s-klustret, om man mäter på antal deployment. Antalet pods varierar mellan 1700 och 2000. Det finns för närvarande cirka 2000 pods i prod-klustret.
Jag kan inte ge exakta siffror, eftersom vi övervakar onödiga mikrotjänster och tar bort dem i ett semi-automatiskt läge. Att övervaka onödiga enheter i k8s hjälper oss , vilket sparar resurser och pengar.
Resurshantering
Övervakning
Den grundläggande beståndsdelen i driften av ett stort kluster blir en välbyggd och informativ övervakning. Vi har ännu inte funnit en universell lösning som täcker 100 % av alla önskemål kring övervakning, så vi skapar periodvis olika skräddarsydda lösningar inom detta område.
- Zabbix. Den gamla goda övervakningen, som är avsedd, framför allt, för att spåra det övergripande tillståndet i infrastrukturen. Den meddelar oss när en nod faller på grund av CPU, minne, diskar, nätverk etc. Inget överkomplicerat, men vi har också en separat DaemonSet med agenter genom vilka vi till exempel övervakar tillståndet för DNS i klustret: vi letar efter segande pods av coredns, kontrollerar åtkomligheten av externa värdar. Man kan tycka att det är onödigt att krångla med det, men vid stora trafikvolymer är denna komponent en allvarlig punkt för avbrott. Jag har tidigare , kämpat med DNS-prestanda i klustret.
- Prometheus Operator. En uppsättning olika exporters ger en god översikt över alla komponenter i klustret. Sedan visualiserar vi allt detta på stora dashboards i Grafana, och för aviseringar använder vi alertmanager.
Ett annat användbart verktyg för oss har blivit . Vi skrev det efter att vi flera gånger stött på en situation där ett team blockerar ett annat teams Ingress, vilket orsakade 50x-fel. Nu kontrollerar utvecklarna innan live-deployment att ingen påverkas, och för mitt team är det ett bra verktyg för att initialt diagnostisera problem med Ingress. Det är lustigt att det först skrevs för administratörer och såg ganska "klumpigt" ut, men efter att verktyget blev populärt bland utvecklingsteamen, förändrades det kraftigt och började se ut mer som "en administratör gjorde ett webbgränssnitt för administratörer". Snart kommer vi att överge detta verktyg och liknande situationer kommer att valideras redan innan pipeline-utrullningen.
Teamresurser i "Kuben"
Innan vi går in på exemplen, är det värt att förklara hur vi arbetar med resursallokering för mikrotjänster.
För att förstå vilka team och i vilka mängder de använder sina resurser (processor, minne, lokal SSD) tilldelar vi varje team sitt eget namnrymd i "Kuben" och begränsar dess maximala kapaciteter för processor, minne och disk, efter att ha diskuterat teamens behov. Således blockerar ett team, i allmänhet, inte hela klustret för deployment genom att allokera tusentals kärnor och terabyte minne. Åtkomsten i namespace ges genom AD (vi använder RBAC). Namespace och deras gränser läggs till genom en pull-begäran i GIT-repositoriet, och därefter distribueras allt automatiskt genom Ansible-pipeline.
Exempel på resursallokering för ett team:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Begärningar och gränser
I "Kuben" Begäran – är det den mängd garanterade reserverade resurser för pod (en eller flera Docker-containrar) i klustret. Limit – är den ogaranterade maxgränsen. Det går ofta att se på grafer hur ett team ställt in för många begärningar för sina applikationer och inte kan deploya applikationen i "Kuben", eftersom alla begärningar i deras namespace redan är "förbrukade".
Den rätta lösningen på en sådan situation: att titta på det faktiska resursutnyttjandet och jämföra det med den begärda mängden (Request).
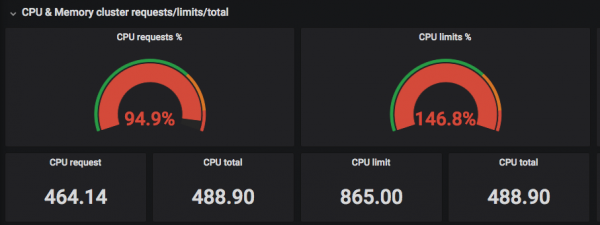
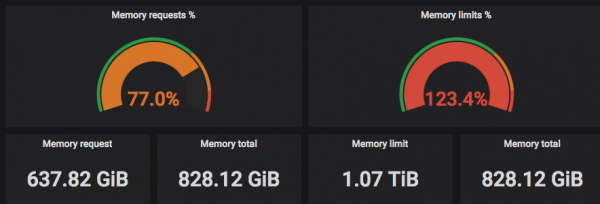
På skärmdumparna ovan kan man se att "begärda" (Requested) CPU:er närmar sig det faktiska antalet trådar, medan Limits kan överstiga det verkliga antalet CPU-trådar =)
Låt oss nu ta en närmare titt på ett namespace (jag valde namespace kube-system – systemnamnrymd för komponenterna i "Kuben") och se förhållandet mellan faktisk processoranvändning och minne i förhållande till begärt:
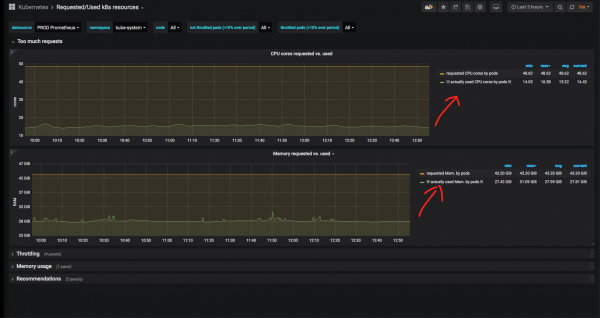
Det är uppenbart att minne och CPU reserveras för systemtjänster i betydligt större utsträckning än vad som faktiskt används. I fallet med kube-system är detta berättigat: det har förekommit att nginx ingress controller eller nodelocaldns i toppar har nått CPU-gränsen och använt mycket RAM, därför är den här reserveringen motiverad. Dessutom kan vi inte förlita oss på diagrammen från de senaste 3 timmarna: det är önskvärt att se historiska mätvärden över en längre tidsperiod.
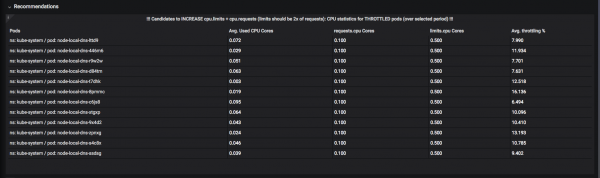
Ett system för "rekomendationer" har utvecklats. Till exempel kan man här se vilka resurser som skulle ha nytta av att höja "gränserna" (den övre tillåtna gränsen) för att förhindra "throttling": stunden när en redan har använt CPU eller minne under sin tilldelade tidskvant och väntar på att bli "avfrostat":
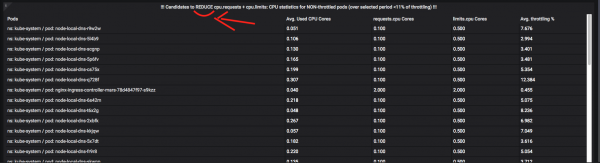
Och här är pods som bör moderera sina begärningar:
Om throttling + resursövervakning kan skrivas inte i en utan många artiklar, så ställ frågor i kommentarerna. Kort sagt kan jag säga att uppgiften att automatisera sådana metoder är ganska komplicerad och kräver mycket tid och balans med "fönster"-funktioner och "CTE" i Prometheus / VictoriaMetrics (dessa termer är inom citat eftersom det i PromQL nästintill inte finns något som liknar det, och det krävs att skapa skrämmande frågor på flera skärmar av text och arbeta med deras optimering).
I slutändan har utvecklarna verktyg för att övervaka sina namespaces i "Kuben", och de kan själva besluta var och när de kan "skära ner" resurser för vilka applikationer, och vilka pods som kan få hela CPU:n under natten.
Metodologier
I företaget, som nu är trendy, följer vi DevOps- och SRE-praktiker. När företaget har 1000 mikrotjänster, cirka 350 utvecklare och 15 administratörer för hela infrastrukturen, måste man "vara trendy": bakom alla dessa "buzzwords" döljer sig ett akut behov av att automatisera allt och ingen ska vara flaskhals i processerna.
Som Ops tillhandahåller vi olika mätvärden och instrumentpaneler för utvecklarna, kopplade till servicen svarstid och deras fel.
Vi använder sådana metodologier som: , och , genom att kombinera dem. Vi försöker minimera antalet instrumentpaneler så att det med ett enda ögonkast är tydligt vilken tjänst som just nu degraderas (till exempel svarskoder per sekund, svarstid enligt 99:e percentilen), och så vidare. Så snart nya metrik behövs för gemensamma instrumentpaneler ritar vi dem och lägger till dem.
Jag har inte ritat några diagram på en månad. Kanske är det ett bra tecken: det betyder att de flesta av "önskemålen" redan har förverkligats. Det har hänt att jag åtminstone en gång om dagen under en vecka har ritat något nytt diagram.
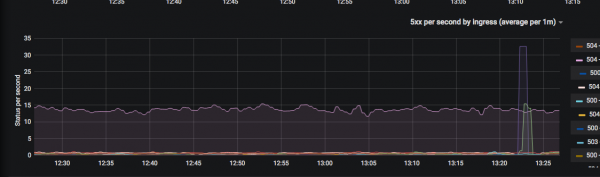
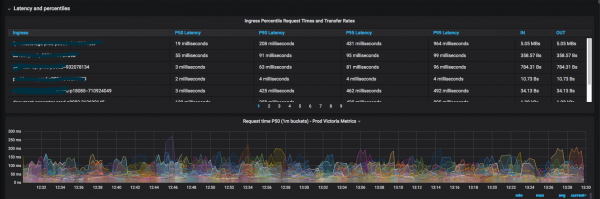
Det skapade resultatet är värdefullt eftersom utvecklarna numera sällan går till administratörerna med frågor om "var man kan se en viss metrik".
Implementering Service Mesh är inte långt borta och bör underlätta livet för alla av oss, kollegor från Tools är redan nära att implementera den abstrakta "Istio för den friska personen": livscykeln för varje HTTP(s)-begäran kommer att synas i övervakningen, och det kommer alltid att vara möjligt att förstå "vid vilket steg allt gick snett" vid tjänsteinteraktion (och inte bara). Prenumerera på nyheter från Hubben på DomKlick. =)
Stöd för Kubernetes-infrastruktur
Historiskt sett har vi använt en patchad version Kubespray – Ansible-roll för distribution, utvidgning och uppdatering av Kubernetes. Vid något tillfälle togs stödet för non-kubeadm installationer bort från huvudgrenen, och övergången till kubeadm föreslogs inte. Som ett resultat gjorde företaget Southbridge sin egen fork (med stöd för kubeadm och snabb fix av kritiska problem).
Processen för att uppdatera alla k8s-kluster ser ut så här:
- Vi hämtar Kubespray från Southbridge, jämför med vår gren, slår samman.
- Vi rullar ut uppdateringen i Stress-"Kuben".
- Vi utför uppdateringen en nod i taget (i Ansible är detta "serial: 1") i Dev-"Kuben".
- Uppdaterar Prod på lördag kväll en nod åt gången.
I framtiden finns planer på att ersätta Kubespray med något snabbare och övergå till kubeadm.
Totalt har vi tre "Kuber": Stress, Dev och Prod. Vi planerar att starta en till (hot standby) Prod-"Kub" i det andra datacentret. Stress och Dev bor i "virtuella maskiner" (oVirt för Stress och VMWare cloud för Dev). Prod-"Kuben" lever på "bar hårdvara": det är identiska noder med 32 CPU-trådar, 64-128 GB minne och 300 GB SSD RAID 10 — totalt finns det 50 stycken. Tre "smala" noder är avsatta för "master" Prod-"Kuben": 16 GB minne, 12 CPU-trådar.
För produktion föredrar vi att använda "bar hårdvara" och undviker onödiga lager som OpenStack: vi behöver inga "bullriga grannar" och CPU steal timeOch dessutom ökar komplexiteten i administrationen med ungefär det dubbla vid in-house OpenStack.
För CI/CD av "Kubernetes" och andra infrastrukturskomponenter använder vi en separat GIT-server, Helm 3 (vi övergick ganska smärtsamt från Helm 2, men är mycket glada över alternativet atomic), Jenkins, Ansible och Docker. Vi älskar feature-brancher och deploy i olika miljöer från ett och samma repository.
Slutsats
Så här, i stora drag, ser processerna för DevOps ut på företaget DomClick från en driftingsenjörs perspektiv. Artikeln blev mindre teknisk än vad jag förväntade mig: så håll utkik efter nyheter från DomClick på Habra: det kommer fler "hårdvaru"-artiklar om Kubernetes och mer.
Källa: habr.com
