

Under de senaste sex månaderna har jag arbetat med att skapa ett system för att bekämpa bedrägerier (fraudulent activity, fraud, etc.) utan någon initial infrastruktur för detta. Dagens idéer som vi har hittat och implementerat i vårt system hjälper oss att upptäcka många bedrägerier och analysera dem. I den här artikeln vill jag berätta om de principer som vi följde och vad vi gjorde för att uppnå det nuvarande tillståndet i vårt system, utan att gå in på den tekniska delen.
Principerna för vårt system
När du hör sådana termer som "automatic" och "fraud" börjar du troligtvis tänka på maskininlärning, Apache Spark, Hadoop, Python, Airflow och andra teknologier i Apache Foundations ekosystem och Data Science-området. Jag tror att det finns en aspekt av att använda dessa verktyg som oftast inte nämns: de kräver att vissa förutsättningar finns i ditt företags system innan du börjar använda dem. Kort sagt, du behöver en företagsdataplattform som inkluderar ett datalager och en databas. Men vad gör du om du inte har en sådan plattform och ändå behöver utveckla denna praktik? De följande principerna som jag berättar om nedan hjälpte oss att nå en punkt där vi kan fokusera på att förbättra våra idéer istället för att leta efter lösningar. Ändå är detta inte projektets "platå". Det finns fortfarande mycket kvar att göra ur både teknisk och produktiv synvinkel.
Princip 1: värde för verksamheten först
I centrum för alla våra insatser satte vi "värde för verksamheten". Generellt sett tillhör alla system för automatisk analys gruppen av komplexa system med hög automatiseringsgrad och teknisk svårighet. Att skapa en komplett lösning kommer att ta väldigt lång tid om du bygger den från grunden. Vi valde att prioritera affärsvärdet före teknisk fullständighet. I praktiken innebär detta att vi inte ser avancerad teknik som en dogm. Vi väljer den teknologi som fungerar bäst för oss just nu. Med tiden kan det visa sig att vi behöver implementera om vissa moduler. Detta är kompromissen vi har accepterat.
Princip 2: Förstärkt intelligens (augmented intelligence)
Jag slår vad om att de flesta människor som inte är djupt involverade i utvecklingen av maskininlärningslösningar kan tro att målet är att ersätta människor. I själva verket är maskininlärningslösningar långt ifrån perfekta och ersättning är endast möjlig inom vissa områden. Vi övergav denna idé från början av flera skäl: obalanserade data om bedrägerier och oförmågan att tillhandahålla en uttömmande lista över funktioner för maskininlärningsmodeller. I stället valde vi en lösning med förstärkt intelligens. Detta är ett alternativt koncept av artificiell intelligens som fokuserar på AI:s stödjande roll, vilket understryker att kognitiva teknologier är avsedda att förbättra mänsklig intelligens snarare än att ersätta den. [1]
Med detta i åtanke skulle utvecklingen av en komplett maskininlärningslösning från grunden kräva enorma ansträngningar, vilket skulle försena skapandet av värde för vårt företag. Vi beslutade att bygga ett system med en iterativt växande aspekt av maskininlärning under vägledning av våra ämnesexperter. Den tuffa delen av att utveckla ett sådant system är att det måste ge våra analytiker fall inte bara utifrån om det är bedrägligt beteende eller ej. Generellt sett är varje avvikelse från kundernas beteende ett misstänkt fall som specialisterna behöver undersöka och på något sätt reagera på. Endast en del av dessa registrerade fall kan verkligen klassificeras som bedrägeri.
Princip 3: plattform för omfattande analysdata
Den mest utmanande delen av vårt system är den övergripande arbetsflödeskontrollen. Analytiker och utvecklare måste enkelt kunna hämta dataset från tidigare perioder med alla de mätvärden som användes för analys. Dessutom måste dataplattformen tillhandahålla ett enkelt sätt att komplettera befintliga uppsättningar av mätningar med nya. Processerna vi skapar, vilket inte bara gäller programvaruprocesser, måste möjliggöra en enkel omräkning av tidigare perioder, lägga till nya mätvärden och justera dataprognoser. Vi skulle kunna uppnå detta genom att lagra all data som vår produktionssystem genererar. I så fall skulle datan gradvis bli ett hinder. Vi skulle behöva lagra en växande mängd data som vi inte använder, och skydda dem. I detta scenario skulle datan med tiden bli alltmer irrelevanta, men ändå kräva våra ansträngningar för att hanteras. För oss var datalagring meningslös, och vi bestämde oss för att använda en annan strategi. Vi valde att organisera datalager i realtid kring de målobjekt vi vill klassificera och endast lagra den data som behövs för att kontrollera de senaste och mest aktuella perioderna. Komplexiteten i dessa ansträngningar ligger i att vårt system är heterogent med flera datalager och programmoduler som kräver noggrant planering för att fungera konsekvent.
Konstruktiva koncept för vårt system
Vi har fyra grundläggande komponenter i vårt system: insamlingssystemet (ingestion system), beräkningssystemet (computational), analys (BI analysis) och spårningssystemet (tracking system). De tjänar specifika isolerade syften, och vi håller dem isolerade genom att följa specifika utvecklingsmetoder.
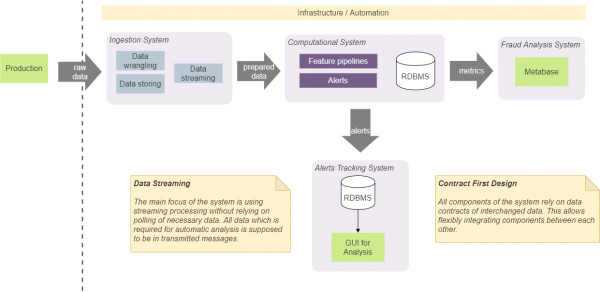
Design baserad på kontrakt
Först och främst kom vi överens om att komponenterna endast ska förlita sig på specifika datainsamlingsstrukturer (kontrakt) som överförs mellan dem. Detta möjliggör enkel integration mellan dem och tvingar inte en specifik sammansättning (eller ordning) av komponenterna. Till exempel i vissa fall möjliggör detta att vi direkt kan integrera mottagningssystemet med varningsspårningssystemet. I så fall kommer det att göras i enlighet med det överenskomna kontraktet för varningar. Detta betyder att båda komponenterna kommer att integreras med hjälp av ett kontrakt som kan användas av vilken annan komponent som helst. Vi kommer inte att lägga till ett extra kontrakt för tillägg av varningar i spårningssystemet från inmatningssystemet. Denna metod kräver att ett förutbestämt minimum av kontrakt används och förenklar systemet och kommunikationen. I grund och botten använder vi ett angreppssätt som kallas 'Contract First Design' och tillämpar det på kontrakt för datastreaming. [2]
Streaming överallt
Att spara och hantera tillstånd i systemet kommer oundvikligen att leda till komplexitet i dess implementering. I allmänhet bör tillståndet vara tillgängligt från alla komponenter, det bör vara konsekvent och ge det mest aktuella värdet till alla komponenter, och det bör vara pålitligt med korrekta värden. Dessutom ökar förekomsten av anrop till permanent lagring för att hämta det senaste tillståndet antalet in- och utmatningsoperationer och komplexiteten i algoritmerna som används i våra realtidspipelines. Därför beslutade vi att ta bort lagring av tillstånd, så långt det är möjligt, från vårt system. Denna metod kräver att alla nödvändiga data inkluderas i den överförda datablocket (meddelandet). Om vi till exempel behöver beräkna det totala antalet vissa observationer (antalet operationer eller fall med vissa egenskaper) beräknar vi det i minnet och genererar en ström av sådana värden. Beroende moduler kommer att använda partitionering och batchning för att dela upp strömmen i entiteter och arbeta med de senaste värdena. Denna metod eliminerade behovet av att ha en permanent diskbaserad lagring för sådana data. Vårt system använder Kafka som meddelandebroker, och det kan användas som en databas med KSQL. [3] Men dess användning skulle starkt koppla vår lösning till Kafka, och vi beslutade att inte använda det. Den metod vi har valt möjliggör att ersätta Kafka med en annan meddelandebroker utan allvarliga interna förändringar av systemet.
Detta koncept innebär inte att vi inte använder diskbaserade lagringar och databaser. För att verifiera och analysera systemets prestanda behöver vi lagra en betydande mängd data på disken som representerar olika mått och tillstånd. En viktig punkt här är att realtidsalgoritmerna inte är beroende av sådana data. I de flesta fall använder vi de lagrade data för självständig analys, felsökning och spårning av specifika fall och resultat som systemet ger.
Problem med vårt system
Det finns vissa problem som vi har löst till en viss nivå, men de kräver mer genomtänkta lösningar. Just nu skulle jag bara vilja nämna dem här, eftersom varje punkt förtjänar en egen artikel.
- Vi måste fortfarande definiera processer och policys som bidrar till insamling av meningsfull och relevant data för vår automatiska analys, upptäckts- och forskningsdata.
- Integreringen av resultat från mänsklig analys i processen för automatisk systemkonfiguration för att uppdatera den med de senaste uppgifterna. Detta handlar inte bara om att uppdatera vår modell utan också om att uppdatera processerna och förbättra förståelsen av våra data.
- Att hitta balansen mellan en deterministisk IF-ELSE-ansats och ML. Någon sa: "ML är ett verktyg för de förtvivlade". Det betyder att du kommer att vilja använda ML när du inte längre förstår hur du ska optimera och förbättra dina algoritmer. Å andra sidan tillåter inte den deterministiska ansatsen upptäckten av anomalier som inte förutsågs.
- Vi behöver ett enkelt sätt att testa våra hypoteser eller korrelationer mellan mätvärdena i datan.
- Systemet måste ha flera nivåer av verkligt positiva (true positive) resultat. Bedrägerifall är bara en del av alla fall som kan betraktas som positiva för systemet. Till exempel vill analytiker få alla misstänkta fall för granskning, och bara en liten del av dem är bedrägeri. Systemet bör effektivt tillhandahålla alla fall för analytiker oavsett om det handlar om verkligt bedrägeri eller bara misstänkt beteende.
- Dataplattformen måste tillåta åtkomst till datamängder från tidigare perioder med beräkningar som skapats och beräknats i realtid.
- Enkelt och automatiskt implementera någon av systemets komponenter i minst tre olika miljöer: produktionsmiljö, experimentell (beta) och för utvecklare.
- Och sist men inte minst, vi behöver skapa en omfattande plattform för prestandatestning där vi kan analysera våra modeller. [4]
Länkar
Källa: habr.com
