

Vi går igenom grunderna för loggning i Docker och Kubernetes, och därefter diskuterar vi två verktyg som kan användas på produktion: Grafana Loki och EFK-stacken (Elasticsearch + Fluent Bit + Kibana).
Innehållet i artikeln är en sammanfattning från . Om det finns ett intresse och särskilt ett produktionsbehov kan du gå en fullständig utbildning — anmäl dig till kursen om .
Loggning i Docker
På Kubernetes-nivå körs applikationer i pods, men på en lägre nivå fungerar de vanligtvis i Docker. Därför behöver vi konfigurera loggningen så att vi samlar loggar från containrar. Eftersom Docker startar containrarna måste vi förstå hur loggningen fungerar på Docker-nivå.
Jag hoppas att varje läsare vet: applikationsloggar ska skrivas till stdout/stderr, och inte inuti containern. Loggarna aggregeras av Docker Daemon, och den arbetar bara med de loggar som skickas till stdout/stderr. Dessutom medför det att skriva loggar inuti containern problem: containern sväller av den växande loggen (eftersom det troligen inte finns någon Logrotate i containern), och Docker Daemon har ingen aning om denna logg.
Docker har flera loggdrivrutiner eller plugins för att samla loggar från containrar. I den gratisversionen Docker Community Edition (CE) finns det färre loggdrivrutiner än i den kommersiella Docker Enterprise Edition (EE).
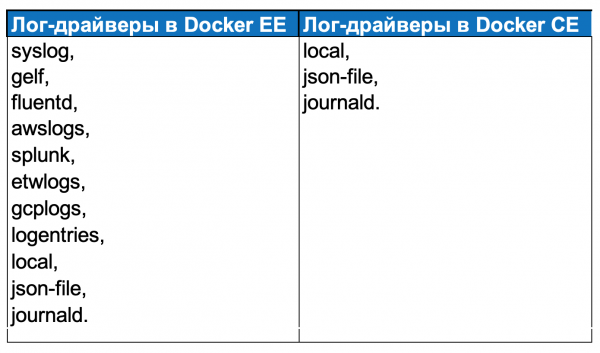
Jag har aldrig använt Docker EE i praktiken: på Southbridge försöker vi hålla oss till Open Source-lösningar, och dessutom behöver våra kunder inte de flesta av de extra funktionerna i Docker EE.
Loggdrivrutiner i Docker CE:
local — skrivning av loggar till interna filer i Docker Daemon;
json-file — skapande av json-loggar i varje containers mapp;
journald — skicka loggar till journald.
Inställningarna för loggning i Docker finns i filen daemon.json.
I fältet 'log-driver' anger man pluginen, och i fältet 'log-opts' — dess inställningar. I exemplet ovan är pluginen 'json-file' angiven, med en loggstorleksbegränsning — 'max-size': '10m'; begränsningen för antal filer (roteringsinställningar) — 'max-file': '3'; samt värden som kommer att knytas till loggarna.
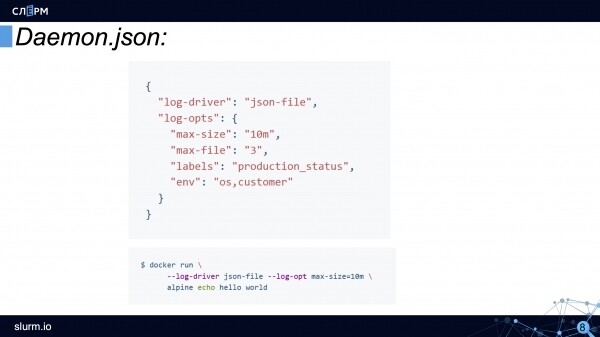
Vissa inställningar för loggdrivrutinen kan anges via kommandoradsverktyget. Detta är praktiskt om en särskild container måste startas med en annan loggdrivrutin.
Så här ser loggningsschemat ut i Docker:
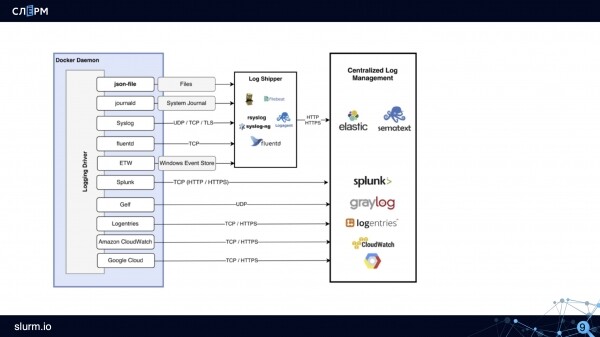
Så här fungerar schemat: loggdrivrutinen, till exempel json-file, skapar filer. Loggsamlare (Rsyslog, Fluentd, Logagent och andra) samlar dessa filer och överför dem för lagring i Elastic, Sematext eller andra lagringslösningar.
Egenskaper för loggning i Kubernetes
Förenklat ser loggningen i Kubernetes ut så här: det finns en pod, i vilken en container körs, och containern skickar loggar till stdout/stderr. Sedan skapar Docker en fil och skriver loggarna, som kan roteras sedan.
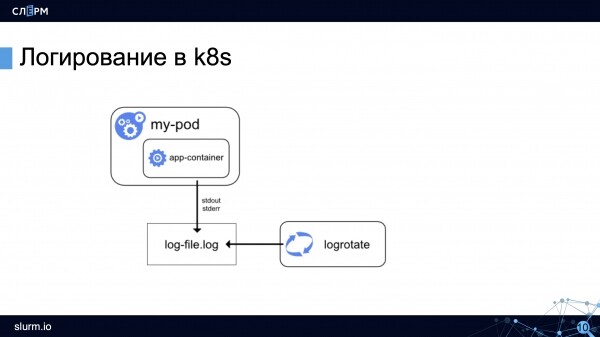
Låt oss överväga egenskaperna hos loggning i Kubernetes.
Spara loggar mellan distributioner. Detta är ett obligatoriskt villkor för korrekt loggning. Om loggar inte sparas mellan distributionerna, kommer loggarna från den tidigare versionen att skrivas över vid en ny version av applikationen, och om containern startas om kan det också medföra förlust av loggar. Kubernetes har en nyckel — previous, som låter oss se loggarna från applikationen före den senaste omstarten av Pod, men inte djupare.
Aggreggera loggar från alla instanser. Om mikrotjänster hostas i molnet är det molnleverantören som ansvarar för systemets övervakning. Om mikrotjänsterna ligger på egen hårdvara måste vi förutom loggar från containrar också samla loggar från systemet.
Tidigare fanns det inga bra verktyg för att samla loggar både från systemet och från mikrotjänster. Vanligtvis använde ett verktyg för att samla systemloggar (till exempel Rsyslog), och ett annat — loggar från Docker (till exempel journal-bit med inställningen av loggdrivrutinen Docker till journald). Vi försökte använda journal-bit — för att samla loggar både från containrar (i loggdrivrutinen Docker ange att loggar ska skrivas till journald) och från systemet (i CentOS 7 finns redan systemd och journald). Lösningen fungerar, men är inte perfekt. Om det finns många loggar börjar journal-bit att lagga och meddelanden går förlorade.
Experimenten fortsatte — och en annan metod hittades. I CentOS 7 dupliceras de huvudsakliga systemloggarna (messages, audit, secure) i var-log som filer. I Docker kan loggar också konfigureras för att sparas i json-filer. Därmed kan dessa filer från CentOS 7 och Docker samlas in tillsammans.
Med tiden blev ELK Stack-lösningen populär. Det är en kombination av flera verktyg: Elasticsearch, Logstash och Kibana.
Elasticsearch lagrar loggar från containrar, Logstash samlar loggar från instanser, och Kibana möjliggör bearbetning av de mottagna loggarna, och skapandet av grafer baserat på dem. Under en tid använde man aktivt ELK Stack, men enligt min åsikt passerar dess tid. Jag kommer senare att berätta varför.
Lägg till metadata. Pods, applikationer och containrar kan köras överallt. Dessutom kan ett enda program ha flera instanser. Loggarna skrivs i ett och samma format, och vi måste kunna förstå vilken replika som skriver vilken logg och i vilket namespace den befinner sig. Därför behöver loggarna metadata.
Analysera loggar. Det är intressant, men kostnaderna för att stödja logg- och övervakningssystemet kan överstiga kostnaderna för själva applikationen. När du har tiotusentals och hundratusentals loggar per sekund känns det rimligt, men du måste ändå känna till gränsen. Ett sätt att hitta denna gräns är att analysera loggar.
Som regel behöver du inte samla in och lagra alla loggar; du bör endast skicka en del för lagring — till exempel loggar med status "warning" eller "error". Om det handlar om loggar från nginx eller ingress-kontrollanter kan du endast skicka loggar vars status skiljer sig från 200. Men detta är inte ett universellt råd: om du bygger någon form av analys på Nginx-loggar, bör du uppenbarligen samla in dem.
Att blint filtrera loggar rekommenderas inte, eftersom de filtrerade data kan vara otillräckliga för en normal analys. Å andra sidan kan det vara värt att utföra analys på metriknivå istället för loggningsnivå. Då behöver du inte lagra hundratusentals rader med kod 200. En av metoderna är att få information om trafik och fel från metrik-data från ingress-kontrollanter.
Generellt sett krävs det en noggrann eftertanke: vad vill du lagra och hur länge, annars uppstår en situation där loggningssystemet tar mer resurser än huvudprojektet.
Det finns fortfarande ingen standardlösning för loggning. Till skillnad från övervakning, där det finns en mest spridd lösning, Prometheus, finns det ingen standard inom loggning.
I denna föreläsning kommer vi att granska två verktyg: ett populärt och ett som vinner mark. Förutom dem finns det fler, men i denna artikel kommer vi inte att beröra dem.
Med tanke på alla ovan nämnda egenskaper kan loggning i Kubernetes nu framställas i följande schema:
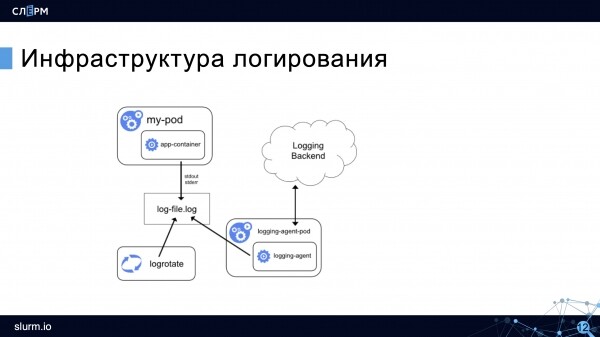
Det kvarstår en logg från containern och rotation, men en agent-samlare dyker upp som plockar upp loggarna och skickar dem för lagring (i schemat — till Logging Backend). Agenten körs på varje nod och är vanligtvis igång i Kubernetes.
Låt oss nu titta på verktygen för loggning.
Grafana Loki
har dykt upp nyligen men har redan blivit ganska välkänt. Dess fördelar: enkel installation, låg resursanvändning, ingen installation av Elasticsearch krävs eftersom den lagrar data i TSDB (tidsseriedatabas). I den tidigare artikeln skrev jag att Prometheus lagrar data i en sådan databas och det är en av många likheter mellan de två produkterna. Utvecklarna hävdar till och med att Loki är "Prometheus för loggningens värld".
Ett kort avbrott om TSDB för dem som inte har läst. : TSDB hanterar utmärkt lagring av stora mängder data och tidsserier, men är inte avsedd för långvarig lagring. Om du av någon anledning behöver lagra loggar längre än två veckor, är det bäst att konfigurera överföring till en annan databas.
En annan fördel med Loki är att Grafana används för att visualisera data. Mycket bekvämt: i Grafana kan vi se övervakningsdata och där även, genom att ansluta Loki, se loggar. Diagrams kan byggas baserat på loggar.
Arkitekturen för Loki ser ungefär ut så här:
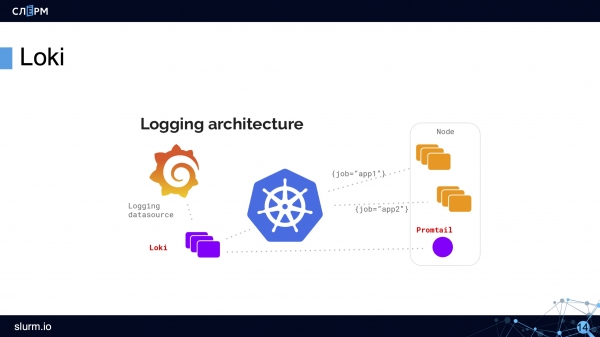
Med hjälp av DaemonSet deployeras en agent – Promtail eller Fluent Bit – på alla servrar i klustret. Agenten samlar loggar. Loki hämtar dem och lagrar dem i TSDB. Metadata läggs omedelbart till loggarna, vilket är praktiskt: man kan filtrera efter Pods, namespaces, container-namn och till och med etiketter.
Loki fungerar i det bekanta gränssnittet Grafana. Loki har till och med ett eget frågespråk, som kallas LogQL – namnet och syntaxen liknar PromQL i Prometheus. I Loki-gränssnittet finns det tips med frågor, så det är inte nödvändigt att kunna dem utantill.
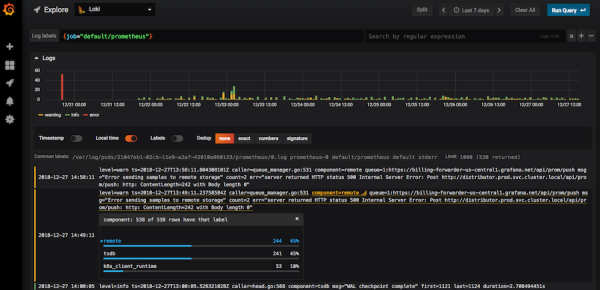
Loki i Grafana-gränssnittet
Genom att använda filter kan man i Loki hitta koder ("400", "404" och alla andra); se loggar från hela noden; filtrera bort alla loggar som innehåller ordet "error". Om du klickar på en logg kommer en kortinformation med all information om händelsen att öppnas.
I Loki finns det tillräckligt med verktyg för att hämta de nödvändiga loggarna, även om det är sant att det tekniskt sett kunde ha funnits fler. Just nu utvecklas Loki aktivt och blir mer populärt.
Elastic + Fluent Bit + Kibana (EFK Stack)
EFK-stapeln är en mer klassisk och samtidigt mycket populär loggningslösning.
I början av artikeln nämndes ELK (Elasticsearch + Logstash + Kibana), men detta stack har blivit föråldrat på grund av Logstashs ineffektivitet och resurskrav. Istället har man börjat använda den lättare och mer effektiva Fluentd, och efter en tid fick den sällskap av — en ännu lättare och ännu mer effektiv insamlingsagent.
Om vi ska tro på utvecklarna, så är Fluent Bit mer än 100 gånger bättre i prestanda än Fluentd: "där Fluentd använder 20 MB RAM, kommer Fluent Bit att använda 150 kB" — ett direkt citat från dokumentationen. Med detta i åtanke har Fluent Bit börjat användas mer frekvent.
Fluent Bit har färre funktioner än Fluentd, men uppfyller de grundläggande behoven, så vi använder huvudsakligen Fluent Bit.
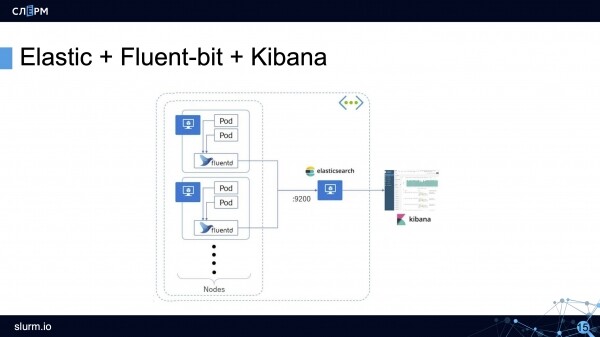
Arbetsflödet för EFK-stacken: agenten samlar loggar från alla poddar (vanligtvis en DaemonSet som körs på alla servrar i klustret) och skickar dem till lagring (Elasticsearch, PostgreSQL eller Kafka). Kibana ansluter till lagringen och hämtar all nödvändig information.
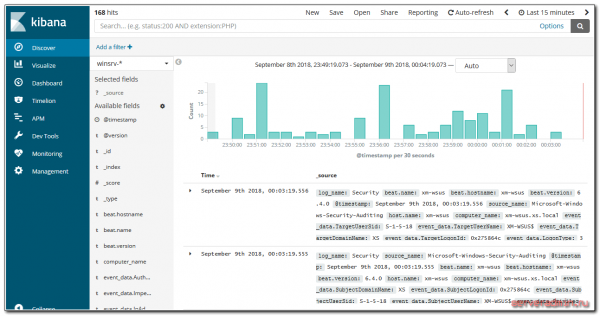
presenterar informationen i ett bekvämt webbgränssnitt. Det finns diagram, filter och mycket mer.
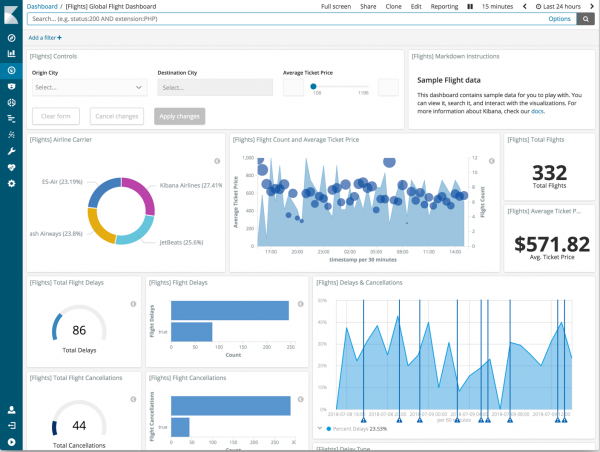
Baserat på loggar kan man skapa hela instrumentpaneler.
Möjligheterna hos Fluent Bit
Eftersom Fluent Bit vanligtvis är mindre känt än Logstash, ska vi titta lite närmare på det. Fluent Bit kan logiskt delas in i 6 moduler, och vissa av modulerna kan utökas med plugins som ökar dess funktioner.
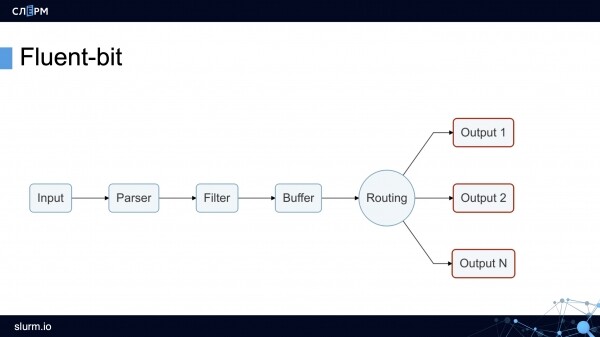
Input-modulen samlar in loggar från filer, systemd-tjänster och även från tcp-socket (det är bara att ange en endpoint, så börjar Fluent Bit hämta därifrån). Dessa möjligheter är tillräckliga för att samla loggar både från systemet och från containrar.
I produktion använder vi oftast plugins (det kan riktas mot en mapp med loggar) och (man kan säga åt det från vilka tjänster som ska samla loggar).
Parser-modulen anpassar loggar till ett gemensamt format. Som standard är Nginx-loggar strängar. Med hjälp av en plugin kan denna sträng omvandlas till JSON: specificera fält och deras värden. Det är mycket enklare att arbeta med JSON än med strängloggar, eftersom man får mer flexibla sorteringsmöjligheter.
Filter-modulen. På denna nivå filtreras oönskade loggar bort. Till exempel skickas endast loggar med värdet "warning" eller med specifika etiketter till lagring. De utvalda loggarna går till bufferten.
Buffer-modulen. Fluent Bit har två typer av buffertar: minnesbuffert och diskbuffert. Bufferten är ett tillfälligt lager för loggar som behövs vid fel eller krascher. Alla vill spara på RAM, så diskbuffert väljs vanligtvis. Men det är viktigt att notera att loggarna fortfarande laddas upp till minnet innan de sparas på disken.
Routing/Output-modulen innehåller regler och adresser för att skicka loggar. Som nämnts kan loggar skickas till Elasticsearch, PostgreSQL eller till exempel Kafka.
Intressant nog kan loggar från Fluent Bit skickas till Fluentd. Då den förstnämnda är mer lättviktig och mindre funktionell kan loggar samlas in och skickas till Fluentd, där de kan bearbetas ytterligare med hjälp av extra plugins och skickas till lagringsplatser.
Om du planerar att använda Elasticsearch…
Avslutningsvis två tips för dem som planerar att använda Elasticsearch som logglagring i produktion.
- Konfigurera aviseringar med hjälp av . Detta program plockar ut viktiga meddelanden från den allmänna loggströmmen och skickar alerts via e-post eller andra kanaler. Tyvärr har det nyligen kommit .
- Rota loggar med hjälp av applikationen eller genom att anropa Elasticsearch API. I princip gör Elastic nu betydande framsteg när det gäller att hantera livscykeln av index utan att använda externa verktyg. Generellt sett finns det ingen mening med att lagra loggar länge: det är osannolikt att någon logg kommer att behövas efter två veckor — om den verkligen är kritisk, kommer den med största sannolikhet att ha bearbetats inom två veckor. I värsta fall kan gamla loggar arkiveras och skickas någonstans för långtidslagring. Jag har hört talas om speciella loggar som enligt lag måste förvaras i upp till 5 år. Jag har personligen inte stött på det, men jag skulle inte jämföra sådan information med vanliga loggar, och kanske till och med förvara dem separat.
Fortsättning följer…
Författare: Marcel Ibraev, certifierad Kubernetes-administratör, praktiserande ingenjör på företaget , talare och kursutvecklare .
Källa: habr.com
