

VictoriaMetrics – en snabb och skalbar databashanteringssystem för lagring och bearbetning av tidsseriedata (en post bildar tid och en uppsättning värden kopplade till den tiden, till exempel erhållna genom periodisk avläsning av sensorstatus eller insamling av mätvärden).
Jag heter Pavel Kolobayev. DevOps, SRE, LeroyMerlin, allting som kod – det handlar om oss: om mig och om andra anställda på LeroyMerlin.
Det finns ett moln baserat på OpenStack. Där finns en liten länk till teknikradarn.
Det är byggt på Kubernetes-hårdvara samt alla tillhörande tjänster till OpenStack och loggning.
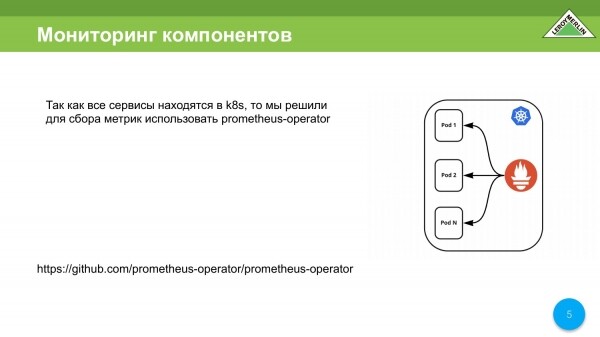
Så här såg vår plan ut under utvecklingen. När vi utvecklade detta hade vi en Prometheus-operator som lagrade data inne i själva K8s-klustret. Den hittar automatiskt det som behöver skrapas och lägger det, grovt sagt, vid sina fötter.
All data måste vi flytta utanför Kubernetes-klustret, för om något händer måste vi förstå vad och var.
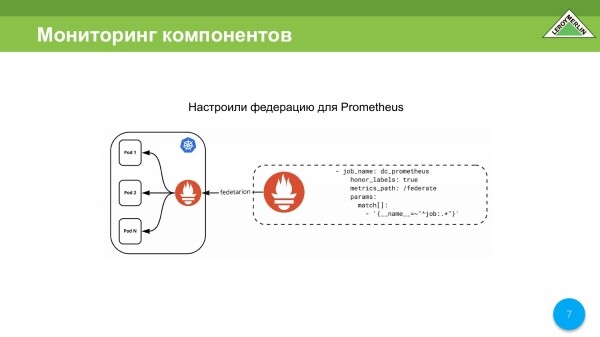
Den första lösningen – vi använder federation, när vi har en extern Prometheus som går in i Kubernetes-klustret via en federation.
Men här uppstår små problem. I vårt fall började problemen när vi hade 250 000 mätvärden, och när det blev 400 000 mätvärden insåg vi att vi inte kunde arbeta så. Vi ökade scrape_timeout till 25 sekunder.
Varför var vi tvungna att göra detta? Prometheus börjar räkna ner timeout-tiden från början av hämtningen. Det spelar ingen roll att datan fortfarande flödar. Om datan inte har flödat under den angivna tidsperioden och sessionen inte stängs via http, så anses sessionen misslyckad och datan går inte in i Prometheus.
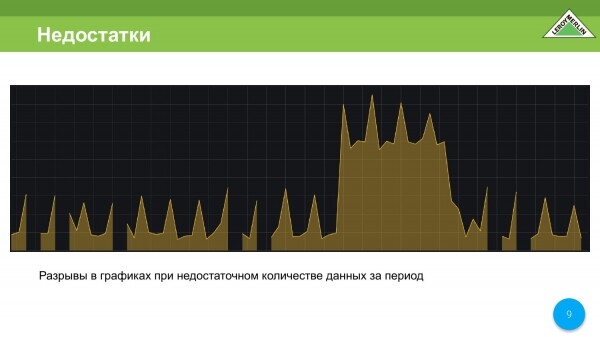
Alla känner igen graferna som vi får när delar av datan saknas. Graferna är hackiga och det är oacceptabelt för oss.
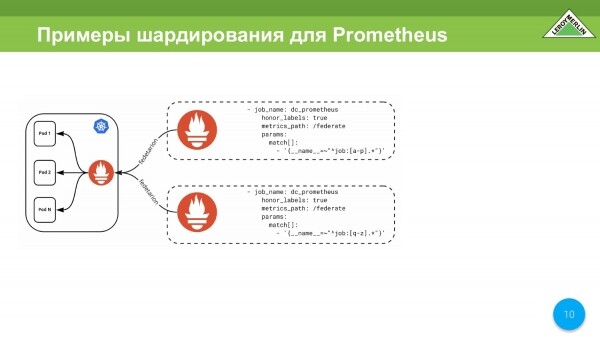
Det nästa alternativet – är shardning baserat på två olika Prometheus via samma federation.
Till exempel, att helt enkelt ta och shardera dem efter namn. Det är också möjligt att använda, men vi beslutade att gå vidare.
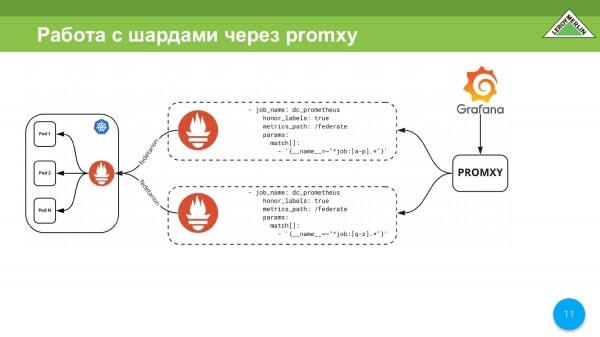
Vi måste nu på något sätt hantera dessa shards. Vi kan ta promxy, som går till shardområdet, multiplicerar datan. Den fungerar med två shards som en enda ingångspunkt. Detta kan implementeras via promxy, men det är fortfarande för komplicerat.
Det första alternativet – vi vill avstå från federationmekanismen eftersom den är mycket långsam.
Utvecklarna av Prometheus säger tydligt: "Grabbar, använd andra TimescaleDB, eftersom vi inte kommer att stödja långtidslagring av mätvärden". Det är inte deras uppgift. 
Vi antecknar på papperslappar att vi faktiskt behöver exportera data för att inte lagra allt på ett ställe.
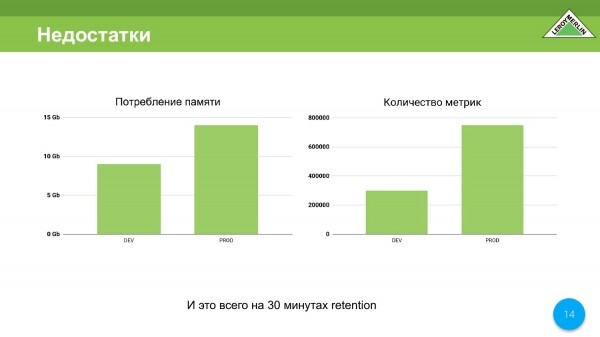
Den andra nackdelen är minnesförbrukningen. Ja, jag förstår att många kommer att säga att ett par gigabyte minne är billigt nu år 2020, men ändå.
Just nu har vi en dev- och en prod-miljö. I dev är det cirka 9 gigabyte för 350 000 mätvärden. I prod är det lite över 14 gigabyte för 780 000 mätvärden. Retentiontiden är endast 30 minuter. Det är dåligt. Och jag ska förklara varför.
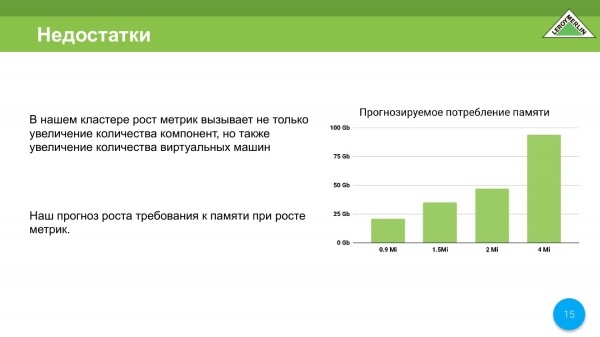
Vi gör beräkningar, det vill säga, vid en och en halv miljon mätvärden, vilket vi redan är nära, får vi under designfasen 35-37 gigabyte minne. Men vid 4 miljoner mätvärden krävs det redan omkring 90 gigabyte minne. Det här har beräknats enligt den formel som utvecklarna av Prometheus tillhandahåller. Vi har granskat korrelationen och förstått att vi inte vill betala flera miljoner för en server bara för övervakning.
Vi kommer inte bara att öka antalet maskiner, vi övervakar även de virtuella maskinerna själva. Så ju fler virtuella maskiner, desto fler olika mätvärden och så vidare. Vi kommer att ha en speciell tillväxt av vår kluster vad gäller mätvärden.
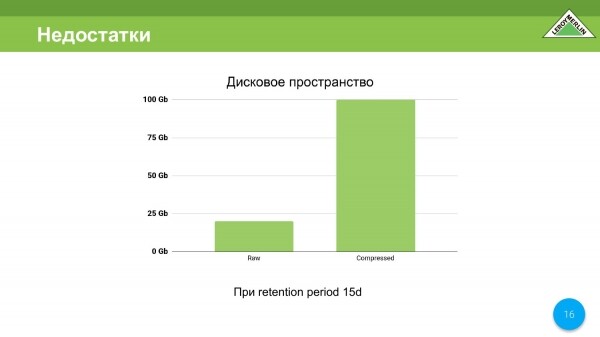
Det är inte så illa med lagringsutrymmet här, men vi skulle vilja förbättra det. Vi har fått totalt 120 gigabyte under 15 dagar, varav 100 är komprimerade data och 20 är okomprimerade data, men man vill alltid ha mindre.
Därför skriver vi ner ännu en punkt – det handlar om stor resursförbrukning som vi ändå vill spara på, eftersom vi inte vill att vår övervakningskluster ska konsumera mer resurser än vår kluster som hanterar OpenStack.
Det finns en annan nackdel med Prometheus som vi har identifierat, och det är att det åtminstone finns något minnesbegränsning. Med Prometheus är det mycket värre eftersom det inte finns några sådana justeringsmöjligheter. Att använda begränsningar i Docker är inte heller ett alternativ. Om din RAF skulle krascha och det finns 20-30 gigabyte, kommer det att ta väldigt lång tid att återhämta sig.
Detta är ytterligare en anledning till varför Prometheus inte passar oss, det vill säga att man inte kan begränsa minnesanvändningen.
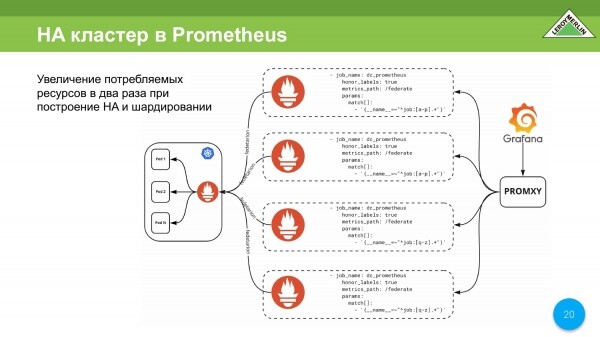
Vi skulle kunna gå till en sådan lösning. Denna lösning behövs för att organisera en HA-kluster. Vi vill att våra mätvärden alltid ska vara tillgängliga oavsett plats, även om servern som lagrar dessa mätvärden kraschar. Därför måste vi bygga en sådan lösning.
Denna lösning säger att vi kommer att ha redundanta shardar och därmed också redundanta kostnader för resursanvändning. Den kan nästan skalas horisontellt, men resursförbrukningen kommer att vara enorm.
Nackdelarna i tur och ordning såsom vi har skrivit ner dem:
- Det krävs att vi exporterar mätvärdena externt.
- Hög resursförbrukning.
- Det går inte att begränsa minnesanvändningen.
- Komplex och resurskrävande implementering av HA.
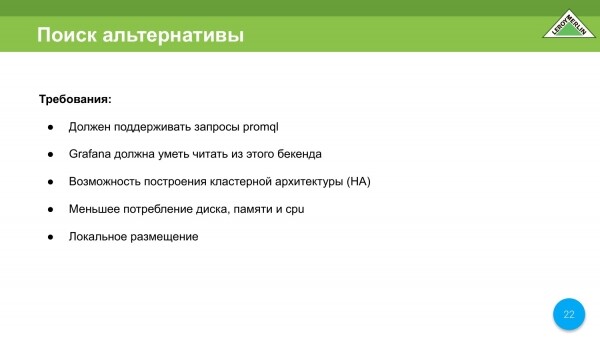
Vi har beslutat att vi går bort från Prometheus som lagring.
Vi har definierat ytterligare krav som vi behöver. Det är:
- Stöd för promql, eftersom det redan finns mycket skrivet för Prometheus: frågor, larm.
- Och vidare har vi Grafana, som också är skriven för Prometheus som backend. Vi vill inte behöva skriva om våra dashboards.
- Vi vill bygga en robust HA-arkitektur.
- Vi vill minska konsumtionen av alla resurser.
- Det finns en liten detalj. Vi kan inte använda olika typer av molnsystem för mätinsamling. Vi vet inte vad som kommer att försvinna i dessa mätvärden för tillfället. Eftersom allt möjligt kan hamna där, är vi tvungna att begränsa oss till lokala installationer.
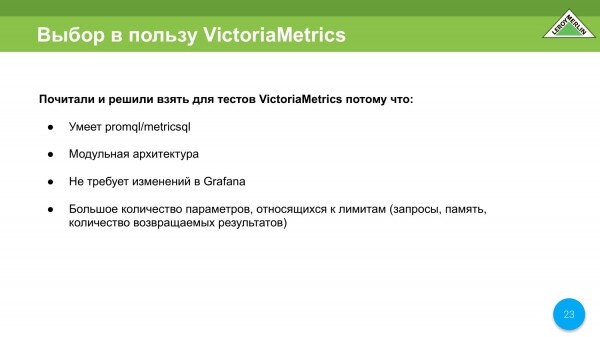
Valen var få. Vi samlade allt där vi hade erfarenhet. Vi tittade på Prometheus sida under integration, läste en massa artiklar och såg vad som fanns. För oss valde vi VictoriaMetrics som ersättning för Prometheus.
Varför? För att:
- Den kan hantera promql.
- Den har en modulär arkitektur.
- Den kräver inga ändringar i Grafana.
- Och viktigast av allt – vi kommer förmodligen att erbjuda mätvärdenas lagring inom vårt företag som en tjänst, därför tittar vi redan på att begränsa olika typer av användningar så att användarna kan använda klustrets resurser på ett begränsat sätt, eftersom det finns en möjlighet att den kommer att vara multitenancy.
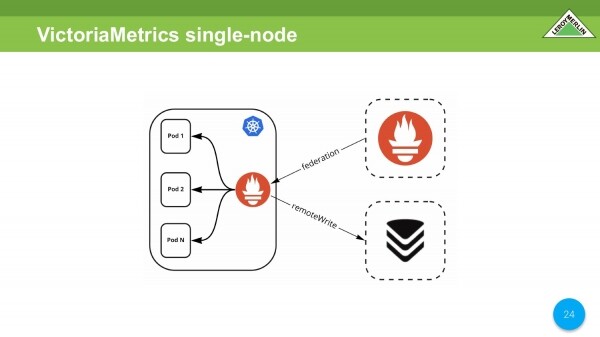
Vi gör våra första jämförelser. Vi tar samma Prometheus inom klustret, där den externa Prometheus kopplar upp sig. Vi lägger till VictoriaMetrics via remoteWrite.
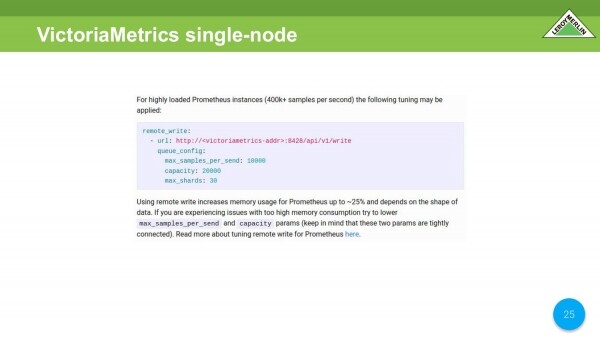
Jag nämner direkt att vi här har upplevt en liten ökning av CPU-användningen från VictoriaMetrics. På VictoriaMetrics wiki står det vilka parametrar som passar bäst. Vi har kontrollerat dem. De minskade CPU-användningen mycket bra.
I vårt fall ökade minnesanvändningen för Prometheus, som finns i Kubernetes-klustret, inte nämnvärt.
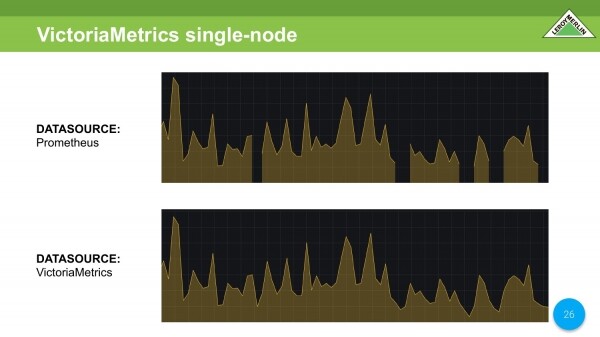
Vi jämför två datakällor med samma data. I Prometheus ser vi alla de saknade data. I VictoriaMetrics ser allt bra ut.
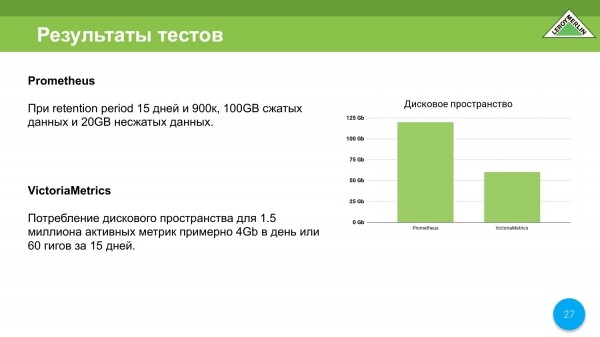
Testresultat med avseende på lagringsutrymme. Vi fick totalt 120 gigabyte i Prometheus. I VictoriaMetrics får vi redan 4 gigabyte per dag. Det är en något annorlunda mekanism än vad vi är vana vid i Prometheus. Det vill säga, data komprimeras ganska bra på en dag, på en halvtimme. De är redan väl komprimerade på en dag, på en halvtimme, trots att det senare kommer att sammanfoga data. Resultatet är att vi har sparat på lagringsutrymme.
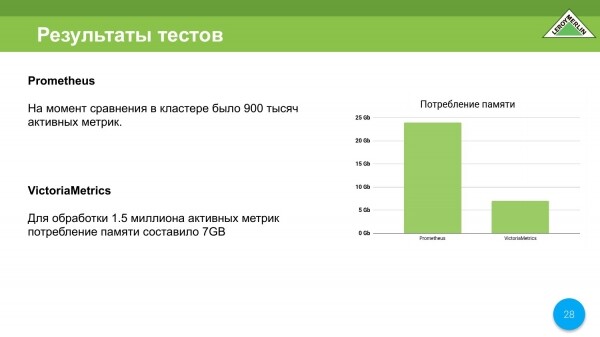
Vi sparar också på minnesanvändning. Vid testtillfället kördes Prometheus på en virtuell maskin – 8 kärnor, 24 gigabyte. Prometheus tar nästan allt. Den föll plötsligt på OOM Killer. Vid det tillfället hade den knappt 900 000 aktiva metrikor. Det handlar om cirka 25 000-27 000 metrikor per sekund.
VictoriaMetrics kördes på en tvåkärnig virtuell maskin med 8 gigabyte RAM. Vi lyckades få VictoriaMetrics att fungera bra genom att justera några saker på den 8-gigabyte maskinen. Resultatet blev att vi höll oss inom 7 gigabyte. Vi fick en högre hastighet på innehållsleveransen, det vill säga metrikor, än Prometheus.
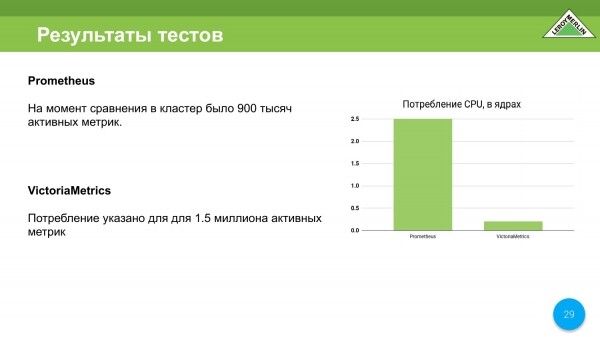
CPU-användningen förbättrades avsevärt jämfört med Prometheus. Här använder Prometheus 2,5 kärnor, medan VictoriaMetrics bara använder 0,25 kärnor. Vid starten – 0,5 kärnor. Vid sammanfogningen når den upp till en kärna, men det är extremt sällan.
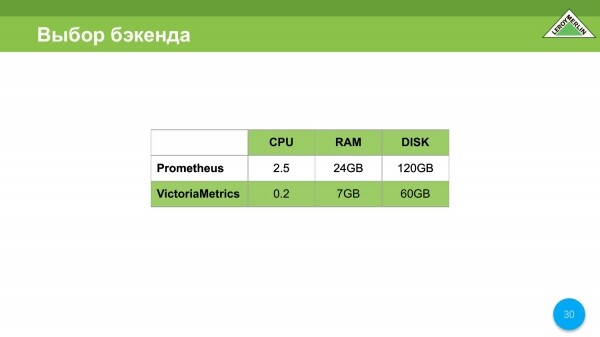
I vårt fall föll valet på VictoriaMetrics av uppenbara skäl, vi ville spara och vi har sparat.
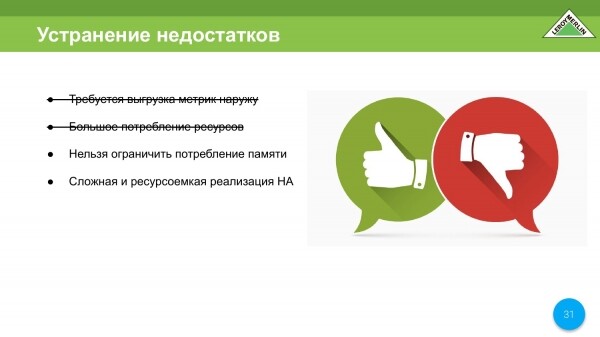
Vi eliminerar direkt två punkter – det är export av metrikor och hög resursanvändning. Vi har kvar två punkter att lösa för oss själva.
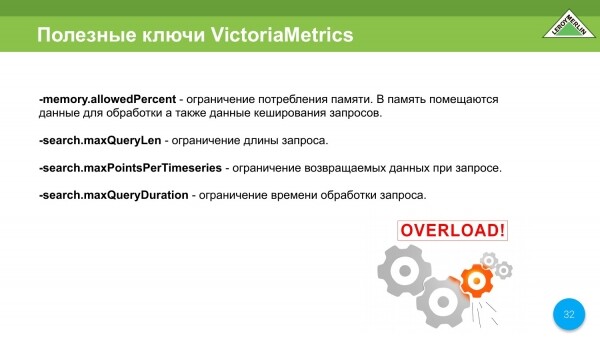
Här nämner jag direkt att vi ser VictoriaMetrics som en metriklagring. Eftersom vi troligen kommer att erbjuda VictoriaMetrics som lagring för hela Leroy, behöver vi begränsa dem som kommer att använda detta kluster, så att de inte tynger det.
Det finns en fantastisk parameter som gör det möjligt att begränsa tid, datamängd och exekveringstiden.
Det finns också ett utmärkt alternativ som gör det möjligt att begränsa minnesanvändningen, vilket gör att vi kan hitta den balans som ger oss en normal arbetshastighet och måttlig resursanvändning.
En minuspunkt, dvs. vi stryker punkt – det går inte att begränsa minnesanvändningen.
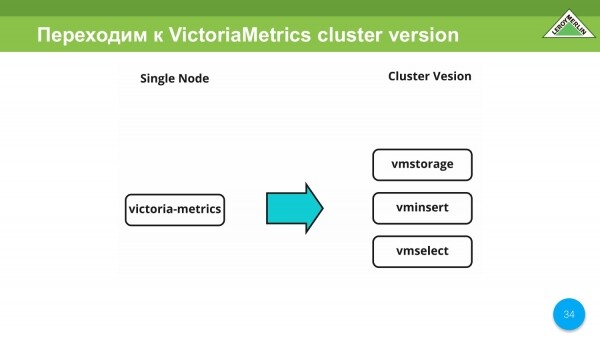
I de första iterationerna testade vi VictoriaMetrics Single Node. Därefter går vi vidare till VictoriaMetrics Cluster Version.
Här får vi möjlighet att separera olika tjänster i VictoriaMetrics beroende på vad de körs på och vilka resurser de förbrukar. Det är en mycket flexibel och praktisk lösning. Vi har använt den själva.
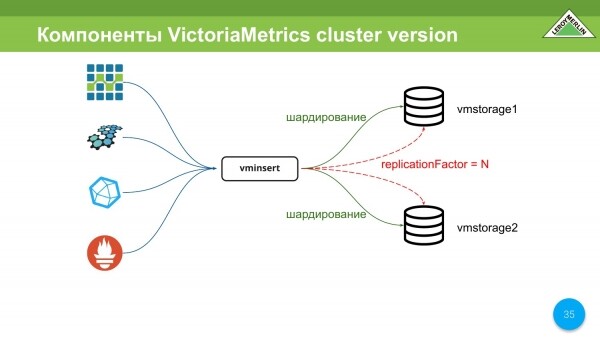
De huvudsakliga komponenterna i VictoriaMetrics Cluster Version är vmstorage. Det kan finnas N antal. I vårt fall har vi för närvarande 2.
Och det finns vminsert. Det är en proxyserver som gör det möjligt för oss att: anordna sharding mellan alla storages som vi informerat den om, och den erbjuder också repliker, dvs. ni får både sharding och repliker.
Vminsert stöder protokollen OpenTSDB, Graphite, InfluxDB och remoteWrite från Prometheus.
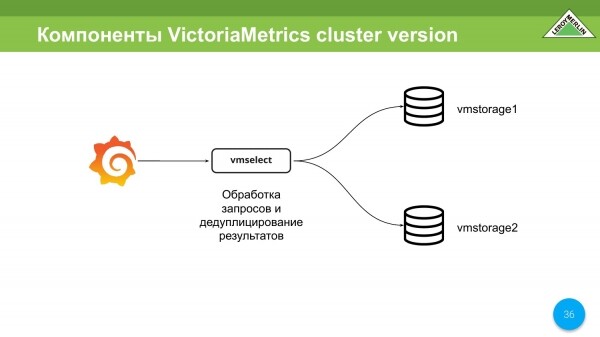
Det finns också vmselect. Dess huvuduppgift är att hämta data från vmstorage, deduplicera dessa data och ge dem till klienten.
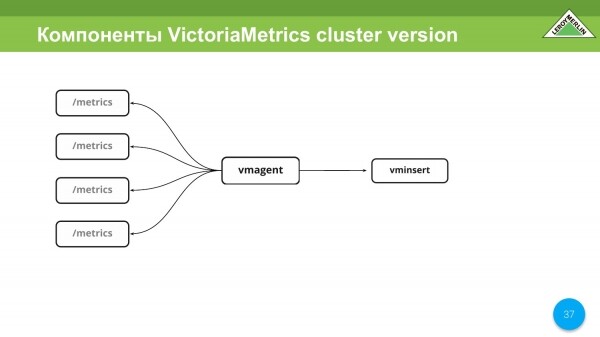
Det finns en fantastisk funktion som heter vmagent. Vi gillar den mycket. Den gör det möjligt att konfigurera precis som Prometheus och fungerar på exakt samma sätt som Prometheus. Dvs. den samlar in metrics från olika entiteter och tjänster och skickar dem till vminsert. Allt beror sedan på er.
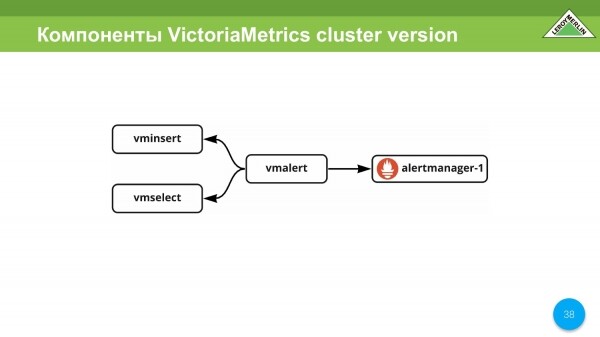
En annan fantastisk tjänst är vmalert, som används som backend för VictoriaMetrics, tar emot data från vminsert och skickar de bearbetade data till vmselect. Den hanterar själva alerterna samt reglerna. Vid alerter får vi ett alert genom alertmanager.
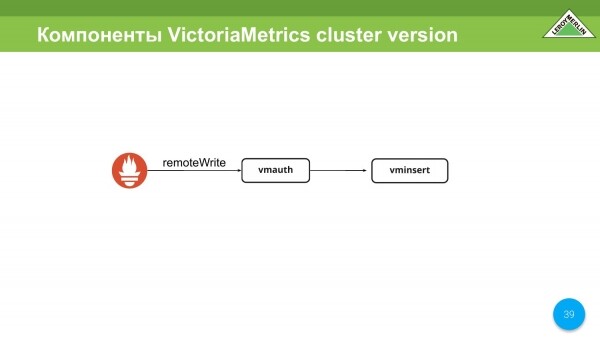
Det finns en komponent som heter wmauth. Den kan eventuellt användas av oss, men kanske inte (vi har inte bestämt oss än) som ett autentiseringssystem för multitenancy-versioner av kluster. Den stöder remoteWrite för Prometheus och kan autentisera baserat på url, mer specifikt den andra delen av den, dit ni får skriva eller inte.
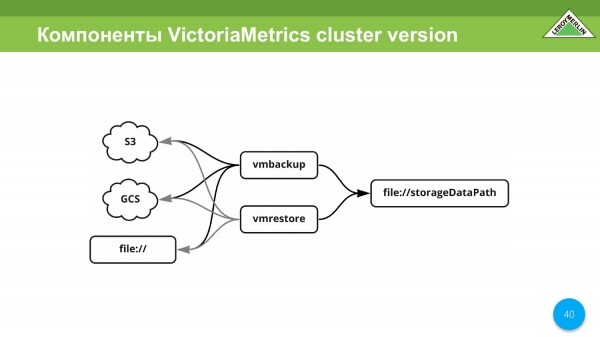
Det finns också vmbackup, vmrestore. Det är i huvudsak återställning och backup av alla data. Den kan hantera S3, GCS, fil.
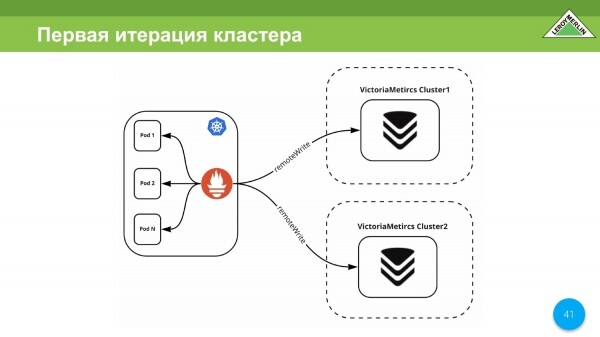
Den första iterationen av vår kluster gjordes under karantänen. Vid den tiden fanns det ingen replik, så vår iteration bestod av två olika och oberoende kluster, från vilka vi tog emot data via remoteWrite.
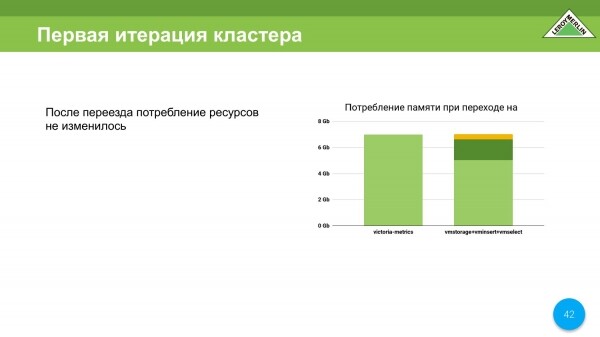
Här vill jag nämna att när vi övergick från VictoriaMetrics Single Node till VictoriaMetrics Cluster Version så förblev vi inom samma resursförbrukning, dvs. det handlar huvudsakligen om minne. Så här fördelades våra data, dvs. resursanvändningen.
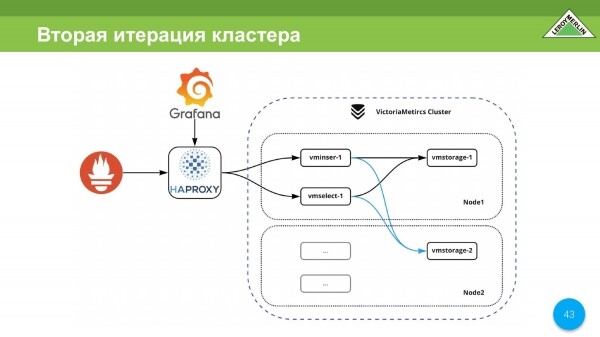
Här lades en replik till. Vi sammanfogade allt i ett relativt stort kluster. Alla våra data både sharded och replikerade.
Hela klustret har N ingångspunkter, dvs. Prometheus kan lägga till data via HAPROXY. Här har vi denna ingångspunkt. Och via denna ingångspunkt kan man komma åt Grafana.
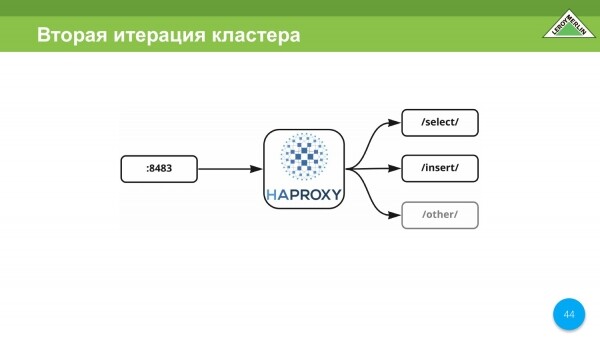
I vårt fall är HAPROXY den enda porten som proxar select, insert och andra tjänster in i detta kluster. I vårt fall kunde vi inte skapa en enda adress, vi var tvungna att göra flera ingångspunkter eftersom de virtuella maskiner som kör VictoriaMetrics-klustret ligger i olika zoner av en molnleverantör, dvs. inte inom vårt eget moln, utan utanför.
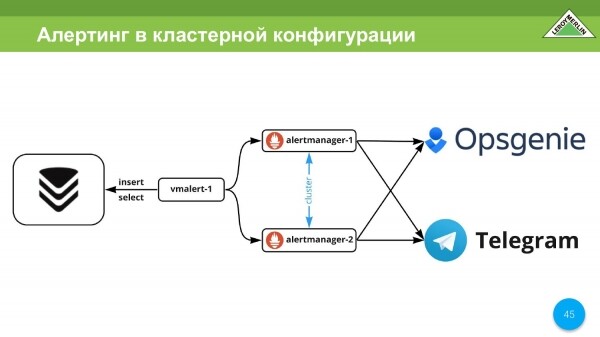
Vi har alerting. Vi använder det. Vi använder alertmanager från Prometheus. Vi använder Opsgenie och Telegram som leveranskanaler för alerterna. I Telegram kommer det notifikationer från dev, kanske något från prod, men mer statistiska saker som är användbara för ingenjörerna. Opsgenie är kritiskt. Det handlar om samtal och incidenthantering.
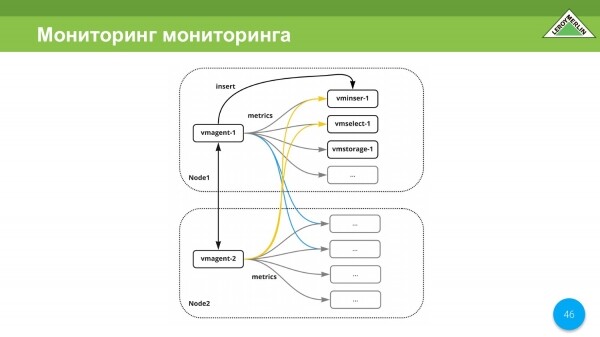
Den eviga frågan: "Vem övervakar övervakningen?" I vårt fall övervakar övervakningen sig själv eftersom vi använder vmagent på varje nod. Eftersom våra noder är fördelade över olika datacenter från samma leverantör, har varje datacenter sin egen kanal, de är oberoende och även om det skulle uppstå en split brain, så får vi fortfarande alerter. Ja, det kommer att bli fler, men bättre att få fler alerter än inga.
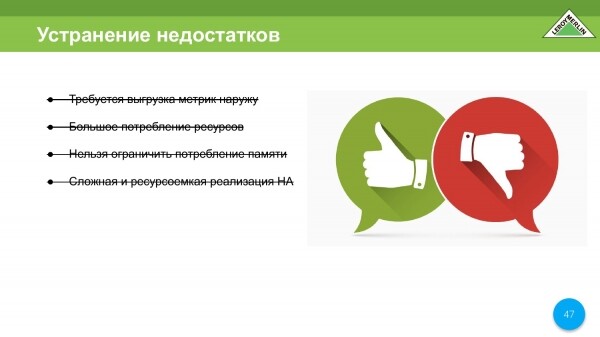
Vi avslutar vår lista med implementationen av HA.
Och jag skulle också vilja nämna erfarenheten av att kommunicera med VictoriaMetrics-communityn. Den har varit väldigt positiv. Killarna är lyhörda. De försöker förstå varje fall som föreslås.
Jag har skapat issues på GitHub. De löstes mycket snabbt. Det finns några fler issues som inte helt har stängts, men jag ser redan i koden att arbetet i den riktningen pågår.
Den största smärtan under iterationerna för mig var att om jag stänger av en nod, så kunde vminsert under de första 30 sekunderna inte förstå att backend inte fanns. Detta är nu löst. På bara en eller två sekunder hämtas data från alla kvarvarande noder, och förfrågan slutar vänta på den saknade noden.
Vid något tillfälle ville vi att VictoriaMetrics skulle ha en VictoriaMetrics-operator. Vi har fått vänta på den. Vi är nu aktivt inne i att bygga ett gränssnitt ovanpå VictoriaMetrics-operatorn för att ta med alla pre-calculating rules osv. från Prometheus, eftersom vi använder de regler som följer med Prometheus-operatören ganska aktivt.
Det finns förslag på förbättringar av klustret. Jag har redogjort för dem ovan.
Och jag skulle verkligen vilja ha downsampling. I vårt fall behövs downsampling uteslutande för att se trender. Grovt sagt, jag skulle bara behöva en metrik under dagen. Dessa trender behövs över ett år, tre, fem, och tio år. Ett enda värde för metrik är helt tillräckligt.
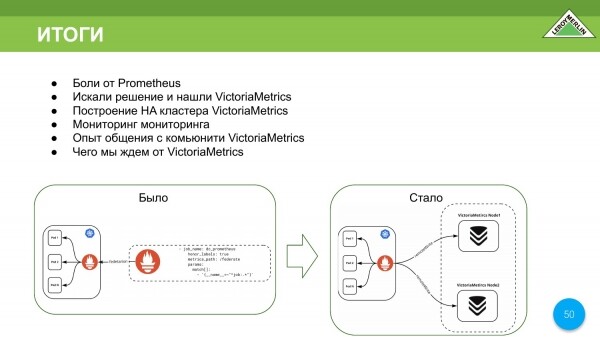
- Vi har upplevt smärtan, liksom några av våra kollegor, när vi använde Prometheus.
- Vi har valt VictoriaMetrics för oss själva.
- Den skalas ganska bra både vertikalt och horisontellt.
- Vi kan sprida ut olika komponenter på olika antal noder i klustret, begränsa deras minnesanvändning, lägga till mer minne osv.
Vi kommer att använda VictoriaMetrics hos oss, eftersom vi verkligen gillade den. Här är vad som var och vad som har blivit.
Ett par QR-koder för VictoriaMetrics-chatt, mina kontaktuppgifter, tech radar för LeroyMerlin.
Källa: habr.com
