

Hej!
Jag heter Mikhail och är IT-chef på företaget 'Sportmaster'. Jag vill dela med mig av en historia om hur vi hanterade de utmaningar som uppstod under pandemin.
Under de första dagarna av de nya förhållandena stannade den traditionella offline-handeln för 'Sportmaster' och belastningen på vår onlinekanal, särskilt när det gäller hemleveranser, ökade tiofaldigt. Inom några veckor transformerade vi en enorm offline-verksamhet till online och anpassade tjänsten efter våra kunders behov.
I stort sett blev det som tidigare var vår sekundära verksamhet vår huvudaffär. Betydelsen av varje online-order ökade extremt. Vi behövde bevara varje krona som kunden tog med sig till företaget.
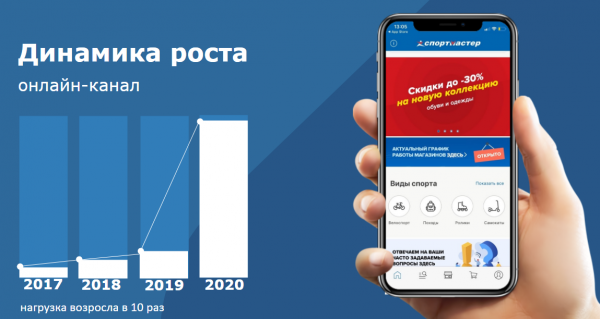
För att snabbt kunna svara på kundernas förfrågningar öppnade vi ett extra kontaktcenter på företagets huvudkontor, och vi kan nu ta emot omkring 285 000 samtal per vecka. Samtidigt har vi överfört 270 butiker till ett nytt format för kontaktlös och säker drift, vilket gjorde det möjligt för kunderna att hämta sina beställningar och för anställda att behålla sina jobb.
Under transformationen stötte vi på två huvudproblem. För det första ökade belastningen på våra online-resurser avsevärt (hur vi hanterade detta kommer Sergey att berätta om). För det andra ökade antalet sällsynta (innan COVID) operationer mångdubbelt, vilket i sin tur krävde en stor mängd snabb automatisering. För att lösa detta problem tvingades vi snabbt omdirigera resurser från de områden som tidigare var huvudfokus. Hur vi klarade av detta kommer Elena att berätta om.
Drift av onlinetjänster
Koliesnikov Sergey, ansvarar för driften av webbshoppen och mikrotjänsterna
Från det ögonblick som våra fysiska butiker började stänga för besökare började vi märka en ökning av mätvärden som antalet användare, antalet beställningar som görs i vår app och antalet begärningar till applikationerna.
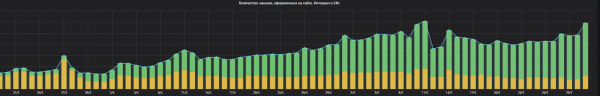 Antalet beställningar från 18 till 31 mars
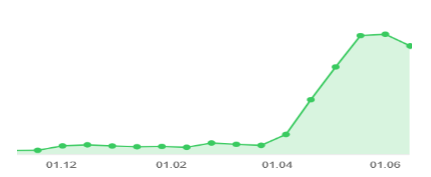 Antalet förfrågningar till mikrotjänsterna för onlinebetalningar
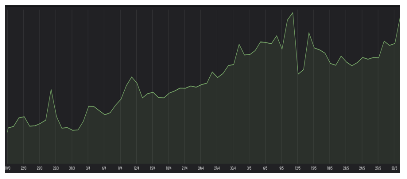 Antalet beställningar som lades på webbplatsen
I den första grafiken ser vi att tillväxten uppgick till cirka 14 gånger, medan den andra visar 4 gånger. Den mest illustrativa metrik vi anser vara svarstiden för våra applikationer.
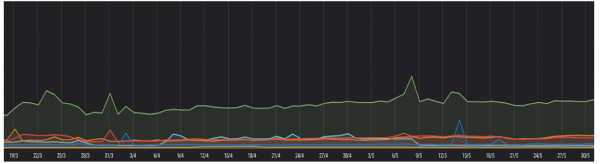
I denna graf ser vi svaret från frontend och applikationer, och vi har kommit fram till att vi inte har sett någon verklig tillväxt.
Först och främst beror detta på att vi påbörjade förberedande arbete i slutet av 2019. Nu har våra tjänster reserverats, med redundans på nivåerna av fysiska servrar, virtualiseringssystem, containrar och tjänster i dessa. Samtidigt tillåter kapaciteten i våra serverresurser att hantera multipla belastningar.
Det huvudsakliga verktyget som hjälpte oss genom hela denna process var vårt övervakningssystem. Ärligt talat hade vi inte nyligen ett enhetligt system som gjorde det möjligt att samla in metrik på alla nivåer, från den fysiska hårdvaran till affärsmått.
Formellt sett fanns det övervakning i företaget, men den var oftast spridd och ansvarig för specifika avdelningar. Faktum var att när en incident inträffade hade vi nästan aldrig en gemensam förståelse för vad som hade hänt, ingen information gavs, och detta ledde ofta till en cirkelrörelse i sökandet och lokaliseringen av problemet för efterföljande lösning.
Vid ett tillfälle insåg vi och beslutade att vi inte längre ville tolerera detta – vi behövde ett enhetligt system för att se hela bilden. De huvudsakliga teknologierna i vår stack inkluderar Zabbix som alert- och metriklagringscentral, Prometheus för insamling och lagring av applikationsmetrik, Stack ELK för loggning och lagring av data för hela övervakningssystemet, samt Grafana för visualisering, Swagger, Docker och andra användbara och bekanta verktyg.
Vi använder dessutom inte bara teknologier som finns på marknaden utan utvecklar också vissa saker själva. Till exempel skapar vi tjänster för att integrera system med varandra, det vill säga någon form av API för insamling av metrik. Dessutom arbetar vi på egna övervakningssystem – på affärsmätningsnivå använder vi UI-tester. Vi har även en bot i Telegram för att informera teamen.
Och vi försöker också göra övervakningssystemet tillgängligt för teamen så att de själva kan lagra sina metrik och arbeta med dem, inklusive att ställa in alertningar för vissa specifika metrik som inte har en så bred tillämpning.
In the entire system, we strive for proactivity and the fastest possible localization of incidents. Moreover, the number of our microservices and systems has significantly increased recently, consequently raising the number of integrations. As part of optimizing the incident diagnostics process at the integration level, we are developing a system that allows for cross-system checks and provides results, which helps identify key issues related to imports and the interaction of systems with each other.
Naturally, we still have room to grow and develop in terms of system operation, and we are actively working on this. You can read more about our monitoring system. .
Technical Tests
Sergey Orlov, heads the center of competence in web and mobile development
Since the closure of physical stores began, we have faced various challenges in terms of development. Primarily, there was a surge in load. It is clear that if no appropriate measures are taken, when high load is applied to the system, it can sadly turn into a pumpkin with a sad pop, either completely degrading in performance or losing its functionality altogether.
The second aspect, slightly less obvious, is that the system under high load needed to be changed very quickly, adapting to changes in business processes. Sometimes several times a day. In many companies, there is a rule that during large marketing activities, no changes should be made in the system. At all, let it operate as it is.
Whereas we essentially had an endless Black Friday, during which changes to the system needed to be made. And any error, problem, or failure in the system would be very costly for the business.
Looking ahead, I can say that we managed to cope with these challenges; all systems withstood the load, scaled easily, and we did not experience any major technical failures.
Det finns fyra grundpelare som systemets förmåga att hantera hög belastning vilar på. Den första är övervakning, som du läste om lite tidigare. Utan ett väl uppbyggt övervakningssystem är det praktiskt taget omöjligt att hitta flaskhalsar i systemet. Ett bra övervakningssystem är som hemma kläder, det ska vara bekvämt och anpassat för dig.
Den andra aspekten är testning. Vi tar detta på stort allvar: vi skriver både klassiska enhetstester, integrationstester, belastningstester och många andra för varje system. Vi skriver dessutom en teststrategi, och vi strävar efter att höja nivån på testningen så att manuella verifieringar inte längre behövs.
Den tredje grundpelaren är CI/CD Pipeline. Processerna för byggande, testning och distribution av applikationer ska vara så automatiserade som möjligt, och det ska inte finnas något manuellt ingripande. Ämnet CI/CD Pipeline är ganska djupt, och jag kommer bara beröra det ytligt. Det är värt att nämna att vi har en checklist för CI/CD Pipeline, enligt vilken varje produktteam går igenom med hjälp av kompetenscentra.
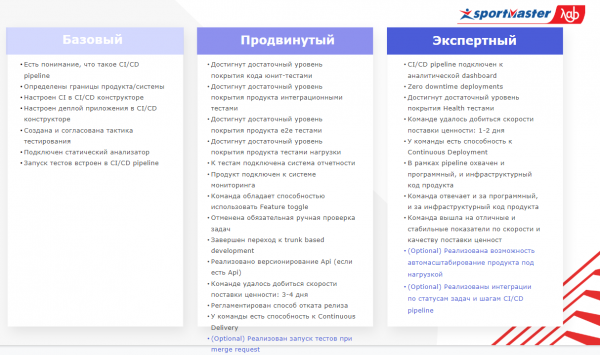 Här är checklistan
På så sätt uppnås många mål. Det handlar om versionering av API, och funktionstoggling för att undvika en våg av releaser, samt att uppnå testtäckning på sådan nivå att testningen är helt automatiserad, distributionerna är sömlösa och mycket mer.
Den fjärde grundpelaren är arkitekturprinciper och tekniska lösningar. Man kan prata länge och mycket om arkitektur, men jag vill betona ett par principer som jag vill lyfta fram.
För det första är det viktigt att välja specialiserade verktyg för specifika uppgifter. Ja, det låter självklart, och det är uppenbart att man bör slå i spik med en hammare, medan man bör använda speciella skruvmejslar för att öppna armbandsur. Men i vår tid strävar många verktyg efter att bli mer universella för att nå ut till ett så stort användarsegment som möjligt: databaser, cache, ramverk och så vidare. Ta till exempel databasen MongoDB, som arbetar med flerdokumenttransaktioner, medan databasen Oracle arbetar med json-filer. Och det verkar som om allt kan användas för allt. Men om vi förespråkar prestanda måste vi tydligt förstå fördelarna och nackdelarna med varje verktyg och använda de som passar vår uppgiftsklass.
För det andra bör varje ökning av komplexiteten vid systemdesign vara motiverad. Vi måste ständigt ha detta i åtanke, principen om låg koppling är allmänt känd. Jag anser att den bör tillämpas både på nivån för en specifik tjänst, på hela systemnivån och på nivån för det arkitektoniska landskapet. Förmågan att horisontellt skala varje komponent i systemet under belastning är också viktig. Om man har denna förmåga innebär skalning ingen svårighet.
När det gäller tekniska lösningar har vi bett produktteam att förbereda en färsk uppsättning rekommendationer, idéer och lösningar som de har genomfört i processen av förberedelser inför nästa belastningsvåg.
Cache
Det är viktigt att medvetet välja mellan lokala och distribuerade cacher. Ibland kan det vara meningsfullt att använda både och inom samma system. Till exempel har vi system där en del av data i grunden är en vitrin-cache, vilket betyder att källan till uppdateringar finns utanför systemet och att systemet inte ändrar dessa data. För denna typ av tillvägagångssätt använder vi den lokala Caffeine Cache.
Och det finns data som systemet aktivt ändrar under drift, och här använder vi en distribuerad cache med Hazelcast. Denna strategi gör att vi kan utnyttja fördelarna med en distribuerad cache där det verkligen behövs, och minimera servicekostnaderna för datacirkulationen i Hazelcast-klustret där vi kan klara oss utan det. Vi har skrivit mycket om cache. och .
Dessutom gav bytet av serialiserare till Kryo i Hazelcast oss en bra prestandaökning. Övergången från ReplicatedMap till IMap + Near Cache i Hazelcast möjliggjorde att vi minimerade datarörelserna i klustret.
Ett litet tips: vid massinvalidering av cache kan en taktik med uppvärmning av en andra cache följt av övergång till den ibland vara tillämplig. Vid en sådan metod borde vi få dubbel minneskonsumtion, men i praktiken, i de system där detta har använts, minskade minnesanvändningen.
Reaktiv stack
Vi använder den reaktiva stacken i ett relativt stort antal system. I vårt fall handlar det om Webflux eller Kotlin med korutiner. Den reaktiva stacken passar särskilt bra när vi förväntar oss långsamma in- och utdataoperationer. Till exempel, anrop till långsamma tjänster, arbete med filsystem eller lagringssystem.
Den allra viktigaste principen är att undvika blockerande anrop. Under huven på reaktiva ramverk körs ett litet antal aktiva tjänstrådar. Om vi ovarsamt gör ett direkt blockerande anrop, som ett anrop till en JDBC-drivrutin, kommer systemet helt enkelt att stanna.
Försök att omvandla fel till egna runtime-exceptioner. Den verkliga exekveringsströmmen av programmet går till de reaktiva ramverken, vilket gör kodexekveringen icke-linjär. Som en följd av detta är det mycket svårt att diagnostisera problem via stack-traces. En lösning här är att skapa tydliga och objektiva runtime-exceptioner för varje fel.
Elasticsearch
Vid användning av Elasticsearch, undvik att välja oanvända data. Detta är i princip ett mycket enkelt råd, men det som oftast glöms bort. Om du behöver välja mer än 10 000 poster på en gång, måste du använda Scroll. I en analogi liknar detta en kursorsökning i en relationsdatabas.
Använd inte postfilter utan behov. Vid stora datamängder i huvudvalet belastar denna operation databasen mycket.
Använd bulkoperationer där det är tillämpligt.
API
Vid utformning av API, inkludera krav på minimering av överförda data. Detta är särskilt relevant i samverkan med frontend: just på detta gränssnitt går vi utanför våra datacenterkanaler och arbetar redan på kanalen som kopplar oss till kunden. Om det finns minsta problem där, kan för hög trafik orsaka en negativ användarupplevelse.
Och slutligen, undvik att överösa med all data, ha en tydlig approach till kontraktet mellan konsumenter och leverantörer.
Organisatorisk transformation
Elena Eroshkina, IT-chef
Vid tidpunkten för nedstängningen, när behovet av att snabbt öka takten i onlineutvecklingen och införa omnikanal-tjänster uppstod, befann vi oss redan i en organisatorisk transformation.
En del av vår struktur har övergått till att arbeta utifrån principer och metoder för produktansats. Team har bildats som nu ansvarar för drift och utveckling av varje produkt. Medarbetare i sådana team är fullt engagerade och organiserar sitt arbete enligt Scrum eller Kanban, beroende på vad som passar dem bäst, de anpassar distributionsprocessen, implementerar tekniska metoder, kvalitetsmetoder och mycket mer.
Av en lycklig tillfällighet hade majoriteten av dessa produktteam just verkat inom online- och omnikanal-tjänster. Detta möjliggjorde för oss att på kort tid (allvarligt, bokstavligt talat inom två dagar) gå över till distansarbete utan att tappa effektiviteten. Den etablerade processen gjorde det möjligt att snabbt anpassa sig till de nya arbetsvillkoren och upprätthålla ett tillräckligt högt tempo för att leverera ny funktionalitet.
Dessutom uppstod det ett behov av att stärka de team som befinner sig i framkant av onlineverksamheten. Vid den tidpunkten blev det klart att vi endast kunde göra detta med interna resurser. Ungefär 50 personer bytte område där de tidigare arbetat och integrerades i arbetet med en ny produkt under två veckor.
För detta krävdes inga speciella ledarskapsinsatser, eftersom vi parallellt med att organisera vår egen process, med teknisk förfining av produkten och kvalitetsmetoder, lär våra team självorganisering - att hantera sin egen produktionsprocess utan att involvera administrativa resurser.
Vi lyckades rikta vårt ledningsresurs dit det var nödvändigt just då – på samordning tillsammans med verksamheten. Vad är viktigt för vår kund just nu? Vilken funktionalitet bör implementeras först? Vad behöver göras för att öka vår kapacitet för leverans och hantering av beställningar? allt detta och en tydlig rollmodell gjorde att vi under denna period kunde belasta våra produktionsflöden med det som verkligen är viktigt och nödvändigt.
Självklart, i en tid av distansarbete och högt förändringstempo, där varje deltagares insats påverkar affärsresultaten, kan man inte bara förlita sig på inre känslor av typen "Går allt bra för oss? Jo, det verkar okej." Objektiva mätvärden av produktionsprocessen är nödvändiga. Sådana har vi, de är tillgängliga för alla som är intresserade av mätvärden för produktteam. Framför allt för teamet självt, verksamheten, de som arbetar i angränsande områden och ledningen.
Varje två veckor hålls en status med varje team där mätvärden analyseras under 10 minuter, flaskhalsar i produktionsprocessen identifieras och gemensamma lösningar utvecklas: vad kan göras för att eliminera dessa flaskhalsar. Här kan man också direkt be om hjälp från ledningen om ett problem ligger utanför teamens påverkan, eller få vägledning från kollegor som kanske redan har stött på ett liknande problem.
Men vi förstår att för att uppnå en betydande acceleration (och exakt det mål har vi satt upp) måste vi fortfarande lära oss mycket och implementera det i vårt dagliga arbete. Just nu fortsätter vi att skala den produktansats vi har till andra team och nya produkter. För att göra detta har vi fått lära oss ett nytt format för en online-skola för metoddoktorer.
Metoddoktorer, de personer som hjälper teamen att bygga processer, förbättra kommunikationen och öka arbetseffektiviteten, är i själva verket förändringsaktörer. Just nu arbetar studenter från vår första omgång med team och hjälper dem att bli framgångsrika.
Jag tror att den aktuella situationen för oss öppnar upp möjligheter och perspektiv som vi kanske själva ännu inte helt har insett. Men den erfarenhet och praktik vi får just nu bekräftar att vi har valt rätt utvecklingsväg, vi kommer inte att missa dessa nya möjligheter i framtiden och vi kommer att kunna svara lika effektivt på de utmaningar som "Sportmaster" kommer att stå inför.
Slutsatser
Under denna svåra tid har vi formulerat de grundläggande principer som utvecklingen av mjukvara bygger på, och som jag tror kommer att vara relevanta för varje företag som sysslar med detta.
Människor. Det är grunden för allt. Anställda måste ha nöje i sitt arbete, förstå företagets mål och målen för de produkter de arbetar med. Och naturligtvis måste de kunna utvecklas professionellt.
Tekniken. Det är viktigt att företaget moget närmar sig arbetet med sin teknologiska stack och bygger upp kompetenser där det verkligen behövs. Det låter väldigt enkelt och uppenbart. Och det ignoreras mycket ofta.
Processer. Det är viktigt att bygga rätt struktur för produktteam och kompetenscenter och att skapa samarbeten med affärerna för att arbeta med dem som partners.
Så ungefär så överlevde vi. Den moderna tidens kärnbudskap bekräftades ännu en gång med en kraftfull klump.
Även om du är ett stort offline-företag med många butiker och en mängd städer där du är närvarande, utveckla din onlineverksamhet. Det är inte bara en extra försäljningskanal eller en snygg app där man också kan köpa något (även för att konkurrenterna också har något fint). Det är inte en reservhjul som kan hjälpa dig att klara stormen.
Det är en absolut nödvändighet. Både dina tekniska resurser och infrastruktur, men också människor och processer måste vara förberedda. Att snabbt köpa extra minne, lagring, starta nya instanser och liknande kan göras på ett par timmar. Men människor och processer måste förberedas i förväg.
Källa: habr.com
