

Kära läsare, god dag!
Att bygga IT-plattformar för att samla och analysera data är en utmaning som så gott som varje företag förr eller senare ställs inför, särskilt de vars verksamhet baseras på en intellektuellt krävande tjänstemodell eller skapandet av tekniskt komplexa produkter. Att bygga analytiska plattformar är en komplex och resurskrävande uppgift. Men alla problem kan förenklas. I den här artikeln vill jag dela med mig av våra erfarenheter av att använda verktyg med låg kod för att skapa analytiska lösningar. Dessa erfarenheter har vi fått genom att genomföra flera projekt inom Big Data Solutions på företaget "Neoflex". Sedan 2005 har Big Data Solutions på "Neoflex" arbetat med att bygga datalager och datavolymer, lösa frågor kring hastigheten för informationbearbetning och utveckla metodologier för datakvalitetsstyrning.
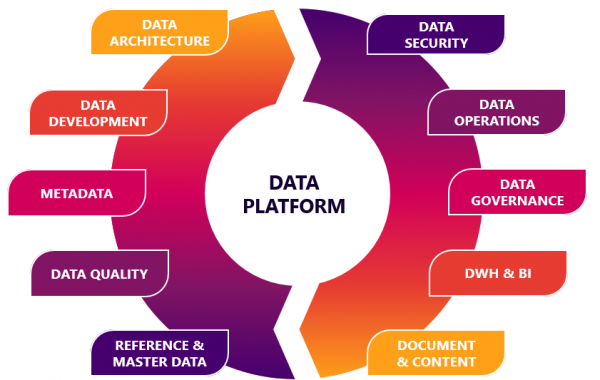
Det går inte att undvika att medvetet samla svagt och/eller starkt strukturerade data. Kanske, även om det handlar om småföretag. När ett lovande företag växer, kommer det att stöta på frågor kring lojalitetsprogram, analysera försäljningsställen, tänka på riktad reklam och bekymra sig över efterfrågan på komplementprodukter. Inledningsvis kan dessa frågor lösas "på egen hand". Men med företagets tillväxt blir det oundvikligt att införa en analytisk plattform.
Under vilka omständigheter kan dataanalysens utmaningar övergå till uppgifter av klassen "Rocket Science"? Kanske just när vi pratar om verkligt stora data.
För att förenkla "Rocket Science"-uppgiften kan man äta elefanten i bitar.
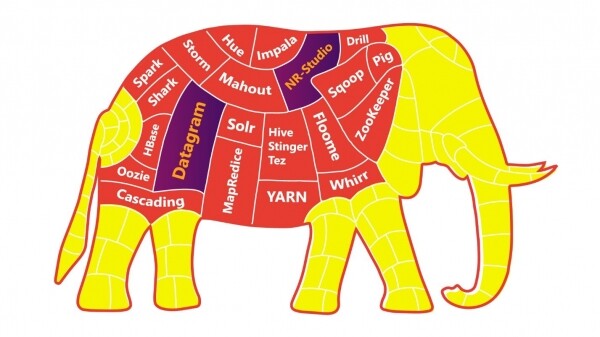
Ju mer diskreta och självständiga era applikationer/tjänster/mikrotjänster är, desto enklare blir det för er, era kollegor och hela företaget att bearbeta elefanten.
Denna slutsats har nästan alla våra kunder kommit fram till genom att omstrukturera landskapet baserat på ingenjörsmetoder från DevOps-team.
Men även med en "separat, elefantdiet" har vi goda chanser till "överskott" i IT-landskapet. I detta ögonblick är det värt att stanna upp, ta ett djupt andetag och titta i riktning mot lågnivåkodningsplattform.
Många utvecklare är skrämda av möjligheten att hamna i en karriärkris när de går ifrån att direkt skriva kod till att ‘dra och släppa’ element i UI-gränssnitt för lågkodssystem. Men introduktionen av maskiner ledde inte till en minskning av ingenjörer; tvärtom höjde den deras arbete till en ny nivå!
Låt oss gå igenom varför.
Dataanalys inom logistik, telekommunikationsbranschen, medieforskning och finanssektorn är alltid förknippad med följande frågor:
- Hastigheten i den automatiserade analysprocessen;
- Möjligheten att genomföra experiment utan att påverka huvudflödet av datakapacitet;
- Tillförlitligheten av de förberedda uppgifterna;
- Övervakning av förändringar och versionering;
- Data provenance, Data lineage, CDC;
- Snabbheten i att leverera nya funktioner till produktionsmiljön;
- Och den beryktade: kostnaden för utveckling och underhåll.
Det innebär att ingenjörer har en mängd högre nivåuppgifter som kan utföras effektivt först när de rensar tankarna från lågnivå utvecklingsuppgifter.
Förutsättningarna för att utvecklare skulle gå vidare till en ny nivå har varit affärernas evolution och digitalisering. Utvecklarens värde förändras också: det råder en stor brist på utvecklare som kan förstå kärnan i koncepten för automatiserad verksamhet.
Låt oss dra en parallell mellan lågnivå- och högnivåprogrammeringsspråk. Övergången från lågnivåspråk till högnivåspråk är en övergång från att skriva ‘direkta direktiv på maskinspråket’ till ‘direktiv på människospråket’. Det handlar om att lägga till ett lager av abstraktion. I det här fallet innebär övergången från högnivå programmeringsspråk till lågkodplattformar en övergång från ‘direktiv på människospråket’ till ‘direktiv på affärsspråket’. Om det finns utvecklare som blir ledsna över detta faktum, kan de ha varit ledsna sedan den dag JavaScript lanserades, där funktioner för att sortera arrayer används. Dessa funktioner har givetvis en programmatisk implementation under huven med hjälp av andra medel för samma högnivåprogrammering.
Således är lågkod helt enkelt ett nytt nivå av abstraktion.
Praktisk erfarenhet av att använda lågkod
Low-code-temat är ganska bred, men nu skulle jag vilja berätta om tillämpningen av "low-code-koncept" genom ett exempel från ett av våra projekt.
Big Data Solutions-avdelningen inom företaget "Neoflex" specialiserar sig i stor utsträckning på finanssektorn, där man bygger datalager och datavattendrag samt automatiserar olika rapporteringsprocesser. Inom denna nisch har användningen av low-code länge blivit standard. Bland andra low-code-verktyg kan vi nämna verktyg för att organisera ETL-processer: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Eller Oracle Apex, som är en plattform för snabb utveckling av användargränssnitt för datainmatning och redigering. Men användningen av low-code-utvecklingsmedel är inte alltid kopplad till att bygga snävt inriktade applikationer på en kommersiell teknikstack med tydligt beroende av leverantören.
Med hjälp av low-code-plattformar kan man också organisera orkestrering av datastreams, skapa datavetenskapsplattformar eller till exempel moduler för datakvalitetskontroll.
Ett exempel på tillämpning av low-code-utvecklingsmedel är samarbetet mellan "Neoflex" och företaget Mediascope, en av ledarna på den ryska marknaden för medieforskning. Ett av målen för denna företags verksamhet är att producera data som annonsörer, internetplattformar, TV-kanaler, radiostationer, reklambyråer och varumärken använder för att fatta beslut om inköp av reklam och planera sina marknadsföringskommunikationer.
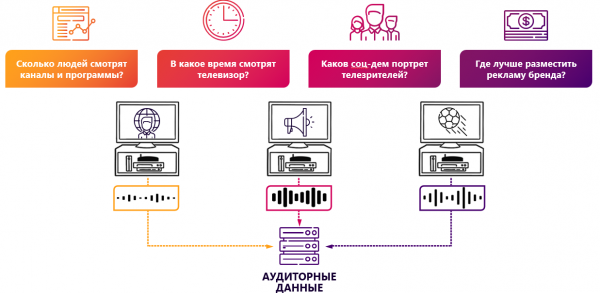
Mediaforskning är en teknologiskt krävande affärssektor. Videoigenkänning, insamling av data från enheter som analyserar visning, mätning av aktivitet på webbplatser - allt detta förutsätter att företaget har en stor IT-stab och enorm erfarenhet av att bygga analytiska lösningar. Men den exponentiella tillväxten av mängden information, antalet och mångfalden av dess källor tvingar ständigt IT-industrin att utvecklas. Den enklaste lösningen för att skala den redan fungerande Mediascope-analytiska plattformen skulle kunna vara att öka antalet IT-anställda. Men en mycket mer effektiv lösning är att påskynda utvecklingsprocessen. Ett av stegen mot detta kan vara användningen av low-code-plattformar.
Vid projektets start hade företaget redan en fungerande produktlösning. Men implementeringen av lösningen på MSSQL kunde inte fullt ut motsvara förväntningarna på att skala funktionaliteten samtidigt som kostnaden för modifieringarna förblev acceptabel.
Den uppgift som låg framför oss var verkligen ambitiös – Neoflex och Mediascope skulle skapa en industriell lösning på mindre än ett år, med kravet på att MVP skulle lanseras inom första kvartalet från projektstart.
Som grund för att bygga den nya databasen, baserad på low-code-beräkningar, valdes teknikstacken Hadoop. Standard för datalagring blev HDFS med användning av parquet-formatfiler. För att få tillgång till data inom plattformen användes Hive, där alla tillgängliga datakällor representeras som externa tabeller. Dataöverföring till lagret genomfördes med hjälp av Kafka och Apache NiFi.
Low-code-verktyget i detta koncept användes för att optimera den mest arbetskrävande uppgiften i byggandet av den analytiska plattformen – databeräkningsuppgiften.
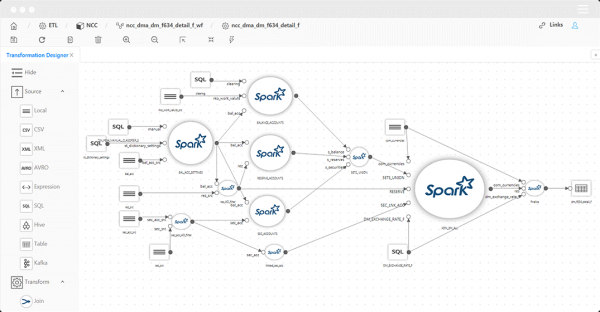
Huvudmekanismen för datamappning valdes att bli low-code-verktyget Datagram. Neoflex Datagram är ett verktyg för att utveckla transformationer och datavolymer.
Genom att använda detta verktyg kan man klara sig utan att skriva Scala-kod "för hand". Scala-koden genereras automatiskt med hjälp av Model Driven Architecture.
Den uppenbara fördelen med ett sådant tillvägagångssätt är att utvecklingsprocessen går snabbare. Men förutom hastigheten finns det också följande fördelar:
- Visning av innehållet och strukturen hos källor/mottagare;
- Spårning av ursprunget av datavolymens objekt ner till individuella fält (lineage);
- Delvis genomförande av transformationer med visning av mellanresultat;
- Visning av koden och dess justering innan körning;
- Automatisk validering av transformationer;
- Automatisk dataöverföring 1 till 1.
Tröskeln för att komma in i low-code-lösningar för att generera transformationer är ganska låg: en utvecklare behöver kunna SQL och ha erfarenhet av ETL-verktyg. Det bör också nämnas att code-driven-generationsverktyg för transformationer inte är ETL-verktyg i den breda bemärkelsen av ordet. Low-code-verktyg kanske inte har sin egen miljö för att köra kod. Det innebär att den genererade koden kommer att köras i den miljö som fanns i klustret innan installationen av low-code-lösningen. Och det här är nog ytterligare en fördel för low-code, eftersom en "klassisk" team kan arbeta parallellt med low-code-teamet för att implementera funktionalitet, exempelvis på ren Scala-kod. Att dra in förbättringar från båda teamen till produktion kommer att vara enkelt och "sömlöst".
Det är värt att notera att det förutom low-code även finns no-code-lösningar. Och i sitt väsen är det olika saker. Low-code ger i högre grad utvecklaren möjlighet att blanda sig i den genererade koden. I fallet med Datagram är det möjligt att granska och redigera den genererade Scala-koden, medan no-code kanske inte ger den möjligheten. Denna skillnad är mycket väsentlig, både ur synpunkt av lösningens flexibilitet och ur synpunkt av bekvämlighet och motivation i arbete för datatekniker.
Arkitektur för lösningen
Låt oss försöka förstå hur low-code-verktyget hjälper till att lösa problemet med att optimera utvecklingshastigheten för databeräkningsfunktioner. Först ska vi titta på systemets funktionella arkitektur. I det här fallet fungerar modellen för dataproduktion för medieforskning som exempel.
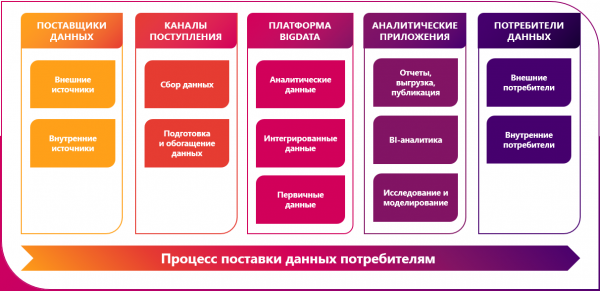
Datakällorna i vårt fall är mycket heterogena och varierande:
- Peoplemetris (TV-metrar) är programvaru- och hårdvaruenheter som registrerar användarbeteende hos respondenter på tv-panelen – vem, när och vilken tv-kanal som visades i hushåll som deltar i studien. Den information som levereras är en ström av visningstider kopplade till mediepaketet och medieprodukten. Data vid inläsning till Data Lake kan berikas med demografiska attribut, kopplingar till geografiska områden, tidszoner och annan information som är nödvändig för att genomföra analys av tv-tittande av en viss medieprodukt. De gjorda mätningarna kan användas för analys eller planering av reklamakampanjer, bedömning av publik aktivitet och preferenser, samt utarbetande av sändningsschema;
- Data kan komma från system som övervakar strömmande tv-sändningar och mäter visning av innehåll på videoresurser på internet;
- Mätningsverktyg i webbmiljö, som inkluderar både site-centric och user-centric mätare. Dataleverantörer för Data Lake kan vara webbläsartillägg som research bar och mobilapplikationer med inbyggd VPN.
- Data kan också komma från plattformar som konsoliderar resultat från enkäter och slutresultat från telefonintervjuer i företagets undersökningar;
- Ytterligare berikning av datalaket kan ske genom att ladda upp information från loggar från partnerföretag.
Implementeringen av as-is-laddning från källsystem till primär staging av rådata kan organiseras på olika sätt. Vid användning av low-code för dessa ändamål är automatisk generation av laddningsscript möjlig baserat på metadata. I detta fall är det inte nödvändigt att gå ner på nivån av utveckling av source to target-mappningar. För att genomföra automatisk laddning måste vi etablera en anslutning till källan, varefter vi i laddningsgränssnittet definierar listan över entiteter som ska laddas. Skapandet av katalogstrukturen i HDFS kommer att ske automatiskt och motsvara strukturen för datalagring i källsystemet.
I sammanhanget av detta projekt har vi beslutat att inte använda denna möjlighet i low-code-plattformar, eftersom företaget Mediascope redan har påbörjat arbetet med att skapa en liknande tjänst med hjälp av Nifi + Kafka.
Det är viktigt att klargöra att dessa verktyg inte är ömsesidigt utbytbara, utan snarare kompletterar varandra. Nifi och Kafka kan arbeta både i direkt (Nifi -> Kafka) och omvänd (Kafka -> Nifi) koppling. För medieforskningsplattformen användes den första kopplingen.
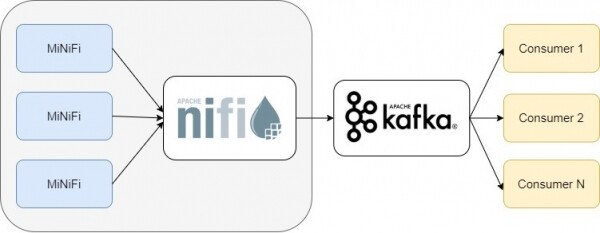
I vårt fall krävdes det att Nifi hanterade olika datatyper från källsystem och skickade dem till Kafka-brokern. Meddelandena riktades till en specifik Kafka-topic genom tillämpning av Nifi-processorerna PublishKafka. Orkestrering och hantering av dessa pipelines sker i det visuella gränssnittet. Verktyget Nifi och användningen av kopplingen Nifi + Kafka kan också kallas en lågkodslösning för utveckling, som har en låg tröskel för att komma in i Big Data-teknologier och påskyndar utvecklingsprocessen för applikationer.
Nästa steg i projektets genomförande var att anpassa till en enhetlig semantisk lag av detaljerad data. I fall där en entitet har historiska attribut beräknas detta i kontexten av den aktuella partitionen. Om entiteten inte är historisk kan antingen en omräkning av hela objektets innehåll göras, eller så kan man välja att helt avstå från omräkningen (på grund av bristen på förändringar). I detta skede genereras nycklar för alla entiteter. Nycklarna sparas i motsvarande huvudobjektsregister i Hbase, som innehåller överensstämmelse mellan nycklar i den analytiska plattformen och nycklar från källsystemen. Konsolidering av atomära entiteter åtföljs av berikning med resultat från förhandsberäkning av analytiska data. Ramverket för databeräkning var Spark. Den funktionalitet som beskrivits för att anpassa data till en enhetlig semantik har också implementerats baserat på mappningar av lågkodverktyget Datagram.
I den målarkitektur som behövdes skulle SQL-åtkomst till data säkerställas för affärsanvändare. För detta alternativ användes Hive. Registreringen av objekt i Hive sker automatiskt när alternativet "Registrera Hive-tabell" aktiveras i lågkodverktyget.
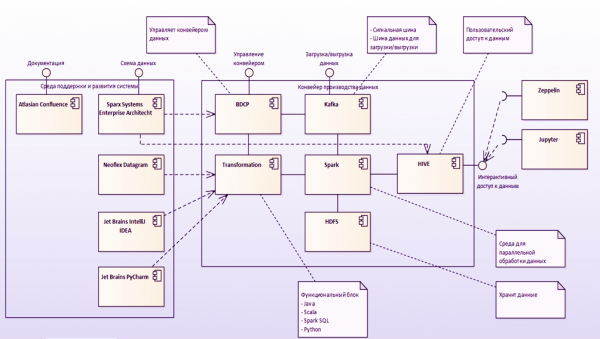
Hantering av beräkningsflödet
Datagram har ett gränssnitt för att bygga design av arbetsflöden. Kartsättning kan köras med hjälp av Oozie-schemaläggaren. I utvecklargränssnittet för arbetsflöden kan man skapa scheman för parallell, sekventiell eller villkorsbunden datatransformation. Stöd finns för shell-skript och Java-program. Användning av servern Apache Livy. Apache Livy används för att köra applikationer direkt från utvecklingsmiljön.
Om företaget redan har en egen processorkestrator kan REST API användas för att integrera kartläggningar i det befintliga flödet. Till exempel har vi haft ganska framgångsrika erfarenheter av att integrera kartläggningar på Scala i orkestra skrivna i PLSQL och Kotlin. REST API för lågt kodade verktyg innebär operationer som att generera exekveringsår baserat på kartläggningsdesign, anropa kartläggning, anropa sekvens av kartläggningar och naturligtvis överföra parametrar i URL:en för att köra kartläggningar.
Utöver Oozie går det också att organisera beräkningsflödet med hjälp av Airflow. Jag kommer inte att gå in på en lång jämförelse mellan Oozie och Airflow, utan jag kan bara säga att i kontexten av medieforskningsprojektet föll valet på Airflow. Huvudskälen för detta var ett mer aktivt community som utvecklar produkten och ett mer avancerat gränssnitt + API.
Airflow är också bra eftersom det använder det många älskar, Python, för att beskriva beräkningsprocesser. Generellt finns det inte så många plattformar för att hantera arbetsflöden med öppen källkod. Att köra och övervaka processer (inklusive med Gantt-diagram) ger dessutom poäng till Airflows rykte.
Formatet för konfigurationsfilen för att köra lågkod-lösningar blev spark-submit. Detta skedde av två anledningar. För det första tillåter spark-submit att direkt köra en jar-fil från konsolen. För det andra kan det innehålla all nödvändig information för att konfigurera arbetsflödet (vilket underlättar skrivandet av skript som formar Dag).
Den mest frekvent förekommande komponenten i vårt arbetsflöde i Airflow blev SparkSubmitOperator.
SparkSubmitOperator gör det möjligt att köra jar-filer — packade kartläggningar av Datagram med förberedda ingångsparametrar.
Det är värt att nämna att varje uppgift i Airflow körs i en separat tråd och vet ingenting om andra uppgifter. Interaktionen mellan uppgifter sker därför genom styroperatörer som DummyOperator eller BranchPythonOperator.
Sammanfattningsvis av användningen av low-code-lösningen Datagram i kombination med standardiseringen av konfigurationsfiler (som bildar Dag) har lett till en betydande snabbbefrämjande och förenklande av utvecklingsprocessen för dataladdningsflöden.
Beräkning av dashboards
Kanske det mest intellektuellt krävande steget i produktionen av analytiska data är steget för att bygga dashboards. I samband med ett av flödena för databeräkning i det forskande företaget sker det på detta steg en anpassning till referenstranslationen med hänsyn till tidszonsjusteringar kopplade till sändningsnätet. En justering för det lokala sändningsnätet (lokala nyheter och reklam) är också möjlig. Bland annat utförs i detta steg en uppdelning av intervall för kontinuerlig visning av mediaprodukter baserat på analys av visningsintervall. Här sker också en "vägning" av visningsvärdena baserat på information om deras betydelse (beräkning av korrigeringsfaktorn).
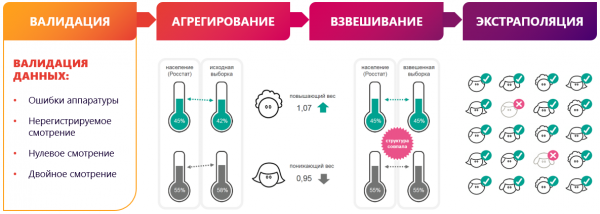
Ett särskilt steg i förberedelsen av dashboards är datavalidering. Valideringsalgoritmen är kopplad till tillämpningen av en rad matematiska science-modeller. Men användningen av en low-code-plattform gör det möjligt att bryta ner den komplexa algoritmen i en rad separata visuellt avläsbara mappningar. Varje mappning utför en smal uppgift. Detta möjliggör mellanliggande avlusning, loggning och visualisering av datberedningsstegen.
Det beslutades att diskretisera valideringsalgoritmen på följande delsteg:
- Byggande av regressionsberoenden mellan TV-nät i regionen och tittandet på alla nät i regionen under 60 dagar.
- Beräkning av studentiserade rester (avvikelser av faktiska värden från de predikterade värdena av regressionsmodellen) för alla regressionspunkter och för den beräknade dagen.
- Uttag av anomaliska par region-TV-nät där den studentiserade resten för den beräknade dagen överstiger normen (angiven av operationens inställning).
- Omräkningen av det justerade studentiserade saldot för anomala par mellan region och TV-nätverk för varje respondent som har tittat på nätverket i regionen, med bestämning av denna respondents bidrag (storleken på förändringen av det studentiserade saldot) vid uteslutning av denna respondents tittande från urvalet.
- Sökning av kandidater vars uteslutning leder till att det studentiserade saldot för beräkningsdagen normaliseras.
Det ovanstående exemplet bekräftar hypotesen att en dataingenjör redan har alldeles för mycket att hålla reda på… Och om det verkligen är en "ingenjör" och inte en "kodare", borde rädslan för professionell försämring vid användning av low-code-verktyg definitivt avta.
Vad mer kan low-code göra?
Användningsområdet för low-code verktyg för batch- och flödesbehandling av data utan behov av att manuellt skriva kod i Scala tar inte slut.
Användningen av low-code i utvecklingen av datalakes har redan blivit en standard för oss. Man kan nog säga att lösningar baserade på Hadoop-stacken följer utvecklingsvägen för klassiska DWH, baserade på relationsdatabaser. Low-code-verktyg på Hadoop-stacken kan hantera både databehandlingsuppgifter och uppgifter för att bygga slutliga BI-gränssnitt. Det är värt att notera att BI kan förstås som inte bara representation av data, utan också som deras redigering av affärsanvändare. Denna funktionalitet används ofta av oss vid uppbyggnad av analytiska plattformar för finanssektorn.
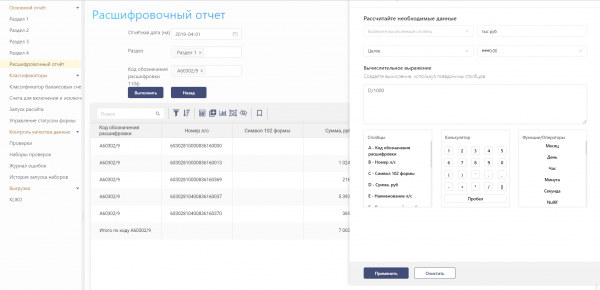
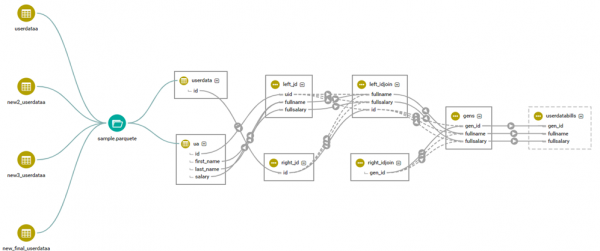
Bland annat kan man med low-code och särskilt Datagram lösa uppgiften att spåra ursprunget till objekt inom datastream med atomisk precision ner till enskilda fält (lineage). För detta har low-code-verktyget implementerat en koppling till Apache Atlas och Cloudera Navigator. I praktiken måste utvecklaren registrera en uppsättning objekt i Atlas-ordspråken och hänvisa till de registrerade objekten vid skapandet av mappningar. Mekanismen för att spåra dators ursprung eller analysera objektberoenden sparar mycket tid när det behövs ändringar i beräkningsalgoritmer. Till exempel, vid skapandet av finansiella rapporter gör denna funktion det lättare att hantera perioder av lagförändringar. Ju bättre vi förstår interformella beroenden i detaljerade lager, desto färre "plötsliga" defekter kommer vi att möta och vi kommer att minska antalet rework.
Data Quality & Low-code
En annan uppgift som implementerades med low-code-verktyget i Mediascope-projektet var en uppgift av klassen Data Quality. En särskildhet i implementeringen av datakontrollpipeline för forskningsföretagets projekt var frånvaron av påverkan på funktionalitet och hastighet i huvudberäkningströmmarna. För att kunna orkestrera oberoende datakontrollflöden användes det välkända Apache Airflow. När varje steg i datatillverkningen var klart, startades parallellt en avskild del av DQ-pipelinen.
En god praxis är att övervaka datakvaliteten från det att de skapas på den analytiska plattformen. Med information om metadata kan vi redan från det ögonblick informationen når det primära lagret kontrollera efterlevnaden av grundläggande villkor — not null, constraints, foreign keys. Denna funktionalitet är baserad på automatiskt genererade mappningar av datakvalitetsfamiljen i Datagram. Kodgenereringen i detta fall grundas också på metadata-modellen. I Mediascope-projektet skedde kopplingen med produktens Enterprise Architect-metadata.
Tack vare kopplingen mellan low-code-verktyget och Enterprise Architect genererades följande kontroller automatiskt:
- Kontroll av närvaron av värden "null" i fält med modifieraren "not null";
- Kontroll av närvaron av dubbletter av primärnyckeln;
- Kontroll av entitetens främmande nyckel;
- Kontroll av unika poster baserat på ett fältset.
För mer komplexa kontroller av tillgång och verifiering av data har en mappning skapats med Scala Expression, som tar emot extern Spark SQL-kod för kontroller, förberedd av analytiker i Zeppelin.
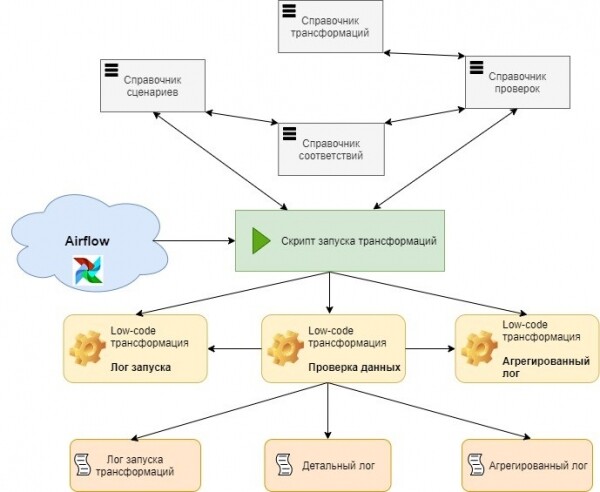
Självklart måste automatgenereringen av kontroller göras gradvis. Inom ramen för det beskrivna projektet föregicks detta av följande steg:
- DQ, genomfört i Zeppelin-notebookar;
- DQ, integrerade i mappningen;
- DQ som separata massiva mappningar, som innehåller en komplett uppsättning kontroller för en specifik entitet;
- Universella parametiserade DQ-mappningar som tar emot information om metadata och affärskontroller.
Kanske den största fördelen med att skapa en tjänst för parametriserade kontroller är den kortare tiden för att leverera funktionalitet till produktionsmiljön. Nya kvalitetskontroller kan omgå den klassiska kodenleveransmönster via utvecklings- och testmiljöer:
- Alla metadata kontroller genereras automatiskt vid ändring av modellen i EA;
- Tillgångskontroller för data (definiering av förekomsten av viss data vid en viss tidpunkt) kan genereras baserat på en katalog som lagrar den förväntade tidsramen för när nästa uppsättning data kommer att vara tillgänglig, sett ur objektens perspektiv;
- Affärskontroller av dataverifiering skapas av analytiker i Zeppelin-notebookar. De skickas direkt till inställningstabellerna för DQ-modulen i produktionsmiljön.
Riskerna med direkt leverans av skript till produktion finns inte. Även vid syntaxfel är det värsta som kan hända att en kontroll inte genomförs, eftersom databeräkningsflödet och kvalitetskontrollflödet är separerade.
I själva verket är DQ-tjänsten ständigt igång i produktionsmiljön och redo att börja sitt arbete vid ankomsten av nästa datauppsättning.
Avslutande
Fördelarna med att använda low-code är uppenbara. Utvecklare behöver inte skapa applikationen "från grunden". Och en programmerare som befrias från extra uppgifter levererar resultat snabbare. Hastigheten frigör i sin tur extra tid för att optimera frågor. Därför kan man i detta fall räkna med ett mer kvalitativt och snabbt lösning.
Självklart är low-code inte en universal lösning, och magi kommer inte att inträffa av sig själv:
- Den låga kodindustrin genomgår en "förstärknings"-fas, och det finns fortfarande inga homogena industriella standarder;
- Många low-code-lösningar är inte gratis, och deras inskaffande bör vara ett genomtänkt steg som man bör ta med fullständig säkerhet om den ekonomiska nyttan av att använda dem;
- Många low-code-lösningar fungerar inte alltid bra med GIT / SVN. Antingen är de obekväma att använda om man vill dölja den genererade koden;
- Vid utvidgning av arkitekturen kan det krävas anpassningar av low-code-lösningen – vilket å sin sida skapar en känsla av "bindning och beroende" av leverantören av low-code-lösningen.
- En lämplig säkerhetsnivå är möjlig, men det är väldigt arbetsintensivt och komplext att implementera i low-code-systemens motorer. Low-code-plattformar bör väljas inte bara utifrån förväntad nytta av att använda dem. När man väljer bör man ställa sig frågorna om tillgångshanteringsfunktionalitet och delegiering/eskalering av identifieringsdata på hela organisationens IT-landskap.
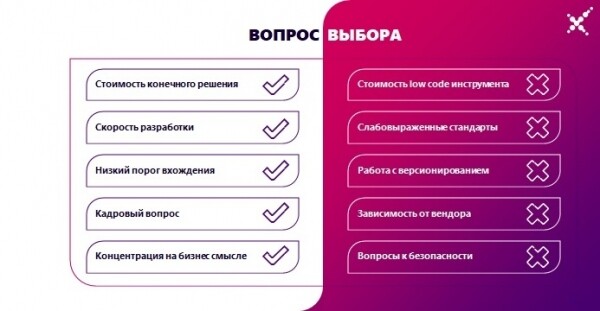
Men om alla nackdelar med det valda systemet är kända, och fördelarna med att använda det ändå dominerar, ska ni gå över till low-code utan att vara rädda. Speciellt eftersom övergången är oundviklig – precis som all evolution.
Om en utvecklare på en low-code-plattform utför sitt arbete snabbare än två utvecklare utan low-code, så ger det företaget ett försprång på alla sätt. Inträdeströskeln för low-code-lösningar är lägre än för "traditionell" teknologi, vilket har en positiv inverkan på problemet med brist på arbetskraft. Genom att använda lågkodverktyg kan samarbetet mellan funktionella team snabbas upp, och beslut om riktigheten av den valda vägen i data science-forskning kan fattas snabbare. Lågkodsplattformar kan bli en drivkraft för digital transformation av organisationen, eftersom de lösningar som skapas kan förstås av icke-tekniska specialister (särskilt företagsanvändare).
Om du har tight tidsramar, komplex affärslogik, brist på teknisk expertis och behöver snabba upp time to market, är low-code ett av sätten att tillfredsställa dina behov.
Det är svårt att förneka betydelsen av traditionella utvecklingsverktyg, men i många fall är användningen av lågkods-lösningar det bästa sättet att öka effektiviteten i de uppgifter som ska lösas.
Källa: habr.com
