

Hej alla! Jag heter Oleg Sidorenkov och jag arbetar som chef för infrastrukturteamet på företaget DomClick. Vi har drivit "Kubik" i produktion i över tre år och har under den tiden haft många intressanta upplevelser med den. Idag kommer jag berätta för er hur man med rätt tillvägagångssätt kan pressa ännu mer prestanda ur "vanillja" Kubernetes för din kluster. Klara, färdiga, gå!
Ni vet alla att Kubernetes är ett skalbart system med öppen källkod för orkestrering av containrar; eller 5 binärer som skapar magi genom att hantera livscykeln av era mikrotjänster i servermiljö. Dessutom är det ett ganska flexibelt verktyg som kan sättas ihop som en Lego-kloss för maximal anpassning till olika uppgifter.
Och allt verkar bra: släng servrar i klustret som ved i en kamin och ha inga bekymmer. Men om du bryr dig om miljön, börjar du tänka: "Hur kan jag hålla elden i kaminen och samtidigt vårda skogen?". Med andra ord, hur kan man hitta sätt att förbättra infrastrukturen och sänka kostnaderna.
1. Håll koll på resurserna för team och applikationer
En av de mest grundläggande men effektiva metoderna är att införa requests/limits. Dela upp applikationerna i namespaces, och namespaces efter utvecklingsteam. Ange resursvärden för CPU-tid, minne och ephemeral lagring för applikationen innan deployment.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Genom erfarenhet har vi kommit fram till att man inte bör öka requests mer än dubbelt så mycket som limits. Klusterstorleken beräknas utifrån requests, och om du ger applikationerna en skillnad i resurser, till exempel 5-10 gånger, så föreställ dig vad som kommer hända med din nod när den fylls med pods och plötsligt får belastning. Inget bra. Minst throttling, och som värst, kan du säga hejdå till workern och få en cyklisk belastning på de andra noderna efter att pods börjar flytta.
Dessutom, med hjälp av limitranges kan du vid starten ange resursvärden för containern - minimala, maximala och standard:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Kom ihåg att begränsa resurserna i namnutrymmet, så att inget team kan ta alla resurser i klustret:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Som framgår av beskrivningen resourcequotas, om teamet ops vill distribuera pods som kommer att konsumera ytterligare 10 cpu, så kommer schemaläggaren inte att tillåta detta och ge ett felmeddelande:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10För att lösa en sådan uppgift kan man skriva ett verktyg, till exempel som , som kan lagra och commita tillståndet för resurserna i teamen.
2. Välj ett optimalt filsystem
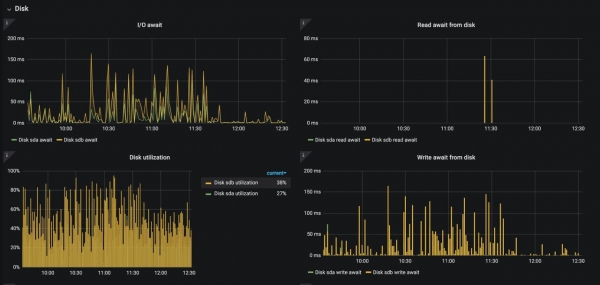
Här skulle jag vilja ta upp ämnet om persistenta volymer och lagringssystemet på worker-noder i Kubernetes. Jag hoppas att ingen använder "Kuben" på HDD i produktion, men ibland är även en vanlig SSD för lite. Vi har stött på sådana problem där loggarna dödade disken på grund av in- och utdataoperationer, och här finns det inte så många lösningar:
Använd högpresterande SSD eller övergå till NVMe (om du själv ansvarar för din hårdvara).
Minska loggnivån.
Gör en "smart" belastningsbalansering av pods som sliter på disken (
podAntiAffinity).
Skärmen ovan visar vad som händer med nginx-ingress-controller och disken när loggningen av access_logs är aktiverad (~12 000 loggar/sek.). Detta tillstånd kan självklart leda till försämring av alla applikationer på denna nod.
När det gäller PV har jag tyvärr inte testat alla Beständiga volymer. Använd det bästa alternativet som passar just dig. Historiskt sett har en liten del av våra tjänster behövt RWX-volymer, och för länge sedan började vi använda NFS-lagring för det. Billigt och… räcker till. Självklart har vi fått mycket skit med det — var så god, men vi har lärt oss att finjustera det, och vi har inte längre huvudvärk. Om möjligt, övergå till S3 objektlagring.
3. Samla optimerade bilder
Det är bäst att använda bilder som är optimerade för containrar, så att Kubernetes kan hämta dem snabbare och köra dem effektivare.
Optimering innebär att bilder:
innehåller endast en applikation eller utför endast en funktion;
är små i storlek, eftersom stora bilder sämre överförs över nätverket;
har slutpunkter för hälsokontroll och beredskap, som Kubernetes kan använda för att vidta åtgärder vid driftsstopp;
använder containervänliga operativsystem (som Alpine eller CoreOS), som är mer motståndskraftiga mot konfigurationsfel;
använder flertrinsbyggen så att du endast kan distribuera kompilerade applikationer, inte tillhörande källkoder.
Det finns många verktyg och tjänster som kan kontrollera och optimera bilder i realtid. Det är viktigt att alltid hålla dem uppdaterade och verifierade för säkerhet. I slutändan får du:
Minskad nätverksbelastning på hela klustret.
Förkortad starttid för containrar.
Mindre storlek på hela din Docker-registry.
4. Använd DNS-cache
När vi pratar om hög belastning är det ganska plågsamt att leva utan finjustering av klustrets DNS-system. För länge sedan stödde Kubernetes-utvecklarna sin egen lösning kube-dns. Den implementerades även hos oss, men mjukvaran fick ingen finjustering och visade inte den prestanda vi behövde, även om uppgiften verkade enkel. Sedan kom coredns, som vi övergick till och som fungerade utmärkt, och blev senare standard DNS-tjänsten i K8s. Vid en tidpunkt nådde vi 40 000 rps till DNS-systemet, och den lösningen blev också otillräcklig. Men av en lycklig slump kom Nodelocaldns, även känd som node local cache, även kallad .
Varför använder vi detta? Det finns en bugg i Linux-kärnan som vid flera förfrågningar genom conntrack NAT över UDP leder till ett race condition för skrivning till conntrack-tabellerna, och en del trafik genom NAT går förlorad (varje besök genom Tjänsten är NAT). Nodelocaldns löser detta problem genom att eliminera NAT och uppgradera anslutningen till TCP för upstream DNS, samt lokal cache för DNS-förfrågningar mot upstream (inklusive en kort negativ cache på 5 sekunder).
5. Skala poddar horisontellt och vertikalt automatiskt
Kan du med säkerhet säga att alla dina mikrotjänster är redo för en två- till trefaldig ökning av belastningen? Hur ska resurser fördelas till dina applikationer? Att ha ett par poddar igång över arbetsbelastningen kan visa sig vara överflödigt, medan att köra alldeles för nära gränsen riskerar att orsaka stillestånd vid en plötslig ökning av trafik till tjänsten. Den gyllene medelvägen nås med hjälp av förmågan att skala sådana tjänster som och .
VPA möjliggör att automatiskt justera requests/limits för dina containrar i en pod baserat på faktisk användning. Hur kan det vara användbart? Om du har poddar som av någon anledning inte kan skalas horisontellt (vilket inte är helt tillförlitligt), kan du prova att låta VPA justera dess resurser. Dess funktion är ett rekommendationssystem baserat på historiska och aktuella data från metric-server, så om du inte vill ändra requests/limits automatiskt, kan du helt enkelt övervaka de rekommenderade resurserna för dina containrar och optimera inställningarna för att spara processor- och minnesanvändning i klustret.
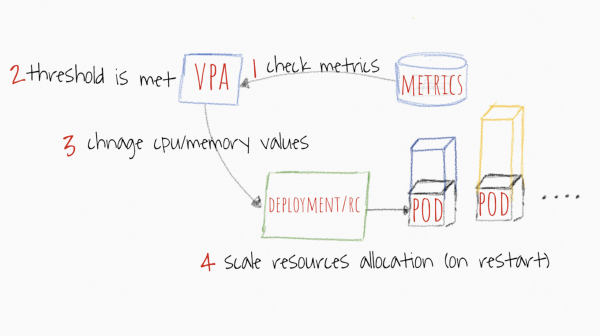 Bild tagen från https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Schemaläggaren i Kubernetes baseras alltid på requests. Vilket värde du än anger där, kommer schemaläggaren att söka efter en lämplig nod baserat på det. Värdena för limits behövs av kubelet för att förstå när den ska begränsa eller döda en pod. Och eftersom den enda viktiga parametern är värdet för requests, kommer VPA att arbeta med detta. Varje gång du ställer in vertikal skalning av applikationen definierar du vilka requests som ska gälla. Men vad händer då med limits? Detta parameter kommer också att skalas proportionellt.
Till exempel, här är vanliga inställningar för en pod:
resurser:
   begärningar:
     minne: 250Mi
     cpu: 200m
   gränser:
     minne: 500Mi
     cpu: 350m
Rekommendationssystemet bestämmer att din applikation behöver 300m CPU och 500Mi för att fungera normalt. Du får följande inställningar:
resurser:
   begärningar:
     minne: 500Mi
     cpu: 300m
   gränser:
     minne: 1000Mi
     cpu: 525m
Som nämnts ovan är detta proportionell skalning baserat på förhållandet mellan begärningar/gränser i manifestet:
CPU: 200m → 300m: förhållande 1:1.75;
Minne: 250Mi → 500Mi: förhållande 1:2.
När det gäller HPA, är mekanismen här tydligare. Tröskelvärden för metrik, som CPU och minne, ställs in, och om det genomsnittliga värdet för alla repliker överstiger tröskeln, skalas applikationen upp med +1 podd tills värdet sjunker under tröskeln eller det maximala antalet repliker uppnås.
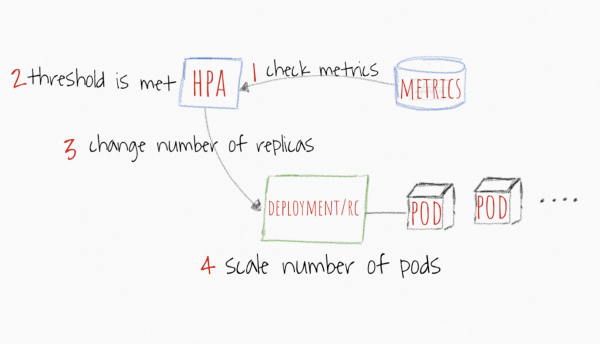 Bild tagen från https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Utöver vanliga metrik som CPU och minne kan du ställa in trösklar för dina egna anpassade metrik från Prometheus och arbeta med dem om du anser att det är den mest precisa definieringen av när du bör skala din applikation. När applikationen stabiliseras under den angivna gränsen för metrik, kommer HPA att börja skala ner poddar till det minimala antalet repliker eller tills lasten uppfyller den angivna tröskeln.
6. Glöm inte Node Affinity och Pod Affinity
Inte alla noder arbetar med samma hårdvara, och inte alla poddar behöver köra applikationer som kräver intensiva beräkningar. Kubernetes tillåter specialisering av noder och poddar med hjälp av Node Affinity och Pod Affinity.
Om du har noder som är lämpade för beräkningstunga operationer, är det bäst att knyta applikationerna till dessa noder för maximal effektivitet. Använd nodeSelector med nodens märkning.
Anta att du har två noder: en med CPUType=HIGHFREQ och många snabba kärnor, och den andra med MemoryType=HIGHMEMORY mycket minne och högre prestanda. Det enklaste sättet är att tilldela distributionen av podden till noden HIGHFREQ, genom att lägga till denna selektor i spec :
…
nodeSelector:
	CPUType: HIGHFREQ
Ett mer kostsamt och specifikt sätt att göra detta är att använda nodeAffinity i fältet affinity i sektionen spec. Det finns två alternativ:
requiredDuringSchedulingIgnoredDuringExecution: strikt konfiguration (planeraren kommer att distribuera poddar endast på specifika noder (och ingen annanstans));preferredDuringSchedulingIgnoredDuringExecution: mjuk konfiguration (planeraren kommer att försöka distribuera på specifika noder, och om det misslyckas kommer den att försöka distribuera på den nästa tillgängliga noden).
Du kan ange en specifik syntax för nodernas etikettkontroll, till exempel, In, NotIn, Exists, DoesNotExist, Gt eller Lt. Men kom ihåg att komplexa metoder i långa listor med etiketter kan fördröja beslutsfattandet i kritiska situationer. Med andra ord, gör det inte mer komplicerat.
Som nämnts ovan tillåter Kubernetes att ange bindning av nuvarande pods. Det vill säga att du kan göra så att vissa pods arbetar tillsammans med andra pods i samma tillgänglighetszon (relevant för molntjänster) eller noder.
I podAffinity fält affinity i sektionen spec är desamma som vid nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution och preferredDuringSchedulingIgnoredDuringExecution. Den enda skillnaden är att matchExpressions binder pods till noder där en pod med sådan etikett redan körs.
Dessutom erbjuder Kubernetes ett fält podAntiAffinity, vilket å sin sida inte binder en pod till en nod med specifika pods.
När det gäller uttryck nodeAffinity kan samma råd ges: försök att hålla reglerna enkla och logiska, försök inte överbelasta pod-dokumentationen med en komplicerad uppsättning regler. Det är mycket lätt att skapa en regel som inte kommer att uppfylla klustrets villkor, vilket skapar onödig belastning på planeraren och minskar den totala prestandan.
7. Taints & Tolerations
Det finns också ett annat sätt att hantera planeraren. Om du har ett stort kluster med hundratals noder och tusentals mikrotjänster, är det mycket svårt att förhindra vissa pods från att placeras på vissa noder.
Detta underlättas av mekanismen taints — förbud regler. Till exempel kan man i vissa scenarier förbjuda vissa noder att köra pods på sig. För att tillämpa en taint på en viss nod bör du använda alternativet taint i kubectl. Ange nyckel och värde, och sedan taint som NoSchedule eller NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleDet är också värt att notera att taint-mekanismen stöder tre grundläggande effekter: NoSchedule, NoExecute och PreferNoSchedule.
NoSchedulebetyder att så länge det inte finns någon motsvarande post i pod-specifikationentolerations, kan den inte distribueras på noden (i detta exempelnode10).PreferNoSchedule— en förenklad versionNoSchedule. I detta fall kommer planeraren att försöka undvika att distribuera pods utan motsvarande posttolerationstill noden, men detta är ingen strikt begränsning. Om det inte finns några resurser i klustret, kommer pods att börja distribueras på denna nod.NoExecute— denna effekt utlöser omedelbar evakuering av pods som inte har någon motsvarande posttolerations.
Intressant nog kan sådant beteende ångras med hjälp av toleranser. Detta är användbart när det finns en "förbjuden" nod och du behöver placera enbart infrastrukturtjänster på den. Hur gör man detta? Tillåt endast de pods för vilka det finns en lämplig tolerans.
Så här kommer pod-specifikationen att se ut:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Detta betyder inte att vid nästa redeployment kommer podden att gå på just denna nod, det är inte mekanismen för Node Affinity och nodeSelector. Men genom att kombinera flera funktioner kan du uppnå en mycket flexibel konfiguration av schemaläggaren.
8. Ställ in prioritet för distribution av pods
Det faktum att du har konfigurerat bindning av pods till noder betyder inte att alla pods ska behandlas med samma prioritet. Till exempel kan du vilja distribuera vissa pods tidigare än andra.
Kubernetes erbjuder olika sätt att konfigurera prioriteringar för pods (Pod Priority and Preemption). Konfigurationen består av flera delar: objektet PriorityClass och beskrivningen av fältet priorityClassName i pod-specifikationen. Låt oss titta på ett exempel:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Denna prioritetsklass bör endast användas för mycket viktiga pods"
Vi skapar PriorityClass, ger den ett namn, en beskrivning och ett värde. Ju högre value, desto högre prioritet. Värdet kan vara vilket 32-bit heltal som helst, mindre eller lika med 1 000 000 000. Högre värden är reserverade för kritiskt viktiga system-pods som vanligtvis inte kan bli avvisade. Avvisning kommer att ske endast om den högprioriterade podden inte har någonstans att distribuera, då kommer vissa pods från en viss nod att evakueras. Om detta mekanism är för sträng kan du lägga till alternativet preemptionPolicy: Never, och då blir det ingen avvisning, podden kommer att stå först i kön och vänta på att schemaläggaren hittar lediga resurser för den.
Därefter skapar vi en pod där vi anger namnet priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Du kan skapa hur många prioritetsklasser som helst, men det rekommenderas att man inte överdriver (låt oss säga, begränsa sig till låg, medelhög och hög prioritet).
På så sätt kan du, om det behövs, öka effektiviteten i distribueringsassistenter för kritiska tjänster som nginx-ingress-controller, coredns osv.
9. Optimera ETCD-klustret
ETCD kan beskrivas som hjärnan i hela klustret. Det är mycket viktigt att hålla denna databas på hög nivå, eftersom hastigheten på operationerna i "Kub" beror på den. Ett ganska standard och samtidigt bra alternativ är att hålla ETCD-klustret på master-noder för att få minimal fördröjning till kube-apiserver. Om det inte är möjligt, placera ETCD så nära som möjligt, med bra bandbredd mellan deltagarna. Tänk också på hur många noder av ETCD som kan falla bort utan att skada klustret.
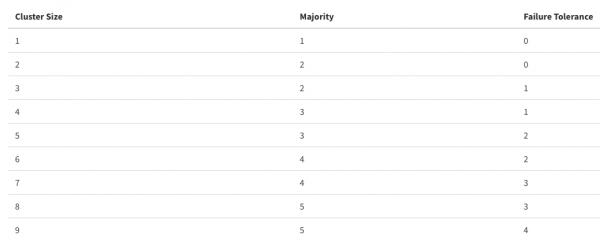
Tänk på att en överdriven ökning av antalet deltagare i klustret kan förbättra tillgängligheten på bekostnad av prestanda; allt bör vara i balans.
När det gäller att konfigurera tjänsten finns det inte så många rekommendationer:
Ha bra hårdvara, baserat på klustrets storlek (du kan läsa mer ).
Finjustera några parametrar, om du har spridit klustret över ett par datacenter eller om ditt nätverk och dina diskar lämnar mycket att önska (du kan läsa mer ).
Slutsats
I den här artikeln beskrivs punkterna som vårt team försöker följa. Det här är inte en steg-för-steg-beskrivning av åtgärder, utan alternativ som kan vara användbara för att optimera kostnaderna för klustret. Det är klart att varje kluster är unikt och inställningarna kan variera mycket, så det skulle vara intressant att få din feedback: hur övervakar du ditt Kubernetes-kluster och hur förbättrar du dess prestanda? Dela med dig av din erfarenhet i kommentarerna, det skulle vara intressant att höra.
Källa: habr.com
