

Under the years of using Kubernetes in production, we have accumulated quite a few interesting stories about how bugs in various system components led to unpleasant and/or confusing consequences affecting the operation of containers and pods. In this article, we've compiled some of the most common or intriguing instances. Even if you never encounter such situations, reading about these brief detective stories — especially 'from the first hand' — is always engaging, isn't it?
Story 1. Supercronic and Hanging Docker
On one of our clusters, we periodically encountered a 'hanging' Docker, which hindered the normal functioning of the cluster. At the same time, the Docker logs showed the following
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create failed: No space left on device
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
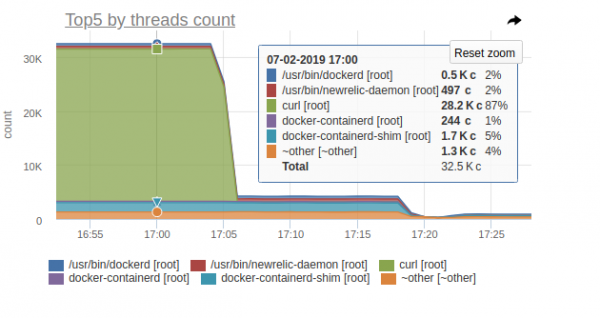
In this error, we are most interested in the message: pthread_create failed: No space left on device. A quick study explained that Docker cannot fork a process, which is why it occasionally 'froze'.
In monitoring, the situation corresponds to the following picture:
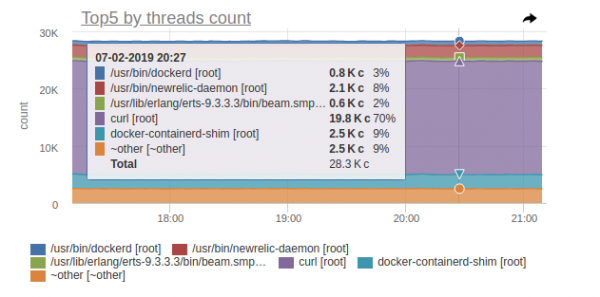
A similar situation is observed on other nodes:
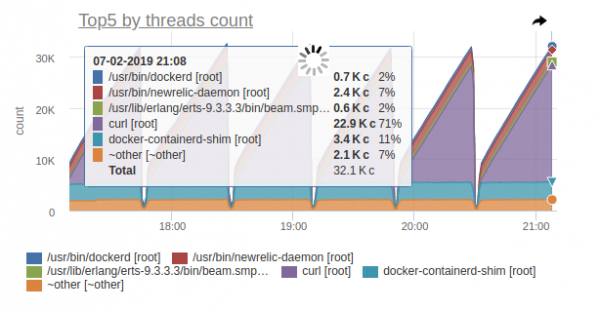
On these same nodes, we see:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
It turned out that this behavior was a consequence of the pod operating with (a Go utility we use to run cron jobs in pods):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
Problemet är följande: när uppgiften körs i supercronic kan den process som den skapar inte avslutas korrekt, vilket gör att den blir .
Anmärkning: För att vara mer exakt skapas processer av cron-uppgifter, men supercronic är inte ett init-system och kan inte "adoptera" processer som dess barn har skapat. Vid uppkomsten av signaler som SIGHUP eller SIGTERM överförs de inte till de skapade processerna, vilket gör att barnprocesserna inte avslutas och förblir i zombistatus. Mer om detta kan man läsa i .
Det finns ett par sätt att lösa problemen:
- Som en tillfällig workaround - öka antalet PID:ar i systemet vid ett och samma tillfälle:
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - Eller göra så att uppgifterna körs i supercronic inte direkt, utan med hjälp av samma , som kan avsluta processer korrekt och inte skapa zombies.
Historia 2. "Zombies" vid borttagning av cgroup
Kubelet började förbruka stora mängder CPU:
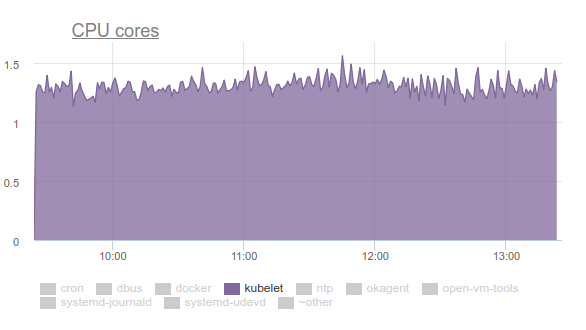
Detta gillar ingen, så vi rustade oss med och började undersöka problemet. Resultatet av utredningen blev följande:
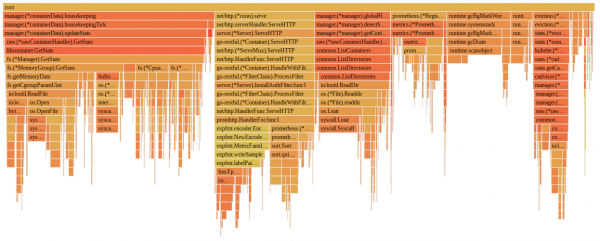
- Kubelet spenderar mer än en tredjedel av sin processor-tid på att hämta data om minnet från alla cgroup:

- I utvecklarutskicken från kärnan kan man hitta . I korthet handlar det om att olika tmpfs-filer och andra liknande objekt inte tas bort helt från systemet vid borttagning av cgroup - så kallade zombies. Så småningom kommer de att tas bort från page cache, men eftersom det finns mycket minne på servern ser kärnan ingen anledning att spendera tid på att ta bort dem. Därför fortsätter de att samlas. Varför händer detta överhuvudtaget? Det är en server med cron-jobb som ständigt skapar nya jobbar, vilket i sin tur skapar nya poddar. På så sätt skapas nya cgroups för containrarna, som snart tas bort.
- Varför spenderar cAdvisor i kubelet så mycket tid? Det är lätt att se med ett enkelt kommando.
time cat /sys/fs/cgroup/memory/memory.stat. På en frisk maskin tar operationen 0,01 sekunder, men på den problematiska cron02 tar den 1,2 sekunder. Problemet är att cAdvisor läser data från sysfs väldigt långsamt och försöker räkna använd minne i zombie cgroups. - För att tvinga bort zombierna, försökte vi rensa cachen, som rekommenderat i LKML:
sync; echo 3 > /proc/sys/vm/drop_caches, — men kärnan visade sig vara mer komplicerad och hängde maskinen.
Vad ska man göra? Problemen fixas (, beskrivningen finns i ) genom att uppdatera Linux-kärnan till version 4.16.
Historia 3. Systemd och dess mount
Återigen använder kubelet för mycket resurser på vissa noder, men denna gång är det minnet:
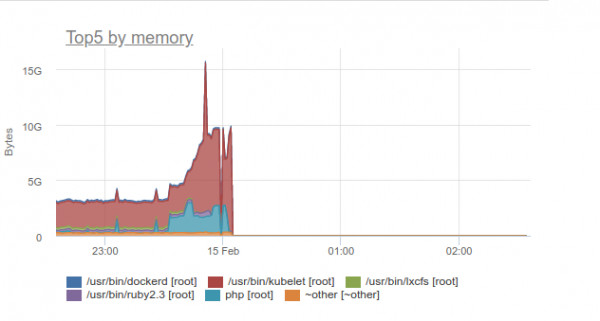
Det visade sig att det finns ett problem med systemd som används i Ubuntu 16.04, och det uppstår när man hanterar mountar som skapas för att montera subPath från ConfigMaps eller secrets. Efter att podden har avslutats förblir systemd-tjänsten och dess hjälpmount i systemet. Med tiden samlas det en stor mängd. Det finns till och med frågor kring detta:
- ;
- .
… där den senaste hänvisar till ett PR i systemd: (issue i systemd — ).
Problemet finns inte längre i Ubuntu 18.04, men om du vill fortsätta använda Ubuntu 16.04 kan vår lösning på detta komma till nytta.
Så vi skapade följande DaemonSet:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… och i den används följande script:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… och det körs var 5:e minut med hjälp av redan nämnda supercronic. Dess Dockerfile ser ut så här:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
Historia 4. Konkurrens vid schemaläggning av poddar
Det har observerats att: om vi har en pod som placeras på en nod och dess bild laddas ner väldigt långsamt, så kommer en annan pod som "hamnade" på samma nod helt enkelt inte att börja ladda ner bilden av den nya podden.Istället väntar den på att bilden av den föregående podden ska laddas ner. Som ett resultat kommer podden som redan har planerats och vars bild skulle kunna laddas ner på bara en minut att förbli under en längre tid i statusen containerCreating.
I händelserna kommer det ungefär att se ut så här:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal pulling image "registry.example.com/infra/openvpn/openvpn:master"Det visar sig att en enda bild från en långsam registry kan blockera distributionen till noden.
Tyvärr finns det inte många lösningar på detta problem:
- Försök att använda ditt Docker Registry direkt i klustret eller direkt med klustret (till exempel GitLab Registry, Nexus osv.);
- Använd verktyg som .
Historik 5. Noder fryser vid minnesbrist
Under driften av olika applikationer har vi också stött på en situation där en nod helt slutar vara tillgänglig: svarar inte på SSH, alla övervakningstjänster släpper, och i loggarna finns det sedan ingenting (eller nästan ingenting) anomalt.
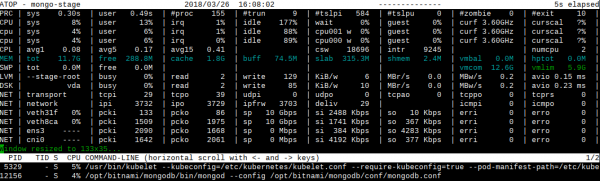
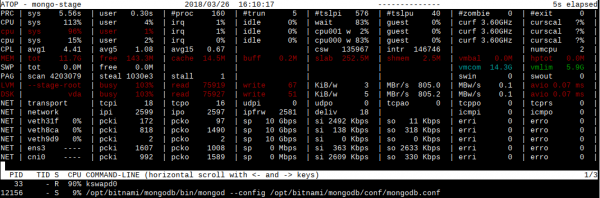
Jag kommer att illustrera med bilder med exempel på en nod där MongoDB fungerade.
Så här ser atop ut till olyckor:
Och så här — efter olyckor:
I övervakningen ses också en plötslig ökning där noden slutar vara tillgänglig:
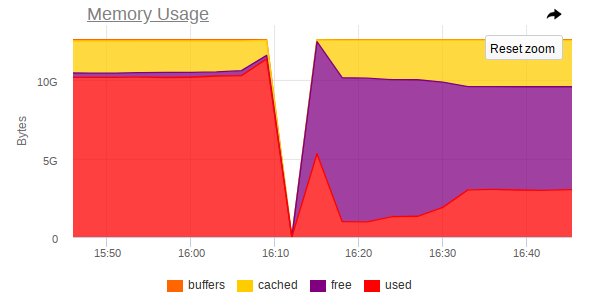
Således framgår det av skärmdumparna att:
- RAM-minnet på maskinen är nästan slut;
- En plötslig ökning av minnesanvändningen observeras, efter vilket åtkomsten till hela maskinen stängs av;
- En stor uppgift kommer till Mongo, vilket får databashanteraren att använda mer minne och aktivt läsa från disken.
Det visar sig att om det fria minnet tar slut i Linux (när minnestryck uppstår) och det inte finns någon swap, så till kan ankomsten av OOM killer leda till ett ekvilibrium mellan att skicka sidor till page cache och att skriva tillbaka dem till disken. Detta hanteras av kswapd, som modigt frigör så många minnessidor som möjligt för efterföljande distribution.
Tyvärr, under stor in-/utdata belastning i kombination med lite fritt minne, blir kswapd flaskhalsen i hela systemet, eftersom det är här alla allokeringar (page faults) av minnessidor i systemet hänger samman. Detta kan pågå under mycket lång tid, om processerna inte vill använda mer minne, utan fastnar på kanten av OOM-killer-avgrunden.
Det är en rimlig fråga: varför kommer OOM killer så sent? I sin nuvarande iteration är OOM killer extremt dum: den dödar en process först när ett försök att allokera en minnessida misslyckas, dvs. om page fault misslyckas. Det tar ganska länge innan detta händer, eftersom kswapd modigt frigör minnessidor genom att spola page cache (i princip hela disk-I/O i systemet) tillbaka till disken. Mer information om de steg som krävs för att lösa sådana problem i kärnan kan läsas .
Detta beteende med kärnan Linux 4.6+.
Historia 6. Podar hänger i status Pending
I vissa kluster där det verkligen finns många pods har vi börjat märka att de flesta av dem "hänger" väldigt länge i status Pending, även om Docker-containrarna redan är igång på noderna och kan arbetas med manuellt.
I detta fall finns det objektet PVC: inte något dåligt:
  Typ     Orsak                   Ålder               Från                     Meddelande
  ----    ------                 ----               ----                     -------
  Normal  Schemalagd             1m                 standard-schemaläggare   Tilldelat sphinx-0 till ss-dev-kub07
  Normal  FramgångsrikBifogadVolym  1m                 attachdetach-controller   AttachVolume.Attach lyckades för volym "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  FramgångsrikMonteradVolym  1m                 kubelet, ss-dev-kub07    MountVolume.SetUp lyckades för volym "sphinx-config"
  Normal  FramgångsrikMonteradVolym  1m                 kubelet, ss-dev-kub07    MountVolume.SetUp lyckades för volym "default-token-fzcsf"
  Normal  FramgångsrikMonteradVolym  49s (x2 under 51s)  kubelet, ss-dev-kub07    MountVolume.SetUp lyckades för volym "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  Hämtad                  43s                kubelet, ss-dev-kub07    Containerbild "registry.example.com/infra/sphinx-exporter/sphinx-indexer:v1" redan närvarande på maskinen
  Normal  Skapad                 43s                kubelet, ss-dev-kub07    Container skapad
  Normal  Startad                 43s                kubelet, ss-dev-kub07    Container startad
  Normal  Hämtad                  43s                kubelet, ss-dev-kub07    Containerbild "registry.example.com/infra/sphinx/sphinx:v1" redan närvarande på maskinen
  Normal  Skapad                 42s                kubelet, ss-dev-kub07    Container skapad
  Normal  Startad                 42s                kubelet, ss-dev-kub07    Container startad
Efter att ha grävt djupare gjorde vi antagandet att kubelet helt enkelt inte hinner skicka all information om podsens status till API-servern, liveness/readiness-prober.
Och efter att ha granskat hjälpen hittade vi följande parametrar:
--kube-api-qps - QPS som ska användas när man pratar med kubernetes apiserver (standard 5)
--kube-api-burst - Burst som ska användas när man pratar med kubernetes apiserver (standard 10)
--event-qps - Om > 0, begränsa händelseproduktion per sekund till detta värde. Om 0, obegränsat. (standard 5)
--event-burst - Maximala storleken för en burstig händelsepost, tillåter tillfälligt händelseposter att blossa upp till detta antal, utan att överskrida event-qps. Används endast om --event-qps > 0 (standard 10)
--registry-qps - Om > 0, begränsa registry pull QPS till detta värde.
--registry-burst - Maximala storleken för burstiga dragningar, tillåter tillfälligt dragningar att blossa upp till detta antal, utan att överskrida registry-qps. Används endast om --registry-qps > 0 (standard 10)
Som man kan se, är standardvärdena - ganska små, och i 90 % av fallen täcker de alla behov... Men i vårt fall visade det sig vara otillräckligt. Så vi ställde in dessa värden:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… och omstartade kubelets, efter vilket vi på API-serverns trafikdiagram såg följande bild:
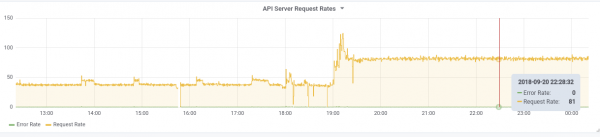
… och ja, allt började flyga!
P.S.
För hjälpen med att samla in buggar och förberedelsen av artikeln vill jag uttrycka stort tack till många ingenjörer i vårt företag, särskilt till kollegan från vårt R&D-team Andrei Klimentiev ().
P.P.S.
Läs även i vår blogg:
- «».
- Kubernetes tips & tricks:
- «»;
- «»;
- «»;
- «».
Källa: habr.com
