

Obs. övers.: författarna till denna artikel är ingenjörer från ett litet tjeckiskt företag pipetail. De har lyckats sammanställa en fantastisk lista över [ibland banala, men ändå] så aktuella problem och missuppfattningar kopplade till användning av Kubernetes-kluster.
Under åren med användning av Kubernetes har vi arbetat med ett stort antal kluster (både hanterade och icke-hanterade — på GCP, AWS och Azure). Med tiden har vi märkt att vissa misstag ständigt upprepas. Men det är inget att skämmas för: vi har själva gjort de flesta av dem!
I artikeln har de vanligaste misstagen samlats och det nämns också hur man kan åtgärda dem.
1. Resurser: begärningar och gränser
Denna punkt förtjänar definitivt mest uppmärksamhet och första plats på listan.
CPU-begäran är vanligtvis antingen inte angiven alls eller har ett mycket lågt värde (för att få plats med så många poddar som möjligt på varje nod). På så sätt blir noder överbelastade. Under hög belastning är processorkapaciteten på noden helt utnyttjad och en specifik arbetsbelastning får endast det den "begärt" genom CPU-throttling. Detta leder till ökad latens i applikationen, tidsavbrott och andra otrevliga konsekvenser. (Läs mer om detta i vår senaste översättning: "" — anm. övers.)
BestEffort (extremt inte rekommenderas):
resources: {}Extremt låg CPU-begäran (extremt inte rekommenderas):
   resources:
      Requests:
        cpu: "1m"
Å andra sidan kan en CPU-gräns leda till obefogad taktförlust för poddar, även om nodens processor inte är helt belastad. Återigen kan detta leda till ökad latens. Det pågår fortfarande diskussioner kring CPU CFS-quota i Linux-kärnan och CPU-throttling beroende på inställda gränser, samt avstängning av CFS-kvoten… Tyvärr kan CPU-gränser orsaka fler problem än de kan lösa. Mer information om detta finns i länken nedan.
Överutnyttjande (overcommitting) av minne kan leda till mer omfattande problem. Att nå CPU-gränsen innebär taktförlust, medan att nå minnesgränsen leder till "mord" på en pod. Har du någonsin sett OOMkill? Да, речь идет именно о нем.
Vill du minimera risken för att detta händer? Undvik att tilldela överdrivna mängder minne och använd Guaranteed QoS (Quality of Service) genom att ställa in memory request som lika med gränsen (som i exemplet nedan). Läs mer om detta i (lead engineer på Zalando).
Burstable (en högre sannolikhet att bli OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Vad kan potentiellt hjälpa vid resursinställningar?
Med hjälp av metrics-server kan användas för att se aktuell CPU-användning och minnesanvändning av pods (och containrar inuti dem). Du använder förmodligen redan det. Utför bara följande kommandon:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Men de visar bara den aktuella användningen. Med detta kan man få en ungefärlig uppfattning om storleksordningen, men i slutändan behövs historik över förändringar i metrik över tid (för att svara på frågor som: «Vad var den högsta CPU-belastningen?», «Hur var lasten igår morse?» — med mera). För detta kan man använda Prometheus, DataDog och andra verktyg. De hämtar bara metrik från metrics-server och lagrar dem, och användaren kan begära dem och skapa motsvarande diagram.
möjliggör automatisera denna process. Den övervakar historiken för CPU- och minnesanvändning och justerar nya requestar och gränser baserat på denna information.
Effektiv användning av beräkningsresurser är en utmaning. Det är som att ständigt spela Tetris. Om du betalar för mycket för beräkningsresurser med låg genomsnittlig användning (låt oss säga ~10 %), rekommenderar vi att titta på produkter som är baserade på AWS Fargate eller Virtual Kubelet. De är byggda på en serverless/pay-per-usage-betalningsmodell, vilket kan vara billigare under sådana omständigheter.
2. Liveness- och readiness probes
Liveness- och readiness-prover är inte aktiverade som standard i Kubernetes. Och ibland glömmer man att aktivera dem...
Men hur kan man annars initiera en omstart av tjänsten vid en oåterkallelig fel? Och hur vet lastbalanseraren att en viss pod är redo att ta emot trafik? Eller att den kan hantera mer trafik?
Dessa prover förväxlas ofta med varandra:
- Liveness — en kontroll av "livskraft", som startar om podden vid ett misslyckande;
- Readiness — en kontroll av beredskap, som vid misslyckande kopplar bort podden från Kubernetes-tjänsten (detta kan kontrolleras med
kubectl get endpoints) och ingen trafik kommer att gå till den förrän nästa kontroll är framgångsrik.
Båda dessa kontroller GENOMFÖRS UNDER HELA LIVSCYKELN FÖR PODDEN. Det är mycket viktigt.
Det är en vanlig missuppfattning att readiness-prover endast körs vid starten, så att lastbalanseraren kan avgöra att podden är redo (Redo) och kan börja ta emot trafik. Men detta är bara en av deras tillämpningar.
En annan är möjligheten att upptäcka att trafiken till podden är överdriven och översvämmar den (eller att podden utför resurskrävande beräkningar). I detta fall hjälper readiness-kontrollen till att minska belastningen på podden och "kyls" ner den. En framgångsrik avslutning av readiness-kontrollen i framtiden tillåter att åter öka belastningen på podden. I det här fallet (vid misslyckande av readiness-proven) skulle ett misslyckande i liveness-kontrollen vara mycket kontraproduktivt. Varför starta om en podd som är frisk och arbetar för fullt?
Därför är det i vissa fall bättre att inte ha kontroller alls än att aktivera dem med felaktigt inställda parametrar. Som nämnts ovan, om liveness-kontrollen speglar readiness-kontrollen, så har ni stora problem. Ett möjligt alternativ är att ställa in , och åtsidan.
Båda typerna av kontroller bör inte misslyckas vid fall av gemensamma beroenden, annars leder det till en kaskad (lavinliknande) nedstängning av alla poddar. Med andra ord, .
3. LoadBalancer för varje HTTP-tjänst
Sannolikt har ni HTTP-tjänster i klustret som ni vill exponera för omvärlden.
Om ni öppnar tjänsten som typ: LoadBalancer, kommer dess controller (beroende på tjänsteleverantören) att tillhandahålla och samordna en extern LoadBalancer (inte nödvändigtvis som arbetar på L7, snarare på L4), och detta kan påverka kostnaden (extern statisk IPv4-adress, beräkningskraft, sekundtidsprissättning) på grund av behovet av att skapa ett stort antal sådana resurser.
I detta fall är det mycket mer logiskt att använda en extern lastbalanserare, och öppna tjänster som typ: NodePort. Eller ännu bättre, distribuera något som nginx-ingress-controller (eller traefik), som kommer att agera som den enda NodePort endpunkten kopplad till den externa lastbalanseraren och kommer att dirigera trafiken i klustret via ingress-resurser i Kubernetes.
Andra interna (mikro)tjänster som interagerar med varandra kan "kommunicera" via tjänster av typen ClusterIP och den inbyggda tjänstupptäcktsmekanismen via DNS. Använd endast deras offentliga DNS/IP med försiktighet, då detta kan påverka latensen och leda till ökade kostnader för molntjänster.
4. Automatisk skalning av klustret utan hänsyn till dess specifika egenskaper
När noder läggs till eller tas bort från klustret bör man inte förlita sig på vissa grundläggande metrik, som CPU-användning på dessa noder. Planering av poddar bör göras med hänsyn till ett flertal begränsningar, som pod-/nodenärhet, taints och toleranser, resursförfrågningar, QoS, osv. Användning av en extern autoscaler som inte beaktar dessa nuances kan leda till problem.
Tänk dig att en viss pod måste planeras, men all tillgänglig CPU-kraft har begärts/allokerats och podden fastnar i tillståndet Pending. Den externa autoscaleren ser den genomsnittliga aktuella CPU-belastningen (inte begärd) och initierar inte en utvidgning (scale-out) — lägger inte till ytterligare en nod. Som ett resultat kommer den aktuella podden inte att planeras.
Samtidigt är omvänd skalning (scale-in) — att ta bort en nod från klustret — alltid svårare att genomföra. Tänk dig att du har en stateful pod (med kopplad persistent lagring). Persistent-volymer hör vanligtvis till ett specifikt tillgänglighetsområde och replikerar inte inom regionen. Om den externa autoscaleren tar bort en nod med denna pod, kommer schemaläggaren inte kunna planera podden på en annan nod, eftersom detta kan göras endast inom det tillgänglighetsområde där den permanenta lagringen finns. Podden kommer att fastna i tillståndet Pending.
Inom Kubernetes-gemenskapen är mycket populär. Den fungerar i klustret, stöder API:er från de största molnleverantörerna, tar hänsyn till alla begränsningar och kan skalas i de ovan nämnda fallen. Den kan även genomföra scale-in under alla satta begränsningar, vilket sparar pengar (som annars skulle spenderas på oanvänd kapacitet).
5. Att ignorera IAM/RBAC-funktionerna
Var försiktig med att använda IAM-användare med permanenta hemligheter för maskiner och applikationer. Ordna tillfällig åtkomst med hjälp av roller och tjänstekonton (service accounts).
Vi stöter ofta på att åtkomstnycklar (och hemligheter) är ‘hårdkodade’ i applikationskonfigurationen och att det finns en vana att inte rotera hemligheterna trots tillgång till Cloud IAM. Använd IAM-roller och tjänstekonton istället för användare där det är lämpligt.
Glöm kube2iam och gå direkt till IAM-roller för tjänstekonton (som beskrivs i Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
En annotation. Inte så svårt, eller hur?
Dessutom, ge inte tjänstekonton och instansprofiler privilegier admin och cluster-admin, om de inte behöver det. Detta är lite svårare att implementera, särskilt i RBAC K8s, men det är definitivt värt ansträngningen.
6. Lita inte på automatisk anti-affinity för pods
Tänk dig att du har tre repliker av en viss deployment på en nod. Noden kraschar, och alla repliker går ner med den. En obehaglig situation, eller hur? Men varför fanns alla repliker på en och samma nod? Ska inte Kubernetes säkerställa hög tillgänglighet (HA)?!
Tyvärr följer Kubernetes-schemaläggaren inte självmant reglerna för separat existens (anti-affinity) för pods. Dessa måste specificeras explicit:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Det är allt. Nu kommer pods att schemaläggas på olika noder (detta villkor kontrolleras bara vid schemaläggning, men inte under deras drift — därav requiredDuringSchedulingIgnoredDuringExecution).
Här pratar vi om podAntiAffinity på olika noder: topologyKey: "kubernetes.io/hostname", — inte om olika tillgänglighetszoner. För att uppnå en komplett HA måste vi gräva djupare i detta ämne.
7. Att ignorera PodDisruptionBudgetar
Tänk dig att du har en produktionsbelastning i en Kubernetes-kluster. Då och då måste noder och hela klustret uppdateras (eller avvecklas). PodDisruptionBudget (PDB) är något som liknar ett garantiavtal om underhåll mellan klusteradministratörer och användare.
PDB gör att man kan undvika avbrott i tjänsterna orsakade av brist på noder:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
I det här exemplet meddelar du som användare av klustret administratorerna: "Hej, jag har en tjänst zookeeper, och oavsett vad ni gör, skulle jag vilja att åtminstone 2 kopior av den här tjänsten alltid är tillgängliga."
Mer information om detta finns att läsa .
8. Flera användare eller miljöer i ett gemensamt kluster
Kubernetes namnrymder (namespaces) ger inte stark isolering.
Det är en vanlig missuppfattning att om man kör en icke-produktions belastning i en namnrymd och en produktionsbelastning i en annan, så kommer de inte att påverka varandra… Men viss nivå av isolering kan uppnås med hjälp av resursförfrågningar/gränser, genom att sätta kvoter, och utse priorityClass:er. En viss "fysisk" isolering i dataglidplanet säkerställs av affiniteter, toleranser, taints (eller nodeselectors), men sådan separation är ganska svår att implementera.
De som behöver kombinera båda typerna av arbetsbelastningar i ett kluster måste acceptera komplexiteten. Om det inte finns något behov av detta, och du har råd att skapa ännu ett kluster (låtom oss säga i det offentliga molnet), så är det bäst att göra så. Det gör att du kan uppnå en mycket högre nivå av isolering.
9. externalTrafficPolicy: Cluster
Vi ser ofta att all trafik in i klustret kommer via en tjänst av typen NodePort, för vilken standardpolicy är inställd på externalTrafficPolicy: Cluster. Det betyder att NodePort öppen på varje nod i klustret, och du kan använda vilken som helst av dem för att interagera med den aktuella tjänsten (uppsättningen av poddar).
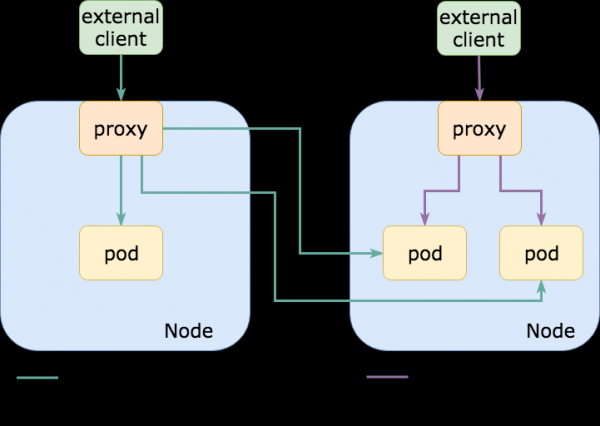
Vid detta tillfälle finns de verkliga poddar som är kopplade till den nämnda NodePort-tjänsten vanligtvis endast på en viss delmängd av dessa noder. Med andra ord, om jag ansluter till en nod där den nödvändiga podden inte finns, kommer den att omdirigera trafiken till en annan nod, och lägga till en transitsträcka (hop) och öka latensen (om noderna finns i olika tillgänglighetszoner/datacenter, kan latensen bli ganska hög; dessutom ökar kostnaderna för egress-trafik).
Å andra sidan, om för en viss tjänst i Kubernetes anges policyn externalTrafficPolicy: Local, så öppnas NodePort endast på de noder där de nödvändiga poddarna faktiskt körs. Vid användning av en extern lastbalanserare som kontrollerar statusen (healthchecking) av endpointar (som görs av AWS ELB), kommer den att skicka trafik endast till de noder som behövs, vilket kommer att påverka latens, beräkningsbehov, utgifter för egress (och sunt förnuft säger detsamma).
Det är stor sannolikhet att du redan använder något liknande traefik eller nginx-ingress-controller som en slutlig NodePort-punkt (eller en LoadBalancer som också använder NodePort) för att dirigera HTTP ingress-trafik, och att aktivera det här alternativet kan avsevärt minska latensen för sådana förfrågningar.
I kan du få veta mer om externalTrafficPolicy, dess fördelar och nackdelar.
10. Bli inte låst vid kluster och missbruka control plane
Tidigare brukade servrar kallas för egna namn: , HAL9000 och Colossus… Idag har de ersatts av slumpmässigt genererade identifierare. Men vanan finns kvar, och nu får kluster egna namn.
En typisk historia (baserad på verkliga händelser): allt började med en konceptbevis, så klustret hade det stolta namnet testing… Åren har gått, och den används fortfarande i produktion, och alla är rädda för att röra vid den.
Det är inget roligt i att kluster blir husdjur, så vi rekommenderar att du regelbundet tar bort dem, samtidigt som du övar på återställning efter fel (detta kan hjälpa med — anm. red.)). Dessutom kan det vara bra att ta hand om control plane (control plane). Rädslan för att röra vid det är inte ett bra tecken. Etcd är död? Grabbar, ni har verkligen hamnat i det!
Å andra sidan, var försiktig med att manipulera det. Med tiden kan control plane bli långsamt. Det beror troligen på det stora antalet skapade objekt utan rotation (ett vanligt problem vid användning av Helm med standardinställningar, vilket gör att dess tillstånd inte uppdateras i configmaps/secrets — resultatet är att tusentals objekt samlas i control plane) eller på konstant redigering av kube-api-objekt (för automatisk skala, för CI/CD, för övervakning, händelseloggar, kontroller osv.).
Dessutom rekommenderar vi att kontrollera SLA/SLO-avtal med din leverantör av managed Kubernetes och uppmärksamma garantierna. Leverantören kan garantera tillgängligheten av control plane (eller dess subkomponenter), men inte p99-latensen för de förfrågningar du skickar till dem. Med andra ord kan du behöva ange kubectl get nodes, och att få svar först efter 10 minuter kommer inte att betraktas som ett brott mot villkoren för tjänsten.
11. Bonus: användning av taggen latest
Det här är verkligen klassisk. På senare tid har vi sett denna teknik ganska sällan, eftersom många, som lärt sig av bitter erfarenhet, har slutat använda taggen :latest och istället börjat låsa (pin) versioner. Hurra!
ECR ; vi rekommenderar att du bekantar dig med denna anmärkningsvärda funktion.
Sammanfattning
Förvänta dig inte att allt fungerar med ett fingerknäpp: Kubernetes är inte en universalmedicin. En dålig applikation (och kanske blir den ännu värre). Försummelse kan leda till överdriven komplexitet, långsam och spänd drift av styrskikten. Dessutom riskerar du att stå utan en katastrofåterställningsstrategi. Räkna inte med att Kubernetes "ur lådan" kommer att se till att isolering och hög tillgänglighet finns. Ta dig tid att göra din applikation verkligt cloud native.
Du kan bekanta dig med misslyckandeerfarenheter från olika team i från Henning Jacobs.
De som vill lägga till listan över misstag som nämns i denna artikel kan kontakta oss på Twitter (, ).
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «» (översikt och video av föreläsningen);
- «».
Källa: habr.com
