

11-12 juli äger konferensen rum i Sankt Petersburg , som handlar om utvecklingen av parallella och distribuerade system. Hydras styrka ligger i att den samlar fantastiska forskare (som vanligtvis endast finns på internationella vetenskapliga konferenser) och kända praktiska ingenjörer i ett stort program som gränsar till vetenskap och praktik.
Hydra är en av de viktigaste konferenserna vi har haft de senaste åren. Den föregicks av en mycket grundlig förberedelse, urval av talare och presentationer. Förra veckan kom det ut ett med direktören för JUG.ru Group, Aleksej Fedotov ().
Vi , om tre viktiga deltagare, grundarna av teorin om distribuerade system — Leslie Lamport, Maurice Herlihy och Michael Scott. Det är dags att prata mer ingående om hela programmet!
Motivation
Om du sysslar med programmering har du på ett eller annat sätt att göra med multitrådning och distribuerade beräkningar. Specialister inom motsvarande områden arbetar direkt med dem, men implicit ser distribuerade system på oss från alla håll: i varje flerkärnig dator eller distribuerad tjänst finns det något som utför beräkningar parallellt.
Det finns många konferenser som belyser olika aspekter av tillämpad programmering. På andra sidan spektrumet har vi specialiserade vetenskapliga skolor, i form av föreläsningar som tar upp enorma mängder komplex teori. Till exempel pågår parallellt med Hydra i Petersburg . På konferensen Hydra har vi försökt sammanföra både hård praktik och vetenskap, och allt det som ligger i skärningspunkten.
Tänk på detta: vi lever i en fantastisk tid då det är möjligt att möta grundarna av det vetenskaps- och ingenjörsområde vi arbetar med. Fysiker träffar varken Newton eller Einstein — tåget har gått. Men bredvid oss lever fortfarande de som skapade grunderna för teorin om distribuerade system, uppfann populära programmeringsspråk, och först genomförde allt detta i fungerande prototyper. Dessa människor har inte övergivit sitt arbete halvvägs, utan arbetar just nu med aktuella frågor på världskända universitet och företag, och är idag de största källorna till kunskap och erfarenhet.
Å andra sidan är möjligheten att träffa dem oftast rent teoretisk: få av oss kan ständigt övervaka offentliga evenemang på något universitet i Rochester för att sedan snabbt resa till USA och tillbaka till en föreläsning med Michael Scott. Att besöka alla deltagare i Hydra skulle kosta en hel del, utan att räkna med den oändliga mängden tid som skulle gå (även om det låter som en intressant quest).
Å andra sidan har vi många topptekniker som just nu arbetar med aktuella problem inom distribuerade system, och de har definitivt något att berätta. Men problemet är att de fungerar, och deras tid är dyr. Ja, om du är anställd hos Microsoft, Google eller JetBrains ökar sannolikheten att träffa en av de kända talarna på ett internt evenemang dramatiskt, men generellt - nej, det händer inte varje dag.
Därför fyller konferensen Hydra en viktig uppgift som de flesta av oss inte kan göra själva – i en och samma plats och vid en och samma tid samlar människor vars idéer eller kommunikation kan förändra ditt liv. Jag medger att inte alla behöver distribuera system eller komplexa fundamentala koncept. Man kan programmerar CRUD-applikationer i PHP hela livet och ändå vara helt lycklig. Men för de som behöver det – det är din chans.
Sedan den första annonseringen av konferensen Hydra på Habr har det gått ganska mycket tid. Under denna tid har ett enormt arbete gjorts – och nu har vi en lista över nästan alla föredrag. Inga tråkiga entrådiga algoritmer, bara ren distribuerad hardcore! Låt oss avsluta med allmänna ord och se vad vi har nu.
Keynotes
Keynotes inleder och avslutar konferensdagarna. Vanligtvis är syftet med den öppnande keynoten att ställa in den allmänna tonen och riktningen för konferensen. Den avslutande keynoten sammanfattar och förklarar hur vi ska leva med de kunskaper och färdigheter vi fått under konferensens dagar. Början och slutet: det som kommer att minnas bäst och som överhuvudtaget har ökad betydelse.
Cliff Click –
 Cliff är en legend inom Java-världen. I slutet av 90-talet skrev han en avhandling med titeln , som efter en tid blev grundlaget for HotSpot JVM Server Compiler. Två år senere arbejdede han allerede hos Sun Microsystems med JVM og viste verden, at JIT har ret til at eksistere. Hele denne historie om, at Java er en af de hurtigste moderne runtime-miljøer med de smarteste og hurtigste optimeringer, stammer fra Cliff Click. I starten blev det anset for, at hvis noget var tilgængeligt for en statisk compiler, skulle man ikke engang forsøge at JIT’te det. Takket være Cliff og holdets arbejde begyndte alle nye sprog at blive skabt med idéen om JIT-kompilering som standard. Uden tvivl var dette et arbejde, der ikke var for én person, men Cliff spillede en meget vigtig rolle i det.
I den åbnende keynote vil Cliff tale om et andet af sine projekter — , en in-memory platform til distribueret og skalerbar maskinlæring til industriel anvendelse. Mere specifikt — om det distribuerede lagringssystem af "nøgle-værdi" par indeni. Dette er en meget hurtig lagerløsning med masser af interessante egenskaber (den præcise liste findes i ), som tillader brugen af lignende løsninger i matematik til streaming af store data.
En anden præsentation, som Cliff vil give — . En anden del af hans biografi — ti år , hvor han opdaterede og forbedrede meget på hårdvaren og teknologistakken i Azul: JIT-kompilatorer, runtime, trådmodel, fejlhåndtering, arbejde med stakken, hardware-interrupter, klasseindlæsning og så videre — ja, du forstod.
Den mest interessante del begyndte, da de lavede hardware til store virksomheder — en supercomputer til kørsel af Java. Dette var en ret innovativ løsning, der var specifikt designet til Java, der har særlige krav — læsbarhedsbariere for lav-latens affaldssamling, arrays med grænsekontrol, virtuelle opkald… En af de mest imponerende teknologier — hardware-transaktionel hukommelse. Hele L1 fra hver af de 864 kerner kunne deltage i transaktionel skrivning, hvilket er særlig vigtigt for arbejdet med låsninger i Java (synchronized-blokke kan køre parallelt, så længe der ikke er reelle hukommelseskonflikter). Men den smukke idé brast mod den barske virkelighed — og i denne præsentation vil Cliff fortælle, hvorfor HTM og STM ikke egner sig særlig godt til praktiske behov inden for multitrådede beregninger.
Michael Scott —
 — professor i datavetenskap vid University of Rochester, där ödet har förenat honom , och vid sitt hemuniversitet Wisconsin–Madison var han dekan i fem år. Han forskar inom parallell och distribuerad programmering och programmeringsspråk och utbildar studenter inom detta.
Hela världen känner Michael tack vare läroboken , vars senaste upplaga kom relativt nyligen — 2015. Hans arbete har fått är en av de mest kända inom distribuerad databehandling och i onlinebiblioteket vid University of Rochester. Du kanske också känner honom som författaren till den berömda Michael-Scott-algoritmen från .
När det kommer till Java-världen är detta ett särskilt fall: tillsammans med Doug Lea utvecklade han dessa icke-blockerande algoritmer och synkrona köer som Java-biblioteken är baserade på. Det är vad keynote-presentationen «Dubbla datastrukturer» handlar om — implementeringen av dessa strukturer i Java SE 6 har förbättrat prestandan med tio gånger java.util.concurrent.ThreadPoolExecutor. Om du är intresserad av vad dessa «Dubbla datastrukturer» är, så finns det .
Maurice Herlihy —
 — innehavare av hela två Dijkstra-priser. Det första — för arbete vid (Brown University), och det andra, mer nyligen — (Virginia Tech University). Dijkstra-priset tilldelas för arbeten vars betydelse och inflytande har varit märkbara under minst tio år, och det är uppenbart att Maurice är en av de mest kända experterna inom området. För närvarande är han professor vid Brown University och har många prestationer som skulle fylla ett helt stycke.
I denna avslutande keynote kommer Maurice att tala om teorin och praktiken av blockchain-baserade distribuerade system ur ett klassiskt perspektiv av distribuerad databehandling och hur detta förenklar många relaterade problem. Detta är en föreläsning som är helt i konferensens ämne — inte om mining-hype, utan snarare om hur vår kunskap kan användas på en överraskande effektiv och relevant sätt för olika uppgifter.
I juli 2017 besökte Maurice redan Ryssland för SPTDC-skolan, deltog vid JUG.ru-mötet, och inspelningen kan ses på YouTube:
Huvudprogrammet
Här kommer en kort översikt av presentationerna som ingår i programmet. Vissa presentationer beskrivs här i detalj, medan andra är mer kortfattade. Längre beskrivningar har mestadels tilldelats engelskspråkiga presentationer som kräver hänvisningar till vetenskapliga artiklar, termer på Wikipedia, och så vidare. Den fullständiga listan kan . Listan på webbplatsen kommer att uppdateras och kompletteras.
Leslie Lamport —
 Leslie Lamport är författare till grundläggande verk inom distribuerade beräkningar. står för "Lamport TeX". Det var han som först, redan 1979, introducerade konceptet , och hans artikel fick Dijkstra-priset.
Detta är den mest ovanliga delen av programmet i och med att det inte ens är en presentation, utan en frågestund. När en betydande del av publiken redan är bekant (eller kan bli bekant) med olika verk baserade på "Lamports teori", hans egna artiklar och presentationer, är det viktigaste att använda all tillgänglig tid för direkt kommunikation.
Idén är enkel — du ser på YouTube två presentationer: och och förbereder åtminstone en fråga, som Leslie svarar på.
Den första av dessa två videor har vi redan . Om du inte har en timme att se på videon kan du snabbt läsa igenom allt detta i textformat.
Observera: Det finns mycket mer video med Leslie Lamport på YouTube. Till exempel finns det en fantastisk . Offline-versionen av hela kursen finns på , och på YouTube har han laddat upp det för enklare visning på mobila enheter.
Martin Kleppmann —
 Martin Kleppmann är forskare vid Cambridge University som arbetar med CRDT och formell verifiering av algoritmer. Martins bok , publicerad 2017, har blivit mycket framgångsrik och har hamnat på bestsellerlistor inom datalagring och bearbetning. Kevin Scott, CTO på Microsoft, : "Denna bok borde vara obligatorisk för utvecklingsingenjörer. Det är en sällsynt resurs som förenar teori och praktik, vilket hjälper utvecklare att bättre designa och implementera infrastruktur och databehandlingssystem." Något liknande sa även skaparen av Kafka och CTO för Confluent, Jay Kreps.
Innan han började med akademiska studier arbetade Martin inom industrin och var med och grundade två framgångsrika startups:
- Rapportive, som visade sociala profiler för kontakter från din e-post och som LinkedIn köpte 2012;
- Go Test It, en tjänst för automatisk testning av webbplatser i olika webbläsare, som RedGate köpte 2009.
Generellt sett är Martin, även om han är mindre känd än våra huvudtalare, redan i stånd att ha bidragit till både utvecklingen av distribuerad databehandling och industrin.
I denna presentation kommer Martin att tala om ett ämne som är närmare hans akademiska forskning. I Google Docs och liknande program för samredigering av dokument innebär "samredigering" uppgiften att replikera: varje användare har sin egen kopia av det gemensamma dokumentet som de sedan ändrar, och alla ändringar skickas över nätverket till övriga deltagare. Ändringar av dokument offline kan leda till tillfällig inkonsistens i dokumentet i förhållande till de andra deltagarna, och att åter-synkronisera kräver hantering av konflikter. Det är just för detta som det finns (CRDT), som i grunden är en ganska ny idé, vars kärna formulerades först 2011. I denna presentation diskuteras vad som har hänt sedan dess i CRDT-världen, vilka de senaste framstegen är, och tillvägagångssätt för att skapa lokal-först applikationer generellt samt användningen av det öppna biblioteket i synnerhet.
Nästa vecka kommer vi att publicera en stor intervju med Martin på Habré, det kommer att bli intressant.
Pedro Ramalhete —
 Pedro arbetar på Cisco och har under de senaste tio åren utvecklat parallella algoritmer, inklusive synkroniseringsmekanismer, lock-free och wait-free datastrukturer och allt som du kan tänka dig inom detta ämne. Hans aktuella forsknings- och ingenjörsintressen är inriktade på Universal Constructions, Software Transactional Memory, Persistent Memory och liknande teknologier som möjliggör utvecklingen av korrekta, skalbara och felresistenta applikationer. Dessutom är han författare till den välkända bloggen inom nischade kretsar .
De flesta flerlänkade applikationer arbetar nu med parallella datastrukturer, från användandet av meddelandeköer mellan aktörer till indexerade datastrukturer i key-value lagringssystem. I Java JDK har de fungerat framgångsrikt i många år, och i C++ har de långsamt börjat läggas till.
Det enklaste sättet att implementera en parallell datastruktur är en sekventiell (enkelttrådad) implementation där metoderna skyddas av mutexar. Detta är tillgängligt för alla juniorer, men har uppenbara problem med skalbarhet och prestanda. Samtidigt hanterar lock-free och wait-free datastrukturer inte bara fel bättre, utan har även en mer gynnsam prestandaprofil — men för deras utveckling krävs djup expertis och anpassning till den specifika användningen. Ett enda felaktigt kodavsnitt räcker för att bryta allt.
Hur kan vi se till att även icke-experter kan designa och implementera sådana datastrukturer? Det är känt att varje sekventiell algoritm kan göras trådsäker med antingen , eller transaktionell minne. De kan på ett sätt sänka inträdeströskeln för att lösa detta problem. Emellertid leder båda lösningarna generellt till ineffektiva implementationer. Pedro kommer att berätta om hur de lyckades göra dessa konstruktioner mer effektiva och hur de kan användas för sina algoritmer.
Heidi Howard —
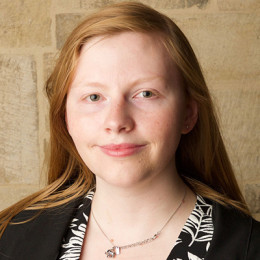 Heidi Howard — liksom Martin, en forskare inom distribuerade system vid Cambridge University. Hennes specialisering är konsistens, felresiliens, prestanda och distribuerad konsensus. Hon är mest känd för generaliseringen av Paxos-algoritmen kallad .
Låt oss påminna om att — en familj av protokoll för att lösa konsensusproblemet i ett nätverk av opålitliga beräknare, som bygger på arbeten av Leslie Lamport. Således arbetar några av våra talare med problem som ursprungligen föreslagits av andra av våra talare — och det är fantastiskt.
Möjligheten att hitta en konsensus mellan flera värdar—för adressering, ledarval, blockering eller samordning—är en grundläggande fråga för moderna distribuerade system. Paxos är nu den främsta metoden för att lösa problem med konsensus, och runt den pågår många forskningar för att utvidga och optimera algoritmen för olika praktiska behov.
I denna rapport kommer vi att se över den teoretiska grunden för Paxos, där vi mildrar de ursprungliga kraven och generaliserar algoritmen. Vi kommer att se att Paxos i grunden bara är en av många alternativ inom ett stort spektrum av konsensusmetoder, och att andra punkter i spektrumet också är mycket användbara för att bygga bra distribuerade system.
Alex Petrov —
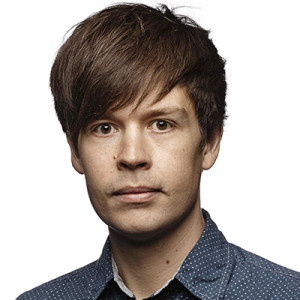 Alex är databas- och lagringssystemexpert, och vad som är viktigast för oss—kommittémedlem i . Tillsammans med O'Reilly arbetar han just nu på boken Database Internals.
För system med (på ryska termen — 'slutlig överensstämmelse'), efter ett knutpunktfel eller nätverksavbrott måste man lösa följande dilemma: antingen fortsätta att utföra förfrågningar, offra konsekvens, eller neka dem och offra tillgänglighet. I ett sådant system kan kvorum, överlappande delmängder av noder som garanterar att åtminstone en nod innehåller det senaste värdet, bli en bra gränslösning. Man kan överleva fel och förlust av anslutning till vissa noder och fortsätta svara med de senaste värdena.
Men allt har sitt pris. Kvorumreplikationsschemat innebär ökade lagringskostnader: det är nödvändigt att lagra redundanta data på flera noder samtidigt för att säkerställa tillräckligt antal tillgängliga kopior vid problem. Det visar sig att man inte behöver lagra all data på alla repliker. Man kan minska belastningen på lagret genom att bara hålla data på en del av noderna och använda speciella noder för felhanteringsscenarier (Transient Replica).
I rapporten kommer vi att titta på , replikationsschemat som används inom och , och implementeringen av detta koncept i Apache Cassandra under namnen .
Dmitry Vyukov —
 Dmitrij är utvecklare på Google, som arbetar med dynamisk testning i C/C++ och Go – Address/Memory/ThreadSanitizer, samt med liknande verktyg för Linux-kärnan. Han har bidragit till en skalbar schemaläggare för gorutiner, nätverkspoller och parallell skräpsamling. Han är expert på multitrådade processer, författare till ett dussin nya icke-blockerande algoritmer och innehavare av Intel.
Nu lite om själva föredraget. Språket Go har inbyggt stöd för multitrådning i form av gorutiner (lätta trådar) och kanaler (FIFO-köer). Tack vare dessa mekanismer är det väldigt enkelt och trevligt för användarna att skriva moderna, multitrådiga applikationer, och det ser ut som magi. Som vi förstår finns det ingen magi här. I detta föredrag kommer Dmitrij att gå djupare in på detaljerna kring Go:s schemaläggare och avslöja hemligheterna bakom denna "magi". Först kommer han att ge en översikt av de viktigaste komponenterna i schemaläggaren, och berätta hur den fungerar. Vidare kommer vi att bekanta oss närmare med specifika aspekter som strategier för parkering/uppackning och hantering av blockerande systemanrop. Slutligen kommer Dmitrij att berätta lite om möjliga förbättringar i schemaläggaren.
Dmitrij Bugaychenko –
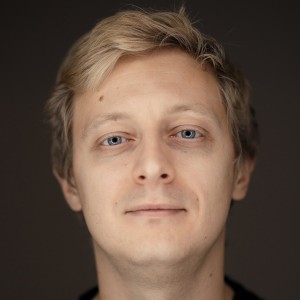 Dmitrij har arbetat nästan 9 år inom outsourcing, utan att tappa kontakten med universitetet och forskarsamhället. Analys av big data på Odnoklassniki blev för honom en unik chans att kombinera teoretisk utbildning och vetenskaplig grund med utveckling av verkliga, efterfrågade produkter.
Distribuerad grafanalys har varit och förblir en svår utmaning: när behovet uppstår att få information om relationen mellan närliggande noder, innebär det ofta att data måste överföras mellan maskiner, vilket leder till ökad exekveringstid och belastning på nätverksinfrastrukturen. I detta föredrag kommer vi att se hur man kan uppnå betydande förbättringar i bearbetningen, genom att använda probabilistiska datakonstruktioner eller fakta som symmetri i vänskapsgrafen i sociala nätverk. Allt detta illustreras med kodexempel på Apache Spark.
Denis Ryscov –
 Denis är utvecklare , expert inom modellkonsistens, konsensusalgoritmer och distribuerade transaktioner. Han arbetar för närvarande på Microsoft och har tidigare arbetat med distribuerade system på Amazon och Yandex.
I den här presentationen kommer vi att bekanta oss med protokoll för distribuerade transaktioner som har utvecklats under de senaste åren och som kan implementeras på klientsidan ovanför vilken databas som helst som stöder villkorlig uppdatering (compare and set). Poängen är att livet inte slutar med en tvåfascommit, transaktioner kan läggas ovanför alla databaser — på applikationsnivå, men olika protokoll (2PC, Percolator, RAMP) har olika avvägningar och är inte gratis.
Alexey Zinovyev —
 Alexey () — vår långvariga talare och medlem av programkommittéer vid andra konferenser. Praktiserande tränare på EPAM Systems, och har arbetat med Hadoop/Spark och annan Big Data sedan 2012.
I den här presentationen kommer Alexey att diskutera problemen med att anpassa klassiska maskininlärningsalgoritmer för att köras i distribuerat läge baserat på sin erfarenhet av Apache Spark ML, Apache Mahout, Apache Flink ML och erfarenheten av att skapa Apache Ignite ML. Alexey kommer också att tala om implementeringen av distribuerade ML-algoritmer i dessa ramverk.
Och avslutningsvis — två presentationer från Yandex om Yandex Database.
Vladislav Kuznetsov —
 Vladislav är utvecklare på Yandex i gruppen för distribuerade plattformar. Yandex Database är en horisontellt skalbar, geo-distribuerad, fail-säker databas som klarar av att hantera disk-, server-, rack- och datacenterfel utan att förlora konsistens. För att säkerställa redundans används en egen algoritm för att uppnå distribuerad konsensus, samt en rad tekniska lösningar som detaljerat beskrivs i presentationen. Presentationen kan vara av intresse för såväl databasutvecklare som utvecklare av applikationer baserade på databasen.
Semyon Checherinda —
 Semyon är utvecklare i gruppen för distribuerade plattformar på Yandex, och arbetar med möjligheten till fleranvändartjänster i YDB-installationen.
Yandex Database är utformad för OLTP-frågor och uppfyller ACID-kraven för transaktionssystem. I rapporten kommer vi att gå igenom algoritmen för transaktionsplanering som ligger till grund för YDB:s transaktionssystem. Vi kommer att analysera vilka entiteter som deltar i transaktionerna, vem som tilldelar transaktionerna en global ordning, hur transaktionernas atomiskhet, tillförlitlighet och strikta isoleringsnivåer uppnås. Genom ett vanligt exempel kommer vi att titta på genomförandet av transaktioner med hjälp av tvåfasiskt åtagande och deterministiska transaktioner. Vi kommer också att diskutera skillnaderna mellan dem.
Vad händer härnäst?
Konferensens program fortsätter att fyllas på med nya presentationer. Specifikt förväntar vi oss en föreläsning från Nikita Koval () från JetBrains och Oleg Anastasyev () från företaget Odnoklassniki. Nikita arbetar med algoritmer för koroutiner i Kotlin-teamet, medan Oleg utvecklar arkitektur och lösningar för högbelastade system på plattformen Odnoklassniki. Dessutom finns det en ledig plats som programkommittén just nu arbetar med kandidater för.
Konferensen Hydra kommer att hållas den 11-12 juli i Sankt Petersburg. Biljetter kan . Vi uppmärksammar på tillgången av onlinebiljetter — om du av någon anledning inte kan komma till Petersburg under dessa dagar.
Vi ses på Hydra!
Källa: habr.com
