

Detta är en myt, ganska utbredd inom serverhardware. I praktiken behövs hyperkonvergerande lösningar (när allt finns i ett) för många olika ändamål. Historiskt sett så utvecklades de första arkitekturerna av Amazon och Google för sina tjänster. Idén var då att skapa en beräkningsfarm bestående av identiska noder, där var och en har sina egna diskar. Allt detta kopplades samman av någon form av systemorienterad mjukvara (hypervisor) och delades sedan upp i virtuella maskiner. Huvudsyftet var att minimera ansträngningen för att underhålla en nod och minimera problem vid skalning: man köpte helt enkelt ytterligare tusen av liknande servrar och kopplade dem bredvid. I praktiken handlar det om enskilda fall, och oftare rör det sig om ett mindre antal noder och en något annorlunda arkitektur.
Men fördelen förblir densamma – otrolig enkelhet i skalning och hantering. Nackdelen – olika uppgifter konsumerar resurser på olika sätt, och på vissa ställen kommer det att finnas gott om lokala diskar, medan andra har för lite RAM och så vidare, vilket innebär att resursutnyttjandet kommer att falla vid olika typer av uppgifter.
Det visade sig att man betalar 10–15 % mer för bekvämligheten med konfigurationen. Detta skapade myten i rubriken. Vi letade länge efter var teknologin skulle tillämpas optimalt, och vi fann det. Faktum är att Cisco inte hade sina egna lagringssystem, men de ville ha hela servermarknaden. Och de skapade Cisco Hyperflex – en lösning med lokala lagringssystem på noder.
Och plötsligt blev detta en mycket bra lösning för backupdatacenter (Disaster Recovery). Varför och hur – det berättar jag nu. Och jag kommer att visa tester av klustret.
Där det behövs
Hyperkonvergens är:
- Överflyttning av diskar till beräkningsnoder.
- Fullständig integration av lagringssystemet med virtualiseringssystemet.
- Överföring/integration med nätverksystemet.
Denna koppling möjliggör implementering av många funktioner i lagringssystem på virtualiseringsnivå och allt från ett och samma hanteringsfönster.
I vårt företag är projekt för design av backupdatacenter mycket efterfrågade, och man väljer ofta just hyperkonvergerande lösningar på grund av sina många replikationsalternativ (ända till metrokluster) direkt ur lådan.
När det gäller backup-datacenter handlar det vanligtvis om en avlägsen plats i en annan del av staden eller till och med i en annan stad. Det tillåter återställning av kritiska system vid delvis eller total nedgång av det primära datacentret. Data från försäljningen replikeras ständigt dit, och denna replikering kan ske antingen på applikationsnivå eller på blocklagringsenhetsnivå (SAN).
Därför kommer jag nu att berätta om systemets struktur och tester, och sedan om några scenarier för verklig tillämpning med data om besparingar.
Tester
Vår instans består av fyra servrar, där varje server har 10 SSD-diskar på 960 GB. Det finns en dedikerad disk för cachning av skrivoperationer och lagring av en service virtuell maskin. Själva lösningen är den fjärde versionen. Den första var uppenbarligen ganska bristfällig (enligt recensionerna), den andra var också lite bristfällig, den tredje är redan tillräckligt stabil, och denna kan kallas en release efter att beta-testningen avslutats offentligt. Under testningen såg jag inga problem, allt fungerar som en klocka.
Ändringar i v4En mängd buggar har fixats.
Ursprungligen kunde plattformen endast arbeta med hypervisorn VMware ESXi och stödde ett begränsat antal noder. Dessutom avslutades inte alltid distributionsprocessen framgångsrikt, vissa steg fick startas om, det fanns problem med att uppdatera från äldre versioner och datan i GUI visades inte alltid korrekt (även om jag fortfarande inte är imponerad av hur prestandadiagrammen visas), ibland uppstod problem i samband med virtualisering.
Nu är alla barnsjukdomar åtgärdade, HyperFlex kan hantera både ESXi och Hyper-V, plus att det är möjligt att:
- Skapa ett distribuerat kluster.
- Skapa ett kontor-kluster utan att använda Fabric Interconnect, från två till fyra noder (vi köper bara servrar).
- Möjlighet att arbeta med externa SAN.
- Stöd för containrar och Kubernetes.
- Skapa tillgänglighetszoner.
- Integration med VMware SRM, om den inbyggda funktionen inte är tillfredsställande.
Arkitekturen skiljer sig inte mycket från konkurrenternas lösningar, så vi skapade inte något nytt. Allt körs på virtualiseringsplattformen VMware eller Hyper-V. Det är fysiskt placerat på servrar av egen design, Cisco UCS. Det finns de som hatar plattformen på grund av den relativt komplexa initiala konfigurationen, många knappar, en icke-trivial system av mallar och beroenden, men det finns också de som har upplevt zen, förstått konceptet och inte längre vill arbeta med andra servrar.
Vi kommer att titta på lösningen för VMware, eftersom den ursprungligen skapades för detta och har mer funktionalitet. Hyper-V har utvecklats under vägen för att inte halka efter konkurrenterna och för att motsvara marknadens förväntningar.
Det finns en kluster av servrar fyllda med diskar. Det finns diskar för datalagring (SSD eller HDD - efter eget val och behov), och en SSD-disk för cachning. Vid skrivning av data på datalagringen sker lagring av data på cachningslagret (dedikerad SSD-disk och RAM från service-VM). Samtidigt skickas en datablokk till noderna i klustret (antalet noder beror på faktorn för klustrets replikering). Efter bekräftelse från alla noder om framgångsrik skrivning skickas bekräftelsen till hypervisorn och vidare till VM. Skrivna data dedupliceras, komprimeras och lagras på lagringsdiskar i bakgrunden. Under detta skrivs alltid ett stort block på lagringsdiskarna sekventiellt, vilket minskar belastningen på lagringsdiskarna.
Deduplicering och komprimering är ständigt aktiverat och kan inte stängas av. Läsning av data sker direkt från lagringsdiskarna eller från RAM-cache. Om en hybridkonfiguration används cachas även läsning på SSD-disk.
Data är inte bundna till den aktuella platsen för den virtuella maskinen och fördelas jämnt mellan noderna. Denna metod gör det möjligt att belasta alla diskar och nätverksgränssnitt lika. Det finns en uppenbar nackdel: vi kan inte maximalt minska läsfördröjningen, eftersom det inte finns någon garanti för att data finns lokalt. Men jag anser att detta är en obetydlig uppoffring jämfört med de fördelar vi får. Dessutom har nätverksfördröjningar nått sådana nivåer att de nästan inte påverkar det slutgiltiga resultatet.
En specialiserad tjänste-VM, Cisco HyperFlex Data Platform-kontrollern, ansvarar för hela logiken i diskresursens arbete och skapas på varje lagringsnod. I vår konfiguration tilldelades tjänste-VM åtta vCPU och 72 GB RAM, vilket inte är så lite. Jag påminner om att värden själv har 28 fysiska kärnor och 512 GB RAM.
Tjänste-VM har direkt åtkomst till de fysiska diskarna genom att passera SAS-kontroller till VM:en. Kommunikation med hypervisorn sker via en specialmodul, IOVisor, som fångar in- och utdataoperationer, och en agent som gör det möjligt att skicka kommandon till hypervisorns API. Agenten hanterar arbete med HyperFlex-snapshots och kloner.
I hypervisorn monteras diskresurser som NFS- eller SMB-delar (beroende på hypervisorns typ; gissa vilken som är vilken). Under huven finns ett distribuerat filsystem som möjliggör tillägg av funktioner som vuxna, fullfjädrade lagringssystem: finjustering av volymer, komprimering och deduplicering, snapshots med Redirect-on-Write-teknik samt synkron och asynkron replikering.
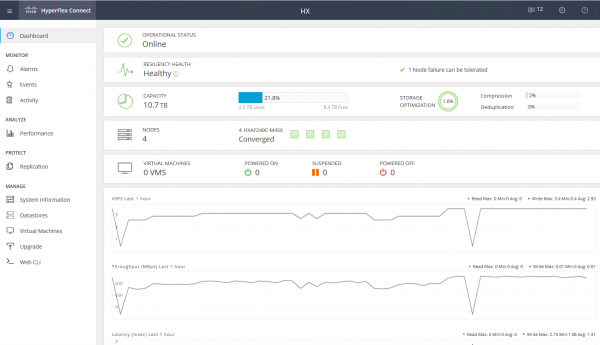
Tjänste-VM ger åtkomst till webbgränssnittet för hantering av HyperFlex-systemet. Det finns integration med vCenter, och de flesta rutinuppgifter kan utföras därifrån, men datastores är lättare att skära från ett separat webbläge om du redan har övergått till den snabba HTML5-gränssnittet, eller använda den fullständiga Flash-klienten med full integration. I det tjänste-webbläget kan du se systemets prestanda och detaljerad status.
Det finns en annan typ av noder i klustret - beräkningsnoder. Dessa kan vara rack- eller bladservrar utan inbyggda diskar. På dessa servrar kan VM köras vars data lagras på servrar med diskar. Ur datatillgångens perspektiv finns det ingen skillnad mellan nodtyperna, eftersom arkitekturen förutsätter en abstrahering från datans fysiska placering. Det maximala förhållandet mellan beräknings- och lagringsnoder är 2:1.
Användningen av beräkningsnoder ökar flexibiliteten vid skalning av klustrets resurser: vi behöver inte nödvändigtvis köpa noder med diskar om vi bara har behov av CPU/RAM. Dessutom kan vi lägga till en bladkorg och få besparingar på serverplacering i skåpet.
Som resultat har vi en hyperkonvergerad plattform med följande funktioner:
- Upp till 64 noder i klustret (upp till 32 lagringsnoder).
- Det minimi antal noder i klustret är tre (två för Edge-klustret).
- Data redundansmekanism: spegling med replikationsfaktor 2 och 3.
- Metro-kluster.
- Asynkron replikation av VM till ett annat HyperFlex-kluster.
- Orkestrering av VM-förskjutning till en avlägsen datacenter.
- Naturliga snapshots med tekniken Redirect-on-Write.
- Upp till 1 PB nyttjandeutrymme med replikationsfaktor 3 och utan att ta hänsyn till deduplicering. Replikationsfaktor 2 beaktas inte, eftersom det inte är ett alternativ för allvarlig försäljning.
Ytterligare en stor fördel — enkelhet i hantering och distribution. Allt krångel med inställningar av UCS-servrar hanteras av en specialiserad VM, förberedd av ingenjörer från Cisco.
Konfiguration av testmiljö:
- 2 x Cisco UCS Fabric Interconnect 6248UP som styrande kluster och nätverkskomponenter (48 portar som arbetar i Ethernet 10G/FC 16G-läge).
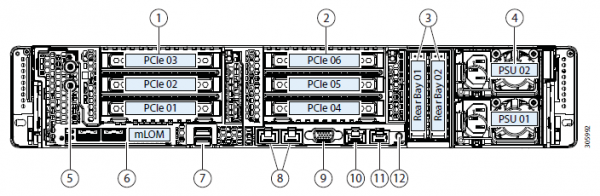
- Fyra servera Cisco UCS HXAF240 M4.
Serverns specifikationer:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Nätverk
UCSC-MLOM-CSC-02 (VIC 1227). 2 portar 10G Ethernet
Lagrings HBA
Cisco 12G Modular SAS Pass through Controller
Lagringsdiskar
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Fler konfigurationsalternativFörutom den valda hårdvaran finns följande alternativ tillgängliga:
- HXAF240c M5.
- En eller två CPU:er från Intel Silver 4110 till Intel Platinum I8260Y. Andra generationen är tillgänglig.
- 24 minnesplatser, minnesmoduler från 16 GB RDIMM 2600 till 128 GB LRDIMM 2933.
- Från 6 till 23 diskar för data, en cache-disk, en systemdisk och en boot-disk.
Kapacitetsdrivande
- HX-SD960G61X-EV 960GB 2.5 Inch Enterprise Value 6G SATA SSD (1X hållbarhet) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X hållbarhet) SAS 3.8 TB.
- Cache-drivande
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Extreme Perf & Hållbarhet.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Perf. NVMe SSD (3X hållbarhet) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Perf. 12G SAS SSD (10X hållbarhet) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Perf. 12G SAS SED SSD (10X hållbarhet) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise performance 12G SAS SSD (3X hållbarhet).
System-/loggdrivande
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (uppgradering krävs).
Bootdrivande
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Anslutning till nätverket via 40G, 25G eller 10G Ethernet-portar.
Som FI kan HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G) användas.
Själva testet
För att testa lagringssystemet använde jag HCIBench 2.2.1. Detta är ett gratis verktyg som automatiserar belastningen av flera virtuella maskiner. Själva belastningen genereras av vanlig fio.
Vårt kluster består av fyra noder, replikationsfaktor 3, alla diskar är Flash.
För testning har jag skapat fyra datalager och åtta virtuella maskiner. För skrivtesterna förutsattes ett scenario där cachdisken inte blir överfull.
Testresultaten är följande:
100 % Läs 100 % Slumptal
0 % Läs 100 % Slumptal
Block/djuplek
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Fetmarkerade värden indikerar efter vilka punkter det inte finns någon ökning i prestanda, ibland ser man till och med en nedgradering. Detta beror på att vi når kapacitetstaket för nätverket/kontrollerna/diskarna.
- Sekventiell läsning 4432 MB/s.
- Sekventiell skrivning 804 MB/s.
- Vid ett fel på en kontroller (antingen en virtuell maskin eller värd) minskar prestandan med hälften.
- Vid ett lagringsdiskfel minskar prestandan med 1/3. Återuppbyggnaden av disken tar 5% av varje kontrollers resurser.
Med en liten blockstorlek når vi kapaciteten för kontrollerna (virtuell maskin), vilket medför att CPU är maxad på 100%, och med större block når vi portarnas bandbredd. 10 Gbit/s är inte tillräckligt för att utnyttja potentialen hos AllFlash-systemet. Tyvärr kan vi inte kontrollera arbetet på 40 Gbit/s på grund av den tillgängliga demostandens specifikationer.
Enligt min erfarenhet från tester och studier av arkitekturen, tack vare algoritmen som distribuerar data mellan alla värdar, får vi en skalbar och förutsägbar prestanda, men detta är också en begränsning vid läsning, eftersom vi skulle kunna pressa ut mer från lokala diskar, här skulle en mer kraftfull nätverkslösning kunna hjälpa, till exempel finns FI för 40 Gbit/s.
En enda disk för caching och deduplicering kan också vara en begränsning; i denna setup kan vi faktiskt skriva till fyra SSD-diskar. Det skulle vara utmärkt att kunna öka antalet cachdiskar och se skillnaden.
Verklig användning
För att organisera en säkerhetskopierings-DC kan man använda två metoder (vi beaktar inte backup-lagring på en avlägsen plats):
- Aktiv-Passiv. Alla applikationer placeras i det huvudsakliga datacentret. Replikation är synkron eller asynkron. I händelse av att det huvudsakliga datacentret faller, måste vi aktivera det reservdatacentret. Detta kan göras manuellt/scripting/applikationer för orkestrering. Här får vi RPO, som är jämförbar med replikationsfrekvensen, och RTO beror på reaktionen och administratorns färdigheter samt kvaliteten på att arbeta igenom/testa failover-planen.
- Aktiv-Aktiv. I det här fallet finns det endast synkron replikation, tillgången till datacentren bestäms av kvorum/arbitrator som är placerad strikt på en tredje plats. RPO = 0, och RTO kan nå 0 (om applikationen tillåter) eller vara lika med tiden för att hantera en nodfel i virtualiseringsklustret. På virtualiseringsnivå skapas ett sträckt (Metro) kluster som kräver Active-Active lagring.
Vi ser vanligtvis att kunderna redan har implementerat en arkitektur med klassisk lagring i det huvudsakliga datacentret, så vi designar en till för replikation. Som jag nämnde, erbjuder Cisco HyperFlex asynkron replikation och skapande av ett sträckt virtualiseringskluster. Vi behöver inte en dedikerad lagring på Midrange-nivå eller högre med dyra replikationsfunktioner och Active-Active åtkomst till data i två lagringssystem.
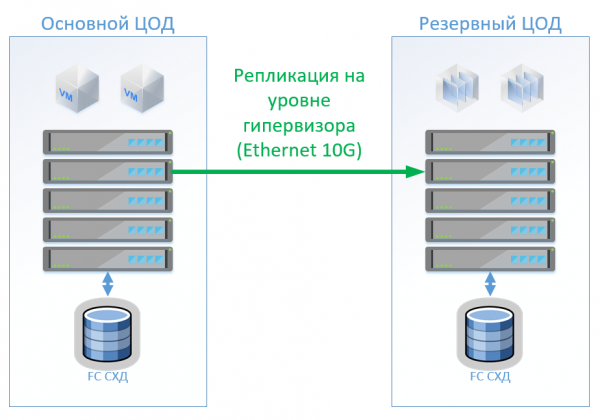
Scenario 1: Vi har ett huvudsakligt och ett reservdatacenter, virtualiseringsplattformen på VMware vSphere. Alla produktiva system finns i det huvudsakliga datacentret, och replikationen av virtuella maskiner utförs på hypervisor-nivå, vilket gör att vi inte behöver hålla VM:ar igång i reservdatacentret. Databaser och speciella applikationer replikerar vi med inbyggda verktyg och håller VM:arna igång. Vid ett fel på det huvudsakliga datacentret startar vi systemen i reservdatacentret. Vi räknar med att ha cirka 100 virtuella maskiner. Så länge det huvudsakliga datacentret är aktivt kan vi köra testmiljöer och andra system i reservdatacentret som kan stängas av vid failover av det huvudsakliga datacentret. Det är också möjligt att vi använder tvåvägsreplikation. Med avseende på utrustningen kommer det inte att bli några förändringar.
Vid klassisk arkitektur installerar vi en hybridlagring i varje datacenter med åtkomst via FibreChannel, tiering, deduplicering och komprimering (men inte online), 8 servrar på varje plats, samt 2 FibreChannel- och 10G Ethernet-switchar. För replikering och omkoppling i klassisk arkitektur kan vi använda VMware-verktyg (Replication + SRM) eller externa verktyg som är något billigare och ibland mer praktiska.
Diagrammet visar schemat.
Vid användning av Cisco HyperFlex ser vi följande arkitektur:
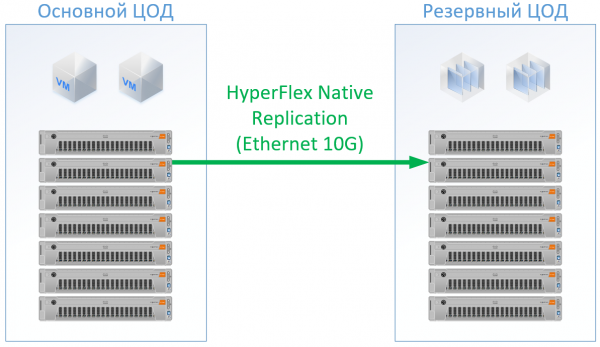
För HyperFlex använde jag servrar med stora resurser för CPU/RAM, eftersom en del av resurserna går till VM-kontrollern för HyperFlex. Jag har till och med lite överdimensionerat konfigurationen för HyperFlex för att inte ge fördelar åt Cisco och för att garantera resurser för övriga VM. Dessutom kan vi avstå från FibreChannel-switchar, och vi behöver inga Ethernet-portar för varje server, den lokala trafiken hanteras internt i FI.
Resultatet blev följande konfiguration för varje datacenter:
Servrar
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Lagring
Hybridlagring med FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet-switch 10G med 12 portar
—
SAN
2 x FC-switch 32/16Gb med 24 portar
2 x Cisco UCS FI 6332
Licenser
VMware Ent Plus
Replikering och/eller orkestrering av VM-omkoppling
VMware Ent Plus
För HyperFlex har jag inte planerat licenser för replikationsprogramvara, eftersom detta är tillgängligt ur lådan.
För den klassiska arkitekturen valde jag en leverantör som har bevisat sig vara en kvalitativ och prisvärd producent. För båda alternativen tillämpade jag standardrabatten för den specifika lösningen och fick verkliga priser.
Lösningen på Cisco HyperFlex blev 13% billigare.
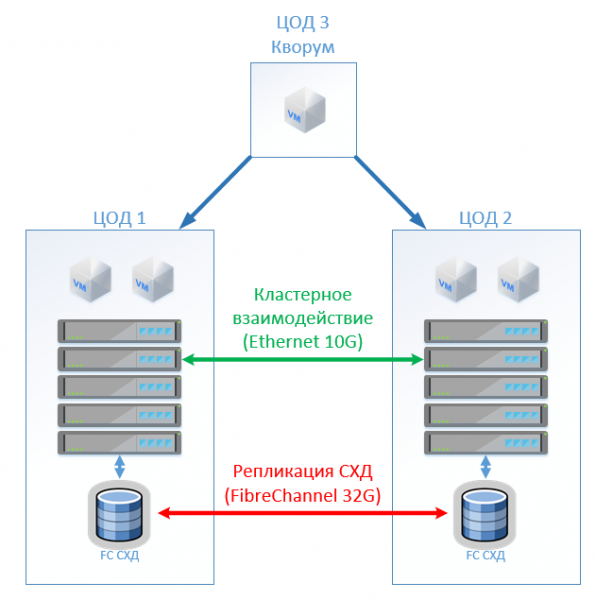
Scenario 2: skapa två aktiva datacenter. I detta scenario designar vi en distribuerad kluster på VMware.
Den klassiska arkitekturen består av virtualiseringsservrar, SAN (FC-protokoll) och två lagringssystem som kan läsa och skriva på det distribuerade mellan dem. Vi planerar användbar lagringskapacitet på varje lagringssystem för lokalisering.
Med HyperFlex skapar vi enkelt ett stretchkluster med lika många noder på båda platserna. I detta fall används en replikationsfaktor på 2+2.
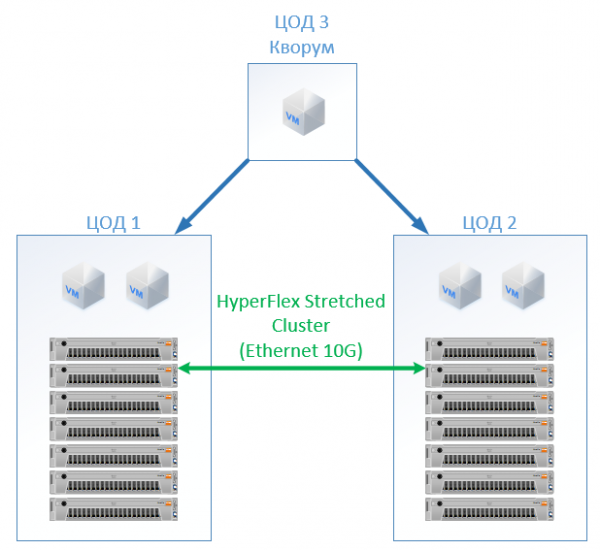
Vi fick följande konfiguration:
Klassisk arkitektur
HyperFlex
Servrar
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Lagring
2 x AllFlash-lagringssystem (150 TB SSD)
—
LAN
4 x Ethernet-switch 10G med 24 portar
—
SAN
4 x FC-switch 32/16Gb med 24 portar
4 x Cisco UCS FI 6332
Licenser
VMware Ent Plus
VMware Ent Plus
I alla beräkningar har jag inte tagit hänsyn till nätverksinfrastruktur, kostnader för datacenter osv.: de kommer att vara desamma för klassisk arkitektur och för lösningen på HyperFlex.
Kostnaden för HyperFlex blev 5% högre. Här bör det noteras att jag för Cisco fick en övervikt vad gäller CPU/RAM-resurser, eftersom jag i konfigurationen fyllde minneskontrollernas kanaler jämt. Kostnaden är något högre, men inte i en annan klass, vilket tydligt indikerar att hyperkonvergens inte nödvändigtvis är "en leksak för rika", utan kan konkurrera med standardmetoden för att bygga datacenter. Detta kan också vara intressant för dem som redan har servrar från Cisco UCS och den motsvarande infrastrukturen.
Bland fördelarna får vi inga kostnader för administration av SAN och lagringssystem, online-komprimering och deduplicering, en enhetlig kontaktpunkt för support (virtualisering, servrar, de är också lagringssystem), platsbesparing (men inte i alla scenarier), och förenkling av driften.
När det gäller support får ni den från en leverantör — Cisco. Utifrån min erfarenhet av att arbeta med servrar från Cisco UCS tycker jag att det är bra, jag behövde aldrig öppna HyperFlex, allt fungerade redan. Ingenjörer svarar snabbt och kan lösa inte bara typiska problem, utan även komplexa gränsfall. Ibland kontaktar jag dem med frågor som: "Är det möjligt att göra så här, koppla på detta?" eller "Jag har konfigurerat något, och det vill inte fungera. Hjälp mig!" — de kommer tålmodigt att hitta rätt guide och peka ut de korrekta stegen, de kommer inte att svara: "Vi löser bara hårdvaruproblem."
Länkar
- Min e-post är StGeneralov@croc.ru
Källa: habr.com
