

Hej, Habr! I den här artikeln vill jag berätta om ett fantastiskt verktyg för utveckling av batchprocesser för databehandling, till exempel i infrastrukturen för företags-DWH eller din DataLake. Det handlar om Apache Airflow (härefter Airflow). Det är orättvist förbisett på Habr, och i huvuddelen av artikeln ska jag försöka övertyga dig om att Airflow åtminstone är värt att överväga när du väljer en schemaläggare för dina ETL/ELT-processer.
Tidigare har jag skrivit en serie artiklar om DWH när jag arbetade på Tinkoff Bank. Nu är jag en del av Mail.Ru Groups team och arbetar med utvecklingen av plattformen för dataanalys inom spelområdet. När nyheter och intressanta lösningar dyker upp kommer vi i teamet att berätta här om vår plattform för dataanalys.
Prolog
Så, låt oss börja. Vad är Airflow? Det är ett bibliotek (eller ) för att utveckla, schemalägga och övervaka arbetsflöden. Huvudfunktionen i Airflow är att använda kod i Python för att beskriva (utveckla) processer. Därav följer massor av fördelar för att organisera ditt projekt och utveckling: i grund och botten är ditt (till exempel) ETL-projekt bara ett Python-projekt, och du kan organisera det som du vill, med hänsyn till infrastrukturens särdrag, teamets storlek och andra krav. Verkygsmässigt är allt enkelt. Använd till exempel PyCharm + Git. Det är underbart och väldigt bekvämt!
Nu ska vi titta på de grundläggande entiteterna i Airflow. Genom att förstå deras innebörd och syfte kommer du att optimalt organisera arkitekturen för processerna. Den kanske viktigaste entiteten är Directed Acyclic Graph (härefter DAG).
DAG
DAG är en viss meningsfull sammanslutning av dina uppgifter, som du vill utföra i strikt bestämd följd enligt ett visst schema. Airflow erbjuder ett bekvämt webbgränssnitt för att arbeta med DAG:ar och andra entiteter:
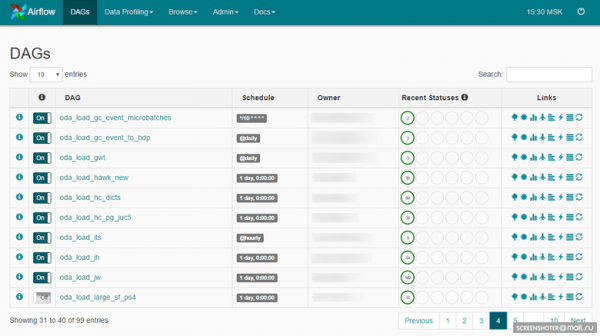
DAG kan se ut så här:
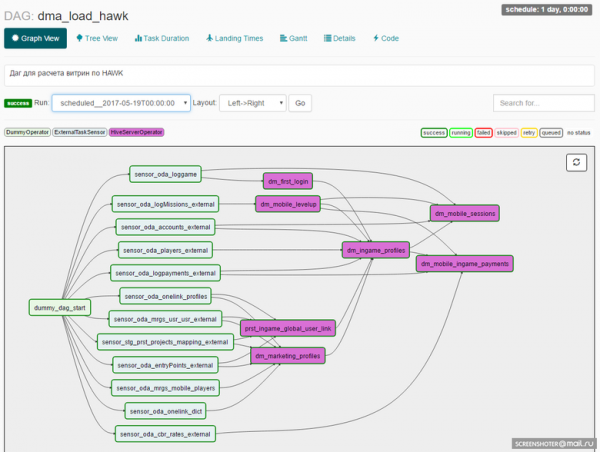
När utvecklaren designar DAG:en lägger hen in en uppsättning operatörer, som uppgifterna inuti DAG:en kommer att byggas på. Här kommer vi till en annan viktig entitet: Airflow Operator.
Operatörer
En operator är en entitet på grundval av vilken instanser av uppgifter skapas, där det beskrivs vad som kommer att hända under utförandet av uppgiftsinstansen. innehåller redan en uppsättning operatörer redo för användning. Exempel:
- BashOperator — en operator för att köra bash-kommandon.
- PythonOperator — en operator för att anropa Python-kod.
- EmailOperator — en operator för att skicka e-post.
- HTTPOperator — en operator för att hantera http-förfrågningar.
- SqlOperator — en operator för att köra SQL-kod.
- Sensor — en operator som väntar på ett händelse (som att en viss tid infaller, en fil dyker upp, en rad i en databas, svar från ett API — osv.).
Det finns mer specifika operators: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Du kan också utveckla operators med särskilda fokusområden och använda dem i ditt projekt. Till exempel har vi skapat MongoDBToHiveViaHdfsTransfer, en operator för att exportera dokument från MongoDB till Hive, och några operators för att arbeta med : CHLoadFromHiveOperator och CHTableLoaderOperator. I grunden, så snart en projekt har kod som används ofta, baserad på grundläggande operators, kan du överväga att samla den i en ny operator. Detta kommer att förenkla framtida utveckling och du kommer att utöka ditt bibliotek av operators i projektet.
Därefter behöver alla dessa uppgiftsexemplen köras, och nu handlar det om schemaläggaren.
Schemaläggare
Uppgiftsschemaläggaren i Airflow är baserad på . Celery är ett Python-bibliotek som möjliggör skapandet av köer samt asynkron och distribuerad exekvering av uppgifter. I Airflow delas alla uppgifter upp i pooler. Pooler skapas manuellt. Vanligtvis är deras syfte att begränsa belastningen på arbete med källan eller typisera uppgifter inom DWH. Pooler kan hanteras via webbgränssnittet:
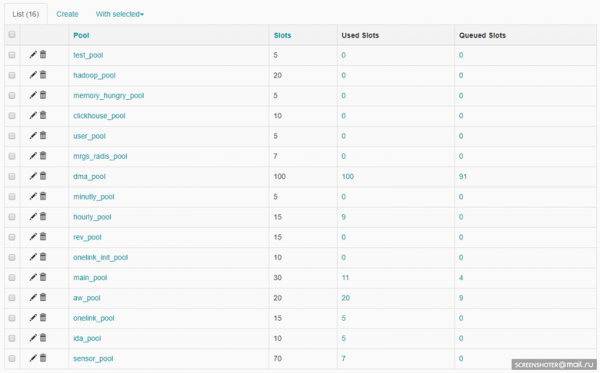
Varje pool har en begränsning för antalet platser. När en DAG skapas tilldelas den en pool:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Poolen som anges på DAG-nivå kan åsidosättas på uppgiftsnivå.
En separat process — Scheduler — ansvarar för schemaläggningen av alla uppgifter i Airflow. Faktiskt handlar Scheduler om all mekanik kring att ställa uppgifter för exekvering. En uppgift går igenom flera steg innan den kan exekveras:
- I DAG:en har tidigare uppgifter slutförts, en ny kan sättas i kö.
- Kön sorteras baserat på uppgifternas prioritet (prioriteter kan också hanteras) och om det finns en ledig plats i poolen kan uppgiften tas i arbete.
- Om det finns en ledig worker celery, skickas uppgiften dit; arbetet som du programmerat i uppgiften börjar, med hjälp av den operatör du angav.
Det är ganska enkelt.
Schemaläggaren fungerar på flera av alla DAG:ar och alla uppgifter inom DAG:arna.
För att schemaläggaren ska börja arbeta med DAG:en måste en schema anges för DAG:en:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Det finns en uppsättning färdiga förinställningar: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Det är också möjligt att använda cron-uttryck:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Körning Datum
För att förstå hur Airflow fungerar är det viktigt att veta vad körning datum är för en DAG. I Airflow har en DAG en dimension för körning datum, det vill säga, baserat på schemat för DAG:ens arbete skapas instanser av uppgifter för varje körning datum. Och för varje körning datum kan uppgifterna utföras igen — eller till exempel kan en DAG utföra samtidigt på flera körning datum. Detta visas tydligt här:
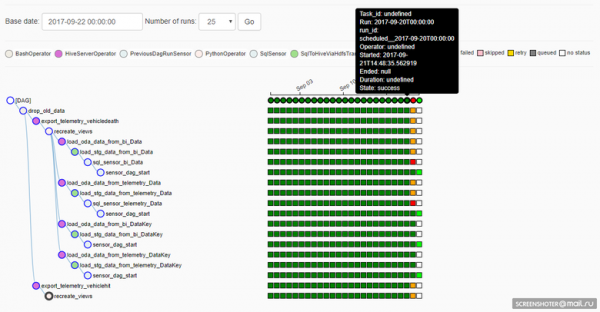
Tyvärr (eller kanske lyckligtvis: beroende på situationen), om implementeringen av uppgiften i DAG:en ändras, kommer utförandet i tidigare körning datum att följa de nya justeringarna. Detta är bra om du behöver beräkna data från tidigare perioder med en ny algoritm, men dåligt eftersom reproducerbarheten av resultatet går förlorad (naturligtvis hindrar ingen dig från att återvända till rätt version av koden från Git och en gång beräkna det som behövs, på det sätt som behövs).
Generering av uppgifter
Implementeringen av DAG:en är kod på Python, så vi har ett mycket bekvämt sätt att minska kodens storlek när vi arbetar, till exempel med sharder källor. Anta att du har tre MySQL-sharder som källor, du måste gå in i varje och hämta viss data. Också oberoende och parallellt. Koden på Python i DAG:en kan se ut så här:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG ser ut så här:
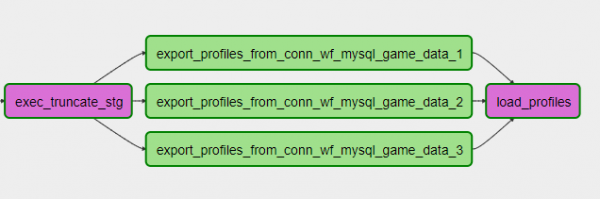
Du kan också lägga till eller ta bort en shard genom att justera inställningarna och uppdatera DAG. Praktiskt!
Du kan använda en mer komplex kodgenerering, till exempel arbeta med datakällor i form av databaser eller beskriva tabellstrukturen, arbetsalgoritmen med hänsyn till DWH-infrastrukturens särdrag och generera laddningsprocesser för N-tabeller till ditt datalager. Eller, till exempel, om du arbetar med ett API som inte stöder parametrar i listaform, kan du generera N-uppgifter i DAG:en baserat på den listan, begränsa parallelliteten av API-anrop till en pool och hämta de nödvändiga uppgifterna från API:t. Flexibelt!
Förråd
I Airflow finns det ett eget backend-repository, en databas (kan vara MySQL eller Postgres, vi använder Postgres) där tillstånd av uppgifter, DAG:ar, anslutningsinställningar, globala variabler osv. lagras. Här vill jag nämna att repositoryt i Airflow är mycket enkelt (ungefär 20 tabeller) och användarvänligt, ifall du vill bygga en egen process ovanpå den. Jag minns 100500 tabeller i Informatica-repositoryt som man var tvungen att sätta sig in i länge innan man förstod hur man bygger en förfrågan.
Övervakning
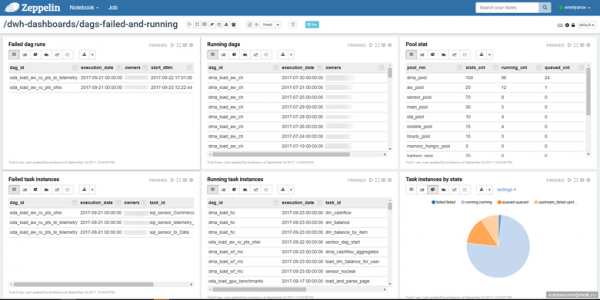
Med tanke på enkelheten i repositoryt kan du själv bygga en process för övervakning av uppgifter som passar dig. Vi använder en anteckningsbok i Zeppelin där vi övervakar uppgifternas tillstånd:
Det kan också vara webgränssnittet för Airflow:
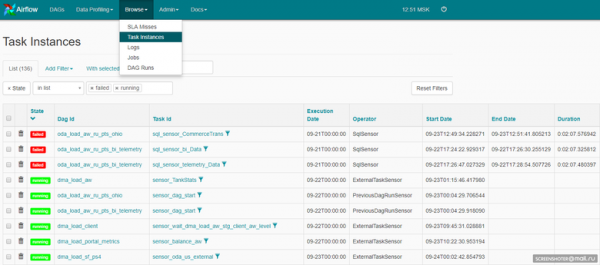
Airflow-koden är öppen, så vi har lagt till larm via Telegram. Varje fungerande instans av en uppgift, om ett fel inträffar, spam-ar i en Telegram-grupp där hela utvecklings- och supportteamet är med.
Vi får snabb reaktion via Telegram (om det behövs) och genom Zeppelin en allmän översikt över uppgifterna i Airflow.
Sammanfattningsvis
Airflow är först och främst open source och du behöver inte vänta på mirakel från det. Var beredd att investera tid och engagemang för att bygga en fungerande lösning. Målet är inom räckhåll, tro mig, det är värt det. Utvecklingshastighet, flexibilitet, enkelhet i att lägga till nya processer — du kommer att gilla det. Självklart behöver man lägga stor vikt vid projektorganisationen, stabiliteten i Airflows arbete: mirakel finns inte.
Nu kör Airflow dagligen ungefär 6,5 tusen uppgifter. De är ganska olika till sin karaktär. Det finns uppgifter för datalastning till det primära DWH från många olika och mycket specifika källor, det finns uppgifter för beräkning av datavitriner inom det primära DWH, det finns uppgifter för publicering av data i ett snabbt DWH, det finns många olika uppgifter — och Airflow hanterar allt detta dag efter dag. Om vi pratar siffror så handlar det om 2,3 tusen ELT-uppgifter av olika komplexitet inom DWH (Hadoop), cirka 2,5 hundra databaser källor, detta är ett team av fyra ETL-utvecklare, som delar upp sig mellan ETL-bearbetning av data i DWH och ELT-bearbetning av data inom DWH, och förstås även en administratör, som ansvarar för tjänstens infrastruktur.
Framtidsplaner
Antalet processer växer ofrånkomligen, och det huvudsakliga vi kommer att fokusera på när det gäller infrastrukturen för Airflow — är skalning. Vi vill bygga en Airflow-kluster, avsätta ett par noder för Celery-arbetare och skapa en duplicerad huvudnod med schemaläggningsprocesser och ett repository.
Epilog
Detta är förstås långt ifrån allt jag skulle vilja berätta om Airflow, men jag har försökt att belysa de viktigaste punkterna. Aptiten kommer under matlagning, prova — och ni kommer att gilla det 🙂
Källa: habr.com
