

Inför kursstarten har förberett en översättning av ännu ett användbart material för dig.
Huffman-kodning är en algoritm för datakomprimering som formulerar den grundläggande idén om filkomprimering. I den här artikeln kommer vi att diskutera fast och variabel längdkodning, unikt avkodningsbara koder, prefixregler och byggandet av Huffman-träd.
Vi vet att varje tecken lagras som en sekvens av 0 och 1 och tar upp 8 bitar. Detta kallas fast längdkodning eftersom varje tecken använder ett lika fast antal bitar för lagring.
Låt oss säga att vi har en text. Hur kan vi minska det utrymme som krävs för att lagra ett tecken?
Den grundläggande idén är variabel längdkodning. Vi kan använda det faktum att vissa tecken i texten förekommer oftare än andra (), för att utveckla en algoritm som kommer att representera samma teckenföljd med färre bitar. Vid variabel längdkodning tilldelar vi tecken ett variabelt antal bitar beroende på hur ofta de förekommer i denna text. Som ett resultat kan vissa tecken ta upp endast 1 bit, medan andra tar 2 bitar, 3 eller mer. Problemet med variabel längdkodning är endast att därefter avkoda sekvensen.
Hur kan vi, med sekvensen av bitar, avkoda den entydigt?
Låt oss titta på strängen «aabacdab». Den innehåller 8 tecken, och vid fast längdkodning kommer den att behöva 64 bitar för att lagras. Vi noterar att frekvensen av tecknen «a», «b», «c» och «d» är 4, 2, 1, 1 respektive. Låt oss försöka representera «aabacdab» med färre bitar, med tanke på att «a» förekommer oftare än «b», och «b» förekommer oftare än «c» och «d». Vi börjar med att koda «a» med en bit, lika med 0, «b» vi tilldelar en tvåbitarskod 11, och med tre bitar kodar vi 100 och 011 «c» och «d».
Så vi får:
a
0
b
11
c
100
d
011
Därför kommer vi att koda strängen «aabacdab» som 00110100011011 (0|0|11|0|100|011|0|11), med hjälp av koderna som presenterats ovan. Men det grundläggande problemet kommer att vara avkodningen. När vi försöker avkoda strängen 00110100011011, får vi ett tvetydigt resultat eftersom den kan representeras som:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
och så vidare.
För att undvika denna tvetydighet måste vi säkerställa att vår kodning uppfyller ett begrepp som prefixregel, vilket i sin tur innebär att koderna kan avkodas på ett unikt sätt. Prefixregeln garanterar att ingen kod är en prefix av en annan. Med kod avser vi bitarna som används för att representera en specifik symbol. I det ovanstående exemplet 0 – är ett prefix 011, vilket bryter mot prefixregeln. Så om våra koder uppfyller prefixregeln kan avkodningen ske entydigt (och vice versa).
Låt oss granska exemplet ovan. Den här gången kommer vi att tilldela symbolerna «a», «b», «c» och «d» koder som uppfyller prefixregeln.
a
0
b
10
c
110
d
111
Med en sådan kodning kommer strängen «aabacdab» att kodas som 00100100011010 (0|0|10|0|100|011|0|10). Och här är 00100100011010 vi kommer redan att kunna avkoda den entydigt och återgå till vår ursprungliga sträng «aabacdab».
Huffman-kodning
Nu när vi har förstått kodning av variabel längd och prefixregeln, låt oss prata om Huffman-kodning.
Metoden bygger på att skapa binära träd. I det kan en nod vara antingen en terminal eller en intern. Från början betraktas alla noder som löv (terminaler) som representerar själva symbolen och dess vikt (dvs. frekvens). Interna noder innehåller symbolvikten och hänvisar till två arvnodar. Enligt vanlig praxis representerar biten «0» att följa den vänstra grenen, medan «1» representerar den högra. I ett fullt träd finns det N blad och N-1 interna noder. Det rekommenderas att man vid byggandet av Huffman-trädet lämnar bort oanvända symboler för att få koder av optimal längd.
Vi kommer att använda en prioriteringskö för att bygga Huffman-trädet, där noden med lägst frekvens tilldelas högsta prioritet. Stegen för konstruktion beskrivs nedan:
- Skapa ett lövnod för varje symbol och lägg till dem i prioriteringskön.
- Så länge som det finns mer än en löv i kön gör vi följande:
- Ta bort två noder med högsta prioritet (med lägst frekvens) från kön;
- Skapa en ny intern nod där dessa två noder är arvtagare, och frekvensen är summan av frekvenserna för dessa två noder.
- Lägg till den nya noden i prioriteringskön.
- Den enda kvarvarande noden kommer att vara roten, och därmed avslutas byggandet av trädet.
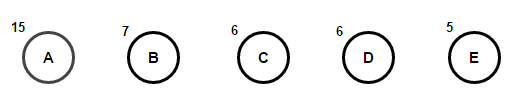
Låt oss föreställa oss att vi har en viss text som endast består av tecken «a», «b», «c», «d» och «e», och frekvenserna för deras förekomst är 15, 7, 6, 6 och 5 respektive. Nedan följer illustrationer som visar stegen i algoritmen.
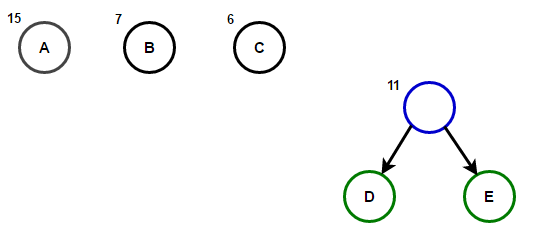
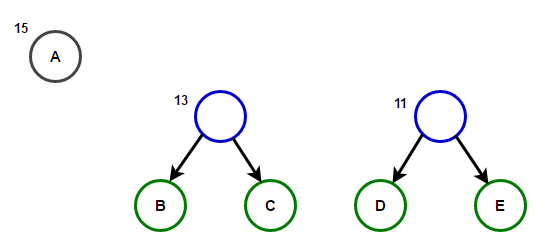
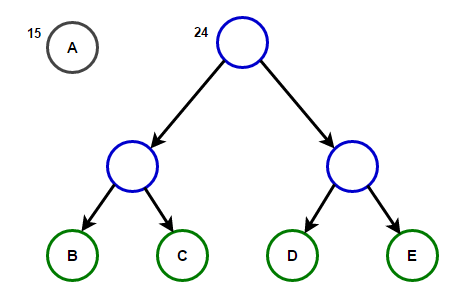
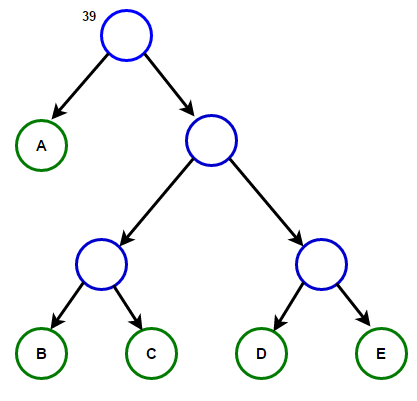
Vägen från roten till varje slutnod kommer att lagra den optimala prefixkoden (även känd som Huffman-kod) som motsvarar tecknet kopplat till denna slutnod.
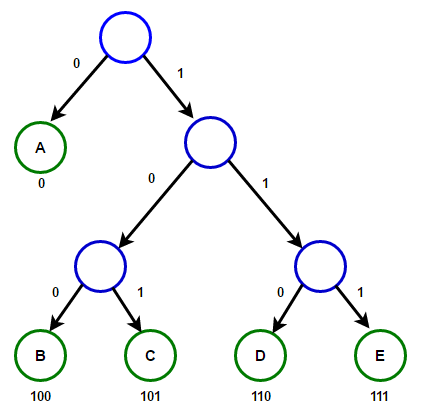
Huffman-träd
Nedan finner du en implementation av Huffman-komprimeringsalgoritmen på C++ och Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// En nod i trädet
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Traversera Huffman-trädet och lagra Huffman-koder
// i en karta.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// hittade en bladnod
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Traversera Huffman-trädet och avkoda den kodade strängen
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// hittade en bladnod
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Bygger Huffman-träd och huffmanCode och avkodar given indata
public static void buildHuffmanTree(String text)
{
// räkna frekvensen av varje teckens utseende
// och lagra det i en karta
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Skapa en prioritetskö för att lagra aktiva noder i Huffman-trädet
// Observera att det högsta prioriterade objektet har lägst frekvens
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Skapa en bladnod för varje tecken och lägg till den
// i prioritetskön.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// gör tills det finns mer än en nod i kön
while (pq.size() != 1)
{
// Ta bort de två noderna med högsta prioritet
// (lägsta frekvens) från kön
Node left = pq.poll();
Node right = pq.poll();
// Skapa en ny intern nod med dessa två noder som barn
// och med frekvensen lika med summan av de två nodernas
// frekvenser. Lägg till den nya noden i prioritetskön.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root lagrar pekare till rot av Huffman-trädet
Node root = pq.peek();
// Traversera Huffman-trädet och lagra Huffman-koderna i en karta
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// skriv ut Huffman-koderna
System.out.println("Huffman-koderna är :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nDen ursprungliga strängen var :\n" + text);
// skriv ut den kodade strängen
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nDen kodade strängen är :\n" + sb);
// Traversera Huffman-trädet igen och den här gången
// avkoda den kodade strängen
int index = -1;
System.out.println("\nDen avkodade strängen är: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman kodning är en algoritm för datakompression.";
buildHuffmanTree(text);
}
}Anmärkning: Minnet som används av indat strängen är 47 * 8 = 376 bitar, och den kodade strängen tar endast 194 bitar, vilket innebär att data komprimeras med ungefär 48 %. I C++-programmet ovan använder vi klassen string för att lagra den kodade strängen för att göra programmet läsbart.
Eftersom effektiva datatyper för prioritetsköer kräver O(log(N)) tid för insättning, och i ett fullständigt binärt träd med N blad finns 2N-1 noder, och Huffman-trädet är ett fullständigt binärt träd, så fungerar algoritmen på O(Nlog(N)) tid, där N är antalet tecken.
Källor:
Källa: habr.com
