

Vanligtvis används kommersiella produkter eller färdiga open-source-alternativ som Prometheus + Grafana för att övervaka och analysera Nginx:s prestanda. Detta är ett bra alternativ för övervakning eller realtidsanalys, men inte särskilt praktiskt för historisk analys. På varje populär resurs växer datamängden från Nginx-loggar snabbt, och för att analysera en stor mängd data är det logiskt att använda något mer specialiserat.
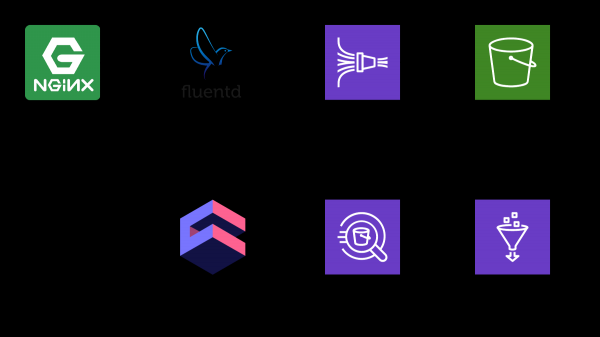
I den här artikeln kommer jag att berätta hur man kan använda för att analysera loggar, med Nginx som exempel, och visa hur man samlar dessa data för att skapa en analytisk dashboard med hjälp av det open-source ramverket cube.js. Här är hela lösningens arkitektur:
TL:DR;
.
För att samla in information använder vi , för bearbetning — och , för lagring — . Med denna koppling kan man lagra inte bara Nginx-loggar, utan även andra händelser samt loggar från andra tjänster. Du kan byta ut vissa delar mot motsvarande för din stack, till exempel kan du skriva loggar direkt till Kinesis från Nginx, utan att gå via Fluentd, eller använda Logstash för detta.
Samla loggar från Nginx
Som standard ser Nginx-loggar ut ungefär så här:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
De kan parsas, men det är mycket enklare att justera Nginx-konfigurationen så att loggarna ges i JSON-format:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 för lagring
För att lagra loggar kommer vi att använda S3. Detta möjliggör lagring och analys av loggar på ett ställe, eftersom Athena kan arbeta med data i S3 direkt. Längre fram i artikeln kommer jag att förklara hur man korrekt lagrar och bearbetar loggar, men först behöver vi en ren bucket i S3, där inget annat kommer att lagras. Det är bra att i förväg tänka på i vilken region du kommer att skapa bucketen, eftersom Athena inte är tillgänglig i alla regioner.
Skapa ett schema i Athena-konsolen
Vi kommer att skapa en tabell i Athena för loggar. Den behövs både för inmatning och läsning, om du planerar att använda Kinesis Firehose. Öppna Athena-konsolen och skapa en tabell:
SQL för att skapa tabellen
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Skapa Kinesis Firehose Stream
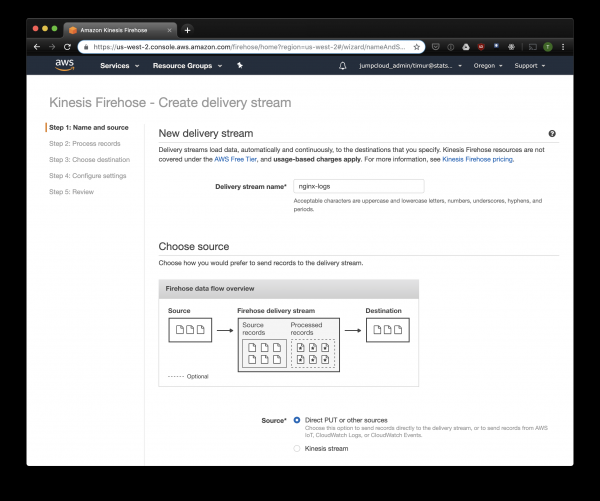
Kinesis Firehose kommer att skriva data som mottas från Nginx till S3 i det valda formatet, uppdelat i mappar enligt formatet ÅÅÅÅ/MM/DD/HH. Detta kommer att vara användbart vid läsning av data. Du kan självklart skriva direkt till S3 från fluentd, men i så fall måste du skriva JSON, vilket är ineffektivt på grund av stora filstorlekar. Dessutom är JSON det långsammaste dataformatet när du använder PrestoDB eller Athena. Så, öppna Kinesis Firehose-konsolen, klicka på „Create delivery stream“, välj „direct PUT“ i fältet „delivery“:
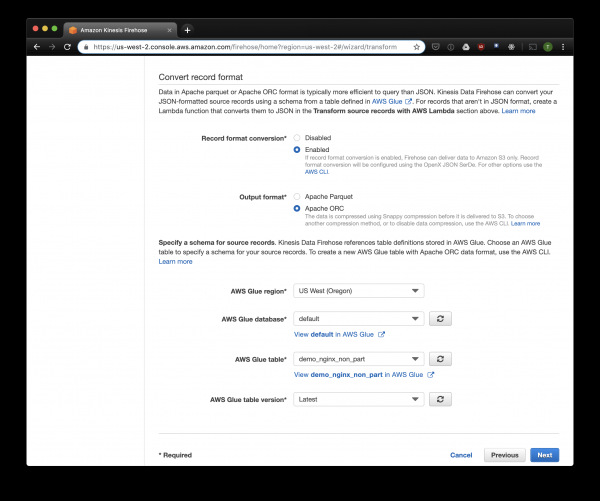
I nästa flik väljer vi „Record format conversion“ — „Enabled“ och väljer „Apache ORC“ som format för skrivning. Enligt forskning från vissa , är detta det optimala formatet för PrestoDB och Athena. Som schema anger vi tabellen som vi skapade ovan. Observera att S3-platsen i Kinesis kan anges till valfri, bara schemat från tabellen används. Men om du anger en annan S3-plats kommer dessa poster inte att kunna läsas från den här tabellen.
Välj S3 för lagring och den bucket som vi skapade tidigare. AWS Glue Crawler, som jag kommer att berätta mer om senare, kan inte arbeta med prefix i S3-bucket, så det är viktigt att lämna den tom.
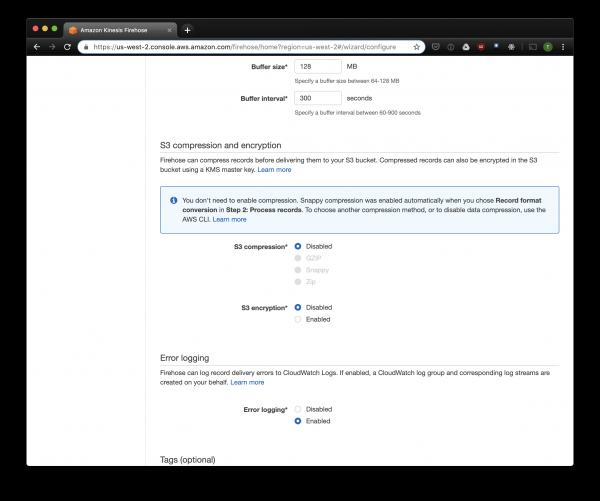
Övriga alternativ kan ändras beroende på din belastning, jag använder vanligtvis standardinställningarna. Observera att S3-komprimering inte är tillgänglig, men ORC använder egen standardkomprimering.
Fluentd
Nu när vi har ställt in lagring och mottagning av loggar måste vi konfigurera sändningen. Vi kommer att använda , eftersom jag älskar Ruby, men du kan använda Logstash eller skicka loggar till Kinesis direkt. Fluentd-servern kan startas på flera sätt, jag kommer att prata om Docker, eftersom det är enkelt och bekvämt.
För att börja, behöver vi en konfigurationsfil fluent.conf. Skapa den och lägg till källan:
framåt
port 24224
bind 0.0.0.0
Nu kan du starta Fluentd-servern. Om du behöver en mer avancerad konfiguration finns det en detaljerad guide, inklusive hur man bygger sin egen bild.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Denna konfiguration använder vägen /fluentd/log för att cacha loggar innan de skickas. Det går att klara sig utan detta, men då kan all cachelagrad data gå förlorad vid en omstart. Du kan även använda valfri port, 24224 är den standardport som Fluentd använder.
Nu när vi har Fluentd igång kan vi skicka Nginx-loggar dit. Vi kör vanligtvis Nginx i en Docker-container, och i det här fallet har Docker en inbyggd loggdrivare för Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Om du kör Nginx på ett annat sätt kan du använda loggfiler; Fluentd har en .
Låt oss lägga till loggarparsing i Fluent-konfigurationen, som vi har ställt in ovan:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
Och skicka loggar till Kinesis genom att använda :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Om du har konfigurerat allt korrekt bör du efter en stund (Kinesis registrerar mottagna data som standard var 10:e minut) se loggfiler i S3. I menyn "monitoring" för Kinesis Firehose kan du se hur mycket data som har skrivits till S3 samt fel. Glöm inte att ge skrivbehörighet till S3-bucketen för Kinesis-rollen. Om Kinesis inte kan parsa något lägger den fel i samma bucket.
Nu kan vi titta på data i Athena. Låt oss hitta de senaste frågorna som vi fick fel på:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Genomsökning av alla poster vid varje fråga
Nu har våra loggar bearbetats och lagrats i S3 i ORC-format, komprimerade och redo för analys. Kinesis Firehose har till och med sorterat dem i kataloger per timme. Men så länge tabellen inte är partitionerad kommer Athena att ladda data från hela tiden varje gång, med några få undantag. Detta är ett stort problem av två skäl:
- Datamängden växer ständigt, vilket saktar ner frågorna;
- Kostnaden för Athena baseras på mängden scannade data, med ett minimum på 10 MB per fråga.
För att korrigera detta använder vi AWS Glue Crawler, som skannar data i S3 och skriver ner information om partitioner i Glue Metastore. Detta gör att vi kan använda partitionerna som filter vid frågor i Athena, och den kommer endast att skanna de kataloger som anges i frågan.
Konfigurerar Amazon Glue Crawler
Amazon Glue Crawler skannar all data i S3-facket och skapar tabeller med partitioner. Skapa en Glue Crawler från AWS Glue-konsolen och lägg till facket där du lagrar data. Du kan använda en crawler för flera fack, i så fall kommer den att skapa tabeller i den angivna databasen med namn som stämmer överens med fackens namn. Om du planerar att använda dessa data kontinuerligt, kom ihåg att ställa in ett schema för att köra Crawler enligt dina behov. Vi använder en crawler för alla tabeller som körs varje timme.
Partitionerade tabeller
Efter den första körningen av crawlern bör tabeller för varje skannat fack visas i databasen som anges i inställningarna. Öppna Athena-konsolen och leta efter tabellen med Nginx-loggar. Låt oss försöka läsa något:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Denna fråga kommer att välja alla poster som mottogs mellan 6 och 7 på morgonen den 8 april 2019. Men hur mycket effektivare är detta än att bara läsa från en icke-partitionerad tabell? Låt oss ta reda på det och välja samma poster, filtrera dem efter tidsstämpel:
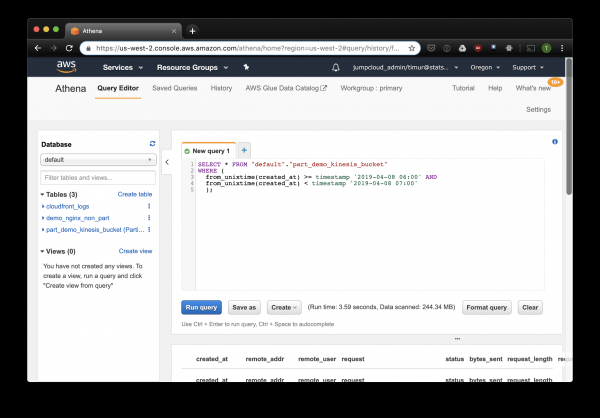
3.59 sekunder och 244.34 megabyte data på ett dataset som har en veckas loggar. Låt oss prova partitioneringsfilter:
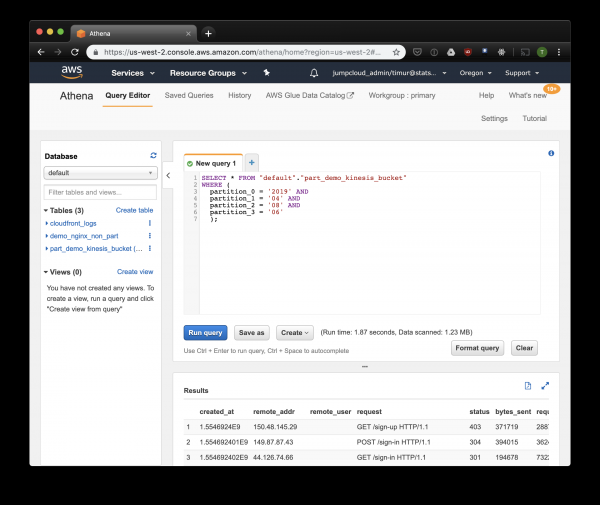
Lite snabbare, men det viktigaste — endast 1.23 megabyte data! Det skulle vara mycket billigare om det inte vore för de minimala 10 megabyte per fråga i prissättningen. Men det är ändå mycket bättre, och på stora dataset kommer skillnaden att vara mycket mer imponerande.
Собираем дэшборд с помощью Cube.js
För att skapa en instrumentpanel använder vi den analytiska ramverket Cube.js. Det har ganska många funktioner, men vi är intresserade av två: möjligheten att automatiskt använda filter baserat på partitioner och pre-aggregationen av data. Det använder dataskema , skriven i Javascript, för att generera SQL och utföra frågor mot databasen. Det som krävs av oss är bara att ange hur vi ska använda partitioneringsfilter i dataskema.
Vi kommer att skapa en ny Cube.js-applikation. Eftersom vi redan använder en AWS-stack är det logiskt att använda Lambda för distribution. Du kan använda express-mallen för att generera om du planerar att hyra ut Cube.js backend på Heroku eller Docker. I dokumentationen beskrivs andra .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
För att konfigurera åtkomst till databasen i cube.js används miljövariabler. Generatorn skapar en fil .env där du kan ange dina nycklar för .
Nu behöver vi en , där vi anger hur våra loggar lagras. Där kan vi också ange hur man beräknar metrik för dashboards.
I katalogen schema, skapa en fil Logs.js. Här är ett exempel på datamodell för nginx:
Kod för modellen
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Här använder vi variabeln , för att generera en SQL-fråga med filter för partitioner.
Vi specificerar också metrik och parametrar som vi vill visa på dashboarden och anger pre-aggregations. Cube.js kommer att skapa ytterligare tabeller med pre-aggregated data och automatiskt uppdatera data allteftersom de kommer in. Detta gör att vi kan snabba upp förfrågningar och minska kostnaden för att använda Athena.
Vi lägger till denna information i dataschemat:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
I denna modell anger vi att data måste pre-aggregaras för alla använda metrik, och att vi ska använda partitionering per månad. kan betydligt påskynda insamlingen och uppdateringen av data.
Nu kan vi skapa en dashboard!
Backend Cube.js tillhandahåller och ett set med klientbibliotek för populära frontend-ramverk. Vi kommer att använda React-versionen av klienten för att bygga dashboarden. Cube.js tillhandahåller endast data, så vi behöver ett bibliotek för visualiseringar — jag föredrar , men du kan använda vilken som helst.
Servern Cube.js tar emot förfrågningar i , där de nödvändiga metrikarna anges. Till exempel, för att räkna hur många fel Nginx har returnerat per dag, måste du skicka en sådan förfrågan:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Vi installerar Cube.js-klienten och React-komponentbiblioteket via NPM:
$ npm i --save @cubejs-client/core @cubejs-client/reactVi importerar komponenterna cubejs och QueryRenderer, för att hämta data, och vi bygger dashboarden:
Dashboard-koden
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Loading...';
        }

        return (


        );
      }}
    />
  )
}
Källkoden för dashboarden finns tillgänglig på .
Källa: habr.com
