

En tidsseriedatabas (TSDB, time series database) i Prometheus 2 är ett utmärkt exempel på en ingenjörslösning som erbjuder betydande förbättringar jämfört med lagringssystemet v2 i Prometheus 1 i termer av datainsamlingens hastighet och frågeprestanda, samt resurseffektivitet. Vi implementerade Prometheus 2 i Percona Monitoring and Management (PMM), och jag hade möjlighet att utvärdera prestandan för Prometheus 2 TSDB. I denna artikel kommer jag att redogöra för resultaten av mina observationer.
Genomsnittlig arbetsbelastning för Prometheus
För dem som är vana vid att arbeta med produktionsdatabaser är den vanliga arbetsbelastningen för Prometheus ganska intressant. Hastigheten på datainsamlingen tenderar att stabiliseras: vanligtvis skickar de tjänster som du övervakar ungefär samma antal metrik och infrastrukturen förändras relativt långsamt.
Förfrågningar om information kan komma från olika källor. Vissa av dessa, som larm, tenderar också att stabiliseras och bli förutsägbara. Andra, såsom användarförfrågningar, kan orsaka toppar, även om detta inte är typiskt för den större delen av belastningen.
Belastningstest
Under testningen fokuserade jag på förmågan att samla in data. Jag rullade ut Prometheus 2.3.2, kompilerad med Go 1.10.1 (som en del av PMM 1.14) på en Linode-tjänst, med hjälp av detta skript: . För att generera belastning så realistiskt som möjligt använde jag detta jag startade flera MySQL-noder med verklig belastning (Sysbench TPC-C Test), där varje nod emulerade 10 Linux/MySQL-noder.
Alla följande tester genomfördes på en Linode-server med åtta virtuella kärnor och 32 GB minne, där 20 belastningssimuleringar av 200 MySQL-instans kördes. I termer av Prometheus, 800 måltavlor (targets), 440 insamlingar (scrapes) per sekund, 380 000 datauppsättningar (samples) per sekund och 1,7 miljoner aktiva tidsserier.
Design
Den vanliga metoden för traditionella databaser, inklusive den som användes av Prometheus 1.x, innebærer . Om det inte finns tillräckligt med minne för att hantera belastningen kommer du att möta stora fördröjningar och vissa förfrågningar kommer att misslyckas. Minnesanvändningen i Prometheus 2 konfigureras via nyckeln storage.tsdb.min-block-duration, som definierar hur länge poster kommer att sparas i minnet innan de rensas till disken (standard är 2 timmar). Den nödvändiga minnesmängden beror på antalet tidsserier, etiketter (labels) och intensiteten av datainsamling (scrapes) tillsammans med det rena inkommande flödet. När det gäller diskutrymme strävar Prometheus efter att använda 3 byte per post (sample). Å andra sidan är minneskraven mycket högre.
Även om det finns möjlighet att konfigurera blockstorleken, rekommenderas det inte att göra det manuellt, så du står inför behovet att ge Prometheus så mycket minne som det ber om för din belastning.
Om det inte finns tillräckligt med minne för att stödja det inkommande flödet av metrik, kommer Prometheus att krascha med out of memory eller nås av OOM killer.
Att lägga till swap för att försena kraschen när Prometheus går tom på minne hjälper inte mycket, eftersom användningen av den här funktionen orsakar explosiv minnesanvändning. Jag tror att det har att göra med Go, dess skräpnivåhanterare och hur den fungerar med swap.
En annan intressant metod är att ställa in rensning av head block till disken vid en viss tidpunkt, istället för att räkna ned från processens starttid.
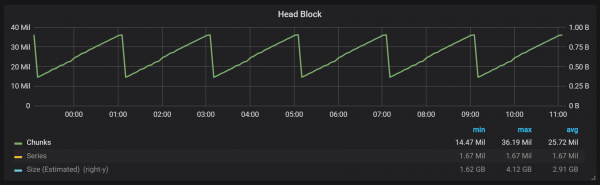
Som du kan se från grafen sker rensningar till disken varannan timme. Om du ändrar parametern min-block-duration till en timme kommer dessa rensningar att ske varje timme, med början efter en halvtimme.
Om du vill använda denna och andra grafer i din Prometheus-installation kan du använda denna . Den är utformad för PMM, men med några små ändringar passar den alla Prometheus-installationer.
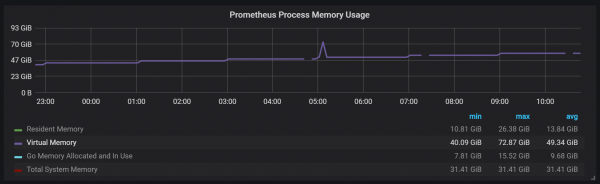
Vi har en aktiv block som kallas head block, som lagras i minnet; block med äldre data är tillgängliga genom mmap(). Detta eliminerar behovet av att konfigurera cache separat, men innebär också att du måste lämna tillräckligt med utrymme för operativsystemets cache om du vill göra förfrågningar om data som är äldre än vad head block kan rymma.
Dessutom betyder det att Prometheus virtuella minnesanvändning kommer att se ganska hög ut, vilket du inte behöver oroa dig för.
En annan intressant aspekt av designen är användningen av WAL (write ahead log). Som framgår av dokumentationen för lagringen använder Prometheus WAL för att undvika förluster vid krasch. Tyvärr är de specifika mekanismerna för att säkerställa datalivslängd otillräckligt dokumenterade. Version 2.3.2 av Prometheus skriver WAL till disk var tionde sekund, och den här inställningen kan inte konfigureras av användaren.
Kompakteringar (Compactions)
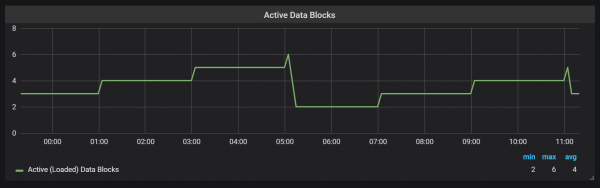
Prometheus TSDB är designad efter LSM-lager (Log Structured Merge - journalstrukturerat sammanslagningssystem): head block skrivs regelbundet till disk, samtidigt som kompakteringsmekanismen sammanfogar flera block för att undvika att skanna för många block vid förfrågningar. Här kan man se antalet block som jag observerade på testsystemet efter ett dygns belastning.
Om du vill veta mer om lagringen kan du studera filen meta.json, där information finns om befintliga block och hur de kom till.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompakteringar i Prometheus är kopplade till tidpunkten för att head block skrivs till disk. Vid den tidpunkten kan flera sådana operationer utföras.
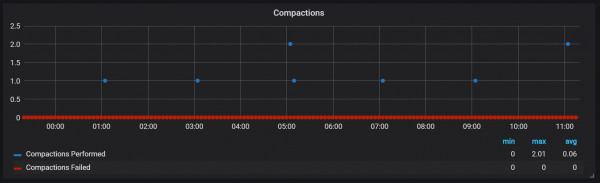
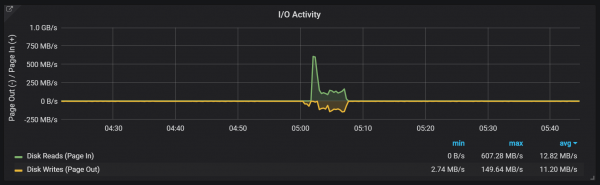
Till synes finns det inga begränsningar för komprimeringar, vilket kan orsaka stora spikar i disk-I/O under körning.
CPU-belastningsspikar
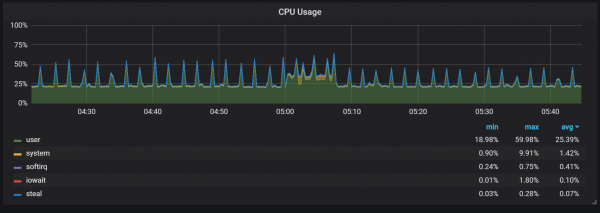
Självklart påverkar detta negativt systemets hastighet och utgör en betydande utmaning för LSM-lager: hur gör man komprimeringar för att stödja hög förfrågningshastighet utan att orsaka för mycket overhead?
Minnesanvändningen under komprimeringsprocesser ser också ganska intressant ut.
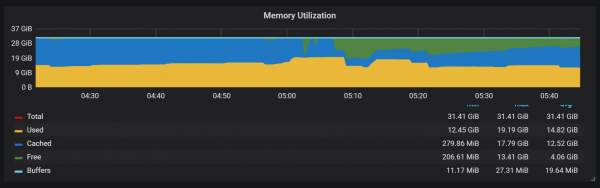
Vi kan se att efter komprimering ändrar sig en stor del av minnet från Cached till Free: det innebär att potentiellt värdefull information har tagits bort därifrån. Det är intressant om det används fadvice() eller någon annan teknik för minimering, eller om det beror på att cachen har rensats från block som förstörts vid komprimeringen?
Återställning efter krasch
Återställning efter krasch tar tid, och det är förståeligt. För en inkommande ström på en miljon poster per sekund var jag tvungen att vänta cirka 25 minuter medan återställningen genomfördes med SSD-disk.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Startar Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Börjar lyssna på anslutningar" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Startar TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="Hittade friskt block" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="Hittade friskt block" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="Hittade friskt block" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="Hittade friskt block" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="Hittade friskt block" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL-korrigering upptäcktes; trunkering" err="oförväntad CRC32 checksum d0465484, vill ha 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB startad"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Läser konfigurationsfil" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Fullföljde inläsningen av konfigurationsfil" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Servern är redo att ta emot webbegärningar."
Det främsta problemet med återställningsprocessen är den höga minnesanvändningen. Även om servern normalt kan fungera stabilt med samma mängd minne, kan den under ett driftstopp misslyckas att starta på grund av OOM. Den enda lösningen jag har hittat är att stänga av datainsamlingen, starta servern, låta den återhämta sig och sedan starta om med datainsamlingen aktiverad.
Uppvärmning
En annan sak att tänka på under uppvärmning är förhållandet mellan låg prestanda och hög resursanvändning direkt efter start. Vid vissa, men inte alla starter, har jag observerat en kraftig belastning på CPU och minne.
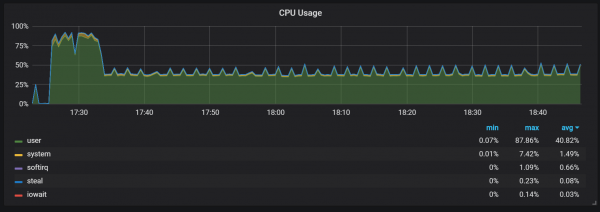
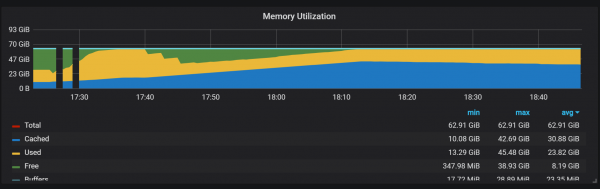
Toppavbrott i minnesanvändningen visar att Prometheus inte kan konfigurera alla insamlare vid start, och viss information går förlorad.
Jag har inte avgjort de exakta orsakerna till den höga belastningen på CPU och minne. Jag misstänker att det är kopplat till skapandet av nya tidsserier i head block med hög frekvens.
Belastningsspikar på CPU
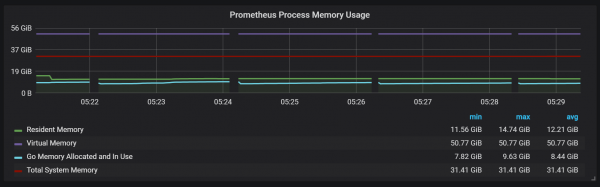
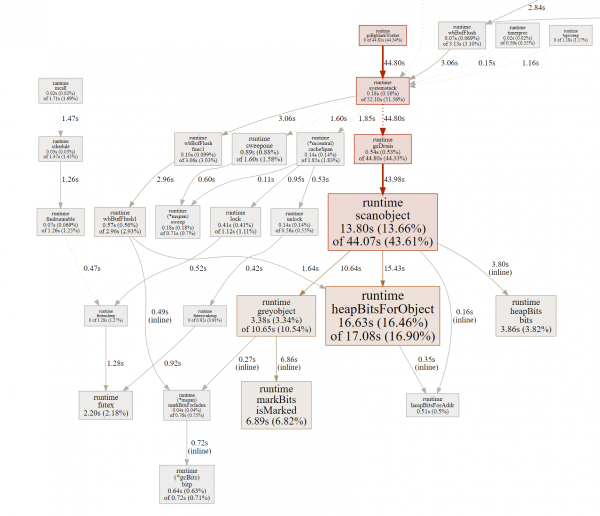
Förutom kompressionerna som skapar ganska hög belastning på I/O har jag noterat allvarliga belastningsspikar på processorn varannan minut. Utslag varar längre vid hög inströmning och verkar orsakats av Go:s skräpsamlare, åtminstone är några kärnor helt belastade.
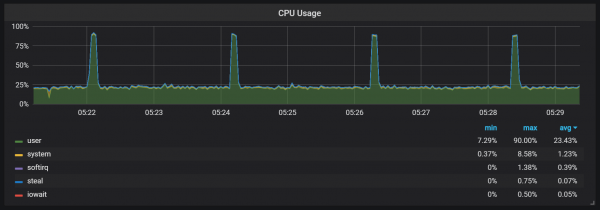
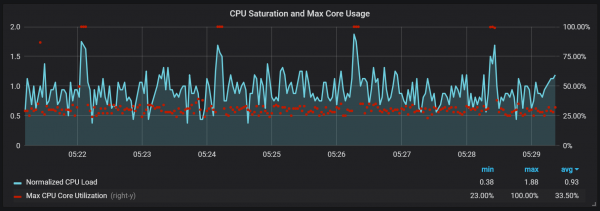
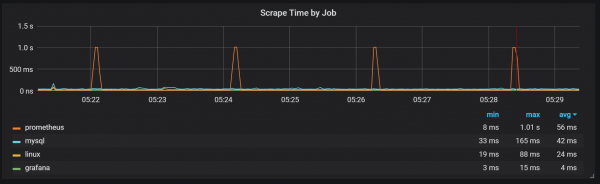
Dessa spikar är inte obetydliga. Det verkar som att när de inträffar blir den interna ingångspunkten och Prometheus-metriker otillgängliga, vilket orsakar dataförluster under dessa tidpunkter.
Det går också att observera att Prometheus-exportören blockerar i en sekund.
Vi kan se korrelationer med skräpsamling (GC).
Slutsats
TSDB i Prometheus 2 fungerar snabbt, den kan hantera miljoner tidsserier och samtidigt tusentals skrivningar per sekund med ganska blygsam hårdvara. CPU- och disk-I/O-utnyttjande är också imponerande. Mitt exempel visade upp till 200 000 metrikdata per sekund på en enda använd kärna.
För att planera för expansion måste man tänka på tillräckliga minnesvolymer, och detta måste vara verkligt minne. Den minnesanvändning jag observerade låg på cirka 5 GB för 100 000 poster per sekund av inströmning, vilket gav en total på cirka 8 GB upptagen minne med operativsystemets cache.
Självklart finns det fortfarande mycket arbete kvar för att tygla spikarna i CPU- och disk-I/O, och det är inte förvånande med tanke på hur ung TSDB Prometheus 2 fortfarande är jämfört med InnoDB, TokuDB, RocksDB, WiredTiger, men de hade alla liknande problem i början av livscykeln.
Källa: habr.com
