

Hej, jag heter Dmitrij Logvinenko — Data Engineer på analysavdelningen inom gruppen av företag "Vezot".
Jag kommer att berätta för er om ett fantastiskt verktyg för att utveckla ETL-processer — Apache Airflow. Men Airflow är så mångsidigt och komplett att ni borde ta en närmare titt på det även om ni inte arbetar med dataflöden, utan har behov av att periodiskt starta vissa processer och övervaka deras genomförande.
Och ja, jag kommer inte bara att berätta utan också visa: programmet innehåller mycket kod, skärmbilder och rekommendationer.
Vad ser man vanligtvis när man googlar ordet Airflow / Wikimedia Commons
Innehållsförteckning
Introduktion
Apache Airflow — det är precis som Django:
- skrivet i Python,
- har ett utmärkt administrationsgränssnitt,
- obegränsat utbyggbart,
— bara bättre, och det är helt gjort för andra ändamål, nämligen (som det står skrivet innan koden):
- start och övervakning av uppgifter på ett obegränsat antal maskiner (så många som Celery/Kubernetes och ditt samvete tillåter)
- med dynamisk generering av arbetsflöden från mycket lätt skriven och förståelig Python-kod
- och möjligheten att länka ihop nästan alla databaser och API:er med hjälp av både färdiga komponenter och egna plugins (vilket görs extremt enkelt).
Vi använder Apache Airflow så här:
- vi samlar data från olika källor (många instanser av SQL Server och PostgreSQL, olika API:er med app-metrik, till och med 1C) till DWH och ODS (hos oss är det Vertica och Clickhouse).
- som en avancerad
cron, som startar konsolideringsprocesser på ODS och övervakar deras underhåll.
Tills nyligen täcktes våra behov av en liten server med 32 kärnor och 50 GB RAM. I Airflow fungerar:
- över 200 DAG-ar (faktiska arbetsflöden, där vi har fyllt uppgifter),
- i genomsnitt med 70 uppgifter,
- detta körs (också i genomsnitt) varje timme.
Och om hur vi expanderade kommer jag att skriva nedan, men nu låt oss definiera den övergripande uppgiften vi kommer att lösa:
Det finns tre ursprungliga SQL-servrar, var och en med 50 databaser - instanser av samma projekt, så strukturen är densamma (nästan överallt, muahaha), vilket innebär att varje server har en tabell som heter Orders (tack och lov kan vi trycka in en tabell med det namnet i vilket företag som helst). Vi hämtar data och lägger till hjälpfält (källa-server, källa-databas, ETL-uppgiftsidentifierare) och naivt slänger vi dem i, säg, Vertica.
Låt oss köra!
Huvuddelen, praktisk (och lite teoretisk)
Varför behöver vi det (och ni)
När träden var stora och jag var enkel SQL-arbetare i en rysk detaljhandel, körde vi ETL-processer aka datastreams med hjälp av två verktyg som vi hade tillgängliga:
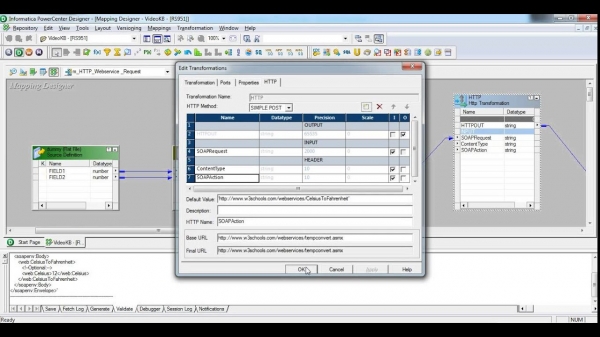
- Informatica Power Center — ett mycket omfattande system, extremt kraftfullt, med sin egen hårdvara och egen versionering. Jag använde kanske 1 % av dess kapabiliteter. Varför? Jo, för det första, det här gränssnittet var psykologiskt pressande och kändes kvar i 00-talet. För det andra, den här grejen är designad för extremt avancerade processer, intensiv återanvändning av komponenter och andra mycket viktiga företags-finesser. Vi ska vara tyst om att det kostar som en Airbus A380 per år.
Försiktighet, en skärmdump kan göra ont för yngre än 30 år

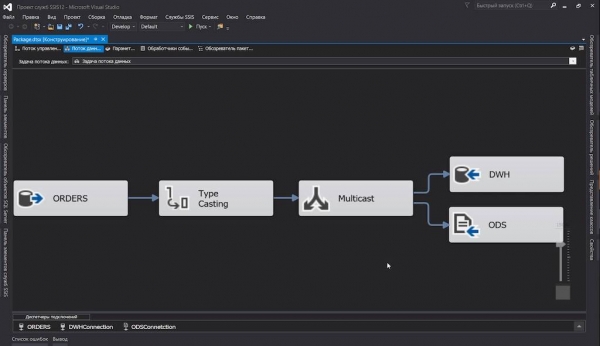
- SQL Server Integration Server — detta verktyg använde vi i vårt interna projektdatastream. Men ärligt talat: vi använder redan SQL Server, och att inte använda dess ETL-verktyg skulle vara irrationellt. Allt i det är bra: gränssnittet är snyggt, och det finns rapporter om utförande... Men vi älskar inte programvaruprodukter för det, oh nej. Vi kan versionera den
dtsx(som är en XML med blandade noder vid sparande) men vad hjälper det? Att skapa ett paket med uppgifter som kan flytta hundra tabeller från en server till en annan? Nej, vad hundra, din pekfinger kommer att falla av efter att ha klickat på musknappen tjugo gånger. Men det ser definitivt mer modernt ut:
Vi letade definitivt efter lösningar. Faktum är att nästan det gick så långt att skriva en egen generator för SSIS-paket…
… men sedan fick jag nytt jobb. Och där stötte jag på Apache Airflow.
När jag fick veta att beskrivningar av ETL-processer är enkel Python-kod, nästan dansade jag av glädje. Så här fick datastreams versionshantering och diff, och att slå samman tabeller med en enhetlig struktur från hundra databaser till en destination blev en fråga om Python-kod på en och en halv till två 13-tums skärmar.
Bygger en kluster
Låt oss inte ha en barnslig diskussion och prata om självklara saker som installation av Airflow, den databas du valt, Celery och andra frågor som beskrivs i dokumentationen.
För att vi ska kunna sätta igång med experimenten genast, har jag skissat på docker-compose.yml där:
- Låt oss starta Airflow: Scheduler, Webserver. Där kommer Flower att köras för att övervaka Celery-uppgifter (eftersom det redan har inkluderats i
apache/airflow:1.10.10-python3.7, och vi är inte emot det); - PostgreSQL, där Airflow kommer att skriva sin logginformation (schemaläggarens data, utförandestatistik osv.), och Celery – notera avslutade uppgifter;
- Redis, som kommer att fungera som uppgiftsbrygga för Celery;
- Celery-arbetare, som kommer att utföra uppgifterna direkt.
- I mappen
.\/dagsvi kommer att lägga våra filer med beskrivning av dags. De kommer att fångas upp i realtid, så det är inte nödvändigt att dra om hela stacken efter varje litet fel.
I vissa fall är koden i exemplen inte helt återgiven (för att inte överbelasta texten), och i andra fall modifieras den under processen. Hela fungerande kodexempel kan ses i repositoryt. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Main container with Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, will be scaled using `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Noteringar:
- I built the compose file mainly relying on the well-known image — definitely check it out. You might not need anything else in your life.
- All Airflow settings are available not only through
airflow.cfg, but also via environment variables (thanks to the developers), which I took full advantage of. - Of course, it's not production-ready: I intentionally did not set heartbeats on the containers and did not bother with security. But I created a minimum setup suitable for our experiments.
- Note that:
- The folder with the DAGs must be accessible to both the scheduler and the workers.
- The same applies to all third-party libraries—they must all be installed on the machines with the scheduler and the workers.
Now simply run:
$ docker-compose up --scale worker=3Once everything is up, you can check the web interfaces:
- Airflow:
- Flower:
Grundläggande begrepp
Om du inte förstod något av alla dessa "dags", här är en kort ordbok:
- Schemaläggare — den viktigaste personen i Airflow, som säkerställer att robotar jobbar och inte människor: han övervakar schemat, uppdaterar dags, och startar uppgifter.
Faktum är att han hade minnesproblem i äldre versioner (nej, inte amnesi, utan läckor) och det finns till och med en legacy-parameter kvar i konfigurationerna.
run_duration— tidsintervallet för hans omstart. Men nu fungerar allt bra. - DAG (även kallad "dag") — "direkt acyklisk graf", men den definitionen säger knappast något för de flesta, i grunden är det en behållare för uppgifter som interagerar med varandra (se nedan), eller en liknelse till Package i SSIS och Workflow i Informatica.
Förutom dags kan det också finnas subdags, men vi kommer sannolikt inte att nå dem.
- DAG Run — en initialiserad dag som tilldelats sitt
execution_date. DAG-körningar av samma dag kan mycket väl arbeta parallellt (om du förstås har gjort dina uppgifter idempotenta). - Operatör — bitarna av kod som ansvarar för att utföra en specifik åtgärd. Det finns tre typer av operatörer:
- åtgärd, som till exempel vår favorit,
PythonOperator, som kan utföra vilken (giltig) Python-kod som helst; - överföring, som transporterar data från en plats till en annan, säg,
MsSqlToHiveTransfer; - sensor kommer att tillåta att reagera eller försena fortsatt utförande av dag tills något sker.
HttpSensorkan slå an en specificerad endpoint, och när den får det svar den väntar på, startar överföringenGoogleCloudStorageToS3Operator. En nyfiken själ undrar: "Varför? Det går ju att göra omstarter direkt i operatören!" Men för att inte blockera uppgiftspoolen med hängande operatörer. Sensorn startar, kontrollerar och dör tills nästa försök.
- åtgärd, som till exempel vår favorit,
- Task — deklarerade operatörer oavsett typ som är kopplade till dags höjs till uppgiftsnivå.
- Uppgiftsinstans — när generalplaneraren bestämmer sig för att det är dags att skicka uppgifter i strid till utförande-arbetare (direkt på plats om vi använder
LocalExecutoreller på en fjärrnod i fallet medCeleryExecutor), tilldelar han dem en kontext (dvs ett set av variabler — utförandeparametrar), rullar ut kommandon eller förfrågningar och lägger dem i poolen.
Genererar uppgifter
Låt oss först beskriva den övergripande schemat av vår dag, och sedan dyka djupare och djupare in i detaljerna, eftersom vi tillämpar vissa icke-triviala lösningar.
Så, i enklaste form kommer en sådan dag att se ut så här:
från datetime import timedelta, datetime

från airflow import DAG
från airflow.operators.python_operator import PythonOperator

från commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

för conn_id, schema i sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Låt oss försöka förstå:
- Först importerar vi de nödvändiga biblioteken och något mer;
sql_server_ds— detta ärList[namedtuple[str, str]]med namnen på anslutningarna från Airflow Connections och databaserna som vi kommer att hämta vår tabell ifrån;dagär deklarationen av vår DAG, som absolut måste vara iglobals(), annars hittar inte Airflow den. Vi måste också tala om för DAG:en:- vad den heter
orders— detta namn kommer att dyka upp i webbgränssnittet, - att den kommer att börja arbeta från midnatt den 8 juli,
- och den ska köras var sjätte timme (för de tuffa killarna här istället för
timedelta()är det tillåtetcron-sträng0 0 0/6 ? * * *, för de mindre tuffa — ett uttryck som@daily);
- vad den heter
workflow()gör det huvudsakliga arbetet, men inte nu. Just nu kommer vi bara att dumpa vår kontext i loggen.- Och nu lite enkel magi för att skapa uppgifter:
- vi går igenom våra källor;
- initialiserar
PythonOperator, som kommer att utföra vår tomma funktionworkflow(). Glöm inte att ange ett unikt (inom DAG:en) uppgiftsnamn och koppla det till DAG:en. Flagganprovide_contextkommer i sin tur att lägga extra argument i funktionen, som vi noga kommer att samla in med hjälp av**context.
Det är allt för nu. Vad har vi fått:
- en ny DAG i webbgränssnittet,
- ett par hundra uppgifter som kommer att köras parallellt (om Airflows, Celerys och servrarnas inställningar tillåter det).
Nåväl, vi har nästan fått det.
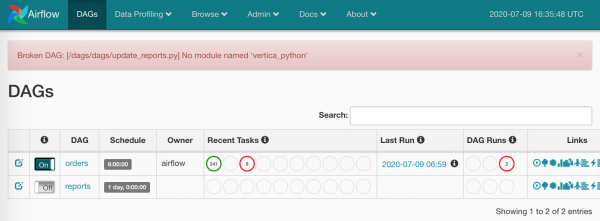
Vem ska sätta upp beroendena?
För att förenkla allt detta har jag infört docker-compose.yml bearbetningen requirements.txt på alla noder.
Nu kör vi:
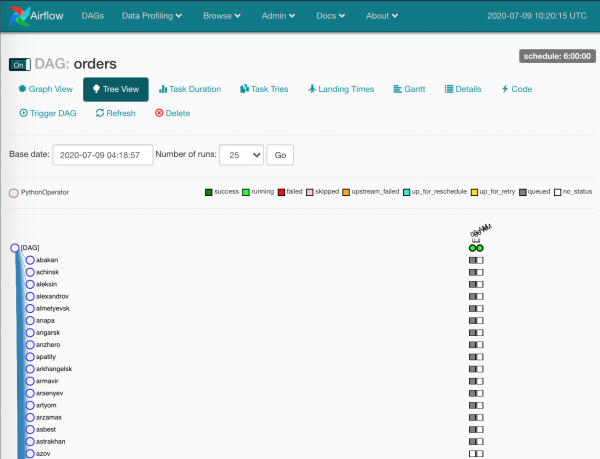
Grå rutor — task instances, bearbetade av schemaläggaren.
Vi väntar lite, uppgifterna tas om hand av arbetarna:
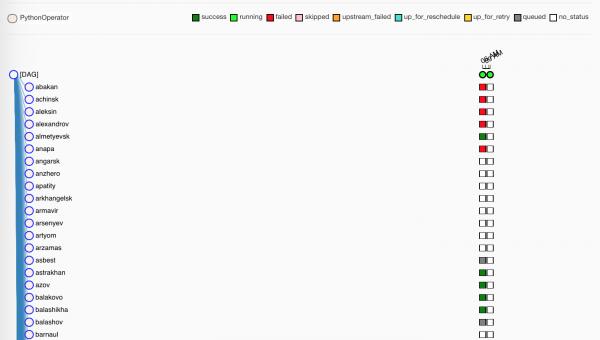
Gröna, förstås, — framgångsrikt avklarade. Röda — mindre framgångsrika.
Förresten, på vår produktionsserver finns det ingen mapp
.\/dags, som synkroniseras mellan maskinerna — alla DAG:ar ligger igitvår Gitlab, och Gitlab CI distribuerar uppdateringar till maskinerna vid sammanslagning imaster.
Lite om Flower
Medan arbetarna sätter igång våra tomma uppgifter, låt oss påminna oss om ett annat verktyg, som kan visa oss något — Flower.
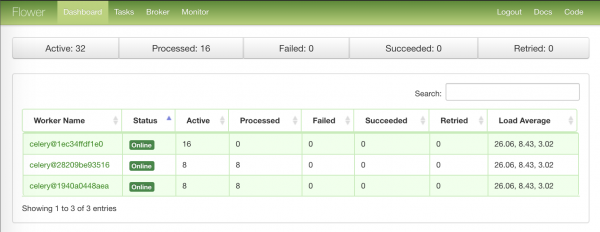
Den allra första sidan med sammanfattande information om nod-arbetarna:
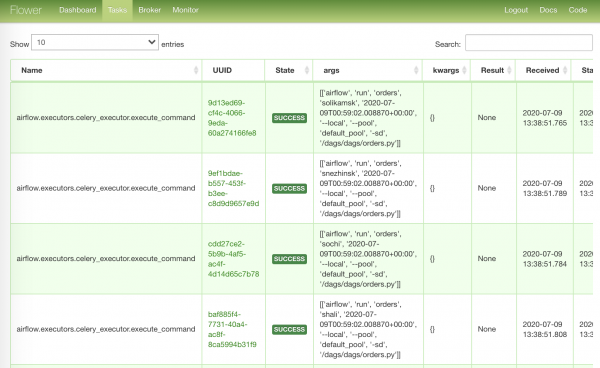
Den mest omfattande sidan med uppgifter som skickats för bearbetning:
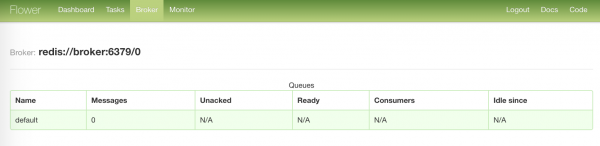
Den mest tråkiga sidan om statusen för vår mäklare:
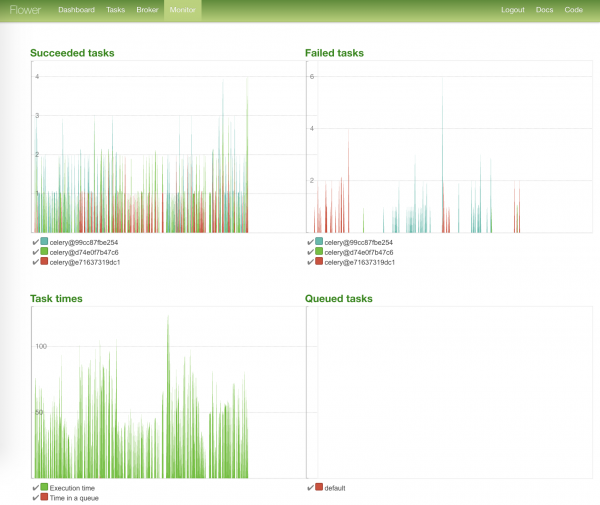
Den mest färgstarka sidan — med diagram över statusen för uppgifter och deras utförandetid:
Laddar ner det som inte laddats ner
Så, alla uppgifter har bearbetats, vi kan ta hand om de skadade.
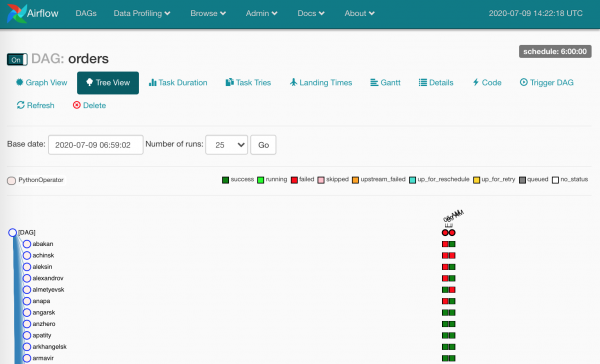
Och det visade sig vara en hel del skadade — av olika anledningar. Vid korrekt användning av Airflow talar dessa rutor om att data verkligen inte har kommit fram.
Vi behöver kolla loggen och starta om de kraschade task instances.
Genom att klicka på vilken ruta som helst ser vi de åtgärder som är tillgängliga för oss:
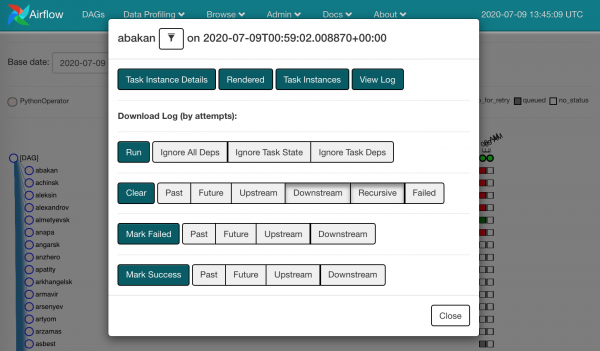
Vi kan ta och göra Clear på den som har kraschat. Det betyder att vi glömmer att något har gått fel, och den samma task instansen går tillbaka till schemaläggaren.
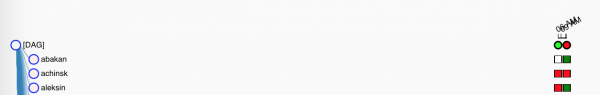
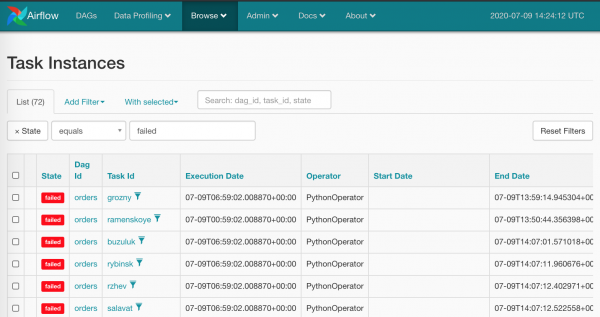
Det är uppenbart att göra så med musen för alla röda rutor inte är särskilt humant — det är inte det vi förväntar oss av Airflow. Naturligtvis har vi ett massförstörelsevapen: Browse/Task Instances
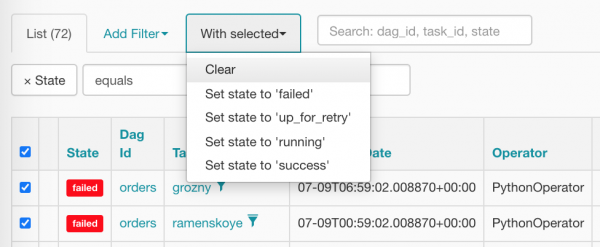
Vi väljer allt på en gång och nollställer genom att trycka på rätt alternativ:
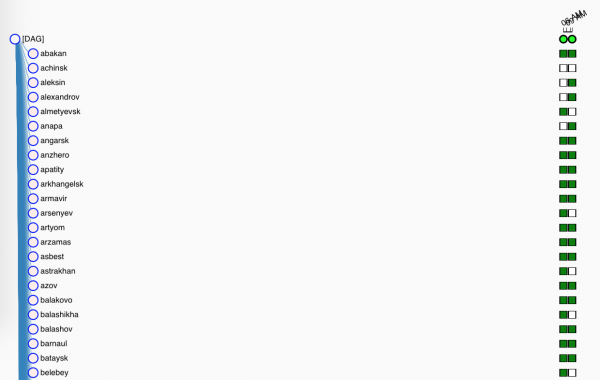
Efter rensning ser våra taxi ut så här (de väntar otåligt på att schemaläggaren ska planera dem):
Anslutningar, hooks och andra variabler
Det är dags att titta på nästa DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Dear gentlemen, the reports have been updated"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, wake up, we have {{ dag.dag_id }} crashed
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

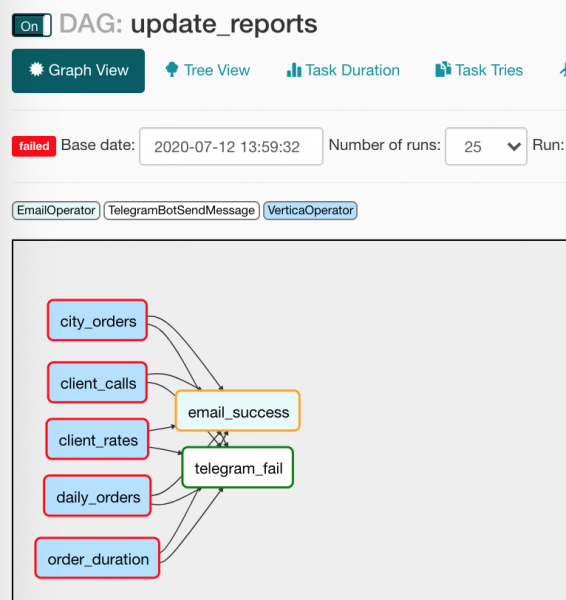
    report_update >> [email, tg]
Har alla någon gång gjort en rapportuppdatering? Här har vi den igen: det finns en lista över källor för att hämta data; det finns en lista över vart den ska läggas; glöm inte att skicka ett meddelande när allt har hänt eller gått fel (men det handlar inte om oss, eller hur).
Låt oss åter gå igenom filen och titta på de nya oklara sakerna:
from commons.operators import TelegramBotSendMessage— ingenting hindrar oss från att skapa våra egna operatörer, vilket vi har nyttjat genom att skapa ett litet wrapper för att skicka meddelanden i Unblocked. (Om denna operatör kommer vi att prata mer om nedan);default_args={}— DAG:en kan dela samma argument med alla sina operatörer;to='{{ var.value.all_the_kings_men }}'— fältettillkommer inte att vara hårdkodad, utan kommer att formas dynamiskt med hjälp av Jinja och en variabel med en lista av e-postadresser som jag noggrant lagt iAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— villkor för operatörens start. I vårt fall kommer brevet skickas till cheferna endast om alla beroenden har arbetat framgångsrikt;tg_bot_conn_id='tg_main'— argumentenconn_idtar emot identifierare för anslutningar som vi skapar iAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— meddelanden till Telegram kommer att skickas endast vid förekomst av misslyckade uppgifter;task_concurrency=1— vi förhindrar samtidigt körning av flera uppgiftsinstanser av samma uppgift. Annars får vi fleraVerticaOperator(som tittar på en tabell);report_update >> [email, tg]— allaVerticaOperatorkommer att konvergera i att skicka brevet och meddelandet, så här:

Men eftersom notifieringsoperatörerna har olika startvillkor, kommer endast en att fungera. I Tree View ser det något mindre överskådligt ut:

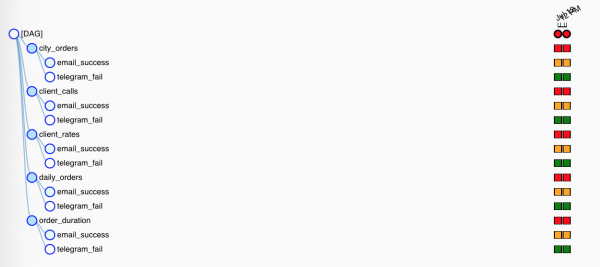
Jag ska säga ett par ord om makron och deras vänner — av variabler.
Makron är Jinja-platsinnehållare som kan infoga olika användbar information i operatörsargument. Till exempel så här:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} kommer att expandera till innehållet i kontextvariabeln execution_date i formatet YYYY-MM-DD: 2020-07-14. Det mest trevliga är att kontextvariabler fästs vid en viss instans av en uppgift (en ruta i Tree View), och vid omstart kommer platsinnehållarna att visa samma värden.
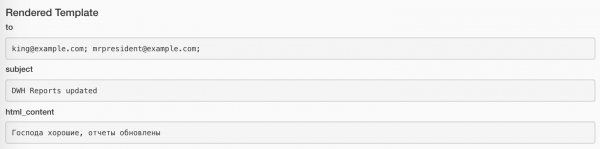
De tilldelade värdena kan ses med hjälp av Rendered-knappen på varje uppgiftsinstans. Så här ser det ut för uppgiften med att skicka brevet:
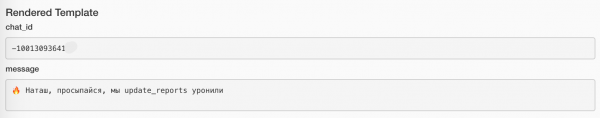
Och så här ser det ut för uppgiften med att skicka meddelandet:
En fullständig lista över inbyggda makron för den senaste tillgängliga versionen finns här:
Dessutom kan vi genom plugins deklarera egna makron, men det är en helt annan historia.
Förutom de fördefinierade objekten kan vi använda värden från våra variabler (jag har redan gjort detta i koden ovan). Låt oss skapa i Admin/Variables ett par objekt:
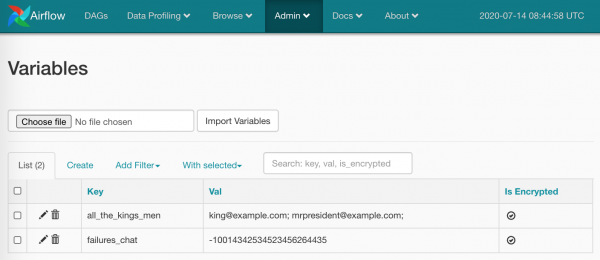
Klart, nu kan vi använda det:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')I värdet kan det vara en skalar eller så kan det ligga en JSON. I fallet med JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
använder vi bara sökvägen till nyckeln vi behöver: {{ var.json.bot_config.bot.token }}.
Jag ska säga ett enda ord och visa en skärmdump om kopplingar. Här är allt elementärt: på sidan Admin/Connections skapar vi en koppling, lägger in våra användarnamn/lösenord och mer specifika parametrar. Så här:
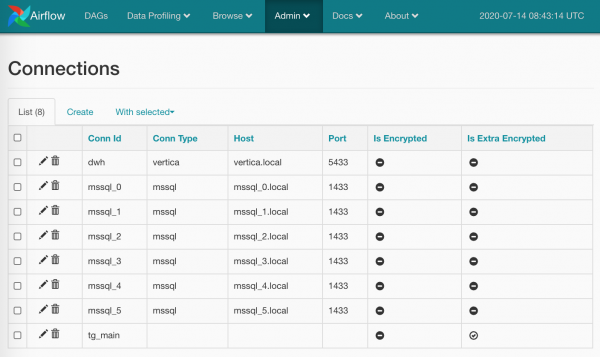
Lösenord kan krypteras (mer noggrant än i standardversionen), och man kan även välja att inte ange typ av koppling (som jag gjorde för tg_main) — poängen är att listan över typer är inbäddad i Airflows modeller och kan inte ändras utan att gå in i källkoden (om jag missat något i min forskning, ber jag er rätta mig), men att få kredentialer enbart genom namn är inget som hindrar oss.
Och man kan också skapa flera kopplingar med samma namn: i så fall kommer metoden BaseHook.get_connection(), som hämtar kopplingar efter namn, att returnera en slumpmässig av flera likadana (det skulle vara mer logiskt att göra Round Robin, men vi lämnar det till Airflows utvecklare).
Variables och Connections är utan tvekan användbara verktyg, men det är viktigt att inte förlora balansen: vilka delar av dina flöden förvarar du faktiskt i koden och vilka ger du till Airflow. Å ena sidan kan det vara bekvämt att snabbt ändra värden, till exempel e-postadress, via UI. Å andra sidan är det trots allt att återgå till att klicka med musen, vilket vi (jag) ville bli av med.
Arbete med kopplingar är en av uppgifterna hooks. Generellt sett är Airflow-hakar kopplingspunkter till externa tjänster och bibliotek. Till exempel kommer JiraHook att öppna en klient för att interagera med Jira (vi kan flytta uppgifter fram och tillbaka), och med hjälp av SambaHook kan vi ladda upp en lokal fil till smb-punkten.
Analyserar en anpassad operator
Och vi har kommit till den punkt där vi kan titta på hur TelegramBotSendMessage
Kod commons/operators.py är uppbyggd med själva operatören:
från typning importera Union

från airflow.operators importera BaseOperator

från commons.hooks importera TelegramBotHook, TelegramBot

klass TelegramBotSendMessage(BaseOperator):
    """Skicka meddelande till chat_id med TelegramBotHook

    Exempel:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     meddelande='{{ dag.dag_id }} misslyckades :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Send "{self.message}" till chatten {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Här, precis som allt annat i Airflow, är allt väldigt enkelt:
- Vi ärver från
BaseOperator, som implementerar ganska många Airflow-specifika saker (kolla på din fritid) - Vi deklarerade fälten
template_fields, där Jinja kommer att leta efter makron för bearbetning. - Vi organiserade korrekta argument för
__init__(), och satte standarder där det behövdes. - Vi glömde inte att initiera överklagandet.
- Vi öppnade den relevanta hooken
TelegramBotHook, fick klientobjektet från den. - Vi åsidosatte (överskred) metoden
BaseOperator.execute(), som Airflow kommer att kalla på när det är dags att köra operatorn — här genomför vi den huvudsakliga åtgärden, utan att glömma att logga in. (Förresten, vi loggar direkt istdoutochstderr— Airflow fångar allt, snyggt kapslar in det och sorterar det var det behövs.)
Låt oss se vad vi har i commons/hooks.py. Första delen av filen, med själva hooken:
från typning importera Union

från airflow.hooks.base_hook importera BaseHook
från requests_toolbelt.sessions importera BaseUrlSession

klass TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Notera: lägg till en anslutning med tom Conn Typ och glöm inte
    fylla i Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Jag vet egentligen inte vad jag kan förklara här, jag noterar bara viktiga punkter:
- Vi ärver, tänker på argumenten — i de flesta fall kommer det att vara ett enda:
conn_id; - Vi åsidosätter standardmetoder: jag begränsade mig till
get_conn(), där jag får anslutningsparametrarna efter namn och bara plockar ut sektionenextra(detta fält är för JSON), där jag (enligt min egen instruktion!) lade Telegram-bot tokenet:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Jag skapar en instans av vår
TelegramBot, och ger den redan en specifik token.
Det var allt. Du kan få klienten från hooken med hjälp av TelegramBotHook().clent eller TelegramBotHook().get_conn().
Och den andra delen av filen, där jag gör ett mikrounpakning för Telegram REST API, så att jag inte behöver dra med mig samma för bara en metod sendMessage.
class TelegramBot:
    """Telegram Bot API wrapper

    Exempel:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hej, älskling')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hej, älskling', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Den rätta vägen är att sammanfoga allt detta:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— i ett plugin, lägga det i ett offentligt repository, och ge ut det som Open Source.
Medan vi studerade allt detta har våra rapportuppdateringar lyckats krasch och skickat ett felmeddelande till mig i kanalen. Jag ska gå och kolla vad som är fel igen...
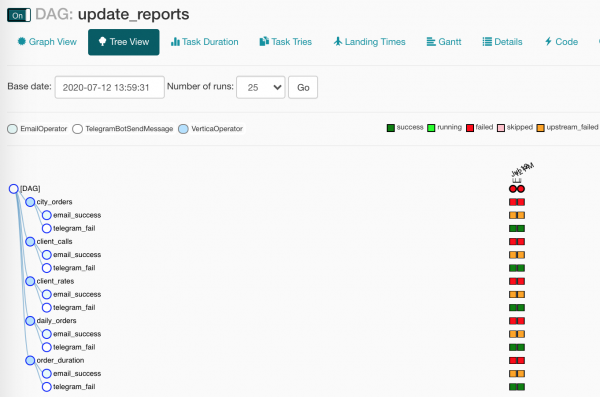
I vårt dag har något gått sönder! Var det inte precis det vi väntade på? Precis!
Ska du hälla?
Känner du att jag missade något? Jag lovade ju att föra data från SQL Server till Vertica, och nu tog jag och gled ifrån ämnet, skamligt!
Detta var ett medvetet brott, jag var bara tvungen att förklara lite terminologi för er. Nu kan vi fortsätta.
Vår plan var så här:
- Skapa ett dag
- Generera uppgifter
- Se hur allt ser vackert ut
- Tilldela sessionnummer till uppladdningar
- Hämta data från SQL Server
- Lägga data i Vertica
- Samla statistik
Så, för att köra allt detta, gjorde jag en liten tillägg till vår docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Här installerar vi:
- Vertica som värd
dwhmed de mest standardinställda konfigurationerna, - tre instanser av SQL Server,
- fyller databaserna med lite data (titta absolut inte i
mssql_init.py!)
Vi startar allt med hjälp av en något mer komplex kommando än förra gången:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Vad vår fantastiska randomizer har genererat kan vi, med hjälp av alternativet Data Profiling/Ad Hoc Query:
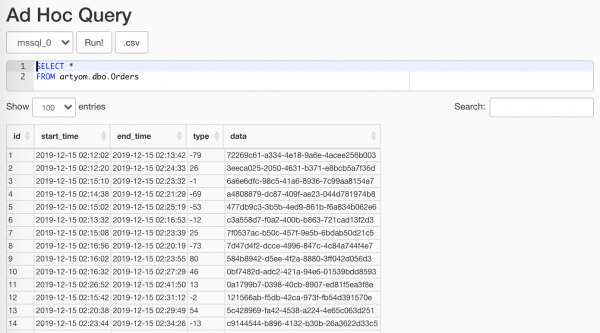
Det viktigaste är att inte visa detta för analytikerna
Jag kommer inte att gå in på detaljer om ETL-sessionerna där, allt är trivialt: vi skapar en databas, i den en tabell, vi omsluter allt i en kontextmanager, och nu gör vi så här:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Lasta arbetsflödet
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
från sys import stderr

class Session:
    """ETL arbetsflödes session

    Exempel:
        med Session(task_name) som session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Bra jobbat'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            SKAPA TABELL OM INTE FINNS sessions (
                id          SERIAL       INTE NULL PRIMARY KEY,
                task_name   VARCHAR(200) INTE NULL,

                started     TIMESTAMPTZ  INTE NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INFÖR sessions (task_name, finished)
            VÄRDEN (%s, NULL)
            RETURNERAR id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'öppnad')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Session är inte öppen')
        query = """
            UPPDATERA sessions
            STÄLL IN
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            VAR
                id = %s
            RETURNERAR id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'stängd',
              ', framgångsrik: ', self.successful,
              ', Laddad: ', self.loaded_rows,
              ', kommentar:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Det är dags att hämta vår data från våra mer än hundra och femtio tabeller. Vi gör detta med hjälp av några mycket enkla rader:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    VÄLJ
        id, start_time, end_time, type, data
    FRÅN dbo.Orders
    DÄR
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Med hjälp av hooken hämtar vi från Airflow
pymssql-anslutning - I frågan lägger vi in en begränsning i form av ett datum — i funktionen kommer templatern att fånga det.
- Vi matar in vår fråga
pandas, som kommer att hämta för ossDataFrame— den kommer att vara till nytta för oss senare.
Jag använder ersättning
{dt}istället för frågeparametern%sinte för att jag är en elak Buratino, utan för attpandaskan inte hanterapymssqloch ger den sista en urchinparams: List, även om den verkligen villtuple.
Notera också att utvecklarenpymssqlbeslutat att inte stödja den längre, och det är dags att flytta tillpyodbc.
Låt oss se vad Airflow har fyllt argumenten för våra funktioner med:
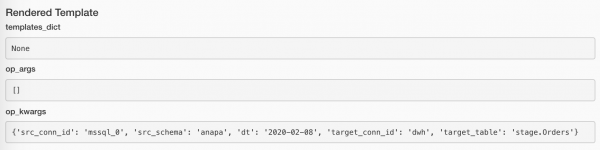
Om det inte finns några data, finns det ingen mening att fortsätta. Men att betrakta uppladdningen som framgångsrik är också konstigt. Men det är inte ett fel. Vad ska man göra?! Så här:
if df.empty:
    raise AirflowSkipException('Inga rader att ladda')
AirflowSkipException kommer att säga att det faktiskt inte finns något fel, och vi hoppar över uppgiften. I gränssnittet kommer det att vara varken en grön eller röd ruta, utan en rosa.
Låt oss ge våra data några kolumner:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Det vill säga:
- DB:n vi hämtade beställningarna från,
- Identifieraren för vår uppladdande session (den kommer att vara olika för varje uppgift),
- Hash från källan och beställningsidentifieraren — så att vi har en unik identifierare för beställningen i den slutgiltiga databasen (där allt kommer att samlas i en tabell).
Kvarstår är näst sista steget: ladda allt i Vertica. Och, som det är konstigt, är en av de mest effektiva sätten att göra detta — via CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Vi gör en speciell mottagare
StringIO. pandassom vänligt lägger vårDataFramei form avCSV-rader.- Vi öppnar en anslutning till vår älskade Vertica med ett hook.
- Och nu med hjälp av
copy()ska vi skicka våra data direkt till Vertica!
Från drivrutinen hämtar vi hur många rader som har laddats, och vi säger till sessionschefen att allt är OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Det var allt.
I produktionen skapar vi måltabellen manuellt. Här har jag tillåtit mig en liten automatisering:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Jag använder
VerticaOperator()för att skapa databasschemat och tabellen (om de inte redan finns, förstås). Det viktigaste är att ställa in beroenden korrekt:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Sammanfattning
— Nåväl, — sa musungen, — är det inte sant att nu
Har du försäkrat dig om att jag är det läskigaste djuret i skogen?
Julia Donaldson, "Gruffalon"
Jag tror att om jag och mina kollegor tävlade om vem som snabbast kunde skapa och köra en ETL-process från grunden: de med sina SSIS och musen och jag med Airflow… Och sedan skulle vi jämföra hur lätt det var att underhålla… Åh, jag tror att ni skulle hålla med om att jag skulle vinna på alla fronter!
Om vi ska vara lite mer seriösa, så har Apache Airflow – genom att beskriva processerna i form av programkod – gjort mitt jobb mycket mer bekvämt och trevligare.
Dess oändliga skalbarhet: både vad gäller plugins och dess benägenhet för skalbarhet – ger dig möjlighet att använda Airflow praktiskt taget överallt: oavsett om det är i hela cykeln för insamling, förberedelse och behandling av data, eller i raketuppskjutningar (till Mars, förstås).
Avslutande del, referens och information
Fallgropar som vi har samlat för er
start_date. Ja, det är redan ett lokalt meme. Genom huvudargumentet i DAG:enstart_dategår allt igenom. Kort sagt, om man anger istart_datedet aktuella datumet, och ischedule_interval– en dag, så kommer DAG:en att köras imorgon tidigast.start_date = datetime(2020, 7, 7, 0, 1, 2)Och inga fler problem.
Det finns också ett annat exekveringsfel kopplat till detta:
Task is missing the start_date parameter, vilket oftast betyder att du har glömt att knyta tillverkaren till DAG:en.- Allt på en maskin. Ja, både databasen (både Airflow och vårt gränssnitt), webbservern, schemaläggaren och arbetarna. Det fungerade till och med. Men med tiden växte antalet uppgifter för tjänsterna, och när PostgreSQL började ge svar baserat på index efter 20 ms istället för 5 ms, tog vi bort den.
- LocalExecutor. Ja, vi är fortfarande kvar på den, och vi har redan kommit till avgrunden. LocalExecutor:n har varit tillräcklig för oss, men nu är det dags att expandera med minst en arbetare, och vi måste anstränga oss för att flytta till CeleryExecutor. Och eftersom man kan arbeta med den på en enda maskin, så finns det inget som hindrar användningen av Celery även på en server som "naturligtvis aldrig kommer att gå i produktion, jag lovar!"
- Icke-användning av inbyggda verktyg:
- Connections för att lagra tjänsternas autentiseringsuppgifter,
- SLA Misses för att reagera på uppgifter som inte har körts i tid,
- XCom för att utbyta metadat (jag sa metadata!) mellan uppgifterna i DAG:en.
- Missbruk av e-post. Vad kan man säga? Jag hade ställt in aviseringar för alla upprepningar av fallna uppgifter. Nu har jag över 90k e-postmeddelanden från Airflow i min arbets-Gmail, och webbgränssnittet för e-post vägrar att ta bort mer än 100 åt gången.
Fler fallgropar:
Verktyg för ännu mer automatisering
För att vi ska kunna arbeta mer med huvudet istället för med händerna har Airflow förberett följande åt oss:
- — den har fortfarande status som Experimental, vilket inte hindrar den från att fungera. Med dess hjälp kan man inte bara få information om DAG:ar och uppgifter, utan också stoppa/starta en DAG, skapa en DAG Run eller pool.
- — många verktyg är tillgängliga via kommandoraden som inte bara är obekväma att använda via WebUI utan faktiskt inte finns där. Till exempel:
backfillär nödvändigt för att köra instanser av uppgifter på nytt.
Till exempel kommer analytiker och säger: "Men ni, kära vänner, har skräp i data från den 1 till 13 januari! Åtgärda det!" Och du är sådär, hokus pokus:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Databasunderhåll:
initdb,resetdb,upgradedb,checkdb. run, som låter dig starta en instans av en uppgift och skita i alla beroenden. Dessutom går det att starta den genomLocalExecutor, även om du har ett Celery-kluster.- Nästan samma sak gör
test, men den skriver ingenting i databasen. connectionsmöjliggör massbeläggning av anslutningar via shell.
- — en ganska hardcore metod för interaktion som är avsedd för plugins, inte att pilla med för hand. Men vem hindrar oss från att gå in i
/home/airflow/dags, startaipythonoch börja göra som vi vill? Man kan till exempel exportera alla anslutningar med följande kod:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Anslutning till Airflows metadatabas. Jag rekommenderar inte att skriva till den, men det går betydligt snabbare och enklare att hämta uppgiftstillstånd för olika specifika metrik än genom något av API:erna.
Låt oss säga att inte alla våra uppgifter är idempotenta och ibland kan falla, och det är okej. Men flera fel — det är redan misstänkt och man borde kolla upp det.
Akta dig för SQL!
MED last_executions SOM (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAGAR
),
failed SOM (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Länkar
Självklart, de första tio länkarna från Googles sökresultat innehåller mappen Airflow från mina bokmärken.
- — självklart, man bör börja med den officiella dokumentationen, men vem läser manualer?
- — åtminstone, läs rekommendationerna från skaparna.
- — allra första steget: användargränssnittet i bilder
- — de grundläggande begreppen är väl förklarade, ifall (i värsta fall!) du inte förstod mig.
- — en kort guide till att konfigurera en Airflow-kluster.
- — en nästan lika intressant artikel, förutom att det är lite mer formellt, och färre exempel.
- — om arbetet i samverkan med Celery.
- — om idempotens av uppgifter, belastning baserat på ID istället för datum, transformationer, filstruktur och andra intressanta saker.
- — uppgiftsberoenden och Trigger Rule som jag nämnde endast i förbifarten.
- — hur man övervinner några "fungerar som det ska" hos schemaläggaren, laddar förlorad data och prioriterar uppgifter.
- — användbara SQL-frågor för Airflows metadata.
- — det finns en användbar sektion om att skapa en anpassad sensor.
- — en intressant kort notering om att bygga infrastruktur på AWS för Data Science.
- — vanliga fel (när någon inte läser manualer).
- — le, hur folk krånglar med att lagra lösenord, när man enkelt kan använda Connections.
- — implicit DAG passthrough, context injection in functions, again about dependencies, and also about skipping task runs.
- — om användning av
standardargumentochparamsi mallar samt om Variabler och Anslutningar. - — en berättelse om hur schemaläggaren förbereds för Airflow 2.0.
- — en lite föråldrad artikel om driftsättning av vår kluster i
docker-compose. - — dynamiska uppgifter med hjälp av mallar och kontextöverföring.
- — standard och anpassade meddelanden via e-post och Slack.
- — Grenering av uppgifter, makron och XCom.
Och länkarna som används i artikeln:
- — tillgängliga platshållare för användning i mallar.
- — Vanliga misstag vid skapande av DAG:ar.
- —
docker-composeför experiment, avblockering och mer. - — Python-wrapper för Telegram REST API.
Källa: habr.com
