

Det är förmodligen ingen hemlighet för någon att förra året var ett år med stora förändringar för Apache Hadoop. Under förra året skedde en sammanslagning mellan Cloudera och Hortonworks (i princip en uppköp av den senare), och Mapr, på grund av allvarliga ekonomiska problem, såldes till Hewlett Packard. Och om valet förr, vid on-premises installationer, oftare handlade om Cloudera och Hortonworks, har vi tyvärr inte längre det valet. En överraskning var också att Cloudera från februari i år har meddelat att de upphör med att släppa binära versioner av sin distribution i offentliga register, och nu finns de bara tillgängliga genom en betald prenumeration. Naturligtvis finns det fortfarande möjlighet att ladda ner de senaste versionerna av CDH och HDP som släpptes före slutet av 2019, och stöd för dem förväntas i ett till två år. Men vad ska man göra framöver? För dem som tidigare betalade för en prenumeration har inget förändrats. Men för dem som inte vill gå över till den betalda versionen av distributionen, men som ändå vill ha möjlighet att få de senaste versionerna av klusterkomponenterna, samt patchar och andra uppdateringar, har vi förberett denna artikel. I den kommer vi att titta på möjliga alternativ för att ta sig ur den uppkomna situationen.
Artikeln är mer översiktlig. Det kommer inte att finnas någon jämförelse av distributionerna och deras detaljerade analys, liksom inga recept för installation och konfigurering. Men vad kommer det att finnas? Vi kommer kort att berätta om en distribution som heter Arenadata Hadoop, som verkligen förtjänar vår uppmärksamhet på grund av sin tillgänglighet, vilket idag är en stor sällsynthet. Och sedan kommer vi att prata om Vanilla Hadoop, huvudsakligen om hur man kan "förbereda" det med hjälp av Apache Bigtop. Redo? Välkommen in.
Arenadata Hadoop
Det är en helt ny och, för närvarande, fortfarande ganska okänd distribution av inhemsk utveckling. Tyvärr finns det just nu bara .
Mer information kan hittas på den officiella projektet. De senaste versionerna av distributionen är baserade på Hadoop 3.1.2 för version 3, och 2.8.5 för version 2.
Information om roadmap kan hittas .
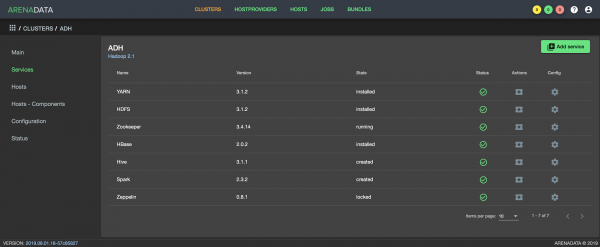
Arenadata Cluster Manager-gränssnittet
Den centrala produkten från Arenadata är , som används för installation, konfiguration och övervakning av olika programlösningar från företaget. ADCM distribueras gratis och dess funktionalitet kan utökas genom att lägga till paket som består av ansible-playbooks. Paketen delas in i två typer: enterprise och community. De senare är tillgängliga för gratis nedladdning från Arenadatas webbplats. Det finns också möjlighet att utveckla sitt eget paket och koppla det till ADCM.
För distribution och hantering av Hadoop 3 erbjuds en community-version av paketet i kombination med ADCM, och för Hadoop 2 finns det endast som alternativ. När det gäller repository med paket är de öppna för offentlig åtkomst, och de kan laddas ner och installeras på det vanliga sättet för alla komponenter i klustret. Sammanlagt ser distributionen ganska intressant ut. Jag är säker på att det finns de som är vana vid sådana lösningar som Cloudera Manager och Ambari, och som kommer att tycka om ADCM. För vissa kan det också vara en stor fördel att distributionen för importersättning.
När det kommer till nackdelar kommer de att vara desamma som för alla andra Hadoop-distributioner. Det vill säga:
- Den så kallade «vendor lock-in». Med exempel från Cloudera och Hortonworks har vi redan insett att det alltid finns en risk för förändringar i företagets policy.
- Betydande eftersläpning från Apache:s upstream.
Vanilla Hadoop
Som ni vet är Hadoop inte en monolitisk produkt, utan i grunden en hel uppsättning tjänster kring dess distribuerade filsystem HDFS. Det är sällan tillräckligt med bara ett filkluster. Vissa behöver Hive, andra Presto, och det finns även HBase och Phoenix, medan Spark används allt oftare. För orkestrering och dataströmning finns ibland Oozie, Sqoop och Flume. Och när det kommer till säkerhet tänker man genast på Kerberos i kombination med Ranger.
Binarversioner av Hadoop-komponenter finns tillgängliga på varje projekts webbplats inom ekosystemet i form av tarballs. De kan laddas ner och installeras, men med ett villkor: förutom att du själv bygger paketen från "råa" binärer, vilket du troligtvis kommer att vilja göra, så kommer du inte att ha någon säkerhet kring kompatibiliteten mellan de nedladdade versionerna av komponenterna. En mer föredragen lösning är att bygga med hjälp av Apache Bigtop. Bigtop gör det möjligt att bygga från Apache Maven-repo, köra tester och bygga paket. Men, vad som är mycket viktigt för oss, är att Bigtop kommer att bygga de versioner av komponenterna som är kompatibla med varandra. Detta kommer vi att utforska närmare senare.
Apache Bigtop
Apache Bigtop är ett verktyg för att bygga, paketera och testa en rad
öppen källkodprojekt, som Hadoop och Greenplum till exempel. Bigtop har många
utgåvor. Vid tidpunkten för skrivandet var den senaste stabila utgåvan version 1.4,
och i master låg 1.5. Olika versioner av utgåvor använder olika versioner
av komponenter. Till exempel, för 1.4 har core-komponenterna Hadoop version 2.8.5, medan master
har 2.10.0. Innehållet av de stödda komponenterna förändras. Något gammalt och
inte underhålls försvinner, medan något nytt, mer efterfrågat kommer in, och
det är inte nödvändigtvis något från Apache-familjen.
Dessutom har Bigtop många .
När vi började bekanta oss med Bigtop, blev vi först och främst förvånad över dess blygsamma, i jämförelse med andra Apache-projekt, spridning och kännedom, samt det mycket lilla communityt. Det följer att information om produkten är minimal, och att sökning efter lösningar på uppkomna problem på forum och mailinglistor kanske inte ger något resultat alls. Till en början visade det sig vara en svår uppgift för oss att göra en fullständig bygga av distributionen på grund av verktygets egenheter, men mer om det senare.
Som ett teaser - för dem som tidigare gillade projekt inom Linux-universumet, som Gentoo och LFS, kan det vara nostalgiskt trevligt att arbeta med det här och minnas de "legendariska" tiderna när vi själva sökte (och ibland skrev) ebuilds och regelbundet byggde om med nya patchar för Mozilla.
En stor fördel med Bigtop är öppenheten och mångsidigheten hos de verktyg som det bygger på. I dess grund ligger Gradle och Apache Maven. Gradle är välkänt som verktyget som Google använder för att bygga Android. Det är flexibelt och, som man säger, 'beprövat i strid'. Maven är det officiella verktyget för att bygga projekt inom Apache, och eftersom de flesta av dess produkter släpps genom Maven, så kan man inte klara sig utan det här. Det är värt att uppmärksamma POM (project object model) – en 'fundamentalt' xml-fil som beskriver allt som behövs för Maven att arbeta med ditt projekt, och kring vilken hela arbetet kretsar. Det är i
delen av Maven som vissa hinder uppstår, som vanligtvis möter dem som första gången arbetar med Bigtop.
Praxis
Så, var ska man börja? Gå till nedladdningssidan och ladda ner den senaste stabila versionen i form av ett arkiv. Där kan man också hitta de binära artefakterna som Bigtop har byggt. För övrigt, av de vanliga paketshanterarna stöds YUM och APT.
Ett alternativt sätt är att ladda ner den senaste stabila versionen direkt från
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKlonar till 'bigtop'…
remote: Uppräkning av objekt: 46, klart.
remote: Räknar objekt: 100% (46/46), klart.
remote: Komprimerar objekt: 100% (41/41), klart.
remote: Totalt 40217 (delta 14), återanvända 10 (delta 1), pack-återanvända 40171
Hämtar objekt: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, klart.
Fastställande av förändringar: 100% (20503/20503), klart.
Uppdaterar filer: 100% (1998/1998), klart.
Den resulterande katalogen ./bigtop ser ungefär ut så här:
./bigtop-bigpetstore — demonstrationsappar, syntetiska exempel
./bigtop-ci — CI-verktyg, jenkins
./bigtop-data-generators — datagenerering, syntetik, för röktester osv.
./bigtop-deploy — verktyg för distribution
./bigtop-packages — konfigurationer, skript, patchar för byggning, huvuddel av verktyget
./bigtop-test-framework — testramverk
./bigtop-tests — själva testerna, belastningstester och röktester
./bigtop_toolchain — byggmiljö, förberedelse av miljön för verktygets arbete
./build — arbetskatalog för byggning
./dl — katalog för nedladdade källfiler
./docker — byggning i docker-bilder, testning
./gradle — gradle-konfiguration
./output – katalog för byggartefakter
./provisioner — provisionering
Det mest intressanta vid detta stadium för oss är huvudkonfigurationen ./bigtop/bigtop.bom, där vi ser alla stödda komponenter med versioner. Här kan vi ange en annan produktversion (om vi vill prova att bygga den) eller versionsnumret för byggningen (om vi till exempel har lagt till en betydande patch).
Även underkatalogen väcker stort intresse .\/bigtop\/bigtop-packages, som har en direkt relation till processen för att bygga komponenter och paket med dem.
Så, vi har laddat ner arkivet, packat upp det eller klonat det från github, kan vi börja bygga?
Nej, först förbereder vi miljön.
Förberedelse av miljön
Här behövs en liten avstickare. För att bygga nästan vilken mer eller mindre komplex produkt som helst krävs en viss miljö — i vårt fall JDK, samma delade bibliotek, header-filer osv., verktyg som ant, ivy2 och mycket mer. Ett av sätten att få den nödvändiga miljön för Bigtop är att installera de nödvändiga komponenterna på byggvärden. Jag kan ha fel i kronologin, men det verkar som att det från version 1.0 även fanns ett alternativ för att bygga med förkonfigurerade och tillgängliga docker-bilder, som man kan bekanta sig med här.
När det gäller förberedelse av miljön finns det en hjälpare — Puppet.
Vi kan använda följande kommandon, körningen görs från rotkatalogen
av verktyget, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Eller direkt via puppet:
puppet apply --modulepath= -e "include bigtop_toolchain::installer"\npuppet apply --modulepath= -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath= -e "include bigtop_toolchain::development-tools"Tyvärr kan det redan på detta stadium uppstå problem. Den allmänna råd här är att använda en stödd distribution, i aktuellt tillstånd på byggvärden eller prova vägen med docker.
Samling
Vad kan vi försöka bygga? Svaret på denna fråga ger utdata från kommandot
.\/gradlew tasks I avsnittet Package tasks finns en rad produkter som är de slutgiltiga artefakterna av Bigtop.
De kan identifieras med suffixet -rpm eller -pkg-ind (i fallet med byggning
i docker). I vårt fall är Hadoop det mest intressanta.
Låt oss försöka utföra byggandet i miljön på vår build-server:
.\/gradlew hadoop-rpmBigtop laddar automatiskt ner de nödvändiga källorna som krävs för den specifika komponenten och påbörjar byggprocessen. Verktygets funktion är kopplad till Maven-repositorier och andra källor, vilket innebär att det behöver internetåtkomst.
Under arbetets gång genereras en standardutmatning. Ibland kan man utifrån detta och felmeddelanden förstå vad som har gått fel. Ibland krävs det att man får mer information. I sådana fall bör man lägga till argumen --info eller --debug, och det kan dessutom vara användbart att inkludera –stacktrace. Det finns ett smidigt sätt att skapa en uppsättning data för efterföljande hänvisningar i distributionslistor, nyckeln är --scan.
Med hjälp av detta kommer Bigtop att samla all information och lägga den i gradle, och efter det ge en länk,
genom att följa vilken en kompetent person kan förstå varför byggprocessen misslyckades.
Viktigt att tänka på är att detta alternativ kan göra oönskad information offentlig, till exempel användarnamn, noder, miljövariabler, osv., så var försiktig.
Ofta beror fel på att det inte går att hämta nödvändiga komponenter för byggprocessen. Vanligtvis kan problemet lösas genom att skapa en patch för att rätta till något i källorna, till exempel adressen i pom.xml i rotdirektoriet för källorna. Detta görs genom att skapa och placera den i den relevanta katalogen .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ patchen, till exempel i form av patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Troligen, vid tidpunkten för läsningen av denna artikel, behöver du inte göra ovanstående korrigering själv.
Vid implementering av patchar och ändringar i byggsystemet kan det vara nödvändigt att "återställa" byggprocessen genom ett rensningskommando:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Denna operation kommer att återställa alla ändringar i byggprocessen för denna komponent, varefter byggprocessen kommer att köras igen. Denna gång ska vi försöka bygga projektet i en docker-image:
./gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Task :hadoop-pkg-ind
Bygger 1.2.1 hadoop-pkg på centos-7 i Docker...
+++ dirname ./bigtop-ci/build.sh
++ cd ./bigtop-ci/..
++ pwd
+ BIGTOP_HOME=/tmp/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop/slaves:1.2.1-centos-7 /sbin/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
många utdata
....
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-secondarynamenode-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-journalnode-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-resourcemanager-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-nodemanager-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-proxyserver-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-timelineserver-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-historyserver-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-client-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Skriven: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd /bigtop/build/hadoop/rpm//BUILD
+ cd hadoop-2.8.5-src
+ /usr/bin/rm -rf /bigtop/build/hadoop/rpm/BUILDROOT/hadoop-2.8.5-1.el7.x86_64
Utför (%clean): /bin/sh -e /var/tmp/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Utför (--clean): /bin/sh -e /var/tmp/rpm-tmp.CwDb22
+ cd /bigtop/build/hadoop/rpm//BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Skapar /bigtop/build/hadoop/.rpm
:hadoop-rpm (Tråd[Task worker för ':',5,main]) slutförd. Tog 38 min 1.151 sek.
:hadoop-pkg (Tråd[Task worker för ':',5,main]) startad.
> Task :hadoop-pkg
Uppgift ':hadoop-pkg' är inte uppdaterad eftersom:
Uppgift har inte deklarerat några utdata trots att den utförde åtgärder.
:hadoop-pkg (Tråd[Task worker för ':',5,main]) slutförd. Tog 0.0 sek.
BYGG FRAMGÅNGSRIKT på 40m 37s
6 åtgärdsbara uppgifter: 6 utförda
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Fel: Ingen sådan behållare:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BYGG FRAMGÅNGSRIKT på 41m 24s
1 åtgärdsbar uppgift: 1 utförd
Byggnaden gjordes för CentOS, men kan även utföras för Ubuntu:
./gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indUtöver att bygga paket för olika Linux-distributioner kan verktyget skapa ett repository med de byggda paketen, till exempel:
./gradlew yumVi kan också nämna smoke-tester och distribution i Docker.
Skapa en kluster med tre noder:
./gradlew -Pnum_instances=3 docker-provisionerKör smoke-tester i klustret med tre noder:
./gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerTa bort klustret:
./gradlew docker-provisioner-destroyFå kommandon för att ansluta in i Docker-containrar:
./gradlew docker-provisioner-sshVisa status:
./gradlew docker-provisioner-statusMer detaljer om distributionsuppgifter kan läsas i dokumentationen.
När det kommer till tester finns det ett stort antal, huvudsakligen smoke och integrationstester. Deras analys ligger utanför ramarna för denna artikel. Jag kan bara säga att bygga distributionen inte är så komplicerat som det kan verka vid första anblicken. Alla komponenter vi använder i produktion har lyckats byggas och genomgå tester, och vi har inte stött på problem med distribution eller utförande av grundläggande operationer i testmiljön.
Förutom de befintliga komponenterna i Bigtop finns det möjlighet att lägga till något annat, även egen programutveckling. Allt detta automatiseras utmärkt och passar in i CI/CD-konceptet.
Slutsats
Det är uppenbart att en distribution som byggts på detta sätt inte omedelbart ska skickas till produktion. Man måste förstå att om det finns ett verkligt behov av att bygga och stödja sin egen distribution så kräver det ekonomiska och tidsmässiga investeringar.
Trots detta, med rätt tillvägagångssätt och ett professionellt team kan man helt klart klara sig utan kommersiella lösningar.
Det är viktigt att notera att själva projektet Bigtop behöver utveckling, och det verkar som att aktiv utveckling inte pågår idag. Också osäkerheten kring perspektivet av Hadoop 3:s ankomst är oklart. För övrigt, om du har ett verkligt behov av att bygga Hadoop 3 kan du titta på från Arenadata, där förutom standard
komponenter också finns en rad ytterligare (Ranger, Knox, NiFi).
När det gäller Rostelecom är Bigtop en av de alternativ vi överväger för närvarande. Om vi väljer det eller inte – tiden får utvisa.
Bilaga
För att inkludera en ny komponent i byggnaden måste du lägga till dess beskrivning i bigtop.bom och ./bigtop-packages. Du kan försöka göra detta med hjälp av befintliga komponenter. Försök förstå det. Det är inte så svårt som det verkar vid första anblicken.
Vad tycker ni? Vi ser gärna era åsikter i kommentarerna och tackar för ert engagemang!
Artikeln är förberedd av datahanteringsteamet på "Rostelecom"
Källa: habr.com
