

Hej, Habr! Idag ska vi bygga ett system som med hjälp av Spark Streaming behandlar meddelandeflöden från Apache Kafka och skriver resultaten till en molndatabas, AWS RDS.
Låt oss anta att en kreditorganisation ställer oss inför uppgiften att behandla inkommande transaktioner "i realtid" för alla sina filialer. Detta kan göras för att snabbt beräkna den öppna valutapositionen för kassan, gränser eller det finansiella resultatet för affärer, etc.
Hur man implementerar detta fall utan att använda magi och trollformler — läs vidare! Låt oss köra!
Introduktion
Självklart erbjuder behandling av stora datamängder i realtid stora möjligheter för användning i moderna system. En av de mest populära kombinationerna för detta är tandem Apache Kafka och Spark Streaming, där Kafka skapar en ström av inkommande meddelandepaket och Spark Streaming behandlar dessa paket under ett givet tidsintervall.
För att öka systemets tillförlitlighet kommer vi att använda checkpoints. Med denna mekanism behöver Spark Streaming-modulen, när den behöver återställa förlorade data, bara återvända till den senaste kontrollpunkten och återuppta beräkningarna därifrån.
Arkitekturen för det utvecklade systemet
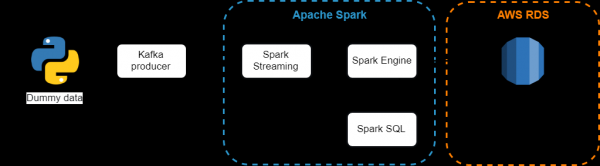
Använda komponenter:
- — är ett distribuerat meddelandebytesystem med publicering och prenumeration. Det är lämpligt för både offline och online konsumption av meddelanden. För att förhindra dataloss sparas meddelanden från Kafka på disk och replikeras inom klustret. Kafka-systemet är byggt ovanpå ZooKeeper-tjänsten;
- — komponenten Spark för bearbetning av strömmande data. Modulen Spark Streaming är byggd med hjälp av mikrobatch-arkitektur, där en datastream tolkas som en kontinuerlig sekvens av små datapaket. Spark Streaming tar emot data från olika källor och samlar dem i små paket. Nya paket skapas med regelbundna tidsintervall. I början av varje tidsintervall skapas ett nytt paket, och all data som kommer in under detta intervall inkluderas i paketet. I slutet av intervallet upphör paketets tillväxt. Storleken på intervallet bestäms av en parameter som kallas batchintervall;
- — förenar relationell bearbetning med funktionell programmering i Spark. Strukturerade data definieras som data som har ett schema, det vill säga en enhetlig uppsättning fält för alla poster. Spark SQL stödjer indata från många källor med strukturerade data och, tack vare att schemainformation finns, kan det effektivt extrahera endast de nödvändiga fälten i posterna samt tillhandahålla API-gränssnitt för DataFrame;
- — en relativt billig molnrelaterad relationsdatabas, en webbtjänst som förenklar installation, drift och skalering, hanteras direkt av Amazon.
Installation och körning av Kafka-servern
Innan Kafka kan användas direkt, måste du säkerställa att Java finns installerat, eftersom JVM används för att köra det:
sudo apt-get update
sudo apt-get install default-jre
java -version
Skapa en ny användare för att arbeta med Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Ladda ner distributionspaketet från Apache Kafkas officiella webbplats:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Packa upp den nedladdade arkivet:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
Nästa steg är valfritt. Frågan är att standardinställningarna tillåter inte att man fullt ut utnyttjar alla funktioner i Apache Kafka. Till exempel att ta bort en ämne, kategori eller grupp som meddelanden kan publiceras på. För att ändra detta, redigera konfigurationsfilen:
vim ~/kafka/config/server.propertiesLägg till följande i slutet av filen:
delete.topic.enable = trueInnan vi startar Kafka-servern, måste vi starta ZooKeeper-servern. Vi kommer att använda ett hjälpskript som följer med Kafka-distributionen:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
När ZooKeeper har startat framgångsrikt, starta Kafka-servern i ett separat terminalfönster:
bin/kafka-server-start.sh config/server.propertiesLåt oss skapa ett nytt ämne med namnet Transaction:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionVi kontrollerar att ämnet har skapats med rätt antal partitioner och replikering:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 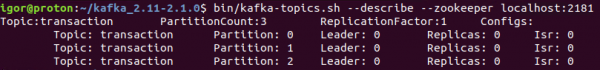
Vi hoppar över testmomentet för producer och konsument för det nyligen skapade ämnet. Mer detaljerat om hur man kan testa att skicka och ta emot meddelanden står i den officiella dokumentationen — . Men vi går vidare till att skriva en producer på Python med KafkaProducer API.
Skriv en producer
Producenten kommer att generera slumpmässiga data – 100 meddelanden varje sekund. Med slumpmässiga data menar vi en ordbok som består av tre fält:
- Filial – namnet på försäljningsstället för kreditorganisationen;
- Valuta – valutakursen för transaktionen;
- Belopp – beloppet för transaktionen. Beloppet kommer att vara ett positivt tal om det handlar om köp av valuta av banken, och negativt om det handlar om försäljning.
Koden för producenten ser ut som följande:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Därefter, med hjälp av metoden send, skickar vi meddelandet till servern, till det ämne vi vill ha, i JSON-format:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Meddelandet har skickats till ett ämne:
            {}, partition: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Det verkar ha uppstått ett fel: {}'.format(e))

finally:
    producer.flush()
När skriptet körs får vi följande meddelanden i terminalen:
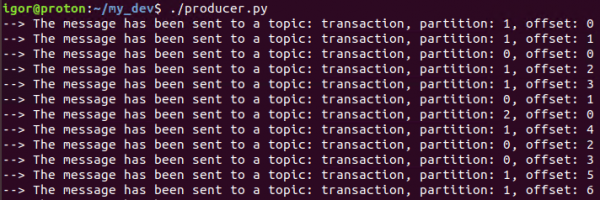
Det betyder att allt fungerar som vi ville – producenten genererar och skickar meddelanden till det ämne vi vill ha.
Nästa steg blir att installera Spark och bearbeta denna ström av meddelanden.
Installation av Apache Spark
Apache Spark — är en mångsidig och högpresterande klusterberäkningsplattform.
När det gäller prestanda överträffar Spark populära implementationer av MapReduce, samtidigt som det erbjuder stöd för en bredare uppsättning beräkningstyper, inklusive interaktiva frågor och strömmande behandling. Hastighet spelar en viktig roll vid hantering av stora datamängder, eftersom hastigheten möjliggör interaktivt arbete utan att behöva vänta minuter eller timmar. En av de viktigaste fördelarna med Spark, som möjliggör denna höga hastighet, är dess förmåga att utföra beräkningar i minnet.
Denna ramverk är skriven i Scala, så vi måste installera det först:
sudo apt-get install scalaLadda ner Spark-distributionen från den officiella webbplatsen:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Packa upp arkivet:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkLägg till sökvägen till Spark i bash-filen:
vim ~/ .bashrcLägg till följande rader via redigeraren:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Kör kommandot nedan efter att ha gjort ändringar i bashrc:
source ~/ .bashrcDistribution av AWS PostgreSQL
Det återstår att distribuera databasen där vi ska ladda upp den bearbetade informationen från strömmarna. För detta kommer vi att använda tjänsten AWS RDS.
Logga in på konsolen AWS —> AWS RDS —> Databaser —> Skapa databas:
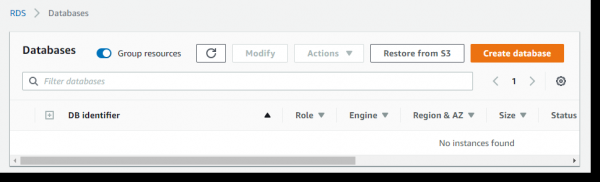
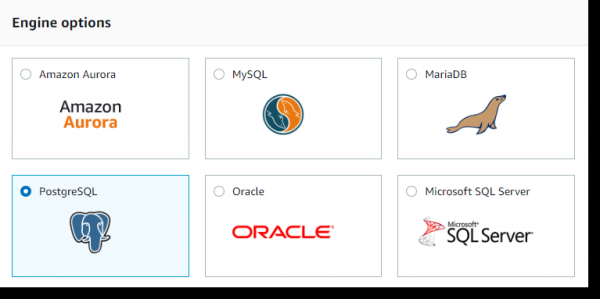
Välj PostgreSQL och klicka på knappen Nästa:
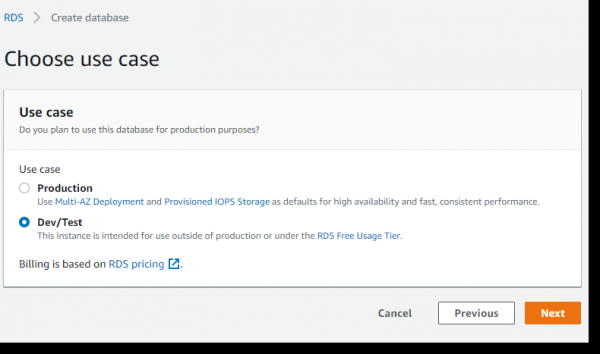
Eftersom detta exempel endast behandlas för utbildningsändamål kommer vi att använda en gratis server "med minimala resurser" (Free Tier):
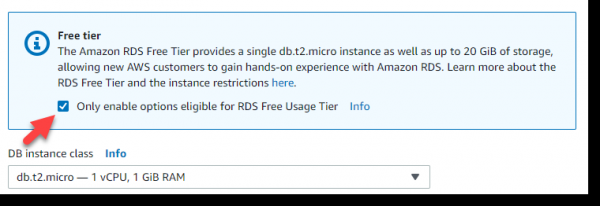
Därefter markerar vi kryssrutan i blocket Free Tier, och efter det får vi automatiskt ett instans av typen t2.micro – om än svagt, men gratis och helt tillräckligt för vår uppgift:
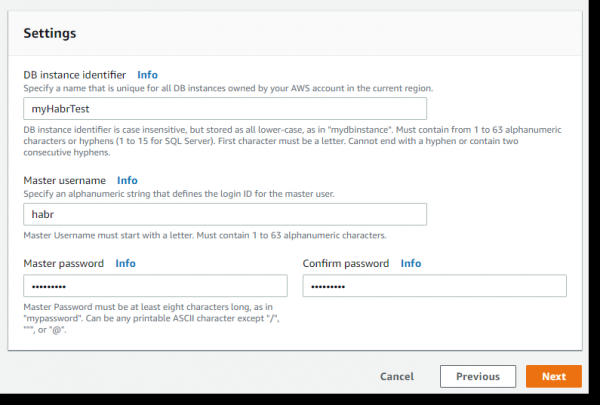
Följande är mycket viktiga saker: namnet på DB-instansen, namn på huvud-användaren och hans lösenord. Vi döper instansen till: myHabrTest, huvud-användare: habr, lösenord: habr12345 och klickar på knappen Nästa:
På nästa sida finns parametrarna som ansvarar för tillgängligheten av vår DB-server utifrån (Public accessibility) och tillgängligheten av portar:
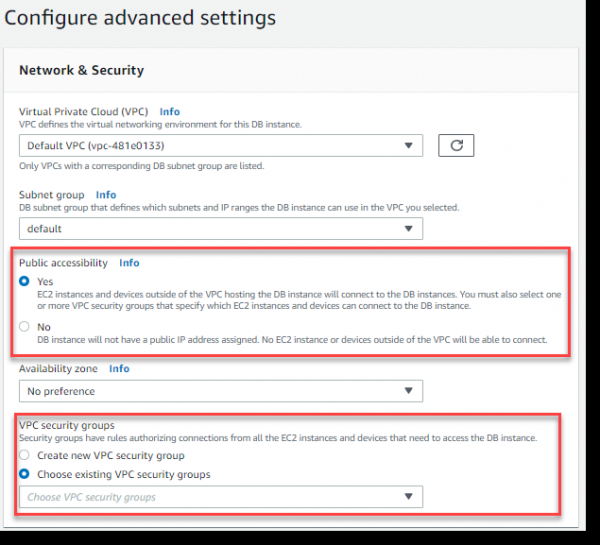
Låt oss skapa en ny inställning för VPC-säkerhetsgruppen, som tillåter extern åtkomst till vår DB-server via port 5432 (PostgreSQL).
Låt oss gå till AWS-konsolen i ett separat webbläsarfönster till VPC Dashboard —> Säkerhetsgrupper —> Skapa säkerhetsgrupp:
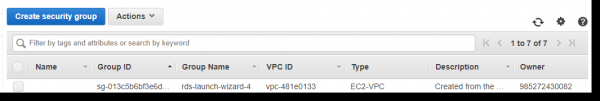
Ange ett namn för Security group – PostgreSQL, en beskrivning, ange vilken VPC denna grupp ska associeras med och klicka på knappen Skapa:

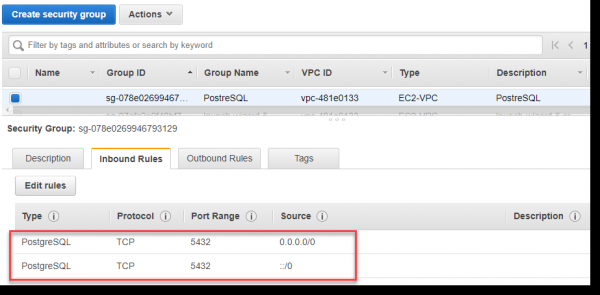
Fyll i den nyss skapade gruppens Inbound rules för port 5432, som visas på bilden nedan. Porten behöver inte anges manuellt, utan kan väljas från rullgardinsmenyn Typ som PostgreSQL.
Rent tekniskt betyder värdet ::/0 att servern har tillgång till inkommande trafik från hela världen, vilket kan anses vara lite missvisande, men för att förtydliga exemplet tillåter vi oss att använda denna metod:
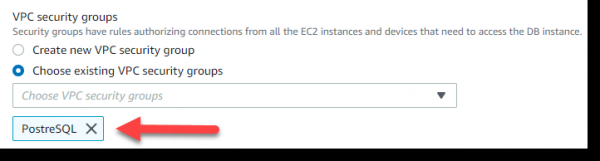
Återvänd till webbläsarsidan där vi har öppnat "Configure advanced settings" och välj i avsnittet VPC security groups –> Välj befintliga VPC security groups –> PostgreSQL:
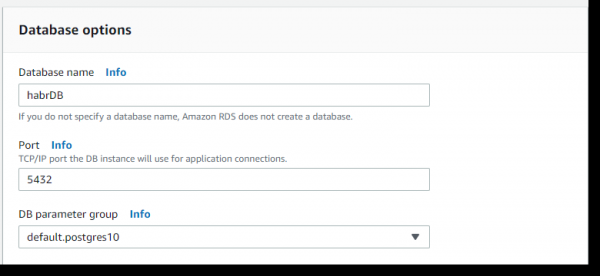
Därefter, i avsnittet Databasalternativ –> Databasnamn –> ange namnet – habrDB.
Övriga parametrar, med undantag för eventuell avstängning av backup (backup retention period – 0 days), övervakning och Performance Insights, kan lämnas som standard. Klicka på knappen Skapa databas:
Strömhanterare
Det sista steget kommer att vara utvecklingen av en Spark-jobb, som varannan sekund kommer att bearbeta nya data som kommer från Kafka och lagra resultatet i databasen.
Som nämnt ovan är checkpoints den grundläggande mekanismen i SparkStreaming, som måste ställas in för att säkerställa fel tolerans. Vi kommer att använda checkpoints och, om processen kraschar, krävs det bara att återvända till den senaste checkpointen för att återuppta beräkningarna.
Checkpointen kan aktiveras genom att ställa in en katalog i ett fel toleranta, pålitligt filsystem (t.ex. HDFS, S3 osv.), där checkpointinformation sparas. Detta görs exempelvis med:
streamingContext.checkpoint(checkpointDirectory)I vårt exempel kommer vi att använda följande tillvägagångssätt, nämligen, om checkpointDirectory finns, kommer kontexten att återskapas från checkpointdata. Om katalogen inte finns (det vill säga körs första gången), så anropas funktionen functionToCreateContext för att skapa en ny kontext och ställa in DStreams:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Skapa ett objekt DirectStream för att ansluta till ämnet "transaction" med hjälp av metoden createDirectStream från KafkaUtils:
från pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Parsing av inkommande data i JSON-format:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Vi använder Spark SQL för att göra en enkel gruppering och skriver ut resultatet i konsolen:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Vi får texten av frågan och kör den genom Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Och sedan sparar vi de aggregerade data i en tabell i AWS RDS. För att spara aggregatresultaten i databastabellen använder vi metoden write för DataFrame-objektet:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
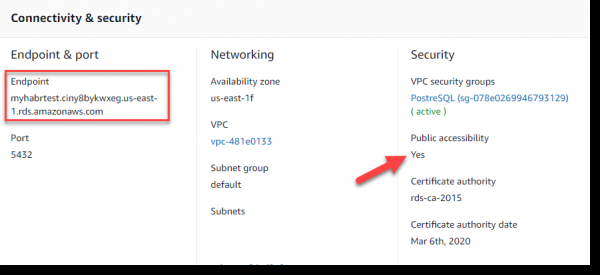
Några ord om hur du konfigurerar anslutningen till AWS RDS. Användaren och lösenordet skapades i steg "Distribution av AWS PostgreSQL". För databasens serveradress bör du använda Endpoint som visas i avsnittet Connectivity & security:
För en korrekt koppling mellan Spark och Kafka bör jobben köras genom spark-submit med hjälp av artefaktet spark-streaming-kafka-0-8_2.11. Dessutom kommer vi även att tillämpa artefakten för att interagera med PostgreSQL-databasen, som vi kommer att överföra via —packages.
För flexibiliteten i skriptet ska vi också föra ut namnet på meddelandeservern och ämnet som ingångsparametrar från vilket vi vill hämta data.
Så nu är det dags att köra och kontrollera systemets funktionalitet:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
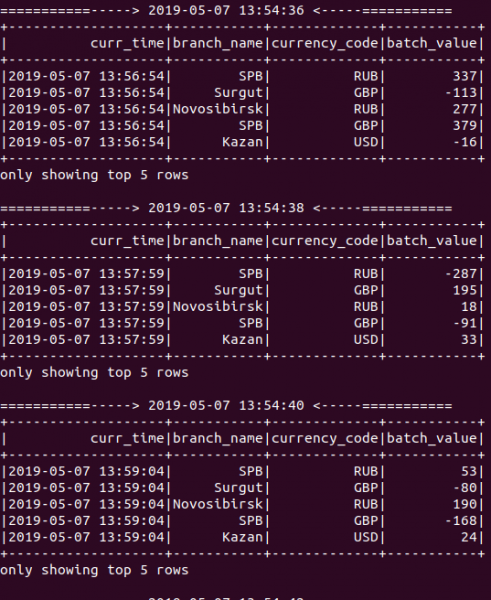
Det fungerade! Som du kan se på bilden nedan — under applikationens drift visas nya aggregater var 2:a sekund, eftersom vi satte batchintervallet till 2 sekunder när vi skapade StreamingContext-objektet:
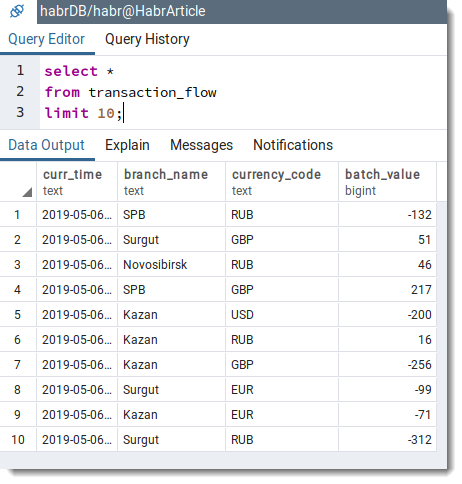
Därefter gör vi en enkel fråga till databasen för att kontrollera om det finns poster i tabellen transaction_flow:
Slutsats
I denna artikel granskades ett exempel på strömmande informationsbehandling med hjälp av Spark Streaming i samarbete med Apache Kafka och PostgreSQL. Med den ökande mängden data från olika källor är det svårt att överskatta det praktiska värdet av Spark Streaming för att skapa strömmande applikationer och applikationer som fungerar i realtid.
Den fullständiga koden kan du hitta i mitt arkiv på .
Jag ser fram emot att diskutera denna artikel, jag väntar på dina kommentarer och hoppas även på konstruktiv kritik från alla intresserade läsare.
Jag önskar dig framgång!
Ps. Det var först planerat att använda en lokal PostgreSQL-databas, men med tanke på min kärlek till AWS beslutade jag mig för att flytta databasen till molnet. I nästa artikel om detta ämne kommer jag att visa hur man helt implementerar det ovan beskrivna systemet i AWS med hjälp av AWS Kinesis och AWS EMR. Håll utkik efter nyheter!
Källa: habr.com
