

År 2017 vann vi upphandlingen för att utveckla det transaktionella kärnet för Alphabanks investeringsverksamhet och påbörjade arbetet (vid HighLoad++ 2018 med en presentation om kärnan för investeringsverksamheten Vladimir Drynkin, chef för det transaktionella kärnet för investeringsverksamheten på Alphabank). Detta system skulle samla data om affärer från olika källor i olika format, standardisera data, lagra dem och ge åtkomst till dem.
Under utvecklingsprocessen utvecklades systemet och fick mer funktionalitet, och vid något tillfälle insåg vi att vi formas något mycket större än bara en applikation som skapades för att lösa ett strikt definierat utbud av uppgifter: vi fick ett system för att bygga distribuerade applikationer med beständig lagring. Den erfarenhet vi fått låg till grund för en ny produkt — (TDG).
Jag vill berätta om arkitekturen för TDG och de beslut vi fattade under utvecklingen, introducera er för den grundläggande funktionaliteten och visa hur vår produkt kan bli grunden för att bygga kompletta lösningar.
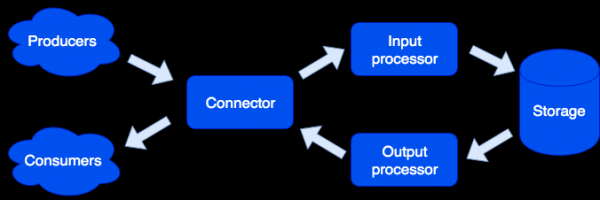
Arkitektoniskt har vi delat systemet i separata roller, där varje roll är ansvarig för att lösa ett visst antal uppgifter. En enskild körning av applikationen implementerar en eller flera typer av roller. I klustret kan det finnas flera roller av samma typ:
Connector
Connector ansvarar för kommunikationen med omvärlden; dess uppgift är att ta emot en begäran, analysera den, och om det lyckas, skicka data för bearbetning till input processor. Vi stöder format som HTTP, SOAP, Kafka, FIX. Arkitekturen gör det enkelt att lägga till stöd för nya format, snart kommer vi att stödja IBM MQ. Om analysen av begäran misslyckas kommer connector att returnera ett fel; annars kommer den att svara att begäran har behandlats framgångsrikt, även om det uppstod ett fel vid vidare bearbetning. Detta är gjort för att kunna arbeta med system som inte kan upprepa begärningar — eller tvärtom, gör det alltför insisterande. För att inte förlora data används en reparationskö: objektet hamnar först där och tas bara bort från den efter lyckad behandling. Administratören kan få aviseringar om objekt som kvarstår i reparationskön, och efter att ha åtgärdat en programvarufel eller hårdvarufel kan försöka igen.
Input processor
Input processor klassificerar de mottagna uppgifterna efter karakteristiska kännetecken och anropar lämpliga hanterare. Hanterarna är kod på Lua-språket, som körs i en sandbox, så de kan inte påverka systemets funktionalitet. På detta stadium kan data konverteras till önskat format, och vid behov kan ett valfritt antal uppgifter startas, som kan implementera den logik som behövs. Till exempel, i produkten MDM (Master Data Management), byggd på Tarantool Data Grid, när en ny användare läggs till, för att inte fördröja behandlingen av begäran, startar vi skapandet av guldposten som en separat uppgift. Sandlådan stöder läs-, ändrings- och tilläggsfrågor, och möjliggör att utföra viss funktionalitet på alla roller av typ storage och aggregera resultatet (map/reduce).
Hanterare kan beskrivas i filer:
sum.lua

local x, y = unpack(...)
return x + y
Och sedan deklareras i konfigurationen:
functions:
  sum: { __file: sum.lua }
Varför Lua? Lua är ett mycket enkelt språk. Baserat på vår erfarenhet, efter ett par timmar med att lära sig det, börjar människor skriva kod som löser deras problem. Och det är inte bara professionella utvecklare, utan även till exempel analytiker. Dessutom, tack vare just-in-time kompilatorn, fungerar Lua mycket snabbt.
Storage
Lagring lagrar beständiga data. Innan de sparas valideras data i förhållande till dataskeman. För att beskriva schemat använder vi ett utökat format. . Exempel:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Utifrån denna beskrivning genereras automatiskt DDL (Data Definition Language) för databashanteraren Tarantool och schema för dataåtkomst.
Asynkron datareplication stöds (det planeras att lägga till synkron).
Output processor
Ibland behöver externa konsumenter meddelas om att nya data har anlänt, för detta finns rollen Output processor. Efter att data har sparats kan de överföras till motsvarande bearbetare (till exempel för att anpassa dem till vad konsumenten kräver) - och efter detta skickas de till connector för utskick. Här används även en reparationskö: om objektet inte har accepterats av någon kan administratören försöka igen senare.
Skalning
Rollerna connector, input processor och output processor har ingen status, vilket gör att vi kan skala systemet horisontellt genom att helt enkelt lägga till nya instanser av applikationen med den önskade rolletypen aktiverad. För horisontell skalning används lagring för att organisera kluster med hjälp av virtuella behållare. Efter att en ny server har lagts till flyttas en del av behållarna från de gamla servrarna i bakgrunden till den nya servern; detta sker transparent för användarna och påverkar inte hela systemets funktion.
Dataegenskaper
Objekt kan vara mycket stora och innehålla andra objekt. Vi säkerställer atomicitet vid tillägg och uppdatering av data genom att spara objektet med alla dess beroenden i en virtuell behållare. På så sätt undviks "utsträckning" av objektet över flera fysiska servrar.
Versionshantering stöds: varje objektuppdatering skapar en ny version, och vi kan alltid ta en tidsavskurning och se hur världen såg ut då. För data som inte behöver en lång historia kan vi begränsa antalet versioner eller till och med bara lagra en — den sista, vilket i praktiken innebär att vi stänger av versionshantering för en viss typ. Vi kan också begränsa historiken i tid: till exempel, ta bort alla objekt av en viss typ som är äldre än 1 år. Arkivering stöds också: vi kan exportera objekt som är äldre än angiven tid, vilket frigör utrymme i klustret.
Uppgifter
Bland de intressanta funktionerna finns möjligheten att köra uppgifter enligt schema, på begäran av användaren eller programmässigt från sandlådan:
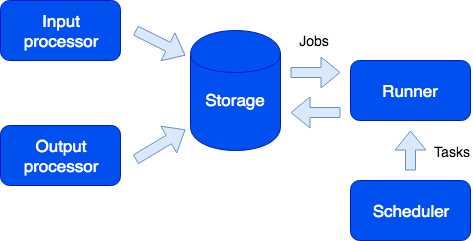
Här ser vi en annan roll — runner. Denna roll har inget tillstånd och vid behov kan ytterligare instanser av applikationen med den här rollen läggas till i klustret. Ansvarig för runner är att utföra uppgifter. Som nämnts kan nya uppgifter skapas från sandlådan; de sparas i kön på lagringen och utförs sedan på runner. Denna typ av uppgift kallas Jobb. Vi har också en typ av uppgift kallad Task — detta är användardefinierade uppgifter som körs enligt schema (cron-syntax används) eller på begäran. För att starta och övervaka sådana uppgifter har vi en användarvänlig uppgiftsförvaltare. För att denna funktionalitet ska vara tillgänglig måste rollen scheduler aktiveras; denna roll har tillstånd, så den kan inte skalas, vilket i och för sig inte krävs; samtidigt kan den, precis som alla andra roller, ha en replik som börjar fungera om master plötsligt misslyckas.
Logger
En annan roll kallas logger. Den samlar loggar från alla medlemmar i klustret och tillhandahåller ett gränssnitt för att exportera och visa dem via webgränssnittet.
Tjänster
Det är värt att nämna att systemet gör det enkelt att skapa tjänster. I konfigurationsfilen kan du ange vilka begärningar som ska riktas till den användardefinierade hanteraren som körs i sandlådan. I denna hanterare kan du till exempel utföra en analytisk begäran och returnera resultatet.
Tjänsten beskrivs i konfigurationsfilen:
services:
   sum:
      doc: "adderar två siffror"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API genereras automatiskt och tjänsten blir tillgänglig för anrop:
fråga {
   sum(x: 1, y: 2)
}
Detta kommer att leda till att hanteraren anropas sum, som kommer att returnera resultatet:
3
Profilering av förfrågningar och metrik
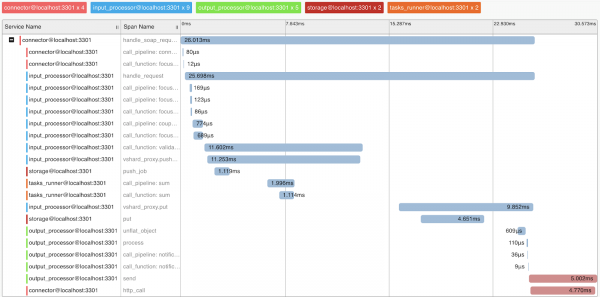
För att förstå systemets funktion och profilera förfrågningar har vi implementerat stöd för OpenTracing-protokollet. Systemet kan vid begäran skicka information till verktyg som stöder detta protokoll, som Zipkin, vilket gör det möjligt att analysera hur förfrågan utfördes:
Naturligtvis erbjuder systemet interna metrik som kan samlas in med hjälp av Prometheus och visualiseras med Grafana.
Utveckla
Tarantool Data Grid kan distribueras från RPM-paket eller arkiv, med hjälp av levererade verktyg eller Ansible, och stöd för Kubernetes finns också ().
Applikationen som implementerar affärslogik (konfiguration, hanterare) laddas upp till den distribuerade Tarantool Data Grid-klustret i form av ett arkiv via UI eller med hjälp av ett skript, genom det API vi tillhandahåller.
Exempel på applikationer
Vilka applikationer kan skapas med hjälp av Tarantool Data Grid? Egentligen är de flesta affärsuppgifter på ett eller annat sätt relaterade till hantering av dataflöden, lagring och tillgång till dem. Så om du har stora datamängder som behöver lagras säkert och vara tillgängliga, kan vår produkt spara dig mycket tid på utvecklingen och låta dig fokusera på din affärslogik.
Till exempel vill vi samla information om fastighetsmarknaden för att i framtiden kunna ha information om de mest förmånliga erbjudandena. I detta fall identifierar vi följande uppgifter:
- Roboter som samlar information från öppna källor kommer att utgöra våra datakällor. Detta problem kan du lösa genom att använda färdiga lösningar eller genom att skriva kod på valfritt språk.
- Därefter kommer Tarantool Data Grid att ta emot och lagra data. Om dataformatet från olika källor skiljer sig, kan du skriva kod i Lua som kommer att standardisera formatet. Under förbehandlingssteget kan du även filtrera bort dubbletter eller uppdatera informationen om agenter som arbetar på marknaden i databasen.
- Nu har du redan en skalbar lösning i ett kluster som kan fyllas med data och användas för dataval. Nästa steg kan vara att implementera nya funktioner, till exempel skriva en tjänst som gör en förfrågan till datan och ger det mest fördelaktiga erbjudandet på en dag — detta kräver några rader i konfigurationsfilen och lite kod i Lua.
Vad händer härnäst?
Vårt fokus ligger på att förbättra utvecklingsbekvämligheten med hjälp av . Till exempel, det här är en IDE med stöd för profilering och felsökning av hanterare som körs i en sandlåda.
Vi lägger också stor vikt vid säkerhetsfrågor. Just nu genomgår vi certifiering av FSTEK i Ryssland för att bekräfta hög säkerhetsnivå och uppfylla krav på certifiering av programvaruprodukter som används i informationssystem för personuppgifter och statliga informationssystem.
Källa: habr.com
