

av St-Pete
Hej alla! Jag heter Mons Anderson, plattformsarkitekt , och jag kommer att berätta hur vi byggde vårt S3-lagring, hur det fungerar, vilka lösningar som var framgångsrika och vilka vi skulle ha ändrat om vi skulle starta ett liknande projekt från början idag.
Artikeln är baserad på en presentation på av Mail.ru Cloud Solutions & Tarantool. I artikeln kommer vi att diskutera:
- hur lagringen på Mail.ru var organiserad, som vi byggde vårt S3-lagring på;
- vad vi lade till för att skapa Mail.ru Cloud Storage;
- hur objektlagringsmodellen fungerar och vilka steg som har tagits för att komma till produktion;
- om förbättringar av produktionssystemet: failover och skalning;
- hur vi implementerade shardning och resharding;
- samt om hantering av SSL-certifikat.
Om du inte vill läsa kan du .
Hur lagringen på Mail.ru var organiserad, som vi byggde vårt S3-lagring på
Utvecklingen av vårt S3 började över Mail.ru Cloud-lagringen, därför är det viktigt att först berätta hur det är organiserat och vad det kan göra.
Mail.ru:s molnlagring består av servrar med diskar. I genomsnitt är en modern lagringsserver 36 diskar på 12–14 terabyte. Tidigare var diskarna mindre, men under de senaste tre åren har diskstorlekarna ökat och idag är det nästan en halv petabyte rådata.
Disken från olika servrar i lagringen kombineras i så kallade "par". Ett par är en enhet för lagring av filer. I grund och botten är det en disk som är monterad i en viss partition på en viss väg, där filer som identifieras med hashar kan lagras.
Par är en historisk benämning som har kvarstått till idag, även om det nu inte nödvändigtvis bara är två diskar i ett par. Det kan finnas tre diskar, och det kan även finnas olika hybrida lagringar, till exempel 3/2.
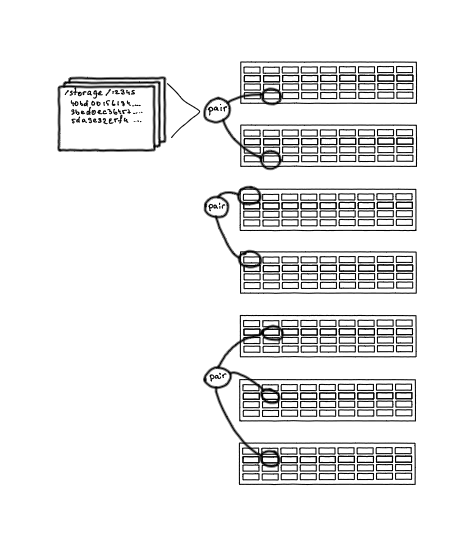
Par (pair) — enheter för objektlagring
Alla par lagras i PairDB — en applikation baserad på Tarantool. Alla databaser i vårt lagringssystem, från de allra första, är Tarantool; vi använder inga andra databaser.
PairDB lagrar alla par, deras tillstånd, ledigt utrymme, felöverskridande möjligheter och senaste fel. Det kan också själv kontrollera paren, uppdatera deras status och verifiera om de fungerar eller inte. Så PairDB är en allmän översikt över tillståndet för alla diskar i vårt system.
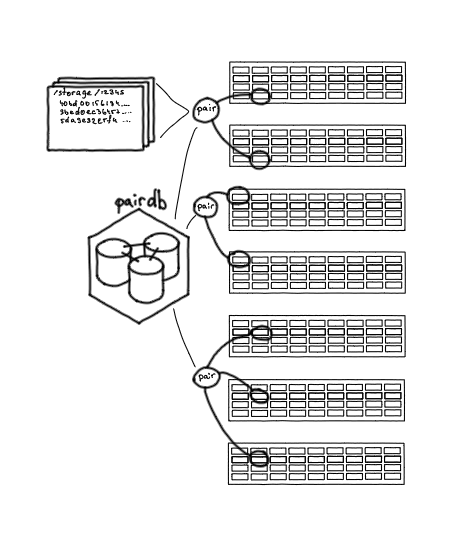
Pair DB: databas med tillståndet hos par
I systemet lagras filer, och för att veta vilken fil som finns på vilken enhet, behövs en annan databas – FileDB. Den lagrar en mappning som definierar kopplingen: filen lagras på denna enhet, samt ett litet antal nödvändiga attribut.
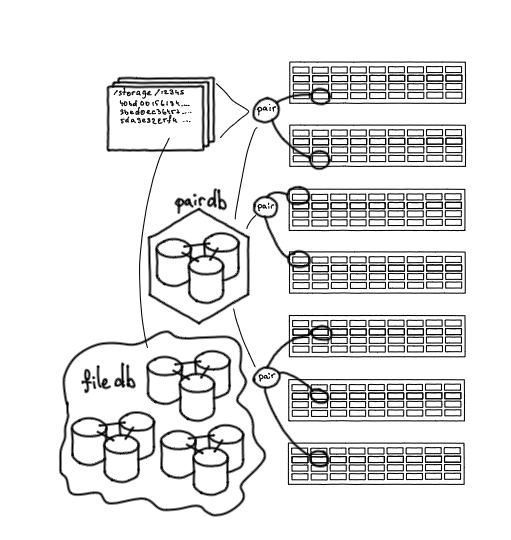 File DB: platsen där filen lagras
En annan viktig del är tjänsten Nylon, en router för att arbeta med databaser. Den fungerar som en enda ingångspunkt och gör det möjligt att arbeta via ett enhetligt gränssnitt med både PairDB och FileDB. Det är en stateless-tjänst, den utför belastningsbalansering av förfrågningar, förstår vilken shard FileDB som ska användas, och vet vilka enheter som är aktiva och vilka som inte är det.
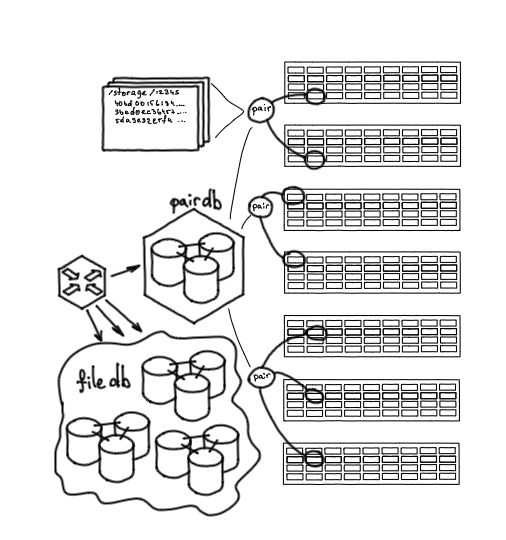
Nylon: router för arbete med databaser
Innehåll måste också på något sätt läggas till i lagringen. För detta finns en tjänst – Streamer. Den tillhandahåller två HTTP-metoder: PUT-metoden för att ladda upp innehåll till lagringen och GET-metoden för att hämta det därifrån. HTTP är ett ganska populärt och bekvämt protokoll för datatransfer.
När vi kontaktar Streamer, tar den kontakt med PairDB via Nylon, tar reda på vilken enhet filen kan laddas upp till, för att sedan överföra data via WebDAV till den enheten.
I grunden är varje lagringsserver nginx plus diskar som är monterade enligt angivna sökvägar. Vi kan ladda upp en fil till lagringen från Streamer, ta bort den, döpa om den eller kontrollera dess integritet. Det är ett bekvämt gränssnitt för låg-nivå interaktion med lagringen.
Streamer: ingångspunkt till lagringen
Vad vi har lagt till för att skapa S3-lagring
Så vi har granskat den allmänna baskonstruktionen av lagringen vid tidpunkten då vi planerade att lansera S3-lagringen. Med PUT-metoden kunde vi lägga in godtyckligt innehåll där och få en hash som identifierare för dessa data. Med denna identifierare kunde vi senare återvända och hämta den ursprungliga filen. Men detta räcker inte för att implementera S3. I S3-protokollet, förutom själva lagringen av objekt, finns:
- lagring av metadata – ytterligare egenskaper hos objekten;
- organisation av åtkomst till objekten via HTTP;
- gruppering av objekt i samlingar – buckets;
- HTTP-S3 Endpoint. S3 organiserar data i specifika strukturer – buckets, där varje bucket fungerar som en ingångspunkt för lagring av filer.
För att implementera denna logik behövdes en separat tjänst. Vi ville också omedelbart ta hänsyn till arkitekturen för vidare tillväxt av tjänsten med linjär skalbarhet.
De första komponenterna
Demon som implementerar S3 API. Detta är det standardiserade S3 API från Amazon som stöder arbete med XML för metadata och möjliggör direkt överföring av innehåll. Vi behövde inte uppfinna något, allt är beskrivits och dokumenterat.
Vi ställde också Nginx framför tjänsten. Vi använde det för SSL-termering, belastningsbalansering samt för viss logik i Lua (metrik, loggning och spårning).
För lagring av S3-metadata valde vi också Tarantool. I den första versionen hämtade S3-demon metadata från denna databas, medan innehållet lagrades i ett stort lagringsutrymme via Streamer.
Nginx + S3 API + metadata
Objektschema för lagring
Låt oss se hur S3 fungerar. Användaren kan skapa en bucket - en samling av objekt. Buckets adresseras med hjälp av värdnamnet och är en underdomän av tjänsten. Inom en bucket kan användaren skapa objekt. Objektets identifierare kommer att vara URL:en. Innehållet i objektet är en blob, en mängd binärdata som vi kommer att lagra i lagringsutrymmet. Varje objekt har också attribut: namn - samma URL, ACL (åtkomstkontrollista), och andra tilläggs- eller godtyckliga attribut - allt detta sparas i metadata.
Det normaliserade schemat för dessa data kan se ut så här: det finns projekt som äger buckets, som innehar objekt, och objekten kan vara sammansatta. Eftersom ett sätt att ladda upp objekt är i delar, finns det två hjälptabeller för uppladdning: uploads och chunks. Projekten har också autentiseringsuppgifter för åtkomst och fakturering.
Dataschema
Eftersom vi skapade en B2B-tjänst med betalabonnemang behövdes det en faktureringsmodul i detta schema.
Faktureringssystemet implementerade vi också på Tarantool.
Förbättringar av S3-lagring: steg mot produktion
Vi har redan skapat en fungerande modell som kan användas: objekt och metadata lagrades, men för att gå i produktion saknades några punkter.
För det första är det fråga om ett ratbegränsningssystem. Om vi kör tjänsten utan den, kunde vi vid hög belastning oavsiktligt överbelasta en del av systemet. Ratbegränsningen bör fungera så här: varje S3-förfrågan kommer till en specifik värd, den här värden är identifieraren för en bucket, och bucketen tillhör en viss kund. Vi behöver definiera en funktion för bucketen som skulle möjliggöra beräkning av ratbegränsningen.
Dessutom bör ratbegränsningssystemet vara tillräckligt effektivt för att hantera den belastning som kommer till S3.
Här använde vi återigen Tarantool. Ratbegränsningarna är en kluster av 21 instanser, instanserna är uppdelade i grupper, fördelade över tre fysiska noder och sammanfogade i ett stort topologiskt kluster. Konfigurationsändringar sprids automatiskt över klustret: ratbegränsningar, standardvärden och konfiguration. Varje bucket hanteras strikt av en instans. När en förfrågan kommer till en specifik bucket beräknas den ansvariga instansen för den bucketen. Inom denna nod görs en räkning av den aktuella begäran baserat på en algoritm som liknar Token Bucket. Därefter, baserat på aktuella belastningsmått och egenskaper som har ställts in för den specifika bucketen, avgör ratbegränsningssystemet om förfrågan kan utföras eller inte. Kontroll av begränsningarna görs i det tidigaste skedet av S3-förfrågan, vilket skyddar alla andra delar av systemet från överbelastning.
Det är också ganska svårt att klara sig utan cache under belastning. I S3 förutsätts upprepade förfrågningar av samma objekt, det vill säga det är ett varmt lagringsutrymme. I normala fall hanteras förfrågningar till enstaka filer av hela kedjan: Streamer, FileDB, PairDB, Storage. Men vid upprepade förfrågningar till en fil optimerar vi åtkomsten till detta innehåll med hjälp av en lokal cache.
Cachen är flerskiktad och implementerad med hjälp av nginx, lokala, SSD- och RAM-diskar. Här använde vi inte Tarantool, eftersom det är mer praktiskt att leverera objekt från filsystemet, vilket gör det möjligt att göra cache-tiering. Dessutom har vi stora objekt med en maximal storlek på 32 gigabyte, och i Tarantool kan endast små objekt cachas.
Det här var det första systemet vi lanserade, som hade en viss beräknad kapacitet, som räckte för att utforska och förstå produkten, samt att den skulle fungera.
Förbättringar av stridsystemet: failover och skalning
Systemet var redan i drift, men vi missade något i början — vi behövde lägga till failover och skalning.
Vår S3-demont hade hämtat metadata via Tarantool-protokollet. Vi ersatte den ursprungliga databasen med Tarantool, som fungerade som en proxy-router för begärningar om metadata. Ur applikationens perspektiv, som implementerade API:t, förändrades inget — den fortsatte att kommunicera med databasen via Tarantool-protokollet, men routern kunde erbjuda aktiv failover. Det betyder att vi kunde kontrollera nodens tillgänglighet, ha en paus vid omkopplingar och fel, och så vidare. Själva applikationen modifierade vi inte.
Mer information om hur vi genomförde sharding
Nästa fråga som behövde åtgärdas var sharding. Systemet växte, antalet objekt ökade och vi behövde säkerställa möjligheter för vidare tillväxt.
Låt oss återvända till datamodellen: det finns projekt, det finns buckets, krediter och fakturering. Det här är objekt som med stor sannolikhet inte kommer växa utanför en enskild instans varken i volym eller i begärningar inom överskådlig framtid. Så det finns ingen anledning att sharda dem, och vi flyttade dem till en separat instans som förblir ofördelad. Det gör det möjligt att hantera projekt och buckets mer konsekvent, eftersom det finns en enhetlig ofördelad punkt.
Det finns också objekt i schemat som växer linjärt — först var det hundratusentals, nu mäts deras antal i flera miljarder. Sådana objekt, tillsammans med deras delar, behövde flyttas till en shardad kluster.
Vi delade upp schemat, men objekten behöver arbeta med buckets: varje objekt tillhör alltid en specifik bucket, plus det finns en ACL som körs på bucketen. Därför har vi för varje shard med objekt en skugga kopia av varje bucket. Dessutom, under modifiering av objekt och utförande av begärningar, måste vi räkna volymen för fakturering, så på varje shard finns det räkneverk för fakturering.
Vi har också lagt till ytterligare några tabeller och komponenter:
- en papperskorg, för att ta bort gamla projekt som tas bort eller fryses;
- kön på bakgrundsuppgifter, det vill säga det primära lagret kan utföra bakgrundsuppgifter som måste göras i klustret;
- livscykelstöd — en mekanism som möjliggör arbete med objekt och hantering av deras livscykel.
Eftersom en del av datan har delats upp på shards behövde vi en sharding-proxy. Man skulle kunna återanvända routern för denna roll, men en separat sharding-proxy, som endast ansvarar för datasharding, gör att routern kan hämta data i sin helhet utan att tänka på sharding.
Jag kommer att berätta varför vi inte valde en färdig lösning utan ville skapa en anpassad sharding-funktion.
Låt oss se hur den är uppbyggd. Vi har 256 tillgängliga shards. För varje bucket tilldelar vi ett intervall med hjälp av en konsistent funktion. Det är enkelt — på samma sätt som du med en konsistent funktion bestämmer tillhörigheten till en shard, så bestämmer du den startande shard och tilldelar intervallet:
f(bucket, shards) = subset
Det vill säga, om vi tar en bucket kan vi säga att den och dess data alltid kommer att ligga på en specifik delmängd av alla shards. Detta minskar påverkan mellan olika buckets och förenklar hanteringen av map-reduce-frågor, när man till exempel behöver lista objekten i en bucket. För detta måste man fråga alla shards där dessa objekt lagras. Om objekten låg på alla shards skulle varje lista påverka systemet som helhet, medan den nu endast påverkar en specifik delmängd.
Vidare — varje objekt tillhör en specifik bucket, så när vi begär ett objekt så begär vi det efter namn i en specifik bucket. Det betyder att vi kan definiera en funktion för objektet inte från hela det tillgängliga intervallet av shards, utan bara från delmängden av sin bucket:
f(object, subset) = shard
Vi tar ett specifikt objekt och som argument för funktionen skickar vi inte alla shards utan delmängden av sin bucket — och får en specifik shard.
Så, sharding är genomfört, vi har en sharding-proxy. Det som återstår är att få routern och databasen med metadata att kommunicera med sharding-proxyn. Till exempel för att skapa skuggbilder av objekt — när vi skapar en bucket måste det primära lagret skapa en representant för denna bucket på alla shards där den ska finnas.
Hur vi genomförde resharding
Det största problemet med shardning är reshadering. Det var viktigt för oss att göra detta utan nedtid, eftersom systemet redan var i produktion. Jag kommer att visa hur vi löste problemet med ett exempel från en liknande uppgift med live-migrering av data från ett projekt till ett annat.
Nedan är schemat för vår klusterkonfiguration som blev resultatet av att vi implementerade shardning. Vi har nginx, S3 API, en router, en primär databas med projekt, en sharderande proxy och själva shardarna.
Jag nämnde tidigare att det under ett visst stadium av projektet fanns en produktuppgift: "Starta ännu ett lagringsutrymme, Icebox, – som Hotbox, men för kalla data". I praktiken handlar det om ett liknande lagringsutrymme, men med olika URL:er och utan cache.
Icebox användes mindre än Hotbox, så det klarade sig ganska länge utan något sharding. Till slut beslutade vi att avveckla det och kombinera Hotbox och Icebox till en tjänst genom att helt enkelt dela upp lagringsklasserna.
Basken i lagringarna överlappar inte, de kunde lätt slås samman och flyttas, men kunderna använde både det ena och det andra lagringsutrymmet, vilket återspeglar behovet av att lösa problemet med att göra detta utan nedtid. Vi kunde inte bara stänga av och kopiera. Vi gjorde migreringen i flera steg.
Först synkroniserade vi de primära lagringarna. Vi hade Tarantool och vi kunde vid skapandet av ett objekt göra så här:
- en begäran kommer till databasen för att skapa en bask, till exempel i Hotbox;
- Tarantool kontrollerar i en annan databas (i det här fallet – i Icebox) att det inte finns någon sådan bask;
- om basken finns, meddelar databasen att den inte kan skapas, och den synkroniseras som en existerande.

Synkronisering av baskar
I det lagringsutrymme som skulle ta emot all data introducerades en egenskap för projekt och baskar som indikerar var detta objekt lagras. Det kunde lagras lokalt, det vill säga i Hotbox, i Icebox – då finns det inga data i det nya lagringsutrymmet, eller det kunde vara i migrering.
Om ett projekt eller bask hade egenskapen Migrating, utfördes begäran under migreringen först i det nya lagringsutrymmet där data bör finnas, och om de inte fanns där, dirigerades begärningarna till lagringsutrymmet därefter.
Därefter växlade vi trafik. Eftersom API:et kunde hantera både Icebox- och Hotbox-begärningar, kunde vi växla trafiken utan nedtid genom att bara flytta värdar och lägga till motsvarande poster i Nginx.
Efter att trafiken omdirigerades kunde vi ta bort Nginx och API från Icebox.
Därefter tog vi bort Icebox nginx och S3 API – och allt fungerade:
Därefter startade vi en bakgrundsprocess för migrering som arbetar inuti databasen – den går igenom alla projekt och deras buckets element för element, sätter dem i statusen Migrating, flyttar data och efter att flytten är klar sätter den statusen Local.
Efter datamigreringen behöver vi inte längre det gamla lagret, och vi tar bort de kvarvarande delarna av det gamla systemet, samt tar bort stöd för migreringsstatus från koden.
De samma principerna följdes för resharding från det gamla lagret till det shardade:
- Vi markerade alla buckets som
Non-sharded. Alla förfrågningar till dem gick till det ursprungliga, icke-shardade lagret. - Nya buckets skapades direkt med statusen
Sharded. - Vi tog en bucket i taget, satte statusen
Migratingoch flyttade data.
Förfrågningar betjänades enligt principen:
- Vi läser i de nya, sedan i de gamla.
- Vi skapar endast i de nya.
- Vi uppdaterar i två faser: om det inte finns i de nya, flyttar vi från de gamla till de nya, och sedan uppdaterar vi.
Arbete med SSL-certifikat
På frontend använder vi Nginx. I vårt fall är det inte vanlig Nginx, utan OpenResty, Nginx med stöd för LuaJIT.
En annan del av systemet – hantering av SSL-certifikat. I S3-lagret kan du ställa in en egen domän för att få åtkomst till en specifik bucket, bara med hjälp av CNAME. Men utan HTTPS går det inte idag: en egen domän innebär en egen SSL-certifikat.
Som jag redan nämnt, ansvarar Nginx för lastbalansering och terminering av SSL. I vårt fall är det inte vanlig Nginx, utan OpenResty, Nginx med stöd för LuaJIT.
Detta gjorde att vi ganska enkelt kunde lära vårt Nginx att leverera godtyckliga certifikat. Dessutom behövde vi ge ut certifikat dynamiskt (utan att behöva ange dem i konfigurationsfilen). Vi använde tillägget ssl_certificate_by_lua, som gör det möjligt att läsa certifikatet från valfri källa direkt under TLS-handshake. Som certifikatslagring använde vi också Tarantool: detta gör att vi kan hantera certifikat utanför och ger en extremt snabb leverans.
Det har också implementerats en separat demon vars uppgift är att regelbundet uppdatera de certifikat som utfärdades med hjälp av Let’s Encrypt.
Vad jag skulle behålla och vad jag skulle göra annorlunda om jag skulle utveckla lagring på nytt
Vad som behövde användas från början
Sharding direkt. Ganska många problem orsakades av resharding. Det är lätt att göra, men om man startar projekt som behöver skalas, är det bättre att använda en sharded kluster från början, även om det bara har ett minimum av noder. Implementeringen av sharding i början är nästan gratis i jämförelse med att införa sharding i ett fungerande system.
Arbete med Tarantool genom lastbalanserare. Nu kopplar vi alla nya databaser direkt till arbete genom lastbalanserare. Det gör det möjligt att utöka funktionaliteten och uppnå högre redundans.
Auto-failover. Jag skulle installera alla verktyg som krävs för auto-failover, eftersom de första misslyckandena efter lanseringen var kopplade till avsaknaden av det. Efter erfarenheten med S3 lanserades alla följande produkter med hänsyn till detta.
Funktionen S3 "Versionering". Det verkade från början som en funktion som inte var särskilt efterfrågad. Att integrera den här möjligheten i arkitekturen av ett fungerande system är extremt svårt.
Separat fakturering. Det sätt på vilket vi integrerade faktureringen i vårt system fungerade bra i början, men så småningom började det störa, det skulle ha varit bättre att ha det som en helt separat tjänst.
Vad som var en bra lösning
Datamodell. Historien har visat att i takt med att tjänsten utvecklades så överensstämde vi ganska väl med datamodellen från Amazon, så vi kan implementera de funktioner som finns där.
Schema för sharding. Jag skulle stödja samma typ av intervallsharding för buckets, eftersom det gör det möjligt att fördela förfrågningar från olika buckets över ett stort kluster.
Användning av Tarantool. Tarantool har hjälpt mycket vid utvecklingen av tjänsten och dess modifiering, vi arbetade enkelt med data, transformerade och shardade lagret utan att behöva gå upp på applikationslagret.
Denna presentation hördes först på by Mail.ru Cloud Solutions&Tarantool. Se andra föreläsningar och följ anmälningarna till evenemang på Telegram .
Du kan också titta på min gamla presentation om S3 eller läsa artikeln från min kollega om blocklagring.
- .
- .
Källa: habr.com
