

SDM är över, men den okontrollerade lusten att skriva finns kvar.
Under många år har vår bror lidit av att utföra rutinuppgifter, hållit tummarna inför commit och lidit av sömnbrist på grund av nattliga rollbacks.
Men mörka tider har ett slut.
Genom den här artikeln inleder jag en serie om hur jag ser automatisering.
Vi kommer att gå igenom stegen för automatisering, lagring av variabler, formalisering av design, med RestAPI, NETCONF, YANG, YDK och vi kommer att programmera mycket.
Jag menar att a) detta inte är en objektiv sanning, b) inte den obestridliga bästa metoden, c) min syn kan till och med förändras under resans gång från den första till den sista artikeln – ärligt talat har jag skrivit om allt helt två gånger från utkast till publicering.
Innehåll
- Målsättningar
- Nätverket – som en enda organism
- Konfigurationstestning
- Versionshantering
- Övervakning och självreparation av tjänster
- Verktyg
- Inventeringssystem
- IP-administrationssystem
- Beskrivningssystem för nätverkstjänster
- Enhetens initieringsmekanism
- Vendor-oberoende konfigurationsmodell
- Vendor-specifik gränssnittdrivrutin
- Mekanism för att leverera konfiguration till enheten
- CI/CD
- Backup-mekanism och sökning efter avvikelser
- Övervakningssystem
- Slutsats
Jag kommer att försöka genomföra ADSM i ett format som skiljer sig något från SDM. Det kommer fortfarande att förekomma stora, detaljerade nummerartiklar, och mellan dem kommer jag att publicera små anteckningar från det vardagliga livet. Jag ska försöka bekämpa perfektionismen här och inte finslipa var och en av dem.
Hur lustigt att behöva gå samma väg en andra gång.
Till en början var jag tvungen att själv skriva artiklar om nätverk eftersom det inte fanns några på ryska internet.
Nu kunde jag inte hitta ett heltäckande dokument som systematiserade tillvägagångssätten för automatisering och med enkla, praktiska exempel gick igenom de ovan nämnda teknologierna.
Kanske har jag fel, så skicka länkar till bra resurser. Men detta kommer inte att ändra min beslutsamhet att skriva, eftersom det primära målet är att lära mig något själv, och att underlätta livet för andra är en trevlig bonus som främjar spridningen av kunskap.
Vi ska försöka ta ett medelstort datacenter LAN DC och arbeta fram hela automatiseringsschemat.
Att göra vissa saker kommer jag att göra nästan för första gången tillsammans med er.
I de idéer och verktyg som beskrivs här kommer jag inte att vara originell. Dmitry Figol har en utmärkt .
Artiklarna kommer i många avseenden att överlappa med dem.
I LAN DC 4 finns det 4 datacenter, cirka 250 switchar, ett halvdussin routrar och några brandväggar.
Inte Facebook, men tillräckligt för att fundera djupt över automatisering.
Det finns en uppfattning om att om du har mer än en enhet, så behöver du redan automatisering.
Det är faktiskt svårt att föreställa sig att någon nu kan leva utan minst en hög av skript som kan köras.
Även om jag har hört att det finns sådana företag där IP-adresser registreras i Excel, och varje av de tusentals nätverksenheterna konfigureras manuellt och har sin unika konfiguration. Detta kan självklart framställas som modern konst, men en ingenjörs känslor skulle säkert bli kränkta.
Målsättningar
Nu kommer vi att sätta upp maximalt abstrakta mål:
- Nätverket – som en enda organism
- Konfigurationstestning
- Versionshantering av nätverksstatus.
- Övervakning och självreparation av tjänster
Senare i denna artikel går vi igenom vilka verktyg vi kommer att använda, och i kommande artiklar både mål och medel i detalj.
Nätverket – som en enda organism
Den avgörande frasen i cykeln, även om den vid första anblick kan verka obetydlig: vi kommer att konfigurera nätverket, inte enskilda enheter..
Under de senaste åren har vi sett en förskjutning av fokus mot att betrakta nätverket som en enda enhet, härifrån kommer också Software Defined Networking, Intent Driven Networks och Autonomous Networks.
Vad behövs egentligen globalt av nätverket för applikationerna: kopplingar mellan punkterna A och B (nåväl, ibland också +C-A) och isolering från andra applikationer och användare.
Således är vår uppgift i denna serie — att bygga ett system, som stödjer den aktuella konfigurationen av hela nätverket, som redan dekomponeras till aktuell konfiguration på varje enhet i enlighet med dess roll och plats.
Systemet nätverksstyrning innebär att vi når ut för att göra ändringar, och det i sin tur beräknar det önskade tillståndet för varje enhet och konfigurerar det.
På så sätt minimerar vi nästan helt behovet av att använda CLI manuellt — eventuella ändringar i inställningarna på enheterna eller nätverksdesignen måste formaliseras och dokumenteras — och först därefter rullas ut till de nödvändiga delarna av nätverket.
Det vill säga, till exempel, om vi beslutar att från och med nu ska rack-switchar i Kazan annonsera två nätverk istället för ett, vi
- Först dokumenterar vi ändringarna i systemen
- Vi genererar den målinriktade konfigurationen för alla nätverksenheter
- Vi startar programmet för att uppdatera nätverkskonfigurationen, som beräknar vad som måste tas bort på varje nod, vad som ska läggas till, och leder noderna till önskat tillstånd.
Vid det här laget gör vi manuella ändringar endast i det första steget.
Konfigurationstestning
, att 80 % av problemen uppstår vid ändring av konfigurationen — ett indirekt bevis på detta är att under nyårshelgen är det vanligen lugnt.
Jag har personligen bevittnat dussintals globala driftstopp på grund av mänskligt misstag: fel kommando, utfört i fel gren av konfigurationen, glömt en community, raderat MPLS globalt på routern, konfigurerat fem enheter, och missat ett fel på den sjätte, kommit tillbaka till gamla ändringar som gjorts av en annan person. Det finns en hel del olika scenarier.
Automatiseringen gör att vi kan begå färre misstag, men i större skala. Så kan man förstöra inte bara en enhet, utan hela nätverket på en gång.
Sedan urminnes tider har våra förfäder kontrollerat riktigheten av de förändringar som görs med ett skarpt öga, stålsatta nerver och nätverkets funktion efter deras implementering.
De förfäder vars arbete ledde till stillestånd och katastrofala förluster lämnade efter sig färre avkommor och borde med tiden dö ut, men evolutionen är en långsam process, och därför kontrollerar inte alla fortfarande ändringar i labbet.
Men i framkant av utvecklingen finns de som automatiserat processen för att testa konfigurationen, och vidare använde den på nätverket. Med andra ord — lånat CI/CD-proceduren () från utvecklarna.
I en av delarna kommer vi att titta på hur man implementerar detta med hjälp av versionskontrollsystem, troligtvis GitHub.
Så snart du vänjer dig vid tanken på nätverks-CI/CD, kommer metoden att kontrollera konfigurationen genom att tillämpa den på det arbetsmässiga nätverket att verka som en tidig medeltida okunnighet. Ungefär som att slå med en hammare på en kärnladdning.
En organisk fortsättning på idéerna om system för nätverkshantering och CI/CD blir fullständig versionshantering av konfigurationen.
Versionshantering
Vi kommer att betrakta att vid varje förändring, även de mest obetydliga, även på en obemärkt enhet, övergår hela nätverket från ett tillstånd till ett annat.
Och vi utför alltid inte kommandot på enheten, vi ändrar nätverkets tillstånd.
Låt oss kalla dessa tillstånd versioner?
Anta att den nuvarande versionen är 1.0.0.
Har IP-adressen för Loopback-gränssnittet förändrats på en av ToR:erna? Detta är en mindre version – den får nummer 1.0.1.
Om vi har reviderat ruttimportpolicys i BGP – något mer seriöst – blir det redan 1.1.0.
Har vi beslutat att överge IGP och gå enbart på BGP – detta är redan en radikal designändring – 2.0.0.
Olika datacenter kan ha olika versioner – nätverket utvecklas, ny utrustning installeras, någonstans läggs nya spinners till, någonstans inte, etc.
Om vi kommer att diskutera det i en separat artikel.
Jag upprepar – varje förändring (utom diagnostiska kommandon) är en versionuppdatering. Administratörerna ska informeras om eventuella avvikelser från den aktuella versionen.
Samma gäller för att rulla tillbaka ändringar – detta är inte annulleringen av de senaste kommandona, det är inte rollback med hjälp av enhetens operativsystem – det är att föra hela nätverket till en ny (gammal) version.
Övervakning och självreparation av tjänster
Detta är en självklart uppgift i moderna nätverk som når en ny nivå.
Ofta praktiserar stora tjänsteleverantörer att det fallna tjänsten måste snabbt fixas och höjas upp igen, istället för att undersöka vad som hände.
"Mycket" betyder att man rikligt måste klä sig i övervakningar som inom sekunder upptäcker även minsta avvikelser från normen.
Och här räcker inte de vanliga metrikarna, som gränssnittsbelastning eller tillgänglighet av noder. Det räcker inte heller med att personalen manuellt övervakar dem.
För många saker måste det vara — övervakningar lyste rött och gick själva och lade en växtplåster där det gör ont.
Och här övervakar vi inte bara enskilda enheter, utan hela nätverkets hälsa, både som vitbox, vilket är ganska förståeligt, och som svartbox, vilket är mer komplicerat.
Vad behöver vi för att genomföra sådana ambitiösa planer?
- Ha en lista över alla enheter i nätverket, deras placering, roller, modeller, mjukvaruversioner.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Ha ett system för att beskriva nätverkstjänster.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Kunna initiera en enhet.
Värdnamn, Mgmt IP, Mgmt Rutt, Användare, RSA-nycklar, LLDP, NETCONF - Konfigurera enheten och återföra konfigurationen till den önskade (inklusive tidigare) versionen.
- Testa konfigurationen.
- Regelbundet kontrollera statusen för alla enheter för avvikelse från aktuell status och informera berörda parter.
Någon lade tyst till en regel i ACL på natten.. - Övervaka driftskompatibiliteten.
Verktyg
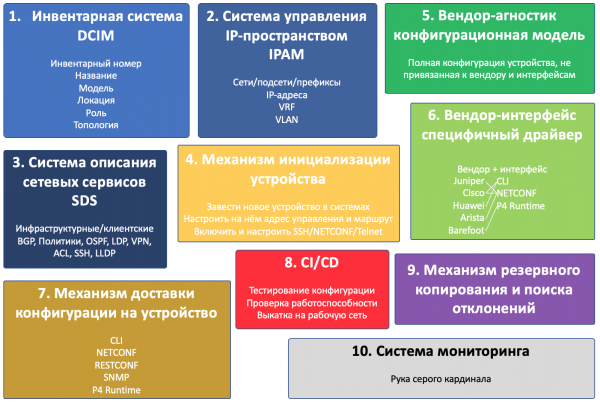
Det låter tillräckligt komplicerat för att börja decomponera projektet i komponenter.
Och det kommer att bli tio av dem:
- Inventeringssystem
- IP-administrationssystem
- Beskrivningssystem för nätverkstjänster
- Enhetens initieringsmekanism
- Vendor-oberoende konfigurationsmodell
- Vendor-specifik gränssnittdrivrutin
- Mekanism för att leverera konfiguration till enheten
- CI/CD
- Backup-mekanism och sökning efter avvikelser
- Övervakningssystem
Det här är för övrigt ett exempel på hur perspektivet på cykelmålen har förändrats — i skissens komponenter fanns det fyra.
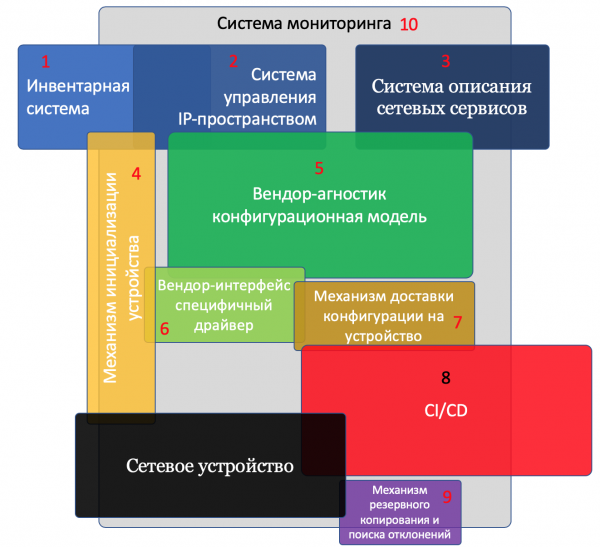
I illustrationen har jag avbildat alla komponenter och själva enheten.
Övergripande komponenter interagerar med varandra.
Ju större block, desto mer uppmärksamhet måste ägnas åt denna komponent.
Komponent 1. Inventariesystem.
Självklart vill vi veta vilken utrustning som finns, var den står, och vad den är ansluten till.
Inventariesystemet är en oumbärlig del av varje företag.
Oftast har företaget ett separat inventariesystem för nätverksenheter, som löser mer specifika uppgifter.
Inom ramen för artikelcykeln kommer vi att kalla detta DCIM — Data Center Infrastructure Management. Även om termen DCIM strikt taget innefattar mycket mer.
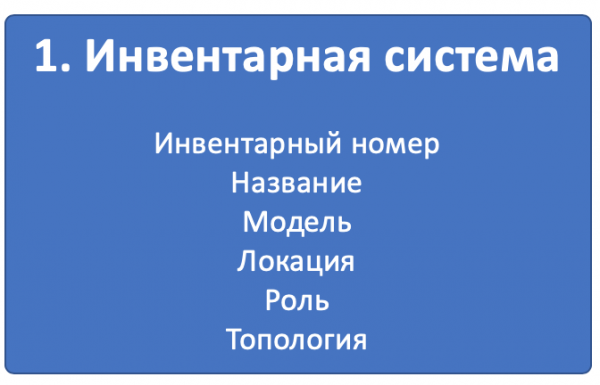
För våra ändamål kommer vi att lagra följande information om enheten i det:
- Inventarienummer
- Namn/beskrivning
- Modell (Huawei CE12800, Juniper QFX5120 osv.)
- Karakteristiska parametrar (kort, gränssnitt osv.)
- Roll (Leaf, Spine, Border Router osv.)
- Plats (region, stad, datacenter, rack, enhet)
- Interkonnektioner mellan enheter.
- Nätverkstopologi.
Det är tydligt att vi själva vill veta allt detta.
Men hjälper det för automatiseringssyften?
Självklart.
Till exempel vet vi att på Leaf-switchar i detta datacenter, om det är Huawei, bör ACL för att filtrera viss trafik tillämpas på VLAN, och om det är Juniper — på unit 0 på den fysiska gränssnittet.
Eller måste vi rulla ut en ny Syslog-server på alla gränser i regionen.
I den kommer vi också att lagra virtuella nätverksenheter, till exempel virtuella routrar eller rout-reflektorer. Vi kan lägga till DNS-servrar, NTP, Syslog och allt annat som på något sätt relaterar till nätverket.
Komponent 2. IP-utrymmeshanteringssystem.
Ja, även idag finns det grupper av människor som håller reda på prefix och IP-adresser i en Excel-fil. Men den moderna metoden är ändå en databas, med frontend i nginx/apache, API och omfattande funktioner för hantering av IP-adresser och nätverk med uppdelning i VRF.
IPAM – IP Address Management.
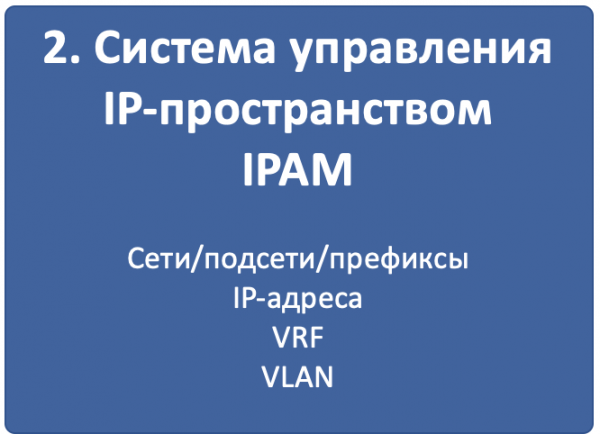
För våra uppgifter i den kommer vi att lagra följande information:
- VLAN
- VRF
- Nätverk/Subnät
- IP-adresser
- Koppling av adresser till enheter, nätverk till platser och VLAN-nummer
Även här är det tydligt att vi vill vara säkra på att när vi tilldelar en ny IP-adress för loopback på ToR:en, så snubblar vi inte över att den redan har tilldelats någon. Eller att vi har använt samma prefix två gånger i olika ändar av nätverket.
Men hur hjälper detta med automatiseringen?
Enkelt.
Vi begär ett prefix med rollen Loopbacks i systemet, där tillgängliga IP-adresser finns för tilldelning – om det finns, tilldelar vi adressen, om inte, begär vi skapandet av ett nytt prefix.
Eller vid skapandet av en enhetskonfiguration kan vi från samma system ta reda på vilket VRF gränssnittet ska ligga i.
Och vid uppstart av en ny server går skriptet in i systemet, tar reda på vilken server-switch, vilken port och vilket subnät som är tilldelat gränssnittet – och därifrån tilldelar vi serverns adress.
Det framstår som naturligt att förena DCIM och IPAM i ett system, så att funktioner inte dupliceras och vi inte behöver underhålla två liknande entiteter.
Och så kommer vi att göra.
Komponent 3. System för beskrivning av nättjänster
Om de första två systemen lagrar variabler som behöver användas på något sätt, så beskriver det tredje för varje role av enhet hur den ska konfigureras.
Det är värt att lyfta fram två olika typer av nättjänster:
- Infrastruktur
- Kunder.
De första syftar till att säkerställa grundläggande konnektivitet och hantering av enheten. Här kan vi inkludera VTY, SNMP, NTP, Syslog, AAA, routingprotokoll, CoPP, etc.
De andra organiserar en tjänst för kunden: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP, etc.
Naturligtvis finns det även gränsfall – hur ska man kategorisera MPLS LDP, BGP? Och routingprotokoll kan användas för kunder. Men det är inte avgörande.
Båda typerna av tjänster bryts ner i konfigurationsprimitiv:
- fysiska och logiska gränssnitt (tag/untag, mtu)
- IP-adresser och VRF (IP, IPv6, VRF)
- ACL och trafikbehandlingspolicyer
- Protokoll (IGP, BGP, MPLS)
- Routingpolicyer (prefixlistor, community, ASN-filter).
- Tjänsteserverar (SSH, NTP, LLDP, Syslog…)
- m.fl.
Hur exakt vi kommer att göra detta vet jag inte än. Vi ska ta itu med det i en separat artikel.
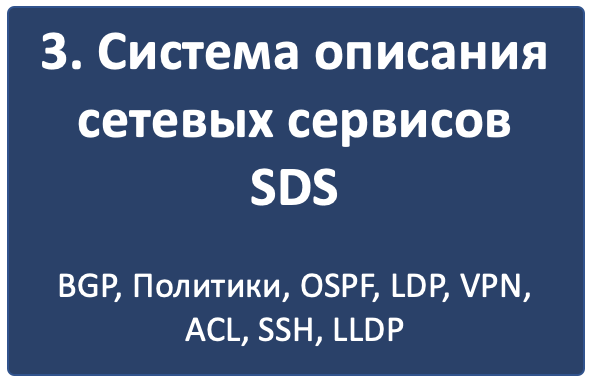
Om vi skulle se lite mer realistiskt kan vi beskriva att
Leaf-switchar måste ha BGP-sessioner med alla anslutna Spine-switchar, importera de anslutna nätverken i processen och ta emot nätverk från Spine-switchar endast med en viss prefix. Begränsa CoPP IPv6 ND till 10 pps m.m.
Spine-switcharna håller å sin sida sessioner med alla anslutna leaf-switchar, fungerar som root-reflektorer och tar emot endast rutter av viss längd och med viss community.
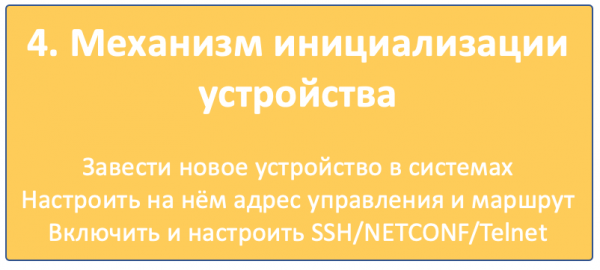
Komponent 4. Enhetens initieringsmekanism
Under denna rubrik sammanfattar jag en mängd åtgärder som måste ske för att enheten ska dyka upp på radarn och kunna nås på distans.
- Få enheten in i inventariesystemet.
- Tilldela en IP-adress för hantering.
- Konfigurera grundläggande åtkomst till den:
Värdnamn, IP-adress för hantering, rutt till hanteringsnätverket, användare, SSH-nycklar, protokoll — telnet/SSH/NETCONF
Det finns tre angreppssätt:
- Helt manuellt. Enheten levereras till en plattform där en vanlig organisk människa registrerar den i systemen, ansluter med en konsol och konfigurerar den. Kan fungera på små, statiska nätverk.
- ZTP — Zero Touch Provisioning. Utrustningen har anlänt, ställt sig på plats, fått en adress via DHCP, besökt en specifik server och självkonfigurerat.
- Infrastruktur av konsolservrar där den första konfigurationen sker via konsolporten i automatisk läge.
Vi kommer att diskutera alla tre i en separat artikel.
Komponent 5. Leverantörsagnostisk konfigurationsmodell
Hittills har alla system varit separata lappar som ger variabel och deklarativ beskrivning av vad vi skulle vilja se på nätverket. Men förr eller senare kommer vi att behöva hantera konkretisering.
I det här skedet kombineras primitiva, tjänster och variabler för varje specifik enhet i en konfigurationsmodell, som faktiskt beskriver den fullständiga konfigurationen av den specifika enheten, men på ett leverantörsoberoende sätt.
Vad ger detta steg? Varför skulle man inte direkt skapa en enhetskonfiguration som kan laddas upp?
I själva verket låter det oss lösa tre uppgifter:
- Anpassa dig inte till ett specifikt gränssnitt för interaktion med enheten. Oavsett om det är CLI, NETCONF, RESTCONF, SNMP – modellen kommer att vara densamma.
- Behåll inte antalet mallar/skript efter antalet leverantörer i nätverket, och vid förändringar i designen, ändra samma sak på flera ställen.
- Ladda konfigurationen från enheten (backup), strukturera den i exakt samma modell och jämför direkt den målkonfigurationen med den befintliga för att beräkna skillnaden och förbereda en konfigurationspatch som endast ändrar de delar som behövs eller för att identifiera avvikelser.
Som ett resultat av detta steg får vi en leverantörsoberoende konfiguration.
Komponent 6. Leverantörsspecifik gränssnittdrivrutin
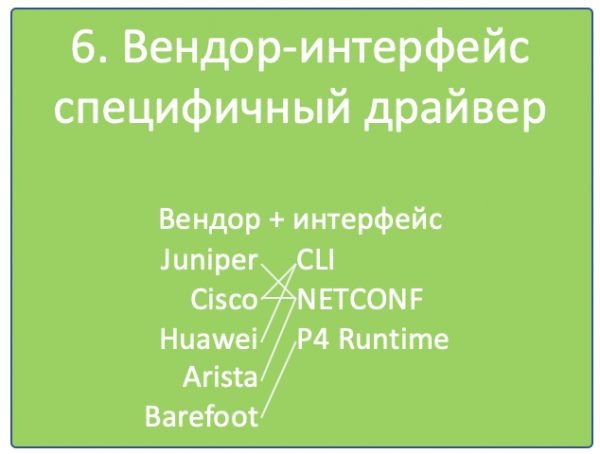
Tro inte att man en dag kan konfigurera Cisco på samma sätt som Juniper, bara genom att skicka helt identiska anrop till dem. Trots att whiteboxar blir mer populära och stödet för NETCONF, RESTCONF, OpenConfig dyker upp, skiljer sig det specifika innehållet som dessa protokoll levererar från leverantör till leverantör, och det är en av deras konkurrensfördelar som de inte kommer att ge upp så enkelt.
Det är ungefär som OpenContrail och OpenStack, som har RestAPI som sitt NorthBound-gränssnitt, förväntar sig helt olika anrop.
Så på femte steget måste den leverantörsoberoende modellen ta den form som den kommer att skickas till hårdvaran.
Och här är alla medel tillåtna (eller inte): CLI, NETCONF, RESTCONF, SNMP är godtagbara.
Därför behöver vi en drivrutin som omvandlar resultatet från föregående steg till det format som krävs av den specifika leverantören: ett set CLI-kommandon, en XML-struktur.
Komponent 7. Mekanism för distribution av konfigurationen till enheten
Vi har genererat konfigurationen, men den måste fortfarande levereras till enheterna – och uppenbarligen inte för hand.
För det första, här uppstår frågan om vilket transportmedel vi ska använda? Och valet idag är inte litet:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (även om det faller utanför listan eftersom det är ett sätt att leverera FIB, och inte inställningar)
Låt oss klargöra detta. CLI är legacy. SNMP… ehm.
RESTCONF – är fortfarande en okänd best, REST API stöds nästan av ingen. Därför kommer vi att fokusera på NETCONF i cykeln.
Som läsaren redan har förstått, har vi vid det här laget definierat användargränssnittet — resultatet från föregående steg presenteras redan i formen av det valda gränssnittet.
För det andra, och vilka verktyg kommer vi att använda för detta?
Här finns det också många alternativ:
- Ett skräddarsytt skript eller en plattform. Vi kan utrusta oss med ncclient och asyncIO och göra allt själva. Vad stoppar oss från att bygga ett distributionssystem från grunden?
- Ansible med sitt omfattande bibliotek av nätverksmoduler.
- Salt med sin begränsade nätverksfunktionalitet och kopplingen till Napalm.
- Egentligen Napalm, som känner till några leverantörer och det är allt, adjö.
- Nornir — ytterligare ett djur som vi kommer att dissekera i framtiden.
Här har vi ännu inte valt någon favorit — vi kommer att utforska.
Vad är också viktigt här? Konsekvenserna av konfigurationsanvändning.
Om det var framgångsrikt eller inte. Om vi fortfarande har tillgång till enheten eller inte.
Det verkar som att commit med bekräftelse och validering av vad som laddades ner till enheten kan hjälpa här.
Detta, tillsammans med en korrekt implementering av NETCONF, minskar avsevärt antalet lämpliga enheter — normala commits stöds inte av många tillverkare. Men detta är bara ett av de obligatoriska villkoren i . Ingen verkar bry sig om att ingen rysk leverantör kommer att klara kravet på 32*100GE gränssnitt. Eller gör de?
Komponent 8. CI/CD
Vid det här laget har vi redan en konfiguration klar för alla nätverksenheter.
Jag säger "alla", eftersom vi pratar om versionhantering av nätverkets tillstånd. Och även om det behövs göra ändringar i inställningarna för bara en switch, beräknas ändringarna för hela nätverket. Det är uppenbart att de kan vara noll för de flesta noder.
Men som nämnts ovan, vi är inte några barbarer som rullar ut allt på en gång i produktion.
Den genererade konfigurationen måste först passera genom CI/CD-pipelinen.
CI/CD står för Continuous Integration, Continuous Deployment. Detta är en metod där teamet inte släpper en ny stor version varje halvår och helt ersätter den gamla, utan regelbundet implementerar (Deployment) ny funktionalitet i små portioner, var och en av dem testas noggrant för kompatibilitet, säkerhet och funktionalitet (Integration).
För detta har vi ett versionskontrollsystem som övervakar förändringar i konfigurationen, ett laboratorium som kontrollerar att kundtjänsten inte kraschar, ett övervakningssystem som verifierar detta faktum, och det sista steget är att rulla ut ändringarna i produktionsnätverket.
Förutom felsökningskommandon måste alla ändringar i nätverket gå igenom CI/CD-pipelinen – det är vår garanti för ett bekymmersfritt liv och en lång och lycklig karriär.
Komponent 9. Backup- och avvikelsehanteringssystem
Vi behöver nog inte prata mer om backups.
Vi kommer bara att lagra dem per cron eller vid faktiska förändringar i konfigurationen i git.
Men den andra delen är mer intressant – någon måste hålla ett öga på dessa backups. I vissa fall måste den personen gå tillbaka och återställa allt som det var, och i andra fall, informera någon om att det är något som är fel.
Till exempel, om en ny användare dyker upp som inte är registrerad i variablerna, måste vi ta bort denne från hacken. Och om det är en ny brandväggsregel – bättre att inte röra, kanske någon bara har aktiverat felsökning, eller så har en ny tjänst, slarvigt, registrerats utanför reglerna, men folk har redan börjat använda den.
Vi kommer ändå inte att undvika en viss liten delta i skalan av hela nätverket, oavsett vilka automatiseringssystem och den fasta hand som ledningen har. Ingen kommer ändå att göra ändringar i konfigurationen för att felsöka problem. Dessutom kanske den inte ens förutses i konfigurationsmodellen.
Till exempel, en brandväggsregel för att räkna antalet paket till en viss IP, för att lokalisera problemet – är en helt vanlig temporär konfiguration.
Komponent 10. Övervakningssystem
I början hade jag inte tänkt ta upp övervakning – det är trots allt ett omfattande, kontroversiellt och komplext ämne. Men under tiden har det visat sig vara en oersättlig del av automatiseringen. Och att undvika det, även utan praktiska erfarenheter, är inte möjligt.
Vid en vidareutveckling av tanken – det är en organisk del av CI/CD-processen. Efter att konfigurationen har rullats ut i nätverket, måste vi kunna avgöra om allt är i ordning nu.
Och det handlar inte bara om användningsgrafer för gränssnitt eller nodernas tillgänglighet, utan om mer subtila saker – tillgång till nödvändiga rutter, attribut på dem, antal BGP-sessioner, OSPF-grannar, End-to-End-funktionaliteten hos överliggande tjänster.
Har loggarna slutat att skickas till den externa servern, har SFlow-agenten slutat fungera, har dropparna i köerna ökat, eller har kopplingen mellan något par prefix blivit bruten?
I en separat artikel kommer vi att reflektera över detta också.
Slutsats
Som grund har jag valt en av de moderna designerna för datacenter-nätverk – L3 Clos Fabric med BGP som routingprotokoll.
Denna gång kommer vi att bygga nätverket på Juniper, för nu är JunOs-gränssnittet en skönhet.
Vi kommer att komplicera vårt liv genom att använda endast Open Source-verktyg och en multivendor-nätverk – därför kommer jag, förutom Juniper, att välja ytterligare en lycklig kandidat.
Planen för kommande publiceringar ser ut ungefär så här:
Först kommer jag att prata om virtuella nätverk. Först och främst för att jag vill, och för det andra för att utan detta kommer designen av infrastruktur-nätverket inte att vara särskilt tydlig.
Sedan handlar det om nätverksdesign: topologi, routing, policies.
Vi ska sätta ihop en laboratorieuppställning.
Vi kommer att reflektera och kanske öva på att initiera en enhet i nätverket.
Och sedan kommer vi att dyka ner i varje komponent i intima detaljer.
Och ja, jag lovar inte att elegant avsluta denna cykel med en färdig lösning. 🙂
Nyttiga länkar
- Innan vi går djupare in i serien kan det vara bra att läsa boken av Natasha Samoylenko . Och kanske också gå igenom .
- Det kan vara användbart att läsa om designen av datacenterfabriker från Facebook, skriven av Petr Lapukhov.
- Dokumentationen om arkitekturen för Overlay SDN kommer att ge en förståelse för hur det fungerar (tidigare Open Contrail).
Tack
Roman Gorge. För kommentarer och korrigeringar.
Artyom Chernobai. För KDPV.
Källa: habr.com
