

I Jag har beskrivit en ram för nätverksautomation. Många har kommenterat att den här första ansatsen till problemet redan har klargjort vissa frågor. Och det glädjer mig mycket, för vårt mål i cykeln är inte att bara täcka Ansible med Python-skript, utan att bygga ett system.
Den här ramen sätter ordning på hur vi ska hantera frågan.
Och nätverksvirtualisering, som detta avsnitt handlar om, passar inte riktigt in i temat ADMS där vi behandlar automation.
Men låt oss titta på det ur ett annat perspektiv.
Många tjänster använder redan länge ett och samma nätverk. För en teleoperatör handlar det om 2G, 3G, LTE, bredbandsinternet och B2B, exempelvis. I fallet med datacenter: uppkoppling för olika kunder, internet, blocklagring, objektlagring.
Och alla tjänster kräver isolering från varandra. Så overlay-nätverk kom till.
Och alla tjänster vill inte vänta på att en människa ska ställa in dem manuellt. Så orkestratorer och SDN kom till.
Den första ansatsen till systematisk nätverksautomation, eller snarare en del av den, har länge gjorts och implementerats på många ställen: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Det är det vi ska granska idag.
Innehåll
- Orsaker
- Terminologi
- Underlay — fysisk nätverk
- Overlay — virtuell nätverk
- Overlay från ToR
- Overlay från värd
- Exempel med Tungsten Fabric
- Kommunikation inom en fysisk maskin
- Kommunikation mellan VM:s belägna på olika fysiska maskiner
- Utgång till den yttre världen
- FAQ
- Slutsats
- Nyttiga länkar
Orsaker
Och eftersom vi talar om detta, bör vi nämna förutsättningarna för nätverksvirtualisering. Egentligen började denna process inte igår.
Du har kanske hört flera gånger att nätverket alltid har varit den mest tröga delen av vilket system som helst. Och det är sant i alla avseenden. Nätverket är basen som allt vilar på, och att göra förändringar på det är ganska svårt — tjänster tål inte att nätverket är nere. Ofta kan avvecklingen av en nod påverka en stor del av applikationerna och påverka många kunder. Delvis därför kan nätverksteamet motstå alla förändringar — för just nu fungerar det på något sätt (vi kanske inte ens vet hur), och nu måste något nytt ställas in, och det är oklart hur det kommer att påverka nätverket.
För att slippa vänta på att nätverksadministratörer ska ställa in VLAN och för att slippa specificera tjänster på varje nod i nätverket, kom människor på att använda overlays — överlagrade nätverk — av vilka det finns ett stort antal: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE etc.
Deras attraktion ligger i två enkla saker:
- Endast slutnoderna konfigureras — transitnoderna behöver man inte röra. Detta påskyndar processen avsevärt och ibland möjliggör det att helt utesluta avdelningen för nätverksinfrastruktur från processen att införa nya tjänster.
- Belastningen döljs djupt inne i rubrikerna — transitnoderna behöver inte veta något om den, om adressering på värdarna, rutterna i det överlagrade nätverket. Det betyder att man behöver lagra mindre information i tabellerna, vilket gör att man kan välja enklare/billigare enheter.
I detta något ofullständiga avsnitt planerar jag inte att gå igenom alla möjliga teknologier, utan snarare beskriva ramverket för hur överlagrade nätverk fungerar i datacenter.
Hela serien kommer att beskriva ett datacenter som består av rader av enhetliga skåp, där likadan serverutrustning är installerad.
På denna utrustning körs virtuella maskiner/kontainrar/serverlösningar som implementerar tjänster.
Terminologi
I cykeln servern kommer jag att kalla programmet som implementerar serverdelen av klient-serverkommunikationen.
De fysiska maskinerna i skåpen kallar vi servrar inte kommer vi att.
Den fysiska maskinen är en x86-dator som är installerad i ett skåp. Den mest använda termen värdkommer vi att kalla den "maskin" eller värd.
Hypervisor — en applikation som körs på den fysiska maskinen och emulerar de fysiska resurserna där virtuella maskiner körs. I litteraturen och på nätet används ibland ordet "hypervisor" som en synonym till "värd".
Virtuell maskin — ett operativsystem som körs på den fysiska maskinen ovanför hypervisorn. För oss i ramen för denna cykel är det inte så viktigt om det verkligen är en virtuell maskin eller bara en container. Vi kommer att kalla detta "VM«
Tenants är ett brett begrepp som jag i denna artikel definierar som en separat tjänst eller en separat kund.
Multitenans eller multihyra — användning av samma applikation av olika kunder/tjänster. I detta fall uppnås isoleringen mellan kunderna genom applikationens arkitektur, inte genom separat körda instanser.
ToR — Top of the Rack-switch — en rackmonterad switch som alla fysiska maskiner är anslutna till.
Förutom ToR-topologin praktiserar olika leverantörer End of Row (EoR) eller Middle of Row (även om det senare är en sällsynthet och jag har inte stött på akronymen MoR).
Underlay-nätverk eller underliggande nätverk — den fysiska nätverksinfrastrukturen: switches, routrar, kablar.
Overlay-nätverk eller översiktsnätverk — ett virtuellt nätverk av tunnlar som fungerar ovanpå den fysiska infrastrukturen.
L3-fabrik eller IP-fabrik — en fantastisk uppfinning som gör att man slipper repetera STP under intervjuer och inte behöver lära sig TRILL. En koncept där hela nätverket ända upp till accessnivån är uteslutande L3, utan VLAN och därmed enorma, uttdragna broadcast-domäner. Vi kommer att utforska ursprunget till termen 'fabrik' i nästa del.
SDN — Software Defined Network. Knappast behöver någon presentation. En metod för nätverksförvaltning där förändringar i nätverket görs av programvara snarare än mänsklig hand. Betyder vanligtvis att kontrollplanet placeras utanför de slutliga nätverksenheterna på en controller.
NFV — Network Function Virtualization — virtualisering av nätverksenheter, vilket innebär att vissa nätverksfunktioner kan köras i form av virtuella maskiner eller containrar för att påskynda implementeringen av nya tjänster, organisera Service Chaining och förenkla horisontell skalbarhet.
VNF — Virtual Network Function. En specifik virtuell enhet: router, switch, brandvägg, NAT, IPS/IDS m.m.
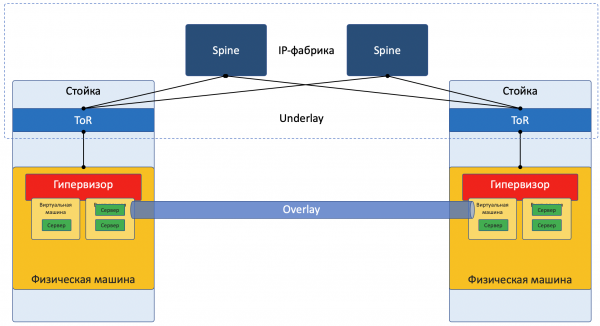
Jag förenklar medvetet beskrivningen till en specifik implementation för att inte förvirra läsaren för mycket. För en mer djupgående läsning hänvisar jag till sektionen . Dessutom lovar Roma Gorge, som kritiserar denna artikel för felaktigheter, att skriva en separat utgåva om virtualiseringsteknologier för servrar och nätverk med större fokus på detaljer.
Majoriteten av dagens nätverk kan tydligt delas in i två delar:
Underlay — det fysiska nätverket med en stabil konfiguration.
Overlay — en abstraktion ovanför Underlay för att isolera tenants.
Detta gäller både för datacenter (som vi kommer att granska i denna artikel) och för ISP (som vi inte kommer att granska, eftersom det redan har behandlats i ). Med företagsnätverk är situationen givetvis något annorlunda.
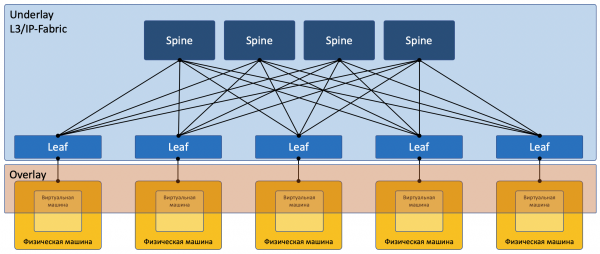
Bild med fokus på nätverket:
Underlay
Underlay är ett fysiskt nätverk: hårdvaruswitchar och kablar. Enheter i underlayet vet hur de ska nå de fysiska maskinerna.
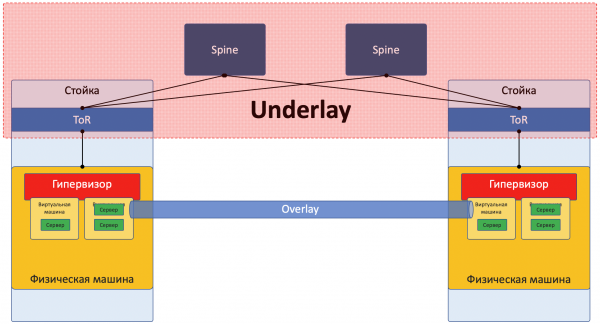
Det bygger på standardprotokoll och teknologier. Inte minst eftersom hårdvaruenheterna fortfarande kör på proprietär programvara, som inte tillåter programmering av chip eller implementering av egna protokoll, vilket kräver kompatibilitet med andra leverantörer och standardisering.
Men någon som Google kan tillåta sig att utveckla egna switchar och avstå från allmänt accepterade protokoll. Men LAN_DC är inte Google.
Underlay ändras relativt sällan, eftersom dess uppgift är att ge grundläggande IP-koppling mellan fysiska maskiner. Underlayet vet ingenting om de tjänster, kunder eller hyresgäster som körs ovanpå det; det behöver bara leverera paket från en maskin till en annan.
En Underlay kan se ut så här:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Underlay-nätverket konfigureras på traditionellt sätt: CLI/GUI/NETCONF.
Manuellt, med skript, proprietära verktyg.
Mer om underlayen kommer att behandlas i nästa artikel i serien.
Overlay
Overlay är ett virtuellt nätverk av tunnlar som sträcker sig över Underlay, och den gör det möjligt för VM:ar från en kund att kommunicera med varandra samtidigt som den erbjuder isolering från andra kunder.
Kundens data inkapslas i vissa tunneleringshuvuden för att skickas genom det gemensamma nätverket.
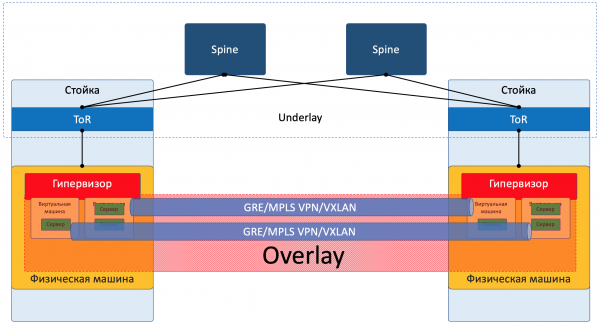
Så VM:ar från en kund (av en tjänst) kan kommunicera med varandra via Overlay, utan att veta vilken väg paketen faktiskt tar.
En Overlay kan se ut så här, som jag nämnde tidigare:
- GRE-tunnel
- VXLAN
- EVPN
- L3VPN
- GENEVE
Overlay-nätverket konfigureras och underhålls vanligtvis via en central kontroller. Konfigurationen, Control Plane och Data Plane levereras till enheten som ansvarar för routning och inkapsling av kundtrafik. Låt oss titta närmare på detta med exempel.
Ja, det är SDN i sin renaste form.
Det finns två principiellt olika angreppssätt för att organisera ett Overlay-nätverk:
- Overlay från ToR
- Overlay från värd
Overlay från ToR
Overlay kan börja vid en accessswitch (ToR) som står i ett rack, som det görs exempelvis i en VXLAN-fabrik.
Detta är en tidtestad mekanism i ISP-nät och alla leverantörer av nätverksutrustning stödjer det.
Men i det här fallet måste ToR-switchar kunna separera olika tjänster, och nätverksadministratören måste i viss utsträckning samarbeta med administratörerna för virtuella maskiner och göra ändringar (även automatiskt) i enhetens konfiguration.
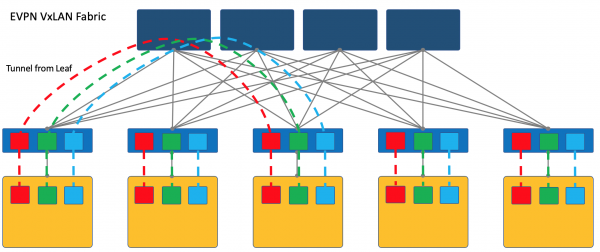
Här hänvisar jag läsaren till artikeln om vår gamla vän .
I denna där metoderna för att bygga ett datacenter-nät med en EVPN VXLAN-fabrik beskrivs i detalj.
För en mer djupgående förståelse kan man läsa Cisco-boken .
Jag vill påpeka att VXLAN är endast en inkapsuleringsmetod och termineringen av tunnlar kan ske inte på ToR utan på värden, som i fallet med OpenStack, till exempel.
Men en VXLAN-fabrik där overlay börjar på ToR är en av de etablerade designen för overlay-nätverk.
Overlay från värd
En annan metod är att börja och terminera tunnlar på slutliga värdar.
I så fall förblir nätverket (Underlay) så enkelt och statiskt som möjligt.
Och värden gör själv alla nödvändiga inkapslingar.
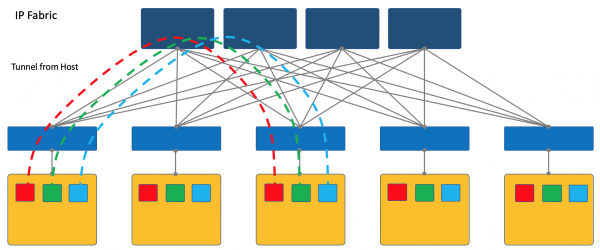
För detta krävs det självklart att ett speciellt program körs på värdarna, men det är värt det.
För det första är det enklare att köra klienten på en Linux-maskin eller, ska vi säga, - överhuvudtaget möjligt - medan man förmodligen måste använda proprietära SDN-lösningar på switchen, vilket motverkar idén om flera leverantörer.
För det andra kan ToR-switchar i det här fallet förbli så enkla som möjligt, både när det gäller Control Plane och Data Plane. Faktum är att de då inte behöver kommunicera med SDN-kontrolleraren och inte heller behöver lagra hela nätverk/ARP:er från alla anslutna klienter - det räcker att veta IP-adressen för den fysiska maskinen, vilket kraftigt förenklar routingtabellerna.
I ADSMs serie väljer jag metoden av overlay från värden - här kommer vi endast att prata om den och vi kommer inte att återkomma till VXLAN-fabriken.
Det är enklast att överväga med exempel. Och som försökskanin tar vi den OpenSource SDN-plattformen OpenContrail, nu känd som .
I slutet av artikeln kommer jag att ge några tankar om analogin med OpenFlow och OpenvSwitch.
Exempel med Tungsten Fabric
På varje fysisk maskin finns det vRouter — en virtuell router som vet om de nätverk som är anslutna till den och vilka kunder de tillhör — i själva verket en PE-router. För varje kund upprätthåller den en isolerad routingtabell (läs VRF). Och själva vRouter hanterar overlay-tunnlar.
Lite mer information om vRouter — i slutet av artikeln.
Varje VM som är placerad på hypervisorn ansluter till vRouter på den maskinen genom .
TAP — Terminal Access Point — ett virtuellt gränssnitt i Linux-kärnan som möjliggör nätverksinteraktion.
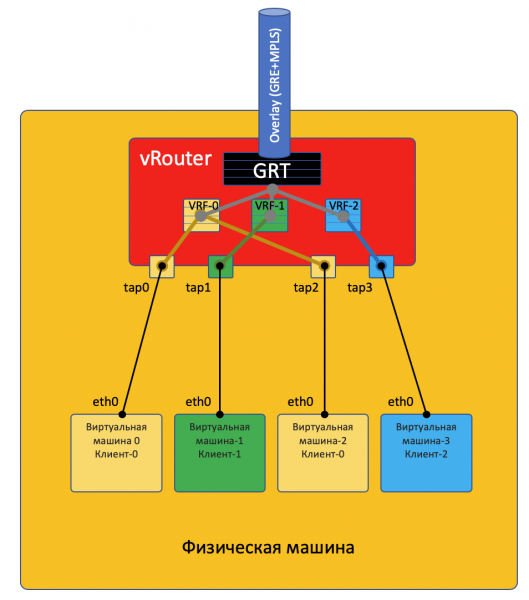
Om det finns flera nätverk bakom vRouter, skapas ett virtuellt gränssnitt för varje nätverk, som tilldelas en IP-adress — det kommer att vara standardgateway-adressen.
Alla nätverk för en kund placeras i en VRF (en tabell), olika — i olika.
Jag kommer att påpeka här att inte allt är så enkelt, och jag skickar den nyfikna läsaren till slutet av artikeln..
För att vRouter ska kunna kommunicera med varandra, och därmed VM:erna som finns bakom dem, utbyter de routinginformation via SDN-kontrollern.
För att ta sig ut i den verkliga världen finns det en utgångspunkt från matrisen — en gateway för det virtuella nätverket. VNGW — Virtual Network GateWay (termen är min).
Nu låt oss titta på exempel på kommunikationer — och då blir det tydligt.
Kommunikation inom en fysisk maskin
VM0 vill skicka ett paket till VM2. Anta tills vidare att detta är VM för en och samma kund.
Data Plane
- VM-0 har en standardrutt till sitt gränssnitt eth0. Paketet skickas dit.
Detta gränssnitt eth0 är faktiskt virtuell kopplat till den virtuella routern vRouter via TAP-gränssnittet tap0. - vRouter analyserar på vilket gränssnitt paketet kom, alltså till vilken kund (VRF) det hör, och jämför mottagarens adress med routingtabellen för den kunden.
- När den upptäcker att mottagaren är på samma maskin via en annan port, skickar vRouter helt enkelt paketet dit utan några ytterligare rubriker – för detta fall har vRouter redan en ARP-post.
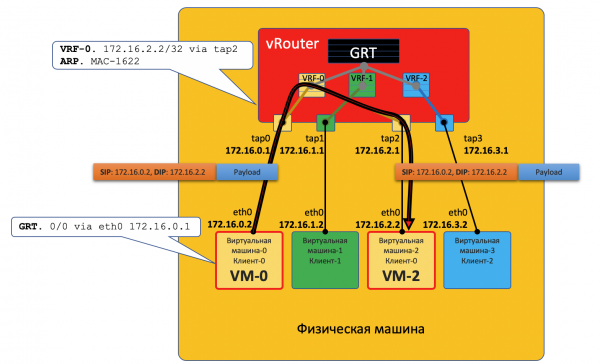
Paketet hamnar i detta fall inte i det fysiska nätverket — det har routats inom vRouter.
Control Plane
Hypervisorn meddelar den virtuella maskinen vid start:
- Den egna IP-adressen.
- Standardrouten — via IP-adressen för vRouter i detta nätverk.
vRouter får via en speciell API hypervisorn att meddela:
- Att ett virtuellt gränssnitt måste skapas.
- Vilken Virtual Network som den (VM) behöver skapa.
- Vilken VRF den (VN) ska kopplas till.
- ARP-posten för denna VM anger vilken interface dess IP-adress är kopplad till och vilken MAC-adress den är kopplad till.
Återigen har den faktiska interaktionsproceduren förenklats för att underlätta förståelsen av konceptet.
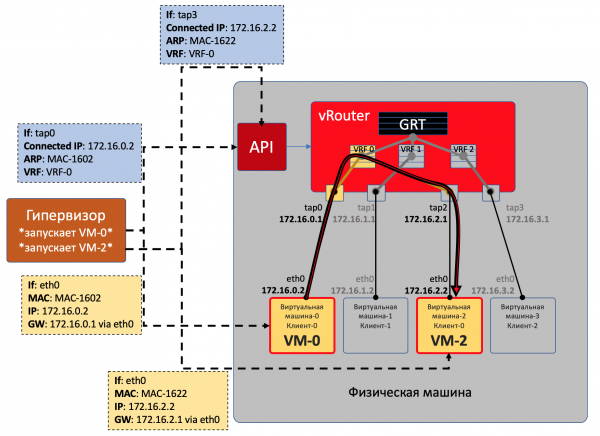
Så alla VMs från en klient på denna maskin ser vRouter som direkt anslutna nätverk och kan routa mellan dem själva.
Men VM0 och VM1 tillhör olika kunder och finns därför i olika vRouter-tabeller.
Om de kan kommunicera direkt beror på inställningarna för vRouter och nätverksdesignen.
Till exempel, om båda kundernas VMs använder offentliga adresser, eller NAT sker på själva vRouter, kan direkt routing göras på vRouter.
I motsatt fall kan adresseringsutrymmen korsa varandra – man måste gå genom en NAT-server för att få en offentlig adress – det liknar att gå ut till externa nätverk, som beskrivs nedan.
Kommunikation mellan VM:s belägna på olika fysiska maskiner
Data Plane
- Det börjar exakt likadant: VM-0 skickar ett paket till adressaten VM-7 (172.17.3.2) via sin standard.
- vRouter tar emot det och ser denna gång att adressaten är på en annan maskin och är tillgänglig via Tunnel Tunnel0.
- Först lägger den till ett MPLS-märke som identifierar den avlägsna interfacet, så att vRouter kan avgöra vart detta paket ska plats utan ytterligare åtgärder.
- För Tunnel0 är källan 10.0.0.2, mottagaren: 10.0.1.2.
vRouter lägger till GRE (eller UDP) rubriker och en ny IP till det ursprungliga paketet. - I vRouter routing-tabellen finns det en standardrutt via adress ToR1 10.0.0.1. Dit skickar det.

- ToR1 som en del av Underlay-nätverket vet (till exempel via OSPF) hur man når 10.0.1.2, och skickar paketet via rutten. Observera att ECMP inkluderas här. På illustrationen finns det två next-hop, och olika flöden kommer att distribueras i dem baserat på hash. I en verklig fabrik skulle det snarare vara 4 next-hop.
Vid detta tillfälle behöver det inte veta vad som finns under den externa IP-rubriken. Således kan ett paket under IP praktiskt taget vara ett lager av IPv6 över MPLS över Ethernet över MPLS över GRE över över över GRE.
- Därför tar vRouter på mottagarsidan bort GRE och förstår genom MPLS-märket vilken interface detta paket ska överföras till, tar isär det och skickar det i sitt ursprungliga skick till mottagaren.
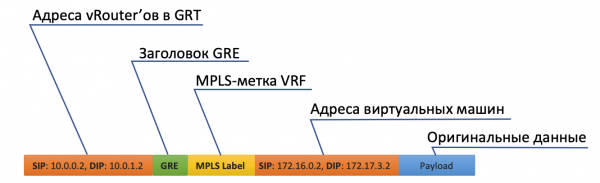
Control Plane
När en maskin startar sker allt som beskrivits tidigare.
Och dessutom det följande:
- För varje kund tilldelar vRouter en MPLS-tagg. Detta är en tjänstetagg för L3VPN som kunderna kommer att separeras efter inom en och samma fysiska maskin.
I själva verket tilldelas MPLS-taggen alltid av vRouter, eftersom det inte är känt i förväg att maskinen bara kommer att interagera med andra maskiner bakom samma vRouter, och det är troligtvis inte ens så.
- vRouter upprättar en anslutning till SDN-kontrollern via BGP-protokollet (eller något liknande — i fallet TF är det XMPP 0_o).
- Genom denna session informerar vRouter SDN-kontrollern om vägarna till de anslutna näten:
- Nätverksadress
- Inkapseringsmetod (MPLSoGRE, MPLSoUDP, VXLAN)
- Kundens MPLS-tagg
- Sin egen IP-adress som next hop
- SDN-kontrollern får sådana vägar från alla anslutna vRouter och speglar dem till andra. Det fungerar alltså som en Route Reflector.
Samma sak sker i motsatt riktning.
Overlay kan ändras vilken minut som helst. Så här går det till i offentliga moln, när kunder regelbundet startar och stoppar sina virtuella maskiner.
Den centrala kontrollern tar hand om all komplexitet kring att upprätthålla konfigurationen och kontrollen av switching/routing-tabeller på vRouter.
För att tala krasst, så kopplas controllern samman med alla vRouter via BGP (eller ett liknande protokoll) och helt enkelt vidarebefordrar routinginformation. BGP har till exempel redan en Address-Family för att överföra inkapslingsmetoden eller .
Samtidigt ändras under inget omständighet konfigurationen av Underlay-nätverket, vilket för övrigt är mycket svårare att automatisera, men enklare att bryta med en klumpig handling.
Utgång till den yttre världen
Någonstans måste simuleringen ta slut, och man måste gå från den virtuella världen till den verkliga. Och då behövs en gateway-taxa.
Två tillvägagångssätt används:
- En hårdvarurouter installeras.
- En typ av appliance startas som utför routerfunktioner (ja, efter SDN möter vi även VNF). Låt oss kalla det en virtuell gateway.
Fördelen med det andra tillvägagångssättet är den billiga horisontella skalbarheten — om man inte har tillräckligt med kapacitet — startade man ytterligare en virtuell maskin med en gateway. På vilken fysisk maskin som helst, utan behov av att leta efter lediga rack, enheter, strömuttag, köpa själva hårdvaran, transportera den, installera den, koppla upp den, konfigurera den, och sedan även byta ut trasiga komponenter.
Nackdelarna med en virtuell gateway är att en fysisk router är avsevärt mer kraftfull än en flertrådig virtuell maskin, och dess mjukvara, som är anpassad till sin hårdvarubas, fungerar betydligt stabilare (nej). Det är också svårt att förneka att det programvaru-hårdvarukomplexet bara fungerar, vilket kräver endast konfiguration, medan start och underhåll av en virtuell gateway är en uppgift för skickliga ingenjörer.
Med en fot ser gatewayen in i det virtuella Overlay-nätverket, som en vanlig virtuell maskin, och kan interagera med alla andra VM. Samtidigt kan den terminera nätverk för alla kunder och därmed utföra routing mellan dem.
Med den andra foten blickar gatewayen mot det anslutna nätverket och vet hur den ska nå internet.
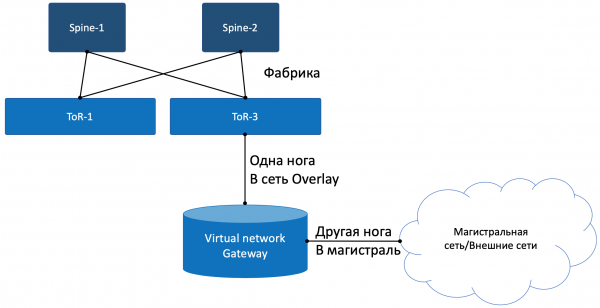
Data Plane
Processen ser alltså ut så här:
- VM-0, som har standarden i samma vRouter, skickar ett paket med adressaten i den externa världen (185.147.83.177) till gränssnittet eth0.
- vRouter tar emot detta paket och gör en look-up på destinationsadressen i routingtabeln — den hittar standardrutt genom gateway VNGW1 via Tunnel 1.
Den ser också att detta är en GRE-tunnel med SIP 10.0.0.2 och DIP 10.0.255.2, och att den först måste tilldela MPLS-märket för denna kund, vilket VNGW1 förväntar sig. - vRouter packar det ursprungliga paketet med MPLS, GRE och ny IP-header och skickar det till adressen ToR1 10.0.0.1 som standard.
- Underliggande nätverk levererar paketet till gateway VNGW1.
- Gateway VNGW1 tar bort tunnelinghuvuden GRE och MPLS, ser destinationsadressen, konsulterar sin routingtabel och inser att den är riktad mot internet — vilket innebär genom Full View eller Default. Vid behov utför den NAT-översättning.
- Från VNGW kan det finnas ett vanligt IP-nät, vilket är osannolikt.
Det kan finnas ett klassiskt MPLS-nät (IGP+LDP/Rsvp TE), det kan också vara en återkoppling från BGP LU eller en GRE-tunnel från VNGW till gränsen genom IP-nätverket.
Hur som helst utför VNGW1 nödvändiga inkapslingar och skickar det ursprungliga paketet mot gränsen.
Trafiken i den motsatta riktningen går igenom samma steg i omvänd ordning.
- Gränsens router levererar paketet till VNGW1.
- Den tar bort inkapslingen, ser på mottagaradressen och ser att den är tillgänglig via tunneln Tunnel1 (MPLSoGRE eller MPLSoUDP).
- Därför fäster den en MPLS-märkning, GRE/UDP-header och ny IP och skickar den till sin ToR3 10.0.255.1.
Måldestinationen för tunneln är IP-adressen till vRouter’n som har den mål-VM:n — 10.0.0.2. - Underliggande nätverket levererar paketet till den nödvändiga vRouter’n.
- Mål-vRouter’n tar bort GRE/UDP, identifierar gränssnittet efter MPLS-märket och skickar det rå IP-paketet till sitt TAP-gränssnitt som är kopplat till eth0-VM:n.
Control Plane
VNGW1 etablerar BGP-nätsgrannskap med SDN-kontrollern, från vilken den får all ruttinformation om kunder: vilken IP-adress (vRouter) en kund befinner sig bakom och vilket MPLS-märke den identifieras med.
På liknande sätt rapporterar den själv till SDN-kontrollern den standardrutt med märkning för den kunden och anger sig själv som nexthop. Sedan når denna standard till vRouter’na.
På VNGW brukar aggregationen av rutter eller NAT-översättning ske.
Och åt andra hållet, i sessionen med gränssnitt eller Route Reflectorer, skickar den just denna aggregerade rutt. Från dem får den antingen en standardrutt eller Full-View, eller något annat.
När det gäller inkapsling och trafiköverföring skiljer sig VNGW inte från vRouter.
Om man vidgar området något, kan man lägga till andra nätverksenheter till VNGW och vRouter’na, såsom brandväggar, trafikrensnings- eller berikningsfjädrar, IPS, och så vidare.
Och genom sekventiellt skapande av VRF och korrekt annonsering av rutter kan man få trafiken att loopa precis som man vill, vilket kallas Service Chaining.
Det vill säga, här agerar SDN-kontrollern som Route-Reflector mellan VNGW, vRouter’na och andra nätverksenheter.
Men i praktiken ger kontrollern också information om ACL och PBR (Policy Based Routing), vilket gör att specifika trafikflöden följer andra vägar än vad rutten föreskriver.
FAQ
Varför kommenterar du alltid GRE/UDP?
Egentligen är detta specifikt för Tungsten Fabric — man kan helt ignorera det.
Men om man tar hänsyn till det, så stödde TF, när den fortfarande var OpenContrail, båda inkapslingarna: MPLS in GRE och MPLS in UDP.
UDP är bra eftersom det i Source Port i dess header mycket enkelt kan koda en hash-funktion från ursprungliga IP+Proto+Port, vilket möjliggör lastbalansering.
Tyvärr, i fallet med GRE finns det bara externa IP- och GRE-headerar som är desamma för hela den inkapslade trafiken, och det talas inte om lastbalansering — få kan se så djupt in i paketet.
Tidigare var routrar, om de kunde hantera dynamiska tunnlar, bara begränsade till MPLSoGRE, och har nyligen lärt sig MPLSoUDP. Därför måste vi alltid nämna möjligheten till två olika inkapslingar.
För rättvisans skull bör det nämnas att TF faktiskt också stödjer L2-koppling med hjälp av VXLAN.
Du lovade att dra paralleller med OpenFlow.
Verkligen, det är lätt att se. vSwitch i samma OpenStack gör mycket liknande saker, med VXLAN, som förresten också har UDP-huvud.
I Data Plane fungerar de ungefär likadant, medan Control Plane skiljer sig åt. Tungsten Fabric använder XMPP för att skicka ruttinformation till vRouter, medan OpenStack arbetar med Openflow.
Kan vi få veta lite mer om vRouter?
Det delas upp i två delar: vRouter Agent och vRouter Forwarder.
Den första körs i User Space av värdoperativsystemet och kommunicerar med SDN-kontrollern genom att utbyta information om rutter, VRF och ACL.
Den andra implementerar Data Plane — vanligtvis i Kernel Space, men kan också köras på SmartNIC:er — nätverkskort med CPU och en separat programmerbar switch-chips, vilket gör att CPU-belastningen på värdmaskinen minskar och nätverket blir snabbare och mer förutsägbart.
Det finns också ett scenario där vRouter är en DPDK-applikation i User Space.
vRouter Agent skickar inställningarna till vRouter Forwarder.
Vad är ett Virtual Network?
Jag nämnde i början av artikeln om VRF, att varje tenant kopplas till sin egen VRF. Och om detta var tillräckligt för en grundläggande förståelse av hur overlay-nätverket fungerar, så behövs det förtydliganden vid nästa iteration.
Vanligtvis i virtualiseringsmekanismer introduceras enhetens Virtual Network (det kan betraktas som ett egennamn) separat från kunder/tenanter/virtuella maskiner — en helt självständig enhet. Detta Virtual Network kan sedan kopplas via gränssnitt till en tenant, en annan, två eller till och med flera, precis som en Service Chaining genom att trafiken behöver passera genom specifika noder i rätt följd, genom att skapa och koppla Virtual Networks i rätt ordning.
Därför finns det ingen direkt motsvarighet mellan Virtual Network och en tenant.
Slutsats
Detta är en ganska ytlig beskrivning av hur ett virtuellt nätverk fungerar med overlay från en värd och SDN-kontroller. Men oavsett vilken virtualiseringsplattform du väljer idag, kommer den att fungera på ett liknande sätt, oavsett om det är VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric eller Juniper Contrail. De kommer att skilja sig åt i typerna av inkapslingar och rubriker, protokoll för att leverera information till slutliga nätverksenheter, men principen för ett programvarukonfigurerat overlay-nätverk som arbetar ovanpå ett relativt enkelt och statiskt underliggande nätverk förblir densamma.
Man kan säga att områdena för att skapa privata moln idag har SDN baserat på overlay-nätverk vunnit. Men detta innebär inte att OpenFlow inte har en plats i den moderna världen - det används i OpenStack och i samma VMWare NSX, och såvitt jag vet används det av Google för att konfigurera det underliggande nätverket.
Lite längre ner har jag lagt länkar till mer detaljerat material, om du vill fördjupa dig i ämnet.
Och vad händer med vårt Underlay?
I stort sett ingenting. Det har inte förändrats hela tiden. Allt det behöver göra i fallet med overlay från en värd är att uppdatera rutter och ARP:er i takt med att vRouter/VNGW dyker upp och försvinner och transportera paket mellan dem.
Låt oss formulera en lista över krav på Underlay-nätverket.
- Bör kunna hantera något routingprotokoll, i vår situation - BGP.
- Ha hög bandbredd, helst utan överbelastning, så att paket inte går förlorade på grund av överbelastning.
- Stödja ECMP - en oundgänglig del av fabriken.
- Kunna säkerställa QoS, inklusive invecklade funktioner som ECN.
- Stödja NETCONF - en förberedelse för framtiden.
Jag har ägnat mycket lite tid åt hur Underlay-nätverket fungerar här. Det beror på att jag senare i serien faktiskt kommer att fokusera på det, medan Overlay kommer att beröras endast i förbigående.
Uppenbarligen begränsar jag oss alla genom att använda ett datacenter-nätverk byggt på Clos-fabriken med ren IP-routing och overlay från värden som exempel.
Men jag är säker på att vilket nätverk som helst med en design kan beskrivas i formella termer och automatiseras. Bara att jag här strävar efter att förstå metoder för automatisering, snarare än att förvirra alla genom att lösa problemet i allmänna termer.
Inom ramen för ADSM planerar jag och Roman Gorge att publicera ett separat avsnitt om virtualisering av datorkraft och dess samverkan med nätverksvirtualisering. Håll er uppkopplade.
Nyttiga länkar
- .
- . 6 timmar om Yandex.Cloud, där den virtuella nätverkstekniken på TF också berörs.
- .
- . Här beskrivs hela datacentret, inklusive Underlay, Overlay, tillvägagångssätt för multi-homing och hantering.
Tack
- — den tidigare programledaren för podcasten linkmeup, och nu expert inom molnplattformar. Tack för kommentarer och redigeringar. Vi ser fram emot hans djupgående artikel om virtualisering inom en snar framtid.
- — min kollega och expert inom utveckling av virtuella nätverk. Tack för kommentarer och redigeringar.
- — min kollega och expert inom Tungsten Fabric. Tack för kommentarer och redigeringar.
- — illustratör för linkmeup. Tack för produktionsstödet.
- Alexander Limonov. Tack för memes "automato".
Källa: habr.com
