

I de två första artiklarna tog jag upp frågan om automatisering och skissade dess ramverk, i den andra gjorde jag en avstickare till nätverksvirtualisering som ett första tillvägagångssätt för att automatisera inställningen av tjänster.
Nu är det dags att rita upp schemat för det fysiska nätverket.
Om du inte är väl insatt i datacenter-nätverksutrustning rekommenderar jag starkt att börja med .
Alla avsnitt:
De metoder som beskrivs i denna serie bör kunna tillämpas på nätverk av alla typer, storlekar och med ett brett utbud av leverantörer. Men det går inte att beskriva ett universellt exempel på hur dessa metoder kan tillämpas. Därför kommer jag att fokusera på den moderna nätverksarkitekturen för datacenter: .
För DCI använder vi MPLS L3VPN.
Ovanpå det fysiska nätverket arbetar ett overlay-nätverk från värden (det kan vara VXLAN från OpenStack eller Tungsten Fabric eller vad som helst annat som kräver att nätverket bara har grundläggande IP-koppling).
I det här fallet kommer vi att få ett relativt enkelt scenarium för automatisering, eftersom vi har mycket utrustning som konfigureras på samma sätt.
Vi väljer en sfärisk datacenter i vakuum:
- En designversion överallt.
- Två leverantörer som bildar två nätverksplan.
- Ett datacenter liknar ett annat som två droppar vatten.
Innehåll
- Fysisk topologi
- Routning
- IP-plan
- Lab
- Slutsats
- Nyttiga länkar
Låt vår Service Provider LAN_DC till exempel vara värd för utbildningsvideor om överlevnad i fastnat hissar.
I storstäder är detta otroligt populärt, så det behövs många fysiska maskiner.
Först kommer jag att beskriva nätverket ungefär som jag skulle vilja se det. Sedan kommer jag att förenkla det för labben.
Fysisk topologi
Platser
LAN_DC kommer att ha 6 datacenter:
- Ryssland (RU):
- Moskva (msk)
- Kazan (kzn)
- Spanien (SP):
- Barcelona (bcn)
- Malaga (mlg)
- Kina (CN):
- Shanghai (sha)
- Xi'an (sia)

Intra-DC
I alla datacenter finns identiska interna nätverk baserade på Clos-topologin.
Vad är Clos-nätverk och varför är det just de — i en separat .
I varje datacenter finns 10 rack med maskiner, de kommer att numreras som A, B, C Och så vidare.
I varje rack finns 30 maskiner. De kommer vi inte att intressera oss för.
Det finns också en switch i varje rack som alla maskiner är anslutna till — detta är Top of the Rack switch — ToR eller i Clos-fabriks termer kallar vi det Leaf.

Allmän schema för fabriken.
Vi kommer att kalla dem XXX-leafY, där XXX — tre-bokstavlig förkortning av DC, och Y — ordningsnummer. Till exempel, kzn-leaf11.
I artiklarna kommer jag att tillåta mig att ganska fritt använda termerna Leaf och ToR som synonymer. Men det är viktigt att komma ihåg att det inte är riktigt så.
ToR är en switch som är installerad i en rack, till vilken maskiner kopplas.
Leaf är en roll för enhet i det fysiska nätverket eller en första nivå switch i termer av Clos-topologi.
Det vill säga Leaf != ToR.
Så en Leaf kan vara en EndofRaw-switch, till exempel.
Men i den här artikeln kommer vi ändå att referera till dem som synonymer.
Varje ToR-switch är i sin tur kopplad till fyra övergripande aggregerande switchar — Spine. En rack har avsatts för Spine. Vi kommer att namnge dem på samma sätt: XXX-spineY.
I samma rack kommer det att stå nätverksutrustning för anslutning mellan DC — 2 routrar med MPLS an Bord. Men i stort sett är det samma ToR:er. Det innebär att ur Spine-switcharnas perspektiv spelar det ingen roll om det är en vanlig ToR med anslutna maskiner eller en router för DCI — det är fortfarande samma sak att vidarebefordra.
Dessa speciella ToR:er kallas Edge-leaf. Vi kommer att namnge dem XXX-edgeY.
Detta kommer att se ut så här.
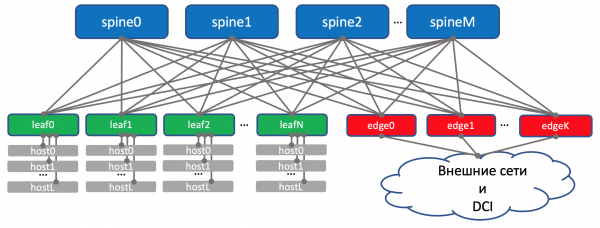
I diagrammet ovan har jag faktiskt placerat edge och leaf på samma nivå. har lärt oss att se uplink (därifrån kommer termen), som länkar uppåt. Men här går "uplink" DCI tillbaka nedåt, vilket bryter mot den förväntade logiken något. I stora nätverk, när datacenter delas in i ännu mindre enheter — POD‘er (Point Of Delivery), avsätter man separata Edge-POD‘er för DCI och utgång mot externa nätverk.
För att underlätta förståelsen framöver kommer jag ändå att rita Edge ovanför Spine, samtidigt som vi kommer att hålla i åtanke att det inte finns något intellekt i Spine och inga skillnader i arbetet med vanliga Leaf och Edge-leaf (även om det kan finnas nyanser, men i stort sett är det så).
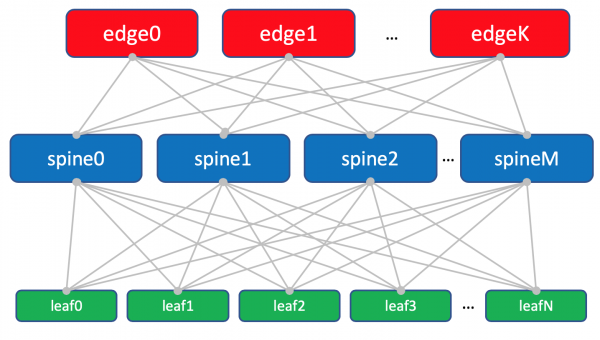
Diagrammet för fabriken med Edge-leaf.
Trion Leaf, Spine och Edge bildar Underlay-nätverket eller fabriken.
Uppgiften för nätverksfabriken (läs Underlay), som vi redan har fastställt i , är mycket enkel — att säkerställa IP-kontinuitet mellan maskiner både inom en och samma DC, och mellan dem.
Därför kallas nätverket en fabrik, på samma sätt som till exempel en växelfabrik inuti modulära nätverkslådor, om vilket man kan läsa mer i .
Överlag kallas en sådan topologi för en fabrik, eftersom fabric på svenska betyder tyg. Och det är svårt att inte hålla med:
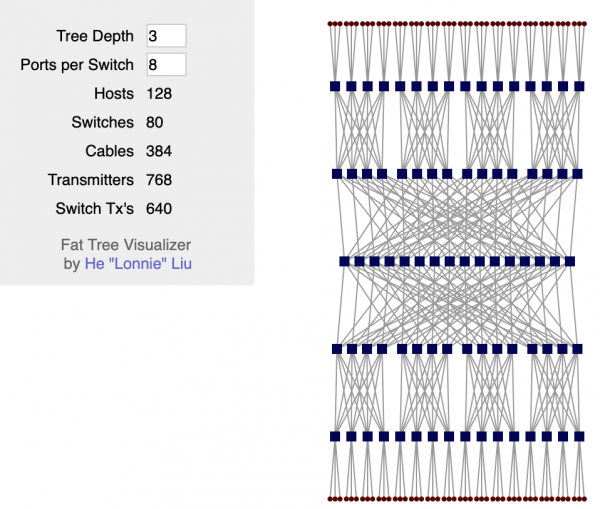
Fabriken är helt L3. Inga VLAN, inga Broadcast — så här bra programmerare har vi i LAN_DC, de kan skriva applikationer som lever i L3-paradigmet, och virtuella maskiner kräver ingen Live Migration med bibehållet IP-nummer.
Och en gång till: svaret på frågan varför fabrik och varför L3 finns i en separat .
DCI — Data Center Interconnect (Inter-DC)
DCI kommer att organiseras med Edge-Leaf, det vill säga de är vår punkt för utgång till ryggraden.
För enkelhets skull antar vi att DC:erna är kopplade till varandra med direkta länkar.
Vi utesluter extern koppling från övervägandet.
Jag är medveten om att varje gång jag tar bort någon komponent så förenklar jag nätverket avsevärt. Och vid automatisering av vårt abstrakta nätverk kommer allt att fungera bra, medan på det verkliga kommer det att uppstå knutar.
Det är sant. Ändå är målet med denna serie att tänka och arbeta med tillvägagångssätten, inte att hjältedådigt lösa påhittade problem.
På Edge-Leaf:arna placeras underlaget i VPN och överförs via MPLS-ryggraden (den direkta länken).
Så här ser en övergripande schem ut.

Routning
För routing inuti DC:n kommer vi att använda BGP.
På MPLS-ryggraden OSPF+LDP.
För DCI, det vill säga organisering av kopplingar i underlaget — BGP L3VPN över MPLS.
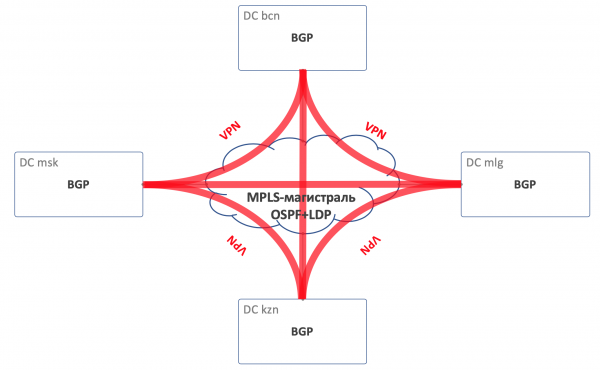
Övergripande routing-schema
I fabriken finns det inga OSPF och ISIS (en routingprotokoll som är förbjudet i Ryska federationen).
Det betyder att det inte kommer att finnas någon Auto-discovery och beräkning av kortaste vägar — endast manuell (egentligen automatisk — vi pratar ju om automatisering här) konfiguration av protokollet, grannar och policyer.
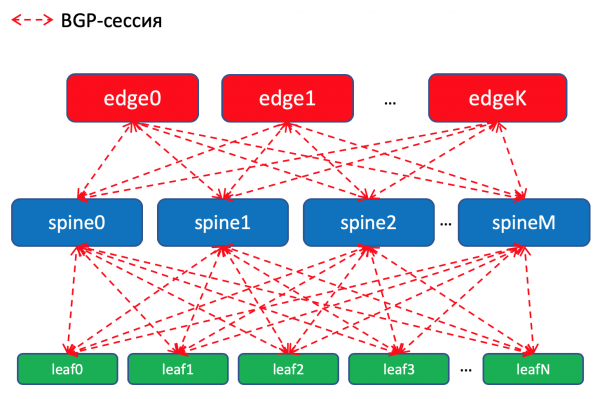
BGP-routing-schema inuti DC:n
Varför BGP?
Det finns en hel del litteratur om detta ämne från Facebook och Arista, som förklarar hur man bygger mycket stora data center-nätverk med hjälp av BGP. Den läses nästan som en skönlitterär bok, jag rekommenderar den verkligen för en lugn kväll.
Det finns också en hel sektion i min artikel som handlar om detta. Dit hänvisar jag er .
Men om man kortfattat säger, så passar inga IGP för stora datacenter-nätverk där antalet nätverksenheter räknas i tusental.
Dessutom kommer att använda BGP överallt att förhindra spridning bland stödet för flera olika protokoll och synkronisering mellan dem.
Om vi lägger handen på hjärtat, på vår fabrik, som troligen inte kommer att växa snabbt, skulle det räcka med OSPF. Det är faktiskt problem för megaskalärer och molngiganter. Men låt oss fantisera bara i några utgåvor om att vi behöver detta, och använda BGP, som Pjotr Lapuchov en gång föreslog.
Routingpolicy
På Leaf-switchar importerar vi BGP-prefix från underliggande interface med nätverken.
Vi kommer att ha en BGP-session mellan varje par av Leaf-Spine, där dessa underliggande prefix kommer att annonseras genom nätverket kors och tvärs.
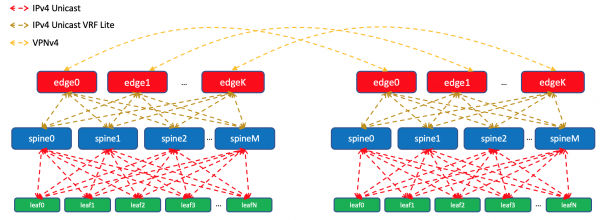
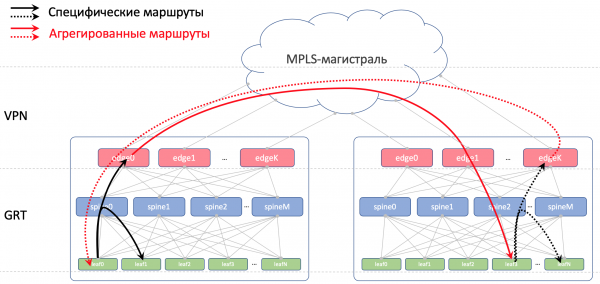
Inom en datacenter kommer vi att sprida specifikationerna som vi har importerat till ToR:erna. På Edge-Leaf:arna kommer vi att aggregera dem och annonsera till avlägsna datacenter och skicka ner till ToR:erna. Det vill säga varje ToR kommer att veta exakt hur man når en annan ToR i samma datacenter och var ingångspunkten är för att nå ToR:en i ett annat datacenter.
I DCI kommer rutter att överföras som VPNv4. För detta kommer Edge-Leaf-interfacet mot fabriken att placeras i en VRF, låt oss kalla det UNDERLAY, och grannskapet med Spine på Edge-Leaf kommer att upprättas inom VRF, medan Edge-Leaf:arna kommer att använda VPNv4-family.
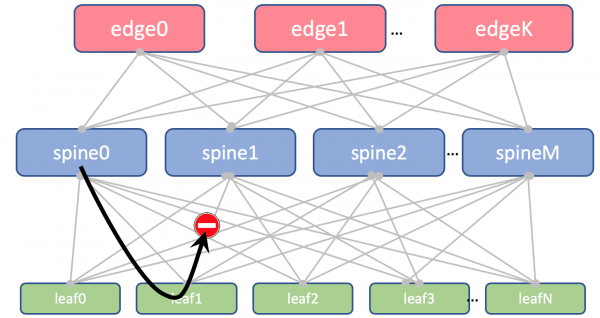
Dessutom kommer vi att förbjuda att återannonsera rutter som mottagits från spine tillbaka till dem.
På Leaf och Spine kommer vi inte att importera Loopbacks. De kommer endast att behövas för att bestämma Router ID.
Men på Edge-Leaf:arna kommer vi att importera dem i Global BGP. Mellan Loopback-adresserna kommer Edge-Leaf:arna att upprätta en BGP-session i IPv4 VPN-family med varandra.
Mellan EDGE-enheterna kommer vi att ha en sträckt ryggrad med OSPF+LDP. Allt i en zon. En extremt enkel konfiguration.
Så här ser bilden ut med routing.
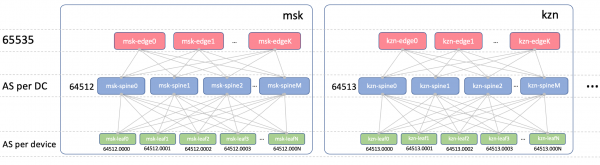
BGP ASN
Edge-Leaf ASN
På Edge-Leaf:arna kommer det att finnas en ASN i alla datacenter. Detta är viktigt för att det ska finnas iBGP mellan Edge-Leaf:arna, så att vi inte stöter på nyanser i eBGP. Låt oss säga att detta är 65535. I verkligheten skulle det kunna vara numret på en offentlig AS.
Spine ASN
På Spine kommer vi att ha en ASN per datacenter. Vi börjar här med det allra första numret i intervallet för privata AS — 64512, 64513 och så vidare.
Varför ASN per datacenter?
Vi bryter ner denna fråga i två:
- Varför samma ASN på alla spines i ett datacenter?
- Varför olika i olika datacenter?
Varför samma ASN på alla spines i ett datacenter
Så här kommer AS-Path för det underliggande routet att se ut på Edge-Leaf:
[leafX_ASN, spine_ASN, edge_ASN]
Vid försök att återannonsera det tillbaka till Spine kommer det att avvisas eftersom dess AS (Spine_AS) redan finns i listan.
Men inom datacentret är vi helt okej med att Underlay-rutter som har nått Edge inte kan gå ner igen. All kommunikation mellan värdarna i datacentret måste ske på spinnutvecklingsnivå.
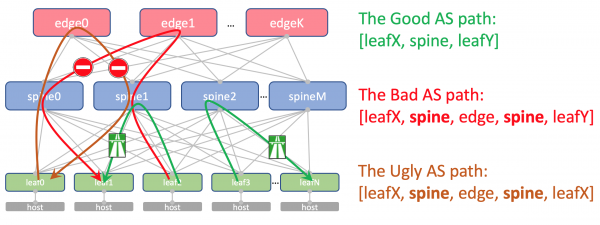
Samtidigt kommer aggregerade rutter från andra datacenter oavsett att nå Tor utan hinder - deras AS-väg kommer endast att innehålla ASN 65535 - numret för Edge-Leafs, eftersom det är på dem de skapades.
Varför olika i olika datacenter
Teoretiskt kan vi behöva dra Loopback-adresser för några tjänstemaskiner mellan datacentren.
Till exempel kan en Route Reflector starta på värden, eller (Virtual Network Gateway), som via BGP kopplar till Tor och annonserar sin loopback, vilken bör vara tillgänglig från alla datacenter.
Så här kommer dess AS-väg att se ut:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Och här får det inte finnas några upprepande ASN.
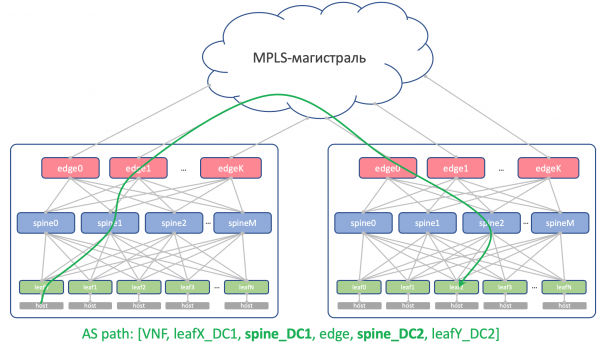
Det vill säga, Spine_DC1 och Spine_DC2 måste vara olika, precis som leafX_DC1 och leafY_DC2, vilket vi är på väg mot.
Som ni kanske vet finns det hacks som tillåter mottagande av rutter med upprepande ASN trots mekanismerna för att förhindra loopar (allowas-in på Cisco). Och detta har till och med legitima tillämpningar. Men det är ett potentiellt hål i nätverkets stabilitet. Jag har personligen ramlat ner i det ett par gånger.
Och om vi har möjlighet att inte använda farliga saker, kommer vi att utnyttja den.
Leaf ASN
Vi kommer att ha en individuell ASN på varje Leaf-switch inom hela nätverket.
Vi gör så här av skäl som nämnts ovan: AS-väg utan loopar, BGP-konfiguration utan bakdörrar.
För att rutterna mellan Leafarna ska passera utan hinder måste AS-vägen se ut så här:
[leafX_ASN, spine_ASN, leafY_ASN]
där leafX_ASN och leafY_ASN bör vara olika.
Detta behövs också för situationen med annonsering av loopback för VNF mellan datacentren:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Vi kommer att använda 4-byte ASN och generera det baserat på Spine ASN och numret på Leaf-switchen, nämligen så här: Spine_ASN.0000X.
Så här ser bilden ut för ASN.
IP-plan
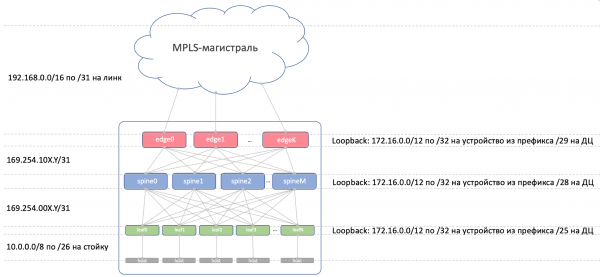
Grunläggande behöver vi tilldela adresser för följande kopplingar:
- Underlay-nätverksadresser mellan Tor och maskinen. De måste vara unika inom hela nätverket så att varje maskin kan nå vilken annan som helst. Passar utmärkt 10/8. En /26 per rack med marginal. Vi kommer att tilldela /19 för datacentret och /17 för regionen.
- Länkadresser mellan Leaf/Tor och Spine.
De skulle gärna tilldelas algoritmiskt, det vill säga beräknas utifrån namnen på enheterna som behöver kopplas till.
Låt oss säga att det blir… 169.254.0.0/16.
Det vill säga 169.254.00X.Y/31, där X — Spine-nummer, Y — P2P-nät /31.
Detta möjliggör att köra upp till 128 ramar och upp till 10 Spine i datacentret. Länknamn kan (och kommer) att upprepas från datacenter till datacenter. - Vi organiserar sammankopplingen Spine — Edge-Leaf på delnät 169.254.10X.Y/31, där det precis likadant X — Spine-nummer, Y — P2P-nät /31.
- Länknamn från Edge-Leaf till MPLS-huvudledning. Här är situationen något annorlunda — platsen där alla bitar kopplas ihop till en enhet, så man kan inte återanvända samma adresser — man måste välja nästa lediga delnät. Därför utgår vi från 192.168.0.0/16 och tar bort de fria.
- Loopback-adresser. Vi avsätter hela intervallet för dem 172.16.0.0/12.
- Leaf — per /25 i datacentret — samma 128 ramar. Vi avsätter per /23 för regionen.
- Spine — per /28 i datacentret — upp till 16 Spine. Vi avsätter per /26 för regionen.
- Edge-Leaf — per /29 i datacentret — upp till 8 enheter. Vi avsätter per /27 för regionen.
Om vi inte får tillräckligt med tilldelade intervall i datacentret (vilket vi inte kommer att få — vi strävar ju efter hyperskalighet), helt enkelt avsätt nästa block.
Så här ser IP-adresseringen ut.
Loopbackar:
Prefix
Enhetens roll
Region
Datacenter
172.16.0.0/23
edge
172.16.0.0/27
sv
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
sv
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
sv
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Prefix
Region
Datacenter
10.0.0.0/17
sv
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Lab
Två leverantörer. Ett nät. ADSM.
Juniper + Arista. Ubuntu. Gamla goda Eva.
Antalet resurser på vår virtuella maskin i Miran är trots allt begränsat, så för praktikens skull kommer vi att använda ett så här förenklat nätverk.
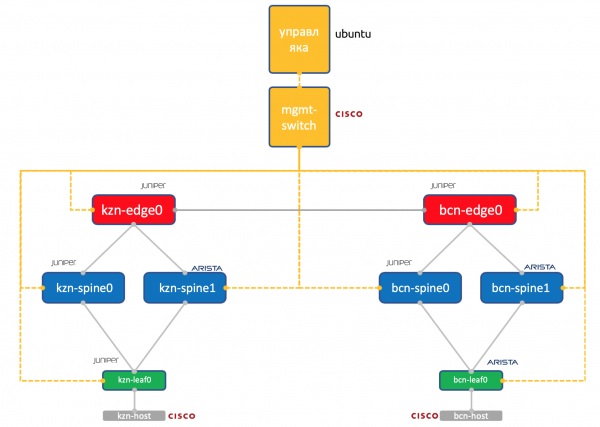
Två datacenter: Kazan och Barcelona.
- Två spine i varje: Juniper och Arista.
- En tor (Leaf) i varje — Juniper och Arista, med en ansluten värd (vi tar en lättviktig Cisco IOL för detta).
- En nod Edge-Leaf (just nu bara Juniper).
- En Cisco-switch för att styra dem alla.
- Utöver nätverksenheterna har en virtuell maskin startats för styrning. Under Ubuntu.
Den har tillgång till alla enheter, där IPAM/DCIM-system, en uppsättning Python-skript, Ansible och allt annat som kan behövas kommer att rulla.
av alla nätverksenheter som vi kommer att försöka återskapa med hjälp av automation.
Slutsats
Är det också ett standardförfarande? Att göra en kort sammanfattning under varje artikel?
Så vi har valt Clos-nätverk inom datacentret, eftersom vi förväntar oss mycket East-West-trafik och vill ha ECMP.
Vi delade nätverket i fysiskt (underlay) och virtuellt (overlay). I det här fallet börjar overlay med värden — på så sätt förenklade vi kraven på underlay.
Vi valde BGP som protokoll för routing av underliggande nätverk på grund av dess skalbarhet och flexibilitet i policyer.
Vi kommer ha separata noder för att organisera DCI – Edge-leaf.
På huvudlinjen kommer det att finnas OSPF+LDP.
DCI kommer att implementeras baserat på MPLS L3VPN.
För P2P-länkar kommer vi att beräkna IP-adresser algoritmiskt baserat på enhetsnamn.
Loopbacks kommer att tilldelas utifrån enheternas roller och deras placering i ordning.
Underliggande prefix kommer endast att tilldelas Leaf-switchar i sekvens baserat på deras placering.
Anta att vi just nu inte har installerad utrustning.
Därför kommer våra nästa steg att vara att registrera dem i systemen (IPAM, inventering), organisera åtkomst, generera konfigurationen och deploya den.
I nästa artikel kommer vi att gå igenom Netbox – ett system för inventering och hantering av IP-utrymme i datacentret.
Tack
- Till Andrey Glazkov aka @glazgoo för korrekturläsning och ändringar.
- Till Alexander Klimenko aka @v00lk för korrekturläsning och ändringar.
- Till Artyom Chernobay för KDPV.
Källa: habr.com
