

Hej alla. Jag arbetar som huvudsystemadministratör på OK och ansvarar för portala stabilitet. Jag vill berätta om hur vi har byggt upp processen för automatisk byte av diskar, och sedan hur vi har eliminerat administratören från denna process och ersatt honom med en bot.
Denna artikel är en slags translitterering på HighLoad+ 2018
Byggande av processen för byte av diskar
Först lite siffror
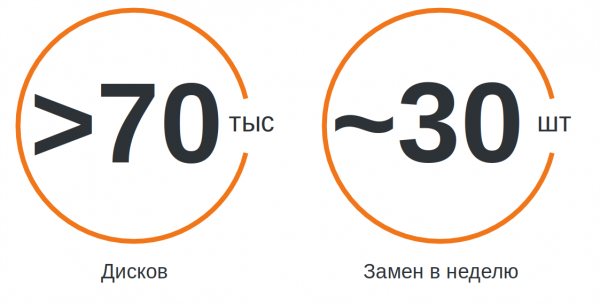
OK är en gigantisk tjänst som används av miljontals människor. Den underhålls av cirka 7 000 servrar som är belägna i 4 olika datacenter. Det finns över 70 000 diskar i servrarna. Om man staplar dem på varandra, får man ett torn som är över 1 km hög.
Hårddiskar är den komponent i servern som oftast går sönder. Med sådana volymer tvingas vi byta ut cirka 30 diskar varje vecka, och denna procedur har blivit en mindre trevlig rutin.
Incidenter
Vi har implementerat en fullständig incidenthantering i vårt företag. Varje incident dokumenteras i Jira, och vi löser och diskuterar dem. Om incidenten hade en effekt för användarna, samlas vi och tänker på hur vi snabbt kan reagera i sådana situationer, hur vi kan minska effekten och självklart hur vi kan förhindra upprepning.
Lagren är inget undantag. Deras tillstånd övervakas av Zabbix. Vi övervakar meddelanden i Syslog för skriv-/läserrors, analyserar tillståndet för HW/SW-RAID, och följer SMART för SSD, där vi beräknar slitage.
Hur diskar byttes tidigare
När en viss trigger aktiveras i Zabbix, skapas en incident i Jira och sätts automatiskt till de ansvariga ingenjörerna i datacentren. Vi gör så här med alla hårdvaruincidenter, det vill säga sådana som kräver något fysiskt arbete med hårdvaran i datacentret.
Datacenteringenjören är personen som hanterar frågor relaterade till hårdvaran, ansvarar för installation, underhåll och demontering av servrar. När ingenjören får en biljett, börjar han arbeta. I diskhyllorna byter han diskar själv. Men om han inte har tillgång till den nödvändiga enheten, vänder sig ingenjören till de jourhavande systemadministratörerna för hjälp. Först och främst måste disken tas ur rotation. För detta måste nödvändiga ändringar göras på servern, stoppa applikationerna och montera av disken.
Den jourhavande systemadministratören ansvarar under sin arbetsvecka för hela portalens funktion. Hen undersöker incidenter, utför reparationer och hjälper utvecklarna med mindre uppgifter. Hen arbetar dock inte med hårddiskarna.
Tidigare kommunicerade datacenter ingenjörer med systemadministratören i en chatt. Ingenjörerna skickade länkar till Jira-ärenden, och administratören gick igenom dem och förde logg i en anteckningsbok. Men för sådana uppgifter är chattar opraktiska: informationen är inte strukturerad och går snabbt förlorad. Dessutom kunde administratören helt enkelt ha lämnat datorn och under en tid inte svara på förfrågningar, medan ingenjören stod vid servern med en hög av diskar och väntade.
Men det värsta var att administratörerna inte såg den heliga bilden: vilka diskincidenter som finns och var det potentiellt kan uppstå problem. Detta beror på att vi överlämnar alla HW-incidenter till ingenjörerna. Ja, det var möjligt att visa alla incidenter på administratörens dashboard. Men det finns så många att administratören endast involverades i vissa av dem.
Dessutom kunde ingenjören inte korrekt prioritera, eftersom hen inte visste något om syftet med de specifika servrarna eller hur informationen är fördelad över lagringsenheterna.
Den nya proceduren för ersättning
Det första vi gjorde var att separera alla diskincidenter till en egen typ "HW-disk" och lägga till fälten "namn på blockenhet", "storlek" och "disktyp" så att denna information sparades i ärendet och inte hela tiden behövdes utbytas i chatten.
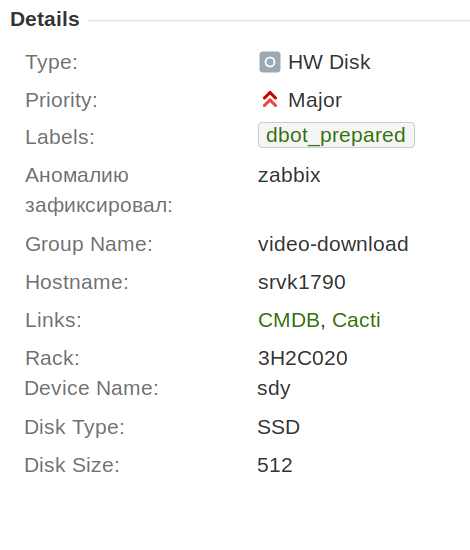
Vi kom också överens om att inom ramen för en incident endast byta ut en disk. Detta har avsevärt förenklat processen för automatisering, insamling av statistik och arbete.
Dessutom har vi lagt till fältet "ansvarig administratör". Där sätts den jourhavande systemadministratören automatiskt in. Detta är mycket praktiskt, eftersom ingenjören nu alltid ser vem som är ansvarig. Det är inte nödvändigt att gå till kalendern och leta. Just detta fält gjorde det möjligt att lyfta fram ärenden på administratörens dashboard där hen eventuellt kan behöva hjälp.
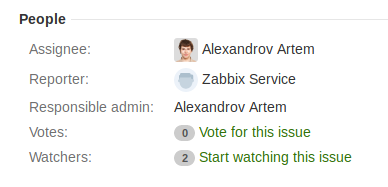
För att alla deltagare ska få ut det mesta av nyheterna har vi skapat filter och dashboards och berättat om dem för teamet. När folk förstår förändringarna avståndar de sig inte från dem som om de vore onödiga. En ingenjör behöver veta racknumret där servern är placerad, samt storlek och typ av disken. En administratör behöver i första hand förstå vilken typ av servergrupp det handlar om och vilken effekt som kan uppnås vid diskbyte.
Att ha fält och deras visning är praktiskt, men det befriar oss inte från att behöva använda chattar. För att göra det var vi tvungna att ändra arbetsflödet.
Tidigare var det så här:
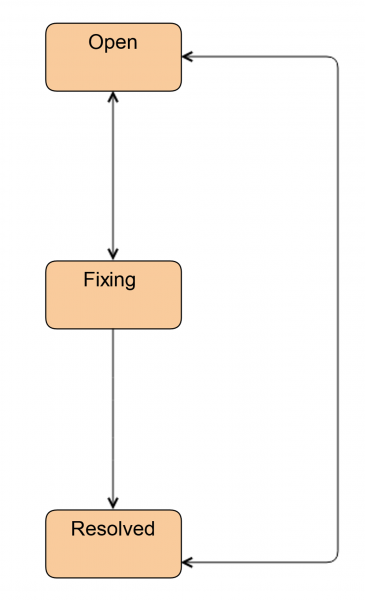
Så här fortsätter ingenjörerna att arbeta idag, när de inte behöver hjälp från administratören.
Det första vi gjorde var att införa en ny status Investigate. I denna status befinner sig ärendet när ingenjören ännu inte har beslutat om han behöver hjälp av administratören. Genom denna status kan ingenjören överföra ärendet till administratören. Dessutom markerar vi ärenden med denna status när en disk behöver bytas, men den faktiska disken inte finns på plats. Detta kan hända i fall med CDN och avlägsna platser.
Vi har också lagt till en status Redo. Ärendet överförs till denna status efter diskbytet. Det betyder att allt redan är gjort, men på servern synkroniseras HW/SW RAID. Detta kan ta ganska lång tid.
Om en administratör involveras blir schemat något mer komplicerat.
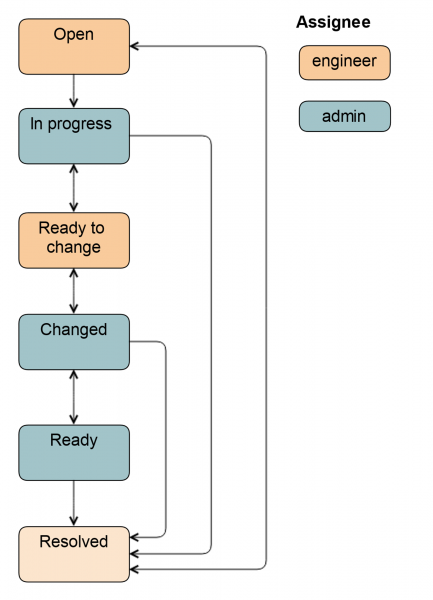
Från statusen Öppen kan ärendet överföras av både systemadministratören och ingenjören. I statusen In progress tar administratören bort disken från rotationen så att ingenjören kan ta ut den enkelt: han sätter på lampan, monterar bort disken, stoppar applikationerna, beroende på vilken typ av servergrupp det handlar om.
Sedan överförs ärendet till Ready to change: detta är en signal till ingenjören om att disken kan tas ut. Alla fält i Jira är redan ifyllda, ingenjören vet vilken typ och storlek disken har. Dessa uppgifter fylls i antingen automatiskt vid föregående status eller av administratören.
Efter diskbytet överförs ärendet till statusen Changed. Det kontrolleras att rätt disk har satts in, partitionering görs, applikationen startas och vissa uppgifter för datagenerering eller återställning utförs. Dessutom kan ärendet överföras till statusen Redo, i det fallet förblir administratören ansvarig, eftersom han var den som satte in disken i rotation. Den fullständiga schemat ser ut så här.
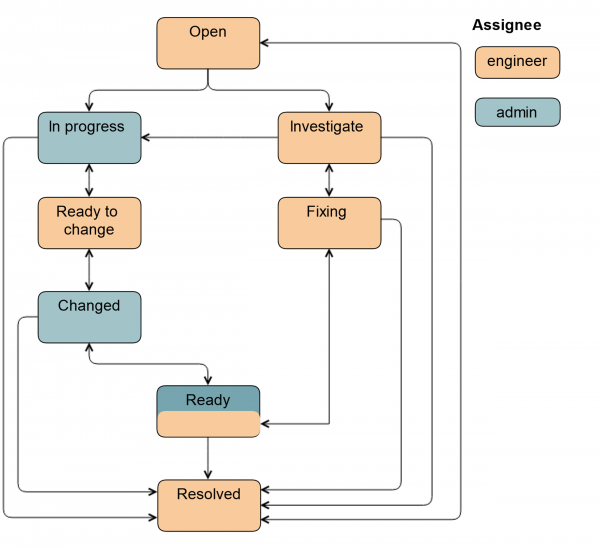
Tillägget av nya fält har underlättat vårt arbete avsevärt. Teamet arbetar nu med strukturerad information, och det är tydligt vad som behöver göras och i vilket skede. Prioriteringarna har blivit mycket mer relevanta, då de nu sätts av administratören.
Behovet av chattar har försvunnit. Självklart kan administratören skriva till ingenjören "här behöver det bytas snabbare", eller "är det möjligt att byta innan kvällen?". Men vi diskuterar inte längre dessa frågor dagligen i chattarna.
Diskarna byts nu ut i större mängder. Om administratören kommer till jobbet lite tidigare, har han tid över, och om inget har hänt kan han förbereda en rad servrar för byte: sätta fält, ta ur diskar från rotation och överlämna uppgiften till ingenjören. Ingenjören kommer lite senare till datacentret, ser uppgiften, hämtar de nödvändiga lagringsenheterna från lagret och byter dem direkt. Som en följd har hastigheten på bytet ökat.
Erfarenheter från byggandet av workflow.
- Vid skapandet av proceduren behöver information samlas från olika källor.
Vissa av våra administratörer visste inte att ingenjören bytte diskar på egen hand. Vissa trodde att ingenjörerna övervakade synkroniseringen av MD RAID, även om vissa av dem inte ens hade tillgång för det. Vissa ledande ingenjörer gjorde det, men inte alltid, eftersom processen inte var dokumenterad någonstans. - Proceduren måste vara enkel och tydlig.
Det är svårt för en person att hålla många steg i huvudet. De viktigaste närstående statusar i Jira bör flyttas till huvudskärmen. Vi kan till exempel omdöpa "In progress" till "Redo att byta". De andra statusarna kan döljas i en rullgardinsmeny så de inte stör ögonen. Men det är bättre att inte begränsa folk, utan ge möjlighet till övergångar.
Förklara värdet av nyheterna. När människor förstår, accepterar de den nya proceduren bättre. För oss var det mycket viktigt att människor inte bara klickade sig igenom hela processen, utan tog sig genom den. Sedan byggde vi automatiseringen på detta. - Vänta, analysera, förstå.
Vi spenderade ungefär en månad på att bygga upp proceduren, den tekniska implementeringen, möten och diskussioner. Och för implementeringen tog det mer än tre månader. Jag såg hur folk sakta började använda nyheten. I början var det mycket negativt. Men det berodde helt enkelt inte på själva proceduren, eller dess tekniska genomförande. Till exempel använde en administratör inte Jira, utan en Jira-plugin i Confluence, och vissa saker var inte tillgängliga för honom. Vi visade honom Jira, och administratörens produktivitet ökade både för generella uppgifter och för diskbyten.
Automatisering av diskbyten
Vi har försökt att automatisera diskbyten vid flera tillfällen. Vi hade redan vissa förberedelser, skript, men alla fungerade antingen interaktivt eller manuellt, och krävde att man startade dem. Och först efter att vi implementerat den nya proceduren insåg vi att det var precis det vi saknade.
Eftersom processen för diskbyten nu är uppdelad i steg, där varje steg har en ansvarig och en lista med åtgärder, kan vi införa automatisering stegvis, snarare än allt på en gång. Till exempel kan det enklaste steget—Ready (kontroll av RAID/synkronisering av data)—lätt delegeras till en bot. När boten har fått lite träning kan vi ge den mer ansvarsfulla uppgifter—insättning av disk i rotation osv.
Zoologisk park av installationer
Innan vi pratar om boten, låt oss göra en liten utflykt till vår zoologiska park av installationer. För det första beror den på den enorma storleken av vår infrastruktur. För det andra försöker vi för varje tjänst anpassa den optimala hårdvarukonfigurationen. Vi har omkring 20 modeller av hårdvaru-RAID, främst LSI och Adaptec, men även HP och DELL av olika versioner. Varje RAID-kontroller har sitt eget administrationsverktyg. Kommando-set och utdata från dem kan variera från version till version av varje RAID-kontroller. Där där HW-RAID inte används, kan det finnas mdraid.
Nästan alla nya installationer gör vi utan diskreserv. Vi försöker att inte längre använda hårdvara och mjukvara RAID, eftersom vi reserverar våra system på datacenter-nivå och inte på servrar. Men självklart finns det många äldre servrar som behöver stöd.
Någonstans kopplas diskar i RAID-kontroller raw-enheter, någonstans används JBOD. Det finns konfigurationer med en enda systemdisk i servern, och om den måste bytas ut måste servern rullas om med installation av operativsystem och applikationer, och dessutom samma versioner, och sedan lägga till konfigurationsfiler och starta applikationerna. Det finns också många grupper av servrar där redundans inte görs på nivå av diskunderstöd, utan direkt i applikationerna själva.
Totalt har vi mer än 400 unika grupper av servrar som körs med cirka 100 olika applikationer. För att täcka ett så stort antal alternativ behövde vi ett multifunktionellt automatiseringsverktyg. Helst med ett enkelt DSL så att även den som skrev det kan stödja det.
Vi valde Ansible eftersom det är agentfritt: det behövde inte förbereda infrastrukturen, och uppstarten går snabbt. Dessutom är det skrivet i Python, vilket är standard i teamet.
Översiktlig schema
Låt oss titta på det övergripande schemat för automatisering utifrån ett exempel på ett incident. Zabbix detekterar att disken sdb har slutat fungera, en trigger sätts igång, och en ticket skapas i Jira. Administratören granskar den, inser att det inte är en dubblett eller en falsk positiv och att disken behöver bytas, och för över ticketen till In progress.
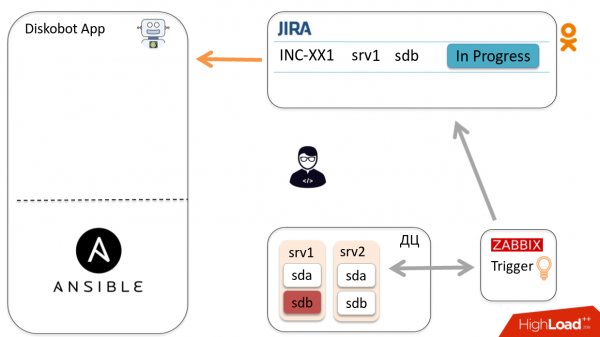
Applikationen DiskoBot, skriven på Python, kollar regelbundet Jira efter nya tickets. Den noterar att en ny ticket In progress har dykt upp, vilket aktiverar motsvarande tråd som startar playbooken i Ansible (detta görs för varje status i Jira). I detta fall startar den Prepare2change.
Ansible skickas till värden, tar bort disken från rotation och rapporterar statusen till applikationen via Callbacks.
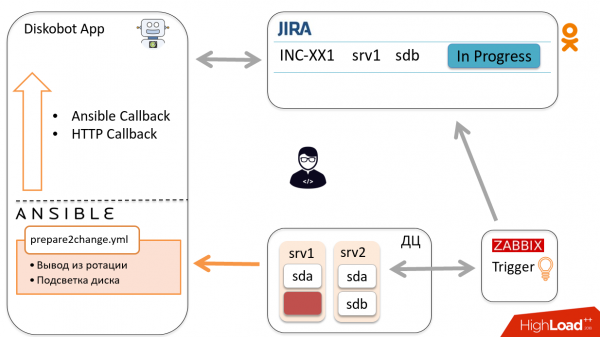
Baserat på resultaten för övergår boten automatiskt ticketen till Ready to change. Ingenjören får en avisering och åker för att byta disken, varefter han/han för över ticketen till Changed.
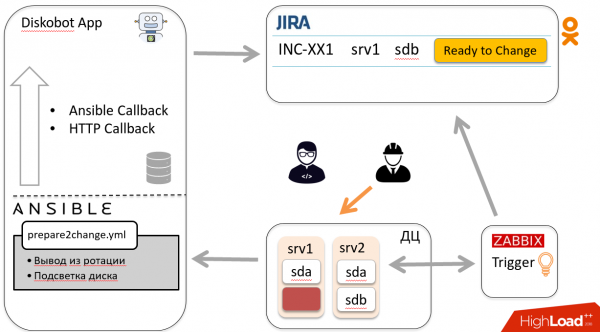
Enligt ovanstående schema kommer ticketen tillbaka till boten, som kör en annan playbook, går till värden och sätter in disken i rotation. Boten stänger ticketen. Hurra!
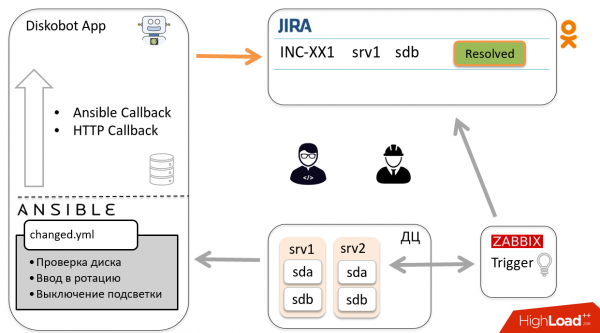
Nu pratar vi om några komponenter i systemet.
Diskobot
Denna applikation är skriven i Python. Den väljer tickets från Jira enligt JQL. Beroende på statusen för ticketen hamnar den hos respektive hanterare som i sin tur kör motsvarande Ansible playbook för statusen.
JQL och undersökningsintervall definieras i applikationens konfigurationsfil.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Till exempel, bland biljetterna med statusen In progress, väljs endast de där fälten Disk size och Device name är ifyllda. Device name är namnet på det blockenheten som behövs för att köra playbooken. Disk size är nödvändig så att ingenjören vet vilken storlek på disken som krävs.
Bland biljetterna med statusen Ready filtreras biljetter med etiketten dbot_ignore. För att nämna något, använder vi Jira etiketter både för liknande filtrering och för att märka dubbletter av biljetter samt för att samla statistik.
Vid ett misslyckande av playbooken tilldelar Jira etiketten dbot_failed, för att det senare ska kunna åtgärdas.
Interaktion med Ansible
Applikationen interagerar med Ansible genom . I playbook_executor överför vi filnamnet och en uppsättning variabler. Detta gör att vi kan hålla Ansible-projektet i form av vanliga yml-filer och inte beskriva det i Python-kod.
Även i Ansible överförs namnet på blockenheten, statusen för biljetten, samt callback_url genom *extra_vars*, där issue-nyckeln är inbäddad — den används för callback i HTTP.
För varje körning genereras en temporär inventory, bestående av en värd och en grupp, som innefattar denna värd, för att gruppröda group_vars ska tillämpas.
Här är ett exempel på en uppgift som implementerar HTTP callback.
Resultatet av playbook-körningar får vi via callback(-er). Det finns två typer:
- , som tillhandahåller data om resultaten av playbook-körningen. Här beskrivs uppgifter som har körts, antingen framgångsrikt eller misslyckat. Den här callbacken anropas vid slutet av playbookens körning.
- HTTP callback för att få information under körningen av playbooken. I Ansible-uppgiften gör vi en POST/GET-förfrågan till vår applikation.
Genom HTTP callback(-er) överförs variabler som har definierats under körningen av playbooken och som vi vill spara och använda vid framtida körningar. Dessa data skriver vi till sqlite.
Även genom HTTP callback lämnar vi kommentarer och ändrar statusen för biljetten.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Precis som många liknande uppgifter har vi flyttat den till en separat gemensam fil och inkluderar den vid behov så att vi inte ständigt behöver repetera i playbooks. Här refereras callback_url, där issue-key och värdnamn är inbäddade. När Ansible utför denna POST-förfrågan förstår boten att den kom inom ramen för en viss incident.
Här är ett exempel från playbooken där vi tog bort en disk från MD-enheten:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Denna uppgift ändrar Jira-biljetten till status "Ready to change" och lägger till en kommentar. Dessutom sparas listan över MD-enheter från vilka disken har tagits bort i variabeln mdam_data, medan partitionen sparas i parted_info som en dump från parted.
När ingenjören sätter in en ny disk kan vi använda dessa variabler för att återställa partitionens dump, samt lägga till disken i de MD-enheter från vilka den har tagits bort.
Ansible check mode
Att aktivera automation var skrämmande. Därför beslutade vi att köra alla playbooks i läget
, där Ansible inte utför några åtgärder på servrarna utan bara emulerar dem.
En sådan körning körs genom en separat callback-modul, och resultatet av playbooken sparas i Jira som en kommentar.
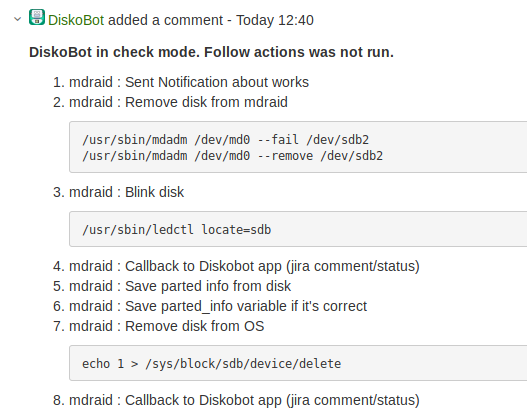
För det första gjorde detta det möjligt att validera botens och playbooks funktionalitet. För det andra ökade det förvaltarens förtroende för boten.
När vi genomgick valideringen och insåg att vi kunde köra Ansible inte bara i läget dry run, gjorde vi en knapp i Jira för att köra Diskobot, vilket startar samma playbook med samma variabler på samma värd, men i normalt läge.
Dessutom används knappen för att köra om playbooken om den misslyckas.
Struktur av Playbooks
Jag har redan nämnt att beroende på statusen hos Jira-biljetten, startar boten olika playbooks.
För det första är det mycket enklare att organisera indata.
För det andra är det i vissa fall helt nödvändigt.
Till exempel, när du byter ut systemdisken behöver du först gå till distributionssystemet, skapa en uppgift, och efter att distributionen har genomförts korrekt, blir servern tillgänglig via ssh, och du kan installera applikationen på den. Om vi hade gjort allt detta i en enda playbook, skulle Ansible inte kunna utföra den på grund av att värden inte är tillgänglig.
Vi använder Ansible-roller för varje servergrupp. Här är hur playbookarna är organiserade i en av dem.
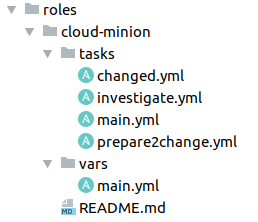
Det är bekvämt eftersom man direkt ser var olika uppgifter finns. I main.yml, som är ingången för Ansible-rollen, kan vi ha en enkel include baserat på ärendets status eller allmänna uppgifter som krävs för alla, till exempel ID-verifiering eller hämta token.
Investigation.yml
Det körs för ärenden i status Investigation och Open. Det viktigaste för denna playbook är namnet på blockenheten. Denna information är inte alltid tillgänglig.
För att få den analyserar vi Jira-sammanfattningen, det senaste värdet från Zabbix-triggern. Där kan blockenhetens namn finnas — om vi är lyckligt lottade. Det kan också finnas en mount point, då måste vi gå till servern, parsa och beräkna den nödvändiga disken. Triggern kan också skicka scsi-adressen eller någon annan information. Men ibland finns det inga ledtrådar och vi måste analysera.
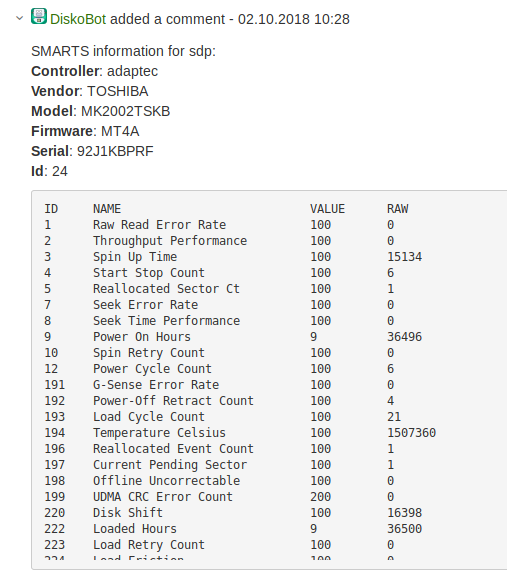
När vi har fått blockenhetens namn samlar vi information om typ och storlek på disken för att fylla i fälten i Jira. Vi tar också information om tillverkare, modell, firmware, ID, SMART, och lägger allt detta i kommentaren i Jira-ärendet. Administratören och ingenjören behöver nu inte leta efter dessa data. 🙂
prepare2change.yml
Ta bort disken från rotation, förbereda för byte. Det mest komplexa, ansvarsfulla steget. Här kan man verkligen stoppa en applikation när den inte får stoppas. Eller ta ut en disk som saknar repliker och därmed påverka användarna och förlora vissa data. Här har vi flest kontroller och notifieringar i chatten.
I det enklaste fallet handlar det om att ta bort disken från HW/MD RAID.
I mer komplexa situationer (i våra lagringssystem), när redundans genomförs på applikationsnivå, måste vi gå in i applikationen via API, rapportera om att disken tas bort, inaktivera den och starta återhämtning.
Vi migrerar nu massivt till , och om servern är en molnserver, kontaktar Diskobot molnets API, meddelar att den tänker arbeta med denna minion — servern där containrarna körs — och ber "migrera alla containrar från denna minion". Den aktiverar också diskupplysningen så att ingenjören direkt kan se vilken som ska tas ut.
changed.yml
Efter att ha bytt disken kontrollerar vi först dess tillgänglighet.
Ingenjörer byter inte alltid ut de nya diskarna, så vi har lagt till kontroll av de SMART-värden som vi är nöjda med.
Vilka attributer tittar vi påReallocated Sectors Count (5) < 100
Current Pending Sector Count (107) == 0
Om disken inte klarar kontrollen, meddelas ingenjören om att en ny ersättning krävs. Om allt är i ordning stängs indikeringen av, markering appliceras och disken sätts i rotation.
ready.yml
Det enklaste fallet: kontroll av synkronisering av HW/SW raid eller slutet av datasykronisering i applikationen.
API för applikationer
Jag har nämnt flera gånger att boten ofta kontaktar API för applikationer. Självklart har inte alla applikationer de nödvändiga metoderna, så jag var tvungen att utveckla dem. Här är de viktigaste metoderna som vi använder:
- Status. Status för klustret eller disken för att förstå om den går att arbeta med;
- Start/stop. Aktivering-deaktivering av disken;
- Migrate/restore. Migrering och återställning av data under och efter ersättningen.
Sammanställd erfarenhet kring Ansible
Jag älskar Ansible mycket. Men ofta, när jag tittar på olika opensource-projekt och ser hur folk skriver playbooks, blir jag lite rädd. Komplexa logiska sammanflätningar av when/loop, brist på flexibilitet och idempotens på grund av frekvent användning av shell/command.
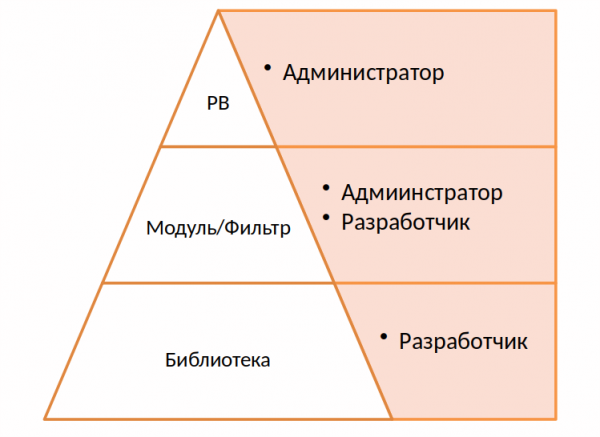
Vi beslutade att förenkla allt så mycket som möjligt och dra nytta av Ansible:s moduläritet. På den högsta nivån finns playbooks, som kan skrivas av vilken administratör eller extern utvecklare som helst som har lite kunskap om Ansible.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Om någon logik är svår att implementera i playbooks, flyttar vi den till en Ansible-modul eller filter. Skripten kan skrivas både i Python och vilket annat språk som helst.
De är lätta och snabba att skriva. Till exempel består modulen för att blinka disken, vars användning är exemplifierad ovan, av 265 rader.
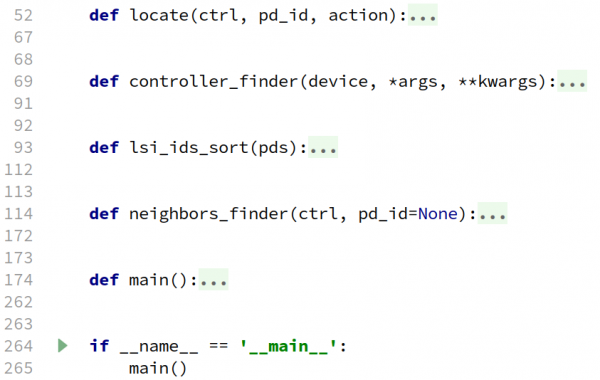
På den lägsta nivån finns biblioteket. För detta projekt skrev vi en separat applikation, en slags abstraktion över hårdvaru- och mjukvaru-RAID, som utför motsvarande förfrågningar.
De starkaste sidorna av Ansible är enkelheten och de tydliga playbooks. Jag anser att man bör utnyttja detta och inte generera skrämmande yaml-filer och enorma mängder villkor, shell-kod och loopar.
Om du vill återupprepa vår erfarenhet med Ansible API, tänk på två saker:
- Playbook_executor och playbook i allmänhet kan inte ta emot en timeout. Det finns en timeout för ssh-sessioner, men ingen timeout för playbook. Om vi försöker avmontera en disk som redan inte finns i systemet kommer playbooken att köras oändligt, så vi var tvungna att kapsla in dess körning i en separat wrapper och döda den enligt timeout.
- Ansible fungerar på grundval av fork-processer, så dess API är inte trådsäkert. Vi kör alla våra playbooks enkeltrådat.
I slutändan lyckades vi automatisera utbytet av cirka 80 % av diskarna. Totalt har hastigheten på bytena fördubblats. Idag ser administratören bara på incidenten och fattar beslut om huruvida disken behöver bytas eller inte, och därefter gör han ett enda klick.
Men nu börjar vi stöta på ett annat problem: vissa nya administratörer vet inte hur man byter diskar. 🙂
Källa: habr.com
