

I Vi har diskuterat våra försök att använda Watcher och presenterat en testrapport. Sådana tester genomför vi regelbundet för lastbalansering och andra kritiska funktioner i stora företags- eller operatormoln.
Den höga komplexiteten hos uppgiften vi löser kan kräva flera artiklar för att beskriva vårt projekt. I dag publicerar vi den andra artikeln i serien, som handlar om lastbalansering av virtuella maskiner i molnet.
Lite terminologi
Företaget VmWare har introducerat verktyget DRS (Distributed Resource Scheduler) för att balansera lasterna i den miljö för virtualisering som de har utvecklat och erbjuder.
Som skrivet av
«VMware DRS (Distributed Resource Scheduler) är ett verktyg som balanserar datorkrafter med tillgängliga resurser i en virtuell miljö. Verktyget är en del av en virtualiseringspaket som kallas VMware Infrastructure.
Med VMware DRS definierar användare regler för fördelning av fysiska resurser mellan virtuella maskiner (VM). Verktyget kan konfigureras för manuell eller automatisk hantering. Resursgrupper i VMware kan enkelt läggas till, tas bort eller omorganiseras. Om så önskas kan resursgrupper isoleras mellan olika affärsenheter. Om arbetsbelastningen på en eller flera virtuella maskiner förändras kraftigt, omfördelar VMware DRS de virtuella maskinerna mellan fysiska servrar. Om den totala arbetsbelastningen minskar kan vissa fysiska servrar tillfälligt stängas av, och arbetsbelastningen konsolideras.»
Varför behövs lastbalansering?
Enligt vår åsikt är DRS en nödvändig funktion i molnet, även om det inte betyder att DRS alltid och överallt måste användas. Beroende på syftet och behoven hos molnet kan det finnas olika krav på DRS och metoder för lastbalansering. Det kan finnas situationer där lastbalansering inte alls behövs, eller till och med är skadlig.
För att förstå bättre var och för vilka kunder DRS behövs, låt oss överväga deras mål och uppgifter. Moln kan delas in i offentliga och privata. Här är de viktigaste skillnaderna mellan dessa moln och kundernas mål.
Privata moln / Stora företagskunder
Offentliga moln / Medel och små företag, individer
Huvudkriteriet och målen för operatören
Att tillhandahålla en pålitlig tjänst eller produkt
Minskning av kostnader för tjänster i kampen på den konkurrensutsatta marknaden
Krav på tjänsten
Tillförlitlighet på alla nivåer och i alla systemets element
Garantit för prestanda
Prioritering av virtuella maskiner i flera kategorier
Informations- och fysisk säkerhet för data
SLA och support dygnet runt
Maximal enkelhet att få tjänsten
Relativt enkla tjänster
Ansvar för data ligger hos kunden
Prioritering av VM behövs inte
Informationssäkerhet på nivån av standardtjänster, ansvar hos kunden
Förseningar kan inträffa
Ingen SLA, kvalitet garanteras inte
Support via e-post
Backup är inte obligatorisk
Kundens specifika behov
Mycket brett spektrum av applikationer.
Legacy-applikationer, ärvda inom företaget.
Komplexa anpassade arkitekturer för varje kund.
Affinitetsregler.
Programvaran fungerar utan avbrott i 7x24-läge.
Backupverktyg "on-the-fly".
Förutsägbar cyklisk belastning från kunden.
Standardapplikationer – nätverksbalansering, Apache, WEB, VPN, SQL
Möjlig nedstängning av applikationen under en tid
Fria placeringar av VM i molnet
Backup utförd av kunden
Förutsägbar statistiskt genomsnittlig belastning med många kunder.
Konsekvenser för arkitekturen
Geokluster
Centraliserad eller distribuerad lagringslösning
Reservkraft
Lokal lagring av data på databehandlingsnoder
Mål för balansering
Jämn fördelning av belastning
Maximal responsivitet för applikationer
Minimal fördröjningstid vid balansering
Balansering endast vid tydligt behov
Uppdrag av viss utrustning för underhåll
Minskning av kostnader för tjänsten och operatörens kostnader
Avstängning av vissa resurser vid låg belastning
Energibesparing
Minskade personalkostnader
Vi drar följande slutsatser:
För privata moln, som tillhandahålls stora företagskunder, kan DRS tillämpas med hänsyn till begränsningar:
- informationssäkerhet och beaktande av affinitetsregler vid balansering;
- tillgång till tillräckliga resurser i reserv vid en olycka;
- data från virtuella maskiner lagras på en centraliserad eller distribuerad lagringslösning;
- tidsfördelning av administrations-, backup- och balanseringsprocedurer;
- balansering endast inom kundens hostaggregat;
- balansering endast vid stark obalans, de mest effektiva och säkra VM-migreringarna (eftersom migrering kan misslyckas);
- balansering i förhållande till "lugna" virtuella maskiner (migrering av "bullriga" virtuella maskiner kan ta väldigt lång tid);
- balansering med hänsyn till "kostnaden" – belastningen på lagringssystemet och nätverket (vid anpassade arkitekturer för stora kunder);
- balansering med hänsyn till de individuella beteendeegenskaperna hos varje VM;
- balansering helst under icke-arbetstid (natt, helger, högtider).
För offentliga moln, som tillhandahåller tjänster till små kunder, kan DRS tillämpas mycket oftare, med utökade möjligheter:
- frånvaro av begränsningar för informationssäkerhet och affinitetsregler;
- balansering inom molnet;
- balansering vid all rimlig tid;
- balansering av vilken VM som helst;
- balansering av "bullriga" virtuella maskiner (för att inte störa de andra);
- data från virtuella maskiner finns ofta på lokala diskar;
- beaktande av den genomsnittliga prestandan hos lagringssystemet och nätverket (molnets arkitektur är en enhet);
- balansering enligt generella regler och befintlig statistik över datacenterbeteende.
Problemets komplexitet
Komplexiteten i balanseringen ligger i det faktum att DRS måste arbeta med ett stort antal osäkra faktorer:
- användarbeteende i varje kunds informationssystem;
- algoritmer för servernas arbete i informationssystem;
- beteendet hos databasservere;
- belastning på beräkningsresurser, lagringssystem och nätverk;
- interaktion mellan servrar i kampen om molnets resurser.
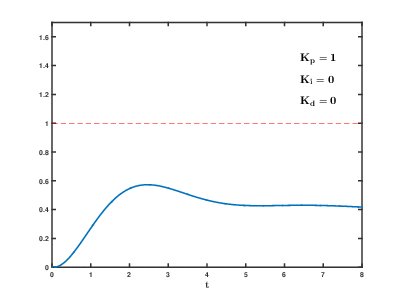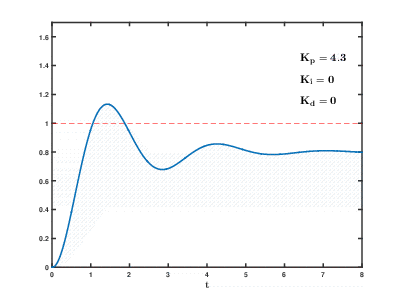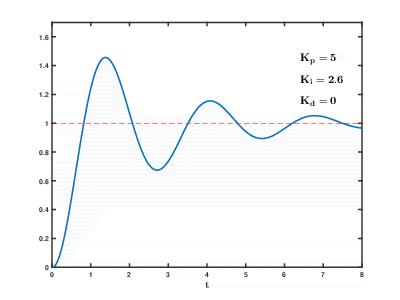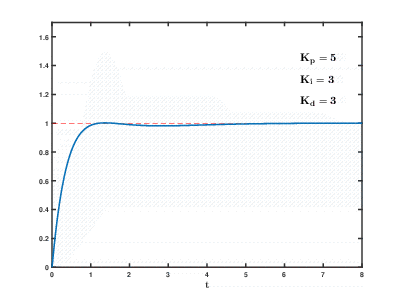
Belastningen av ett stort antal virtuella applikations- och databasservrar på molnresurser sker över tid, och konsekvenserna kan manifestera sig och överlappa varandra med oförutsägbara effekter över en oförutsägbar tidsperiod. Även för att hantera relativt enkla processer (till exempel för att styra en motor, ett system för vattenuppvärmning i hemmet) måste automatiska regleringssystem använda komplexa algoritmer med återkoppling.
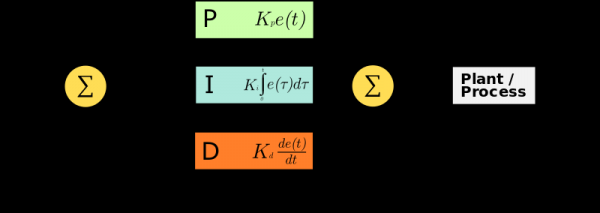
Vår uppgift är flera nivåer mer komplicerad, och det finns en risk att systemet inte kan genomföra belastningsbalansering till stabiliserade värden inom rimlig tid, även om externa påtryckningar från användare inte uppstår.
Historien om våra utvecklingar
För att lösa detta problem beslutade vi oss för att inte börja om från början, utan istället bygga på den befintliga kunskapen, och vi började samarbeta med specialister inom detta område. Lyckligtvis sammanföll vår förståelse av problematiken helt.
Steg 1
Vi använde ett system baserat på neuronnätsteknik och försökte optimera våra resurser utifrån det.
Intresset för detta skede låg i att pröva en ny teknik, och dess betydelse låg i tillämpningen av en ovanlig metod för att lösa problemet, där standardmetoderna i övrigt nästan hade uttömt sina möjligheter.
Vi lanserade systemet, och vi såg verkligen en belastningsbalansering. Storleken på vårt moln gjorde att vi inte fick de optimistiska resultaten som utlovades av utvecklarna, men det var tydligt att balanseringen fungerade.
Samtidigt hade vi ganska allvarliga begränsningar:
- För att träna neuronnätet är det nödvändigt att de virtuella maskinerna fungerar utan betydande förändringar under veckor eller månader.
- Algoritmen är utformad för optimering baserat på analys av tidigare "historiska" data.
- För att träna neuronnätet krävs en tillräckligt stor mängd data och beräkningsresurser.
- Optimering och balansering kan göras relativt sällan – en gång var flera timmar, vilket uppenbarligen är otillräckligt.
Steg 2
Eftersom vi inte var nöjda med situationen beslutade vi att modifiera systemet, och för detta behövde vi svara på den huvudsakliga frågan – för vem gör vi det?
Först och främst – för företagskunder. Det innebär att vi behöver ett system som fungerar snabbt, med de företagsbegränsningar som bara förenklar genomförandet.
Den andra frågan – vad menar vi med "snabbt"? Efter korta diskussioner beslutade vi att vi kunde utgå från en reaktionstid på 5–10 minuter, så att kortvariga toppar inte stör systemet.
Den tredje frågan – vilken storlek på det balanseterade antalet servrar ska vi välja?
Detta problem löste sig självt. Som regel gör inte kunderna serveraggregat särskilt stora, och detta överensstämmer med rekommendationerna i artikeln om att begränsa aggregat till 30-40 servrar.
Dessutom, genom att segmentera serverpoolen förenklar vi algoritmens balansjobb.
Den fjärde frågan – hur lämplig är en neuronnätverk med dess långa inlärningsprocess och sällsynta balanseringar för oss? Vi har beslutat att avstå från det till förmån för enklare operationella algoritmer för att få resultat på sekunder.
Du kan bekanta dig med systembeskrivningen som använder sådana algoritmer och dess nackdelar
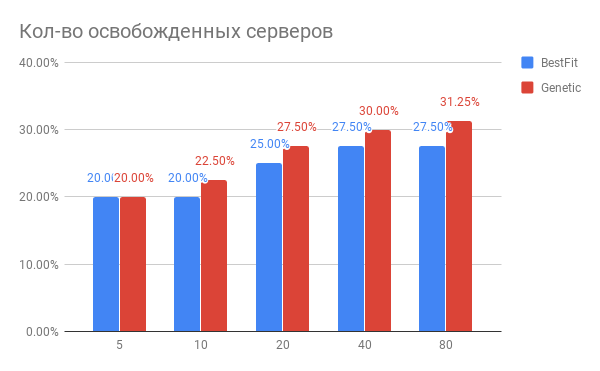
Vi implementerade och lanserade detta system och fick lovande resultat – nu analyserar det regelbundet belastningen i molnet och ger rekommendationer för flyttning av virtuella maskiner, vilket ofta är korrekt. Redan nu är det tydligt att vi kan uppnå 10-15 % frigöring av resurser för nya virtuella maskiner med förbättrad kvalitet på de befintliga.
Vid upptäckten av obalans i RAM eller CPU ger systemet kommandon till Tionyx-schemaläggaren för att genomföra levande migration av de nödvändiga virtuella maskinerna. Som syns i övervakningssystemet, flyttades den virtuella maskinen från en (övre) till en annan (nedre) värd och frigjorde minne på den övre värden (markerad i gula cirklar), och tog det motsvarande på den nedre (markerad i vita cirklar).
Just nu försöker vi mer noggrant bedöma effektiviteten av den nuvarande algoritmen och letar efter möjliga fel i den.
Steg 3
Det skulle tyckas att vi kan nu lugna oss, vänta på bevisad effektivitet och stänga ämnet.
Men följande uppenbara optimeringsmöjligheter driver oss till att genomföra ett nytt steg
- Statistik, till exempel, och visar att två- och fyrprocessorsystem presterar betydligt sämre än enprocessor-system. Det betyder att alla användare får en mycket mindre avkastning från inköpta CPU, RAM, SSD, LAN, FC i flerprocessor-system jämfört med enprocessor-system.
- Själva resursschemaläggarna kan arbeta med betydande fel, om detta ämne.
- De teknologier som erbjuds av Intel och AMD för övervakning av RAM och cache gör det möjligt att studera beteendet hos virtuella maskiner och placera dem på ett sätt så att "brusiga" grannar inte stör "lugna" virtuella maskiner.
- Utöka uppsättningen av parametrar (nätverk, lagringssystem, prioritet för virtuella maskiner, kostnad för migrering, beredskap för migrering).
Sammanfattningsvis
Resultatet av vårt arbete med att förbättra balansalgoritmerna har lett till en tydlig slutsats att genom moderna algoritmer kan man uppnå betydande resurseffektivisering (25-30%) i datacenter och samtidigt höja kvaliteten på kundservicen.
Algoritmen som är baserad på neurala nätverk är utan tvekan intressant, men kräver vidareutveckling och är på grund av befintliga begränsningar inte lämplig för uppgifter av den storlek som är typiska för privata moln. I offentliga moln av betydande storlek har algoritmen emellertid visat goda resultat.
Mer om processorer, schemaläggare och högre nivå av balansning kommer vi att berätta i kommande artiklar.
Källa: habr.com
