

KDB+, en produkt från företaget är en välkänd, extremt snabb kolumndatabas avsedd för lagring av tidsserier och analytiska beräkningar baserat på dem. Den har ursprungligen haft (och har fortfarande) stor popularitet inom finanssektorn — alla topp-10 investeringsbanker och många kända hedgefonder, börser och andra organisationer använder den. På senare tid har KX beslutat att utöka sin kundbas och erbjuder nu lösningar även inom andra områden där det finns stora mängder data som är ordnade tidsmässigt eller på annat sätt — telekom, bioinformatik, produktion osv. De har också blivit partner till Aston Martin Red Bull Racing-teamet inom Formel 1, där de hjälper till att samla in och bearbeta data från bilarnas sensorer och analysera tester i vindtunneln. I den här artikeln vill jag förklara vilka egenskaper KDB+ har som gör den supersnabb, varför företag är villiga att spendera stora summor på den, och varför det faktiskt inte är en databas.
I den här artikeln kommer jag att försöka förklara vad KDB+ är, vilka möjligheter och begränsningar den har, samt vilken nytta den erbjuder företag som vill bearbeta stora datavolymer. Jag kommer inte att gå in på detaljerna för hur KDB+ implementeras och detaljerna för dess programmeringsspråk Q. Båda dessa ämnen är mycket omfattande och förtjänar egna artiklar. Mycket information om dessa ämnen kan hittas på webbplatsen code.kx.com, inklusive en bok om Q — Q For Mortals (se länken nedan).
Några termer
- In-memory databas. En databas som lagrar data i RAM för att snabba upp åtkomsten. Fördelarna med en sådan databas är uppenbara, medan nackdelarna är risken för dataloss, samt behovet av mycket minne på servern.
- Kolumn databas. En databas där data lagras kolumnvis istället för radvis. Huvudfördelen med en sådan databas är att data från en kolumn lagras tillsammans på disk och i minnet, vilket avsevärt snabbar upp åtkomsten. Det är inte nödvändigt att ladda kolumner som inte används i frågan. Huvudnackdelen är att det är svårt att modifiera och ta bort poster.
- Tidsserier. Data med datu- eller tidskolumn. Vanligtvis är ordning i tid viktig för sådana data, så att man enkelt kan avgöra vilken post som föregår eller följer den aktuella, eller för att tillämpa funktioner vars resultat beror på ordningen på posterna. Klassiska databaser är uppbyggda på helt andra principer — presenterar en uppsättning poster som en mängd, där ordningen på posterna i princip inte är definierad.
- Vektor. I KDB+-sammanhang är det en lista av element av en och samma atomära typ, till exempel nummer. Med andra ord, en array av element. Arrays, till skillnad från listor, kan lagras kompakt och bearbetas med hjälp av vektorbaserade processorinstruktioner.
Historisk översikt
Företaget KX grundades 1993 av Arthur Whitney, som tidigare arbetat på Morgan Stanley med språket A+, som var en efterföljare till APL — ett mycket originellt och populärt språk inom finansvärlden. Självklart fortsatte Arthur i KX med samma anda och skapade det vektorfunktionella språket K, styrt av idéerna om radikal minimalism. Program skrivna i K ser ut som en kaotisk uppsättning skiljetecken och speciella symboler, där betydelsen av tecken och funktioner beror på sammanhanget, och varje operation har en mycket djupare innebörd än vad man vanligtvis ser i klassiska programmeringsspråk. Tack vare detta tar ett K-program minimal plats — några rader kan ersätta sidor av text i långrandiga språk som Java — och är en superkoncentrerad implementering av algoritmen.
En funktion i K som implementerar största delen av LL1-parsergeneratorn enligt en given grammatik:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Denna filosofi om extrem effektivitet med minimala rörelser har Arthur också förverkligat i KDB+, som lanserades 2003 (nu tror jag att det är klart varifrån bokstaven K i namnet kommer) och är inget annat än en tolk av den fjärde versionen av K-språket. Ovanpå K har en mer användarvänlig version av K lagts till, kallad Q. I Q har även stöd för en specifik SQL-dialekt — QSQL, samt stöd för tabeller som datatyp, verktyg för att hantera tabeller i minnet och på disk osv. lagts till.
Således, sett ur ett användarperspektiv, är KDB+ helt enkelt en tolk för Q-språket med stöd för tabeller och SQL-liknande uttryck i LINQ-stil från C#. Detta är den viktigaste skillnaden mellan KDB+ och andra databaser och dess främsta konkurrensfördel som ofta förbises. Det är inte en databas + ett hjälp-språk, utan ett fullvärdigt kraftfullt programmeringsspråk + inbyggt stöd för databasfunktioner. Denna skillnad kommer att spela en avgörande roll när man räknar upp alla fördelar med KDB+. Till exempel…
Dimensions
Enligt moderna standarder har KDB+ en mikroskopisk storlek. Det är i bokstavlig mening en körbar fil på mindre än en megabyte och en liten textfil med vissa systemfunktioner. Faktiskt — mindre än en megabyte och för detta program betalar företag tiotusentals dollar per år för en processor på servern.
- En sådan storlek gör att KDB+ fungerar utmärkt på vilken hårdvara som helst — från mikrodatorn Pi till servrar med terabyte av minne. Detta påverkar inte funktionaliteten, snarare startar Q omedelbart, vilket också gör att det kan användas som ett skriptspråk.
- Med en sådan storlek ryms Q-tolken helt i processorens cache, vilket snabbar upp körningen av program.
- Med en sådan storlek på den körbara filen tar Q-processen försvinnande lite minnesutrymme, och de kan startas i hundratals. Samtidigt kan Q vid behov hantera tiotals eller hundratals gigabyte minne inom en och samma process.
Allsidighet
Q passar utmärkt för en mängd olika uppgifter. Q-processen kan fungera som en historisk databas och ge snabb tillgång till terabyte av information. Vi har till exempel Dussintals historiska databaser, där en ospecificerad dag med data tar mer än 100 gigabyte. Trots detta, med rimliga begränsningar, kommer en databasfråga att utföras inom tiotals till hundratals millisekunder. Generellt har vi en universell tidsgräns för användarförfrågningar på 30 sekunder, och den utlöses mycket sällan.
Med samma lätthet kan Q fungera som en in-memory databas. Att lägga till nya data i tabellerna i minnet sker så snabbt att det begränsande faktorn är användarförfrågningar. Data i tabellerna lagras kolumnvis, vilket innebär att varje operation på en kolumn utnyttjar processorns cache till max. Därtill har KX försökt implementera alla grundläggande operationer, som aritmetiska, genom vektoriserade processorinstruktioner för att maximera deras hastighet. Q kan även utföra uppgifter som inte är typiska för databaser — till exempel bearbeta strömmande data och beräkna i "real tid" (med en fördröjning från tiotals millisekunder till några sekunder beroende på uppgiften) olika aggregatfunktioner för finansiella instrument över olika tidsintervall eller bygga en modell för hur en genomförd transaktion påverkar marknaden och genomföra profilering nästan omedelbart efter att den har genomförts. I sådana uppgifter bidrar oftast inte Q till den primära tidsfördröjningen, utan behovet av att synkronisera data från olika källor. Den höga hastigheten uppnås tack vare att data och funktioner som behandlar dem finns i samma process, och bearbetningen begränsas till att utföra några QSQL-uttryck och joins, som inte tolkas utan körs som binär kod.
Slutligen kan man på Q skriva vilket serviceprogram som helst. Till exempel Gateway-processer som automatiskt fördelar användarförfrågningar till rätt databaser och servrar. Utvecklaren har full frihet att implementera vilken algoritm som helst för lastbalansering, prioritering, felhantering, åtkomsträttigheter, kvoter och egentligen vad som helst som önskas. Huvudproblemet här är att man måste implementera allt detta själv.
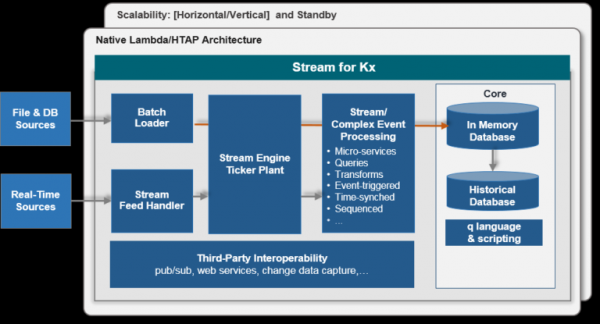
Som exempel kommer jag att lista vilka typer av processer vi har. Alla används aktivt och fungerar tillsammans, vilket sammanför tiotals olika databaser, behandlar data från många källor och betjänar hundratals användare och applikationer.
- Kopplare (feedhandler) till datakällor. Dessa processer använder vanligtvis externa bibliotek som laddas in i Q. C-gränssnittet i Q är mycket enkelt och gör det lätt att skapa proxyfunktioner för vilket C/C++-bibliotek som helst. Q är tillräckligt snabbt för att hantera till exempel bearbetningen av en ström av FIX-meddelanden från alla europeiska börser samtidigt.
- Datadistributörer (tickerplant), som fungerar som ett mellanled mellan kopplarna och konsumenterna. Samtidigt skriver de indata i en speciell binär logg, vilket ger konsumenterna stabilitet mot förlust av anslutningar eller omstarter.
- In-memory databaser (rdb). Dessa databaser ger maximalt snabb åtkomst till färska rådata genom att lagra dem i minnet. I allmänhet samlar de in data i tabeller under dagen och nollställer dem på natten.
- Persistenta databaser (pdb). Dessa databaser säkerställer att dagens data sparas i en historisk databas. Vanligtvis, till skillnad från rdb, lagrar de inte data i minnet, utan använder en speciell cache på disken under dagen och kopierar data till den historiska databasen vid midnatt.
- Historiska databaser (hdb). Dessa databaser ger åtkomst till data från tidigare dagar, månader och år. Deras storlek (i dagar) är endast begränsad av hårddiskens kapacitet. Data kan placeras var som helst, inklusive på olika diskar för att påskynda åtkomsten. Det finns möjlighet att komprimera data med hjälp av flera algoritmer att välja mellan. Databasstrukturen är väl dokumenterad och enkel, data lagras kolumnvis i vanliga filer så att de också kan bearbetas med hjälp av operativsystemets verktyg.
- Databaser med aggregerad information. De lagrar olika aggregationer, vanligtvis grupperade efter instrumentets namn och tidsintervall. In-memory databaser uppdaterar sitt tillstånd vid varje inkommande meddelande, medan historiska databaser lagrar förberäknade data för att påskynda åtkomsten till historiska data.
- Slutligen, gateway processer, för att stödja applikationer och användare. Q möjliggör helt asynkron hantering av inkommande meddelanden, fördelning av dessa till databaser, åtkomstkontroll och så vidare. Jag vill påpeka att meddelandena inte är begränsade och oftast inte är SQL-uttalanden, som det är fallet i andra databaser. Oftast göms SQL-uttalandet i en specialfunktion och konstrueras baserat på de parametrar som användaren begär – tidskonvertering genomförs, filtrering utförs, data normaliseras (till exempel justeras aktiepriser om utdelningar har betalats) och så vidare.
Typisk arkitektur för en datatyp:
Hastighet
Även om Q är ett tolkande språk, är det också ett vektoriserat språk. Det innebär att många inbyggda funktioner, särskilt aritmetiska, accepterar argument i vilken form som helst — tal, vektorer, matriser, listor, och det förväntas av programmeraren att programmet implementeras som operationer på arrayer. I ett sådant språk, om du lägger ihop två vektorer med en miljon element, spelar det ingen roll att språket är tolkande; additionen kommer att utföras med en superoptimerad binär funktion. Eftersom en stor del av tiden i Q-program spenderas på operationer med tabeller som använder dessa grundläggande vektoriserade funktioner, får vi en ganska bra hastighet som möjliggör hantering av enorma datamängder även i en och samma process. Det liknar matematikbibliotek i Python — även om Python som språk är ganska långsamt, finns det många utmärkta bibliotek som numpy, vilka gör det möjligt att bearbeta numeriska data med hastigheten hos ett kompilatorbaserat språk (för övrigt är numpy ideologiskt nära Q).
Dessutom har KX lagt stor vikt vid designen av tabeller och optimering av dem. För det första stöds flera typer av index, som kan användas med inbyggda funktioner och som kan tillämpas inte bara på kolumner i tabeller utan också på alla vektorer – gruppering, sortering, unika attribut och speciell gruppering för historiska databaser. Index appliceras enkelt och justeras automatiskt vid tillägg av element i kolumnen/vektorn. Index kan framgångsrikt tillämpas på kolumner i tabeller både i minnet och på disken. Vid utförande av en QSQL-förfrågan används index automatiskt om så är möjligt. För det andra hanteras historiska data genom en mekanism för avbildning av OS-filer (memory map). Stora tabeller laddas aldrig helt in i minnet, utan nödvändiga kolumner avbildas direkt i minnet, och endast den del som behövs laddas faktiskt (även index hjälper till med det). För programmeraren spelar det ingen roll om data finns i minnet eller inte; mekanismen för arbete med mmap döljs helt inuti Q.
KDB+ är en icke-relationell databas, där tabeller kan innehålla godtyckliga data. Ordningen på raderna i tabellen förändras inte vid tillägg av nya element och kan och bör användas vid skrivning av förfrågningar. Denna funktion är oerhört viktig för arbete med tidsserier (data från börser, telemetri, händelseloggar), eftersom om data är sorterade efter tid, så behöver användaren inte tillämpa några SQL-tricks för att hitta den första eller sista raden i tiden i tabellen eller N rader, eller avgöra vilken rad som följer efter den N:e raden, och så vidare. Ännu enklare blir join-avfrågningar, till exempel att hitta den senaste kursen för 16000 affärer i VOD.L (Vodafone) i en tabell med 500 miljoner element tar cirka en sekund på disken och ett tiotal millisekunder i minnet.
Ett exempel på en tidsjoin – quote-tabellen avbildas i minnet, så det finns ingen anledning att ange VOD.L i where, indexet på sym-kolumnen och det faktum att data är sorterade efter tid används implicit. Nästan alla joins i Q är vanliga funktioner, snarare än en del av select-uttrycket:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Slutligen är det värt att nämna att ingenjörerna på KX, ledda av Arthur Whitney, verkligen är besatta av effektivitet och gör allt för att maximera standardfunktionerna i Q och optimera de vanligaste användningsmönstren.
Resultat
KDB+ är populär bland företag främst på grund av sin exceptionella mångsidighet – den fungerar lika bra som en in-memory databas, som en databas för lagring av terabyte av historiska data, och som en plattform för dataanalys. Eftersom databehandling sker direkt i databasen uppnås hög hastighet och resursbesparing. Ett fullständigt programmeringsspråk, integrerat med databasfunktioner, gör det möjligt att implementera hela det nödvändiga processstacken på en plattform – från datainsamling till bearbetning av användarförfrågningar.
Ytterligare information
Nackdelar
En betydande nackdel med KDB+/Q är den höga inlärningströskeln. Språket har en udda syntax, vissa funktioner är kraftigt överbelastade (value, till exempel, har cirka 11 användningsvarianter). Viktigast av allt, det kräver en radikalt annan inställning till programmeringsskrivande. I det vektorbaserade språket måste man alltid tänka i termer av arrayomvandlingar, alla loopar implementeras genom olika varianter av funktioner map/reduce (som kallas adverbs i Q), och man får aldrig försöka spara genom att ersätta vektoroperationer med atomära. Till exempel, för att hitta indexet för den N:e förekomsten av ett element i en array bör man skriva:
1. (where element=vector)[N]
även om detta verkar fruktansvärt ineffektivt i termer av C/Java (skapar en boolesk vektor, där where returnerar indexen för true element i den). Men sådan notation gör betydelsen av uttrycket mer begriplig och du använder snabba vektoroperationer istället för långsamma atomära. Den konceptuella skillnaden mellan vektorbaserade språk och andra liknar skillnaden mellan imperativ och funktionell programmering, och man måste vara beredd på detta.
Vissa användare är också missnöjda med QSQL. Problemet är att det bara liknar riktig SQL. I verkligheten är det bara en tolk för SQL-liknande uttryck som inte stödjer optimering av frågor. Användaren måste själv skriva optimala frågor, vilket många inte är redo för. Å andra sidan kan man alltid själv skriva en optimal fråga istället för att förlita sig på en svart låda-optimerare.
Som en fördel är boken om Q — Q For Mortals tillgänglig gratis på , där det också finns många andra nyttiga material.
En annan stor nackdel är kostnaden för licensen. Det handlar om tiotusentals dollar per år för en CPU. Endast stora företag har råd med sådana utgifter. Nyligen har KX gjort sin licenspolicy mer flexibel och ger möjlighet att betala endast för användningstid eller hyra KDB+ i molnen från Google och Amazon. Dessutom erbjuder KX för nedladdning (32-bitarsversion eller 64-bitarsversion på begäran).
Konkurrenter
Det finns ganska många specialiserade databaser som bygger på liknande principer — kolumnbaserade, in-memory, fokuserade på mycket stora datavolymer. Problemet är att det just är specialiserade databaser. Ett tydligt exempel är Clickhouse. Denna databas har en lagringsprincip på disk och indexbyggande som liknar KDB+, och vissa förfrågningar utför den snabbare än KDB+, även om det inte är väsentligt. Men även som databas är Clickhouse mer specialiserad än KDB+ — webbanalys mot godtyckliga tidsserier (denna skillnad är mycket viktig — på grund av den finns det till exempel ingen möjlighet att använda ordningen av poster i Clickhouse). Men viktigast av allt, Clickhouse saknar den allsidighet som KDB+ har, ett språk som skulle tillåta att bearbeta data direkt i databasen, istället för att först ladda dem i en separat applikation, bygga godtyckliga SQL-uttryck, tillämpa godtyckliga funktioner i förfrågningar, skapa processer som inte är relaterade till utförandet av historiska funktionsanrop. Därför är det svårt att jämföra KDB+ med andra databaser, de kan vara bättre i specifika användningsscenarier eller helt enkelt bättre när det gäller traditionella databasanvändningar, men jag känner inte till något annat lika effektivt och allsidigt verktyg för bearbetning av tidsdata.
Integration med Python
För att förenkla arbetet med KDB+ för personer som inte är bekanta med teknologin har KX skapat bibliotek för nära integration med Python inom samma process. Man kan anropa vilken python-funktion som helst från Q, och vice versa — anropa vilken Q-funktion som helst från Python (särskilt QSQL-uttryck). Biblioteken konverterar vid behov (för effektivitetens skull, inte alltid) data från formatet av det ena språket till formatet av det andra. Som ett resultat lever Q och Python i ett sådant nära symbios att gränserna mellan dem suddas ut. Som ett resultat har programmeraren, å ena sidan, full tillgång till många användbara Python-bibliotek, och å andra sidan får han en integrerad snabb databas för att arbeta med stora datamängder, vilket är särskilt användbart för dem som sysslar med maskininlärning eller modellering.
Arbeta med Q i Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Länkar
Företagets webbplats —
Utvecklarwebbplats —
Boken Q For Mortals (på engelska) —
Artiklar om tillämpningar av KDB+/Q från anställda på kx —
Källa: habr.com
